


Python字符串转数字:int()与float()的安全转换与异常处理
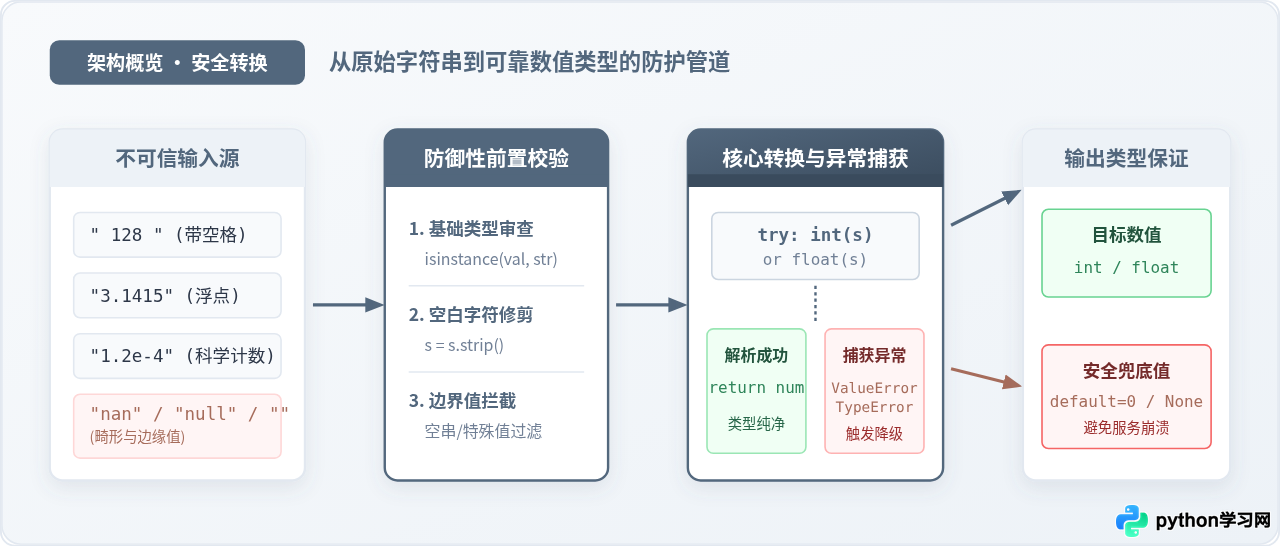
深入讲解 Python 中将字符串转换为整数与浮点数的核心机制、格式支持边界、常见异常触发场景,并提供工业级的安全转换函数与异常处理最佳实践。
在 Python 中,将字符串转换为数值最直接的方法是调用内置的 int() 与 float() 函数。然而在实际工程开发中,外部输入(例如用户表单、第三方接口或文本日志)往往夹杂空字符、非法符号、特殊浮点数甚至非预期的类型对象。若不加防范地直接转换,极易触发 ValueError 或 TypeError 并中断主程序。掌握两者的语法规则边界,遵循 Python 倡导的 EAFP 异常防御范式,并实现带默认值降级的安全函数,是编写高可靠数据解析代码的核心基础。
一、int() 与 float() 的转换规则与边界对照
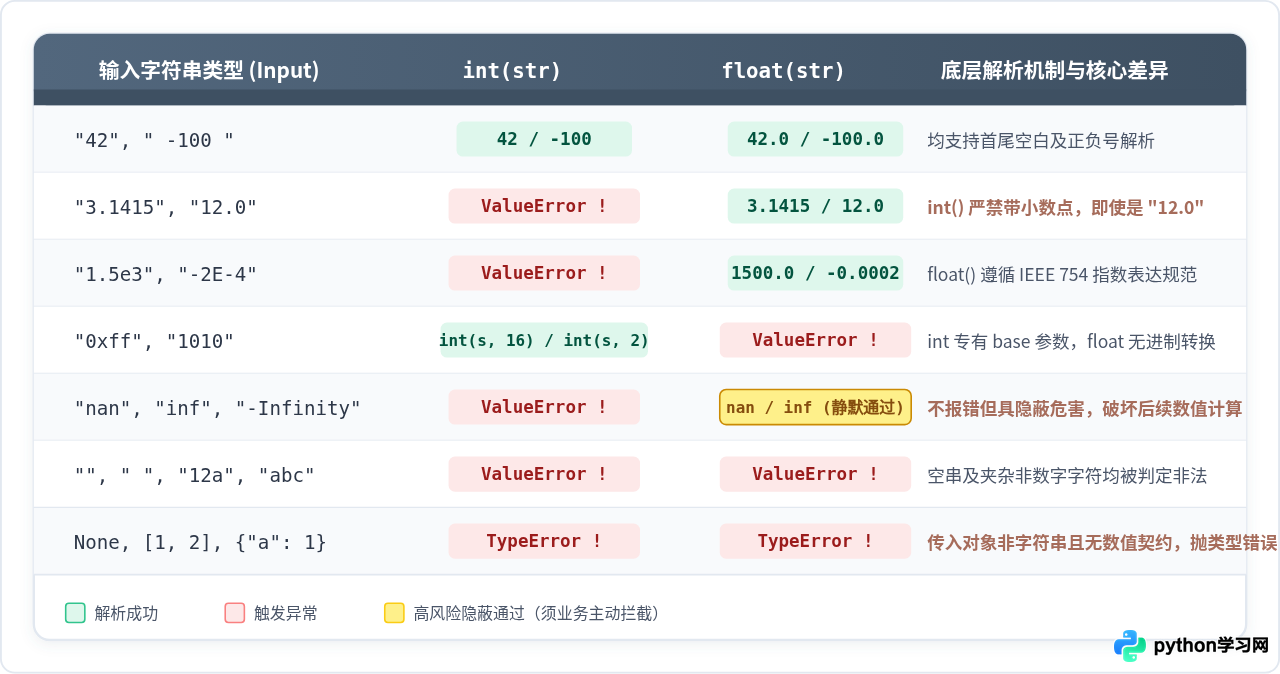
很多初学者容易将 int() 和 float() 视为简单的“强制类型转换器”,但两者在底层的 CPython 解析实现和对字符串格式的语法要求上存在显著差异。
1. int() 的行为特点与语法边界
内置函数 int(x, base=10) 用于将一个数值或字符串转换为整数。当传入字符串时,它支持前导正负号(如 "+42"、"-100")以及前后的空白字符(如 " 256 \n")。然而,int() 的解析规则极为严格:
- 严禁包含任何小数结构: 即使字符串内容在数学上等价于整数(如
"42.0"),传入int("42.0")也会立即抛出ValueError。它不会自动截断小数位。 - 支持指定进制(base 参数):
int()拥有第二个可选参数base(取值范围为 2 到 36,或为 0 根据前缀自动推断)。例如int("1010", 2)解析为 10,int("0xff", 16)解析为 255。
2. float() 的行为特点与语法边界
内置函数 float(x) 用于将字符串或整数转为双精度浮点数。与 int() 相比,它的语法接受度更宽,但也带来了独特的安全考量:
- 支持丰富的数值记号: 能够无缝解析标准小数(如
"3.14159")和科学计数法表示(如"1.5e-3"、"-2.8E4")。 - 不具备进制参数:
float()无法像int()那样指定非十进制基数,传入十六进制表示会引发异常。 - 静默接受特殊 IEEE 754 标识:
float()会不区分大小写地将"nan"、"inf"、"-infinity"等字符串解析为合法的浮点对象。这一特性若未主动拦截,极易渗透到业务算法中导致后续计算失真。
二、生产环境中的典型陷阱与排查
在日常开发与数据清洗任务中,以下四个场景最容易引发非预期的程序崩溃或逻辑错误:
陷阱一:浮点数字符串无法直接通过 int() 转换
当外部数据源传入一个带小数点的整数字符串(例如部分 JSON 序列化工具输出的 "100.0")时,直接调用 int("100.0") 会立即报错:
# 错误示例:直接调用 int() 解析带小数点的文本
val_str = "100.0"
# int(val_str)  # 触发 ValueError: invalid literal for int() with base 10: '100.0'

# 正确做法:若业务允许向下取整或丢弃小数位,应先转 float 再转 int
safe_integer = int(float(val_str))
print(f"转换结果: {safe_integer}, 类型: {type(safe_integer)}")
# 输出: 转换结果: 100, 类型: <class 'int'>先转 float 再转 int 意味着发生了精度截断。如果原字符串是 "100.9",结果将是 100。在金融、计费等精度敏感场景中,应明确业务规则是否允许截断,或者使用 decimal.Decimal 进行定点数解析。
陷阱二:特殊浮点值 "nan" 与 "inf" 的静默渗透
很多开发者认为“只要 float() 没有报错,得到的就一定是合法有效数字”。这是一个严重的误区:
# 隐蔽陷阱示例
raw_input = "nan"
num = float(raw_input)
print(num)  # 输出: nan

# nan 的比较行为具有反直觉特性
print(num == num)        # 输出: False
print(num > 0 or num < 0) # 输出: False
若未经检验的 nan 存入数据库或进入统计模型,会导致后续的求和、平均值计算均被污染为 nan。对于需要实际参与计算的浮点数,必须使用标准库中的 math.isnan() 和 math.isinf() 进行阻断。
陷阱三:空字符串与纯空白字符串
字符串为 ""、" " 或仅包含换行符 "\n" 时,无论是 int() 还是 float() 都会直接抛出 ValueError。虽然两者会自动修剪数值两侧的空白,但面对纯空白时无法推断任何有效数值。
陷阱四:传入非字符串类型导致的 TypeError
在弱类型的外部数据流中,传入的变量可能是 None、列表或字典。直接传入会触发 TypeError(如 TypeError: int() argument must be a string, a bytes-like object or a real number, not 'NoneType')。因此在异常捕获设计中,决不能只捕获 ValueError。
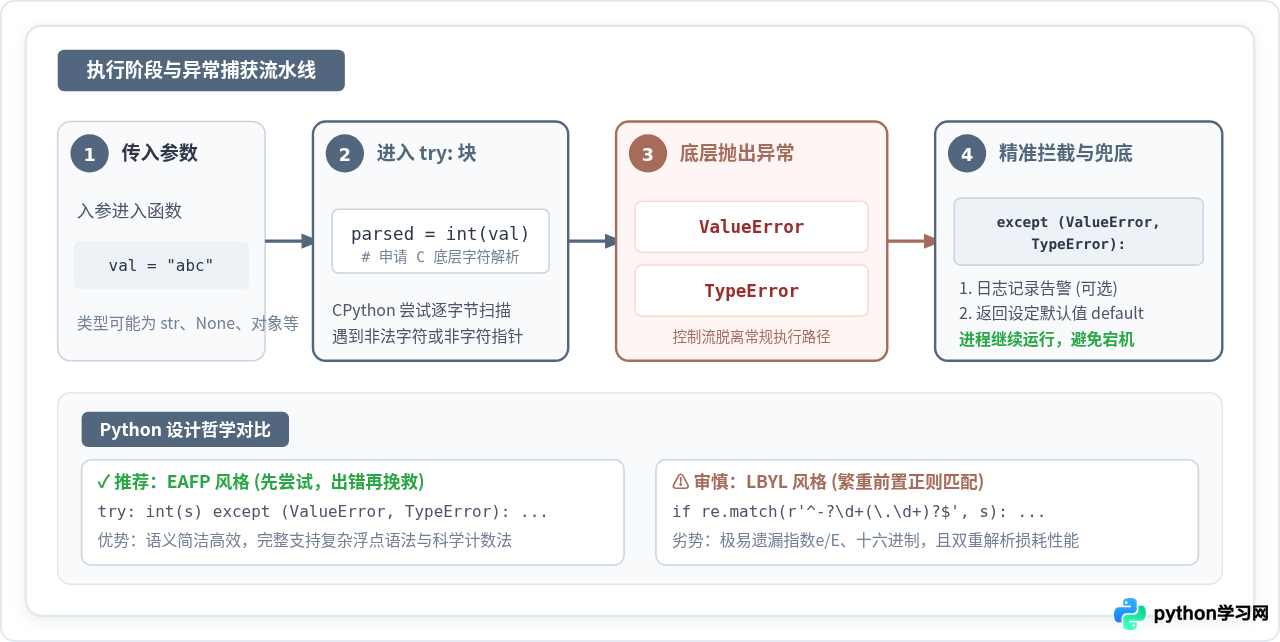
三、异常处理策略:为什么优先选择 EAFP
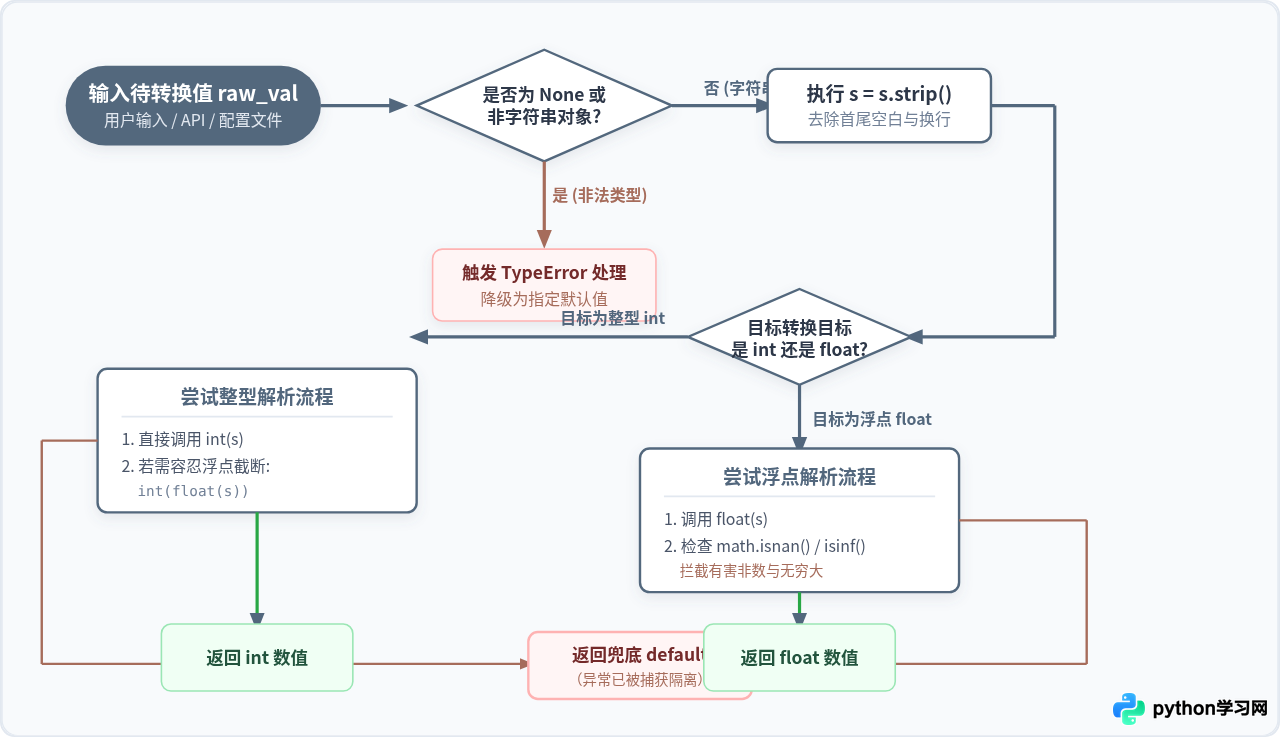
在设计防御性转换逻辑时,通常有两种思路:一是“先检查再执行”(LBYL,Look Before You Leap),即用正则表达式检查字符串是否符合数字规则;二是“先尝试后挽救”(EAFP,Easier to Ask for Forgiveness than Permission),即通过 try-except 捕获转换异常。
在 Python 转换数字的场景下,强烈推荐采用 EAFP 风格,主要原因如下:
- 浮点语法的全面性与复杂性: 浮点数规范极其复杂,包含正负号、指数符号(
e/E)、省略前导零的小数(如".5")等。编写一个完全覆盖且高效的正则表达式非常困难,极易出现误判。 - 避免重复计算: 正则表达式首先要在 Python 层面完整扫描一遍字符串,匹配成功后再交由 C 底层的
int()或float()再次解析,造成双重性能开销。 - 精确定位目标异常: 在编写
except子句时,应显式声明(ValueError, TypeError),杜绝使用没有指定异常类型的“裸 except:”,以防掩盖诸如KeyboardInterrupt或内存耗尽等系统级异常。
四、工程级安全转换工具函数实现
为了在实际项目中复用稳健的转换逻辑,我们可以封装一组兼顾鲁棒性、性能与灵活性的通用函数。
1. 安全整数转换:safe_int
from typing import Any, Optional

def safe_int(val: Any, default: Optional[int] = 0, base: int = 10) -> Optional[int]:
    """
    安全地将输入转换为整数。
    若转换失败或遇到非预期类型,返回指定的 default 值。
    """
    if val is None:
        return default
    try:
        # 如果是字符串,先去除首尾空白
        if isinstance(val, str):
            val = val.strip()
        return int(val, base)
    except (ValueError, TypeError):
        return default

# 验证测试
assert safe_int("42") == 42
assert safe_int("  -128  ") == -128
assert safe_int("0x10", default=0, base=16) == 16
assert safe_int("invalid", default=-1) == -1
assert safe_int(None, default=None) is None
assert safe_int("3.14", default=0) == 0  # int 默认不接受小数点
2. 安全浮点数转换:safe_float(带 NaN/Inf 过滤)
import math

def safe_float(val: Any, default: Optional[float] = 0.0, allow_nan: bool = False, allow_inf: bool = False) -> Optional[float]:
    """
    安全地将输入转换为浮点数。
    默认自动过滤 nan 与 inf,防止特殊浮点值污染下游业务。
    """
    if val is None:
        return default
    try:
        if isinstance(val, str):
            val = val.strip()
        num = float(val)

        # 阻断特殊浮点值
        if not allow_nan and math.isnan(num):
            return default
        if not allow_inf and math.isinf(num):
            return default

        return num
    except (ValueError, TypeError):
        return default

# 验证测试
assert safe_float("3.14159") == 3.14159
assert safe_float("  -2.5e3  ") == -2500.0
assert safe_float("nan", default=0.0) == 0.0      # 成功拦截 nan
assert safe_float("inf", default=-999.0) == -999.0  # 成功拦截 inf
assert safe_float("abc", default=None) is None
3. 自适应数字解析器:parse_number
在解析无模式结构(如动态 JSON 或报表)时,我们往往事先不知道字段是整数还是浮点数。此时可以构建自适应级联转换:优先尝试解析为整型,失败后再尝试浮点型。
from typing import Union

def parse_number(val: Any, default: Any = None) -> Union[int, float, Any]:
    """
    自适应数值转换器:
    1. 优先尝试解析为 int;
    2. 失败后尝试解析为 float;
    3. 若均为非法输入,返回默认值。
    """
    if val is None:
        return default
    if isinstance(val, str):
        val = val.strip()

    # 第一步:尝试整型
    try:
        return int(val)
    except (ValueError, TypeError):
        pass

    # 第二步:尝试浮点型
    try:
        num = float(val)
        if not (math.isnan(num) or math.isinf(num)):
            return num
    except (ValueError, TypeError):
        pass

    return default

# 验证测试
assert parse_number("100") == 100            # 解析为 int
assert parse_number("100.5") == 100.5        # 解析为 float
assert parse_number("  1.2e2  ") == 120.0    # 解析为 float
assert parse_number("invalid") is None       # 返回默认值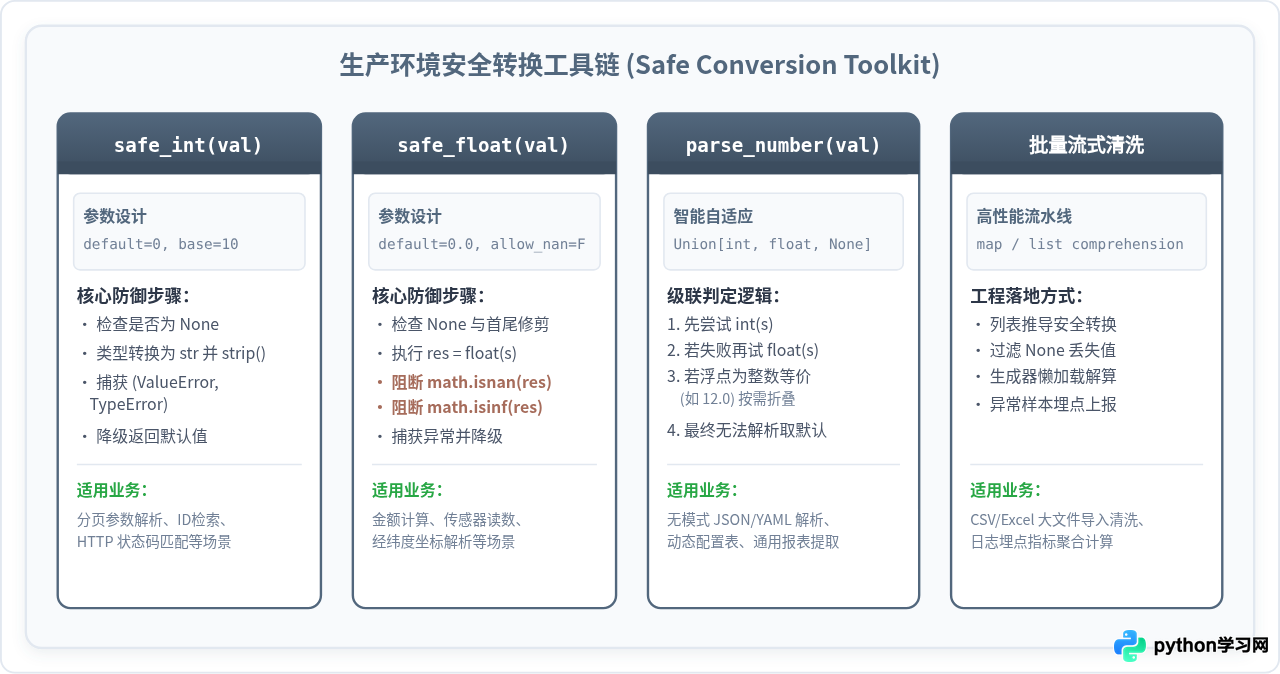
五、批量数据流清洗实战
在数据分析与清洗流程中,待处理的数据通常以列表、字典或生成器序列的形式存在。借助上述封装的安全转换函数,可以简洁优雅地完成批量清洗:
# 模拟外部抓取或 CSV 读取的原始脏数据列表
raw_data_stream = [" 10 ", "25.4", "N/A", "0", "-8", "null", "3.6e2", "", "nan"]

# 需求:提取所有合法浮点数并计算总和与均值
cleaned_floats = [
    f for item in raw_data_stream
    if (f := safe_float(item, default=None)) is not None
]

print("清洗后的有效数据:", cleaned_floats)
# 输出: 清洗后的有效数据: [10.0, 25.4, 0.0, -8.0, 360.0]

total = sum(cleaned_floats)
average = total / len(cleaned_floats) if cleaned_floats else 0
print(f"有效数据条数: {len(cleaned_floats)}, 合计: {total}, 平均值: {average:.2f}")
# 输出: 有效数据条数: 5, 合计: 387.4, 平均值: 77.48
六、实践总结与速查清单
处理 Python 字符串转数字任务时,建议在编码前对照以下清单进行设计:
- 明确目标类型: 如果确定是整数且必须杜绝小数位,直接使用
int();如果允许截断或数据为整数形式的浮点串(如"5.0"),先转float()再转int()。 - 防御异常组合: 始终同时捕获
(ValueError, TypeError),防止空指针或错误对象破坏流程。 - 警惕特殊浮点值: 对
float()转换结果显式使用math.isnan()和math.isinf()校验。 - 预先清理空白: 面对用户输入时,先执行
.strip()消除换行符与多余空格。 - 统一封装工具函数: 在业务核心库中沉淀
safe_int与safe_float,通过默认值机制保证主干链路的高可用性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















