


Python字符串常用方法速查:split、join与replace详解
全面解析Python字符串核心处理方法split、join与replace。包含参数机制、底层行为差异、常见陷阱、性能考量、多场景对比与组合实战,配有详细图解与速查表格。
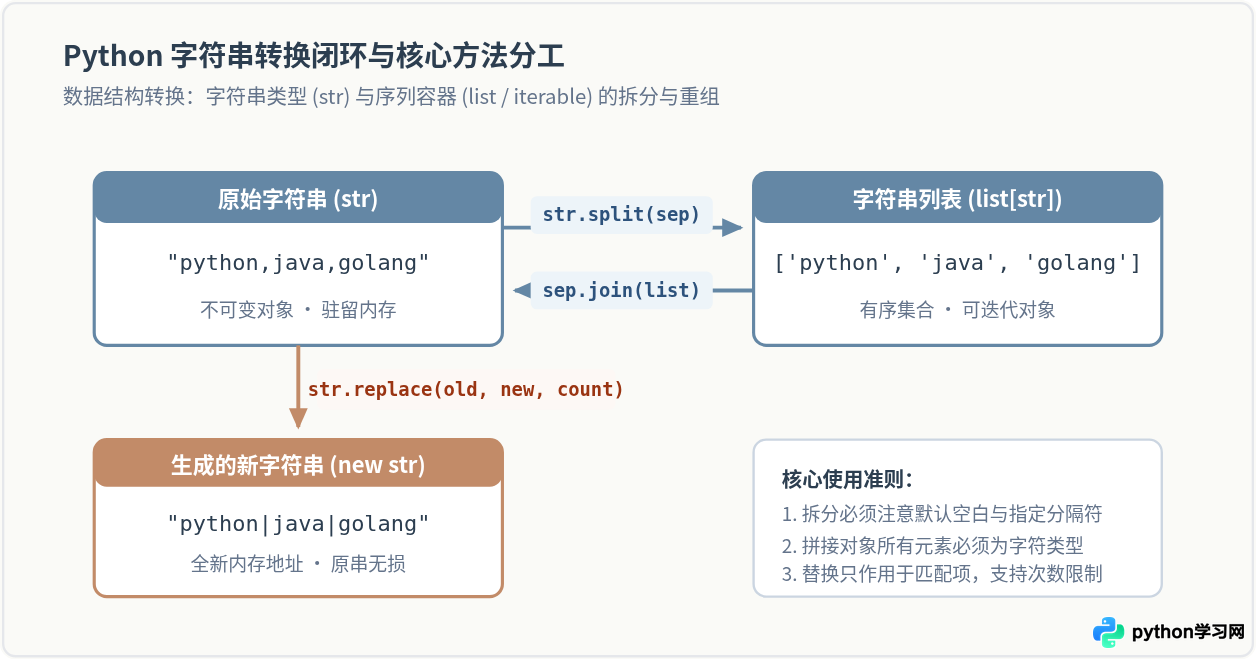
在 Python 的日常文本处理与数据清洗中,split()、join() 和 replace() 是使用频率最高的三大核心字符串方法。因为 Python 中的字符串属于不可变对象(Immutable),这三个方法均不会就地修改原始字符串,而是生成并返回全新的对象。掌握它们的核心机制、参数细节及常见陷阱,是写出高效、健壮代码的基础。
一、str.split():字符串拆分为列表
split() 方法用于沿着指定的分隔符切割字符串,并将切分出的片段放入一个列表中返回。方法完整签名如下:
str.split(sep=None, maxsplit=-1)1. 关键参数解析
- sep(分隔符):用于指定切分的依据字符或子串。默认值为
None。 - maxsplit(最大拆分次数):指定最多执行多少次拆分。默认值为
-1,表示“全量拆分,不设上限”。若指定为n,则返回列表的最大长度为n + 1。
2. 核心陷阱:默认空白与显式空白的巨大差异
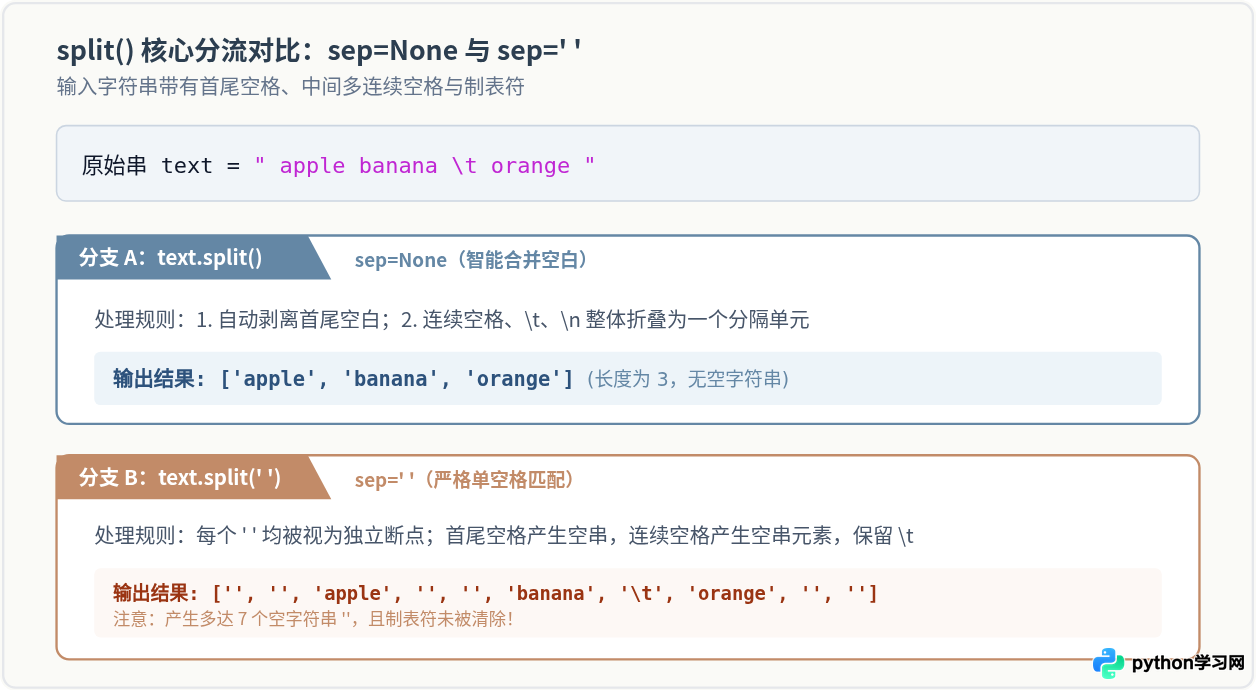
许多初学者容易忽视 sep=None 与 sep=' '(显式空格)的差异。实际上,二者在底层有本质不同的逻辑:
-
当
sep=None(默认行为)时:Python 将连续的任意空白字符(包括半角空格、制表符\t、换行符\n、回车符\r)视作一个整体分隔符;同时会自动忽略字符串开头和结尾的所有空白,绝不会在列表中产生空字符串""。 -
当
sep=' '(指定单个空格)时:Python 会严格把单个空格作为分隔符。若存在连续空格或首尾空格,切分后会在相应位置保留空字符串""。
3. 代码示例与运行结果对比
# 示例 1:对比默认切分与指定空格切分
raw_str = "  Python   Java \t Go  \n"

result_default = raw_str.split()
print("默认切分:", result_default)
# 示例输出: 默认切分: ['Python', 'Java', 'Go']

result_explicit = raw_str.split(' ')
print("指定空格:", result_explicit)
# 示例输出: 指定空格: ['', '', 'Python', '', '', 'Java', '\t', 'Go', '', '\n']

# 示例 2:使用 maxsplit 控制拆分段数(常用于配置项解析)
config_line = "database_url=mysql://user:pass@localhost:3306/db?mode=read"
key_value = config_line.split("=", maxsplit=1)
print("配置切分:", key_value)
# 示例输出: 配置切分: ['database_url', 'mysql://user:pass@localhost:3306/db?mode=read']
在需要处理键值对(如 key=val=extra)或提取日志前缀时,务必使用 maxsplit=1,防止数值本身所包含的分隔符被过度切割导致列表解包失败。
二、str.join():序列高效拼接为字符串
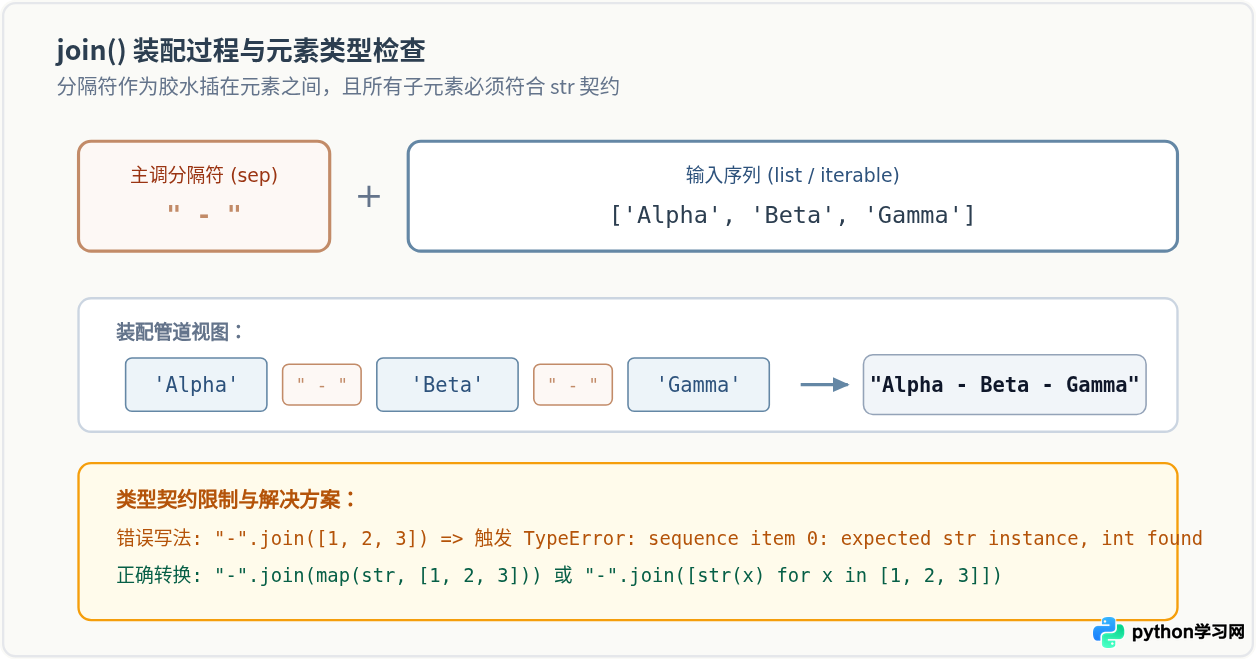
join() 用于将一个可迭代对象(如列表、元组、集合)中的字符串元素连接成一个新的完整字符串。其调用语法较为特殊:
separator.join(iterable)1. 为什么是 separator.join(list) 而不是 list.join(separator)?
初学者常对此设计感到困惑。Python 之所以将 join 设计为字符串对象的方法,主要基于以下两点考量:
-
解耦容器类型:参数
iterable可以是 Python 中任意合法的可迭代对象(包括list、tuple、set、生成器表达式(x for x in ...)等)。如果把方法挂在列表上,那么元组、集合就得各自实现一份。 - 明确职责归属:分隔符本身是字符串,返回结果也是字符串,由字符串对象主导格式化逻辑最为统一。
2. 性能优势:为什么严禁在循环中使用 += 拼接?
由于 Python 字符串的不可变性,每次执行 s += new_str 时,Python 都无法在原有内存块上就地追加,而是必须申请一块新的连续内存空间,将旧字符串内容复制过去,再复制新串。
在包含 $N$ 次追加的循环中,使用 += 会导致 $O(N^2)$ 的时间复杂度与大量内存碎片;而 join() 内部会预先计算所有元素总长度,仅分配一次内存,实现高效的 $O(N)$ 线性拼接。
3. 典型代码示例
# 示例 1:常规列表拼接
languages = ["Python", "Go", "Rust"]
joined_str = " | ".join(languages)
print("拼接语言:", joined_str)
# 示例输出: 拼接语言: Python | Go | Rust

# 示例 2:拼接含非字符串元素(通过 map 转换)
numbers = [100, 200, 300, 400]
csv_row = ",".join(map(str, numbers))
print("数字CSV:", csv_row)
# 示例输出: 数字CSV: 100,200,300,400

# 示例 3:通过生成器表达式高效过滤并拼接
words = ["hello", "", "world", None, "python"]
clean_text = " ".join(w for w in words if w)
print("过滤后文本:", clean_text)
# 示例输出: 过滤后文本: hello world python
三、str.replace():子串精准替换
replace() 方法返回一个新字符串,其中所有的(或指定数量的)指定子串均被替换为新的目标字符串。方法签名如下:
str.replace(old, new, count=-1)1. 关键参数与返回值机制
- old:需要被替换的旧子字符串。
- new:用于替换旧子串的新字符串。若传入空字符串
"",则相当于删除旧子串。 - count(替换次数上限):可选参数,默认为
-1,表示替换全部匹配项;若指定为正整数k,则仅替换从左到右匹配到的前k个子串。
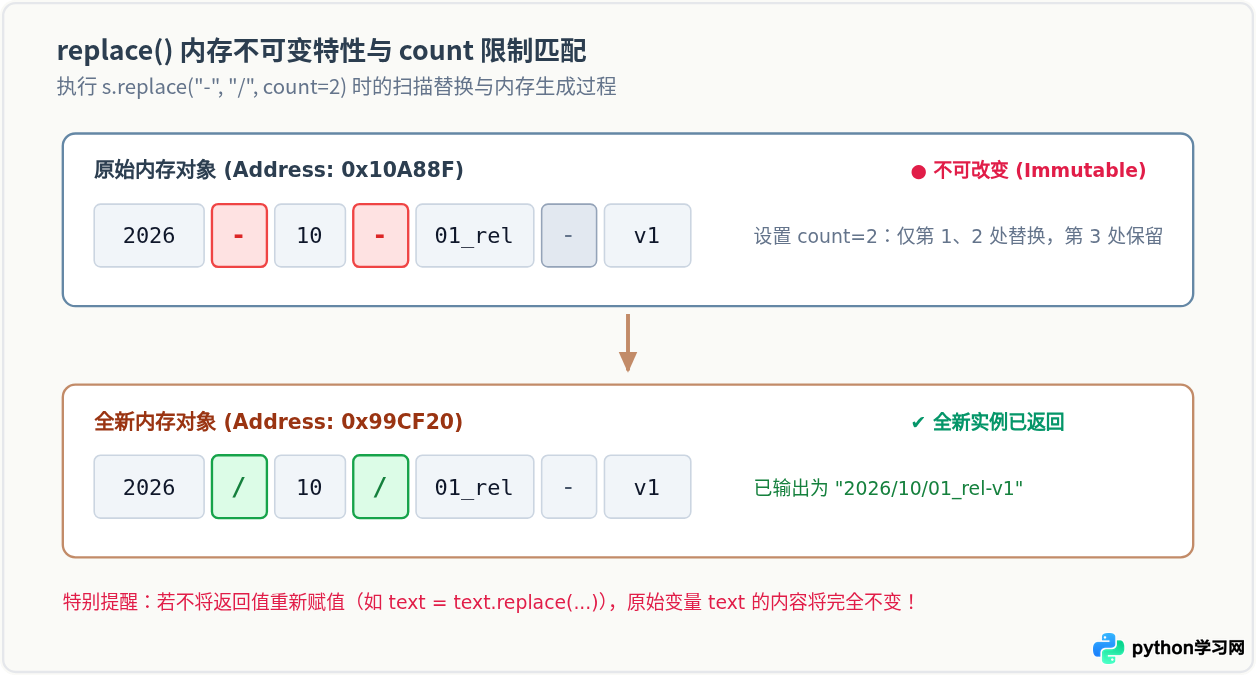
2. 常见错误:遗漏接收返回值
在 Python 新手代码中,最常出现的逻辑 Bug 之一便是直接调用 replace() 而不接收返回值:
filename = "report_2026.xlsx"
filename.replace(".xlsx", ".csv")  # 错误!原变量 filename 并未发生任何改变
print(filename)  # 依然打印: report_2026.xlsx

# 正确做法:将返回的新对象重新赋值给变量
filename = filename.replace(".xlsx", ".csv")
print(filename)  # 示例输出: report_2026.csv
3. 链式调用与 replace 局限性
针对少量固定模式的清理任务,可以连贯调用 replace()。但若需要进行复杂的模糊匹配(如大小写不敏感替换、模式匹配数字),应使用 re.sub(),而不是嵌套过深的 replace()。
raw_code = " [A-01]  "
# 链式替换清理字符
cleaned = raw_code.replace("[", "").replace("]", "").strip()
print("清理结果:", cleaned)  # 示例输出: 清理结果: A-01
四、组合实战:三大方法的经典协同场景
在实际项目开发中,这三个方法往往组合使用,共同构成数据清洗流水线。
场景 1:规范化多余空白(消除一切连续空格)
用户输入的文本中常常混杂着不规则的连续空格和制表符。利用 split() 默认吞并空白的特性配合 " ".join(),只需一行代码即可实现完美的空白规范化:
user_input = "   Deep Learning   with     Python   3.12 \t\n  "
normalized = " ".join(user_input.split())
print("规范化后:", repr(normalized))
# 示例输出: 规范化后: 'Deep Learning with Python 3.12'
场景 2:数据格式与分隔符重构(如逗号分隔转 TSV)
当需要将 CSV 格式的数据行重塑为制表符分隔(TSV)并同时对特定字符做转义时:
csv_record = "1001, Alice, Engineer, 2026-05"
# 先按逗号切分,剥离各项多余空格,再用制表符拼接
fields = [field.strip() for field in csv_record.split(",")]
tsv_record = "\t".join(fields)
print("TSV记录:", repr(tsv_record))
# 示例输出: TSV记录: '1001\tAlice\tEngineer\t2026-05'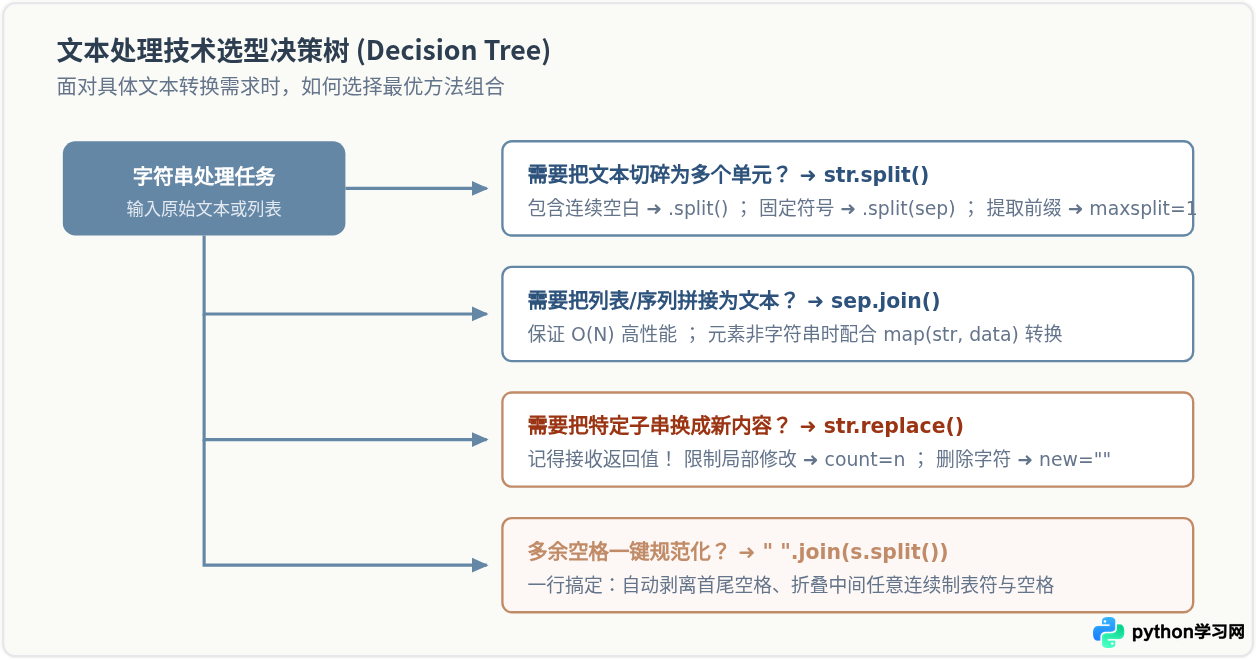
五、三方法核心特性速查对比表
为了方便日常编码时快速核对,下表系统梳理了三大方法的关键技术特征:
| 方法名称 | 典型调用语法 | 主要参数 | 返回值类型 | 高频陷阱与注意事项 |
|---|---|---|---|---|
split |
s.split(sep, maxsplit) |
sep (默认None)maxsplit (默认-1) |
list[str] |
默认 sep=None 会吞并连续空白且不留空串;若写成 s.split(' ') 则会保留大量空串 ""。 |
join |
sep.join(iterable) |
iterable (序列/生成器) |
str |
由分隔符调用;序列内只要有一个元素不是 str 就会报 TypeError;严禁用 += 代替。 |
replace |
s.replace(old, new, count) |
old, newcount (默认-1) |
str (新对象) |
字符串是不可变对象,绝不能漏写 s = s.replace(...) 的变量重接收。 |
六、总结
split()、join() 与 replace() 分别承担了 Python 文本处理中分解、重组和置换的核心职责:
- 分解用
split:区分好默认空白与显式分隔符,必要时利用maxsplit限制拆分步数; - 重组用
join:牢记由分隔符调用,确保待拼接元素均为字符串,利用其 $O(N)$ 一次性内存分配取代低效的循环累加; - 置换用
replace:铭记不可变对象的特性,始终接收返回的新字符串,合理利用count参数精准控制替换边界。
理解了三者的运作原理与底层契约,即可在日常的数据解析、日志提取及接口清洗中写出简洁、安全且高性能的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















