


Python中替代\t进行精准列对齐的更好方法
深入剖析在Python控制台或日志输出中替代\t制表符的方案,详解f-string格式化规范、东亚宽字符视觉宽度补偿算法以及现代表格工具,实现跨环境精准对齐。
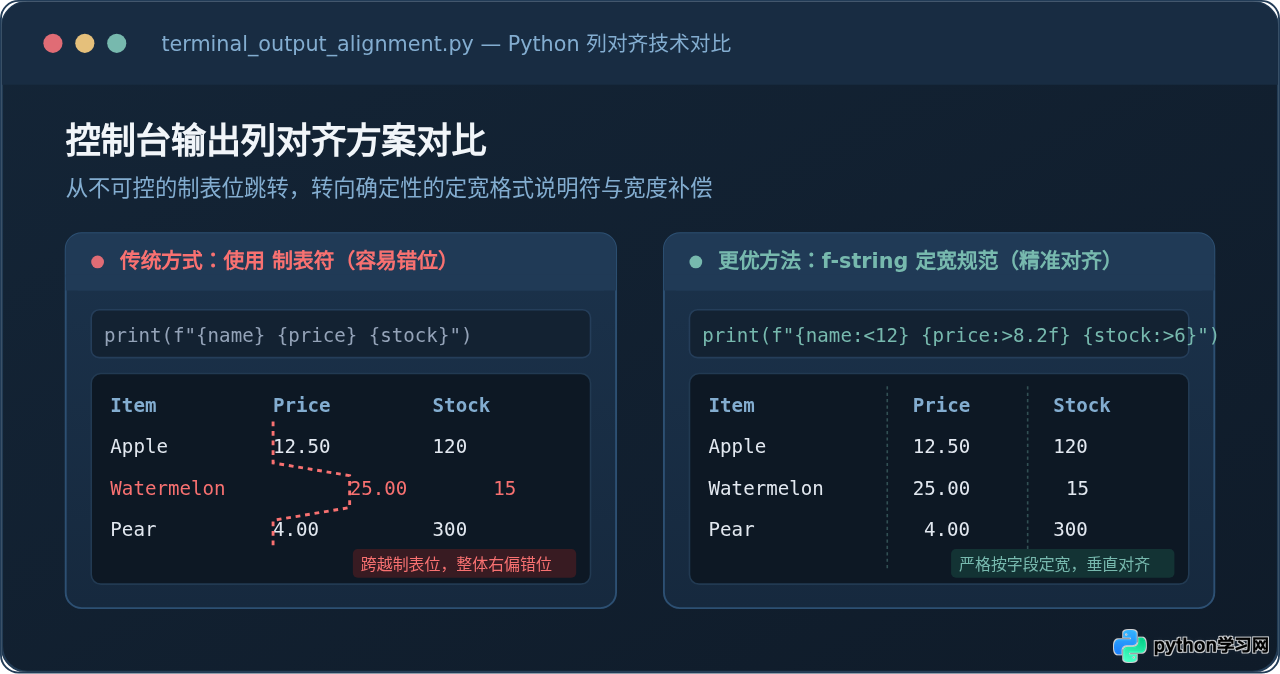
在编写命令行工具、生成测试报告或打印监控数据时,许多开发者习惯在字段之间插入制表符 来进行快速分列。设想这样一个场景:你需要打印一份包含商品名称、价格与库存的清单,直接写出 print(f"{name} {price} {stock}")。当名称为 "Apple" 或 "Pear" 时排版看似正常,但一旦出现像 "Watermelon" 这样稍长的单词,整行数据就会在终端中突然向右跳跃,导致整张数据表参差错位。
要彻底解决这一问题,核心路径是放弃不可控的制表位跳格机制,改用具有确定性宽度的字段规范与字符补偿机制。本文将深入剖析制表符 失效的底层原因,并系统介绍四种在 Python 生产环境中实现精准列对齐的更好方案:内置 f-string 格式说明符、字符串内建填充方法、基于 unicodedata 的中英混排视觉宽度补偿方案,以及高级结构化表格排版库。
一、深入剖析:为什么 无法实现可靠的列对齐?
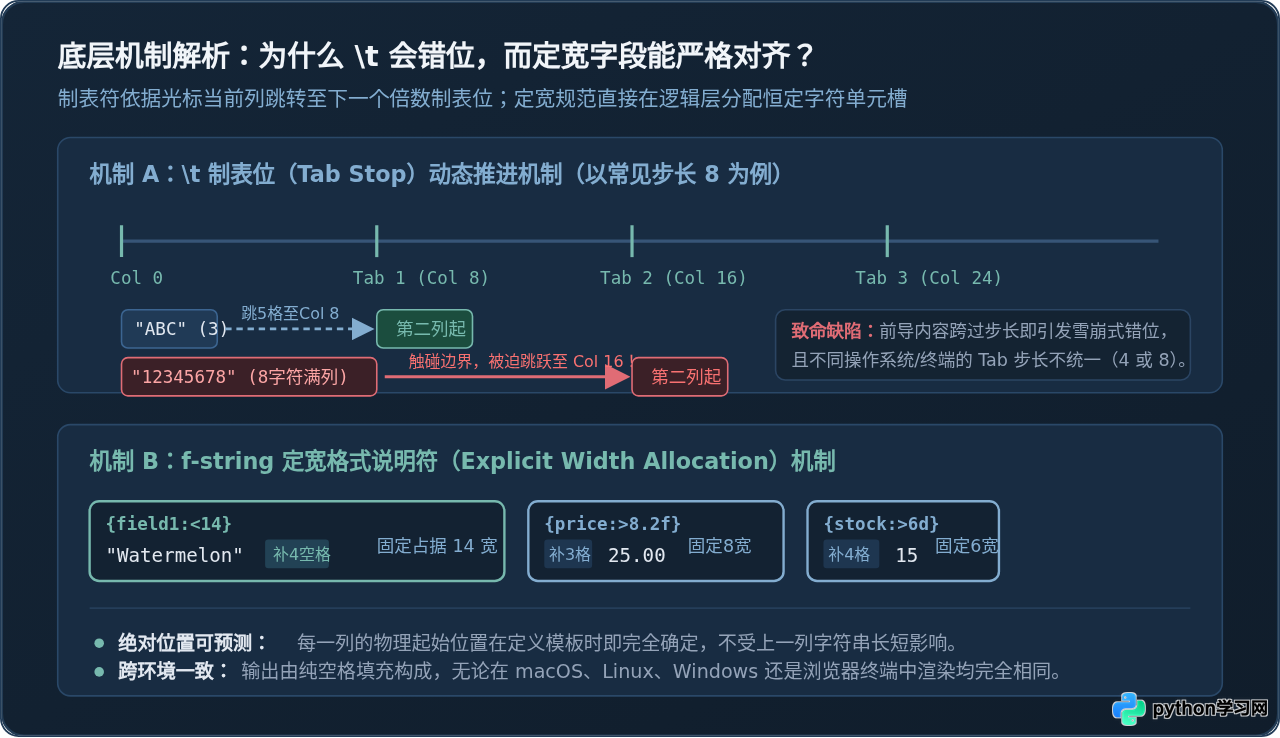
制表符(ASCII 码 9,转义为 )本身并不是“空格集合”,它的设计初衷是让光标跳转到下一个预设的制表位(Tab Stop)。在主流终端和文本查看器中,制表位通常设置在列号为 8 或 4 的整数倍位置。
当我们在第 0 列输出长度为 5 的字符串 "Apple" 后紧跟 ,光标位于第 5 列,距离下一个 8 的倍数制表位(第 8 列)还有 3 个单位,因此光标跳跃 3 格;而当输出长度为 10 的 "Watermelon" 时,它已经越过了第 8 列的制表位,此时紧跟的 只能将光标推进到下一个制表位——即第 16 列。这一跨步直接导致后面的价格列和库存列整体右偏,破坏了整张表的垂直对齐。
排版的文本在跨机器展示时几乎必定发生格式错乱。
二、标准首选:使用 f-string 与 format 格式化说明符
从 Python 3.6 开始普及的 f-string(格式化字符串字面值)以及沿用至今的 str.format(),提供了原生的格式说明符(Format Specifier)语法。这是纯 ASCII 与数字排版下最优雅、性能最高且零外部依赖的解决方案。
1. 格式说明符语法规范
在占位符的大括号内部,通过冒号 : 引入格式说明符:
{value:[fill][align][width][.precision][type]}
- align(对齐符号):
<表示左对齐(文本常用);>表示右对齐(数值常用,保证小数点和数位对齐);^表示居中对齐(状态或编码常用)。 - width(字段宽度):指定该列分配的固定字符单元宽度。如果内容长度不足,Python 会自动填充空格。
- fill(填充字符,可选):位于对齐符号之前,默认为普通空格,也可指定为
0或-等。 - .precision 与 type(精度与类型,可选):例如
.2f将浮点数格式化为保留两位小数。
2. 完整实战示例
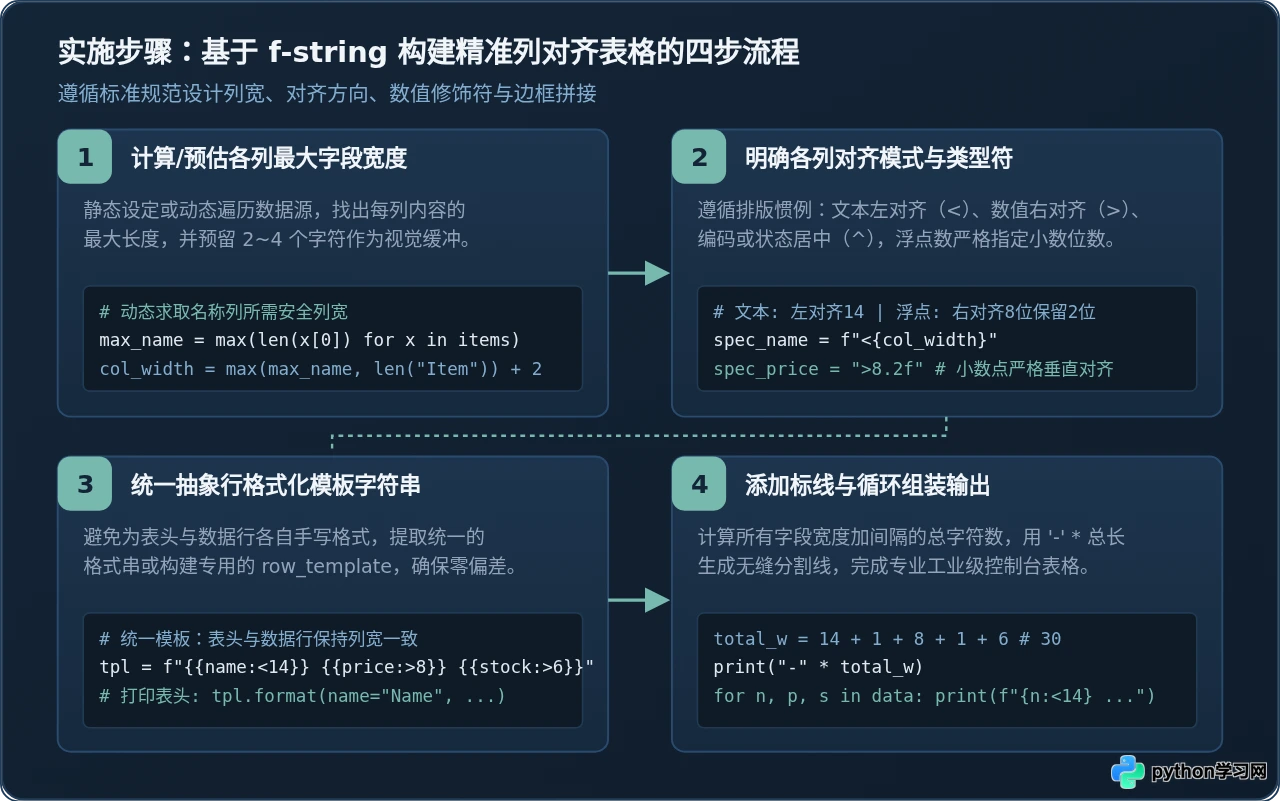
以下示例展示如何利用 f-string 规范构建一个具备表头、数据行与分隔线的标准控制台报表:
# 数据清单:包含品名、单价与库存
inventory = [
    ("Apple", 12.5, 120),
    ("Banana", 3.25, 50),
    ("Watermelon", 25.0, 15),
    ("Pear", 4.0, 300),
]

# 1. 定义各列的宽度常数与对齐规范
# 品名左对齐宽14,价格右对齐宽8保留2位小数,库存右对齐宽6位整数
col_name_w = 14
col_price_w = 8
col_stock_w = 6

# 2. 输出表头(表头与数据行使用相同列宽)
print(f"{'Item':<{col_name_w}} {'Price':>{col_price_w}} {'Stock':>{col_stock_w}}")

# 3. 输出自适应分割线(各列宽加上中间的单空格间隔)
total_width = col_name_w + 1 + col_price_w + 1 + col_stock_w
print("-" * total_width)

# 4. 循环格式化输出数据行
for item, price, stock in inventory:
    print(f"{item:<{col_name_w}} {price:>{col_price_w}.2f} {stock:>{col_stock_w}d}")
在上面的输出结果中,即便 "Watermelon" 长度达到 10 个字符,下一列的价格依然严格从固定的第 16 列开始排列,右对齐的单价与库存数位完美对齐,完全消除了由于字符长短引起的抖动。
三、轻量选择:使用字符串内建方法 ljust、rjust 与 center
如果处理的数据已经是字符串形式,或者需要在独立函数中对单一字段做定宽包装,Python 原生字符串对象提供的三个填充方法同样比 可靠得多:
str.ljust(width[, fillchar]):返回原字符串左对齐、右侧用fillchar(默认空格)填充至width长度的字符串。str.rjust(width[, fillchar]):返回原字符串右对齐、左侧填充的字符串。str.center(width[, fillchar]):返回原字符串居中、两端填充的字符串。
headers = ["Task ID", "Status", "Duration"]
widths = [12, 10, 10]

# 拼接表头
header_line = " ".join([
    headers[0].ljust(widths[0]),
    headers[1].center(widths[1]),
    headers[2].rjust(widths[2])
])
print(header_line)
print("-" * len(header_line))

# 模拟数据输出
tasks = [
    ("TASK-101", "RUNNING", "1.45s"),
    ("TASK-1024", "SUCCESS", "12.80s"),
    ("TASK-9", "PENDING", "0.00s"),
]

for tid, status, dur in tasks:
    line = " ".join([
        tid.ljust(widths[0]),
        status.center(widths[1]),
        dur.rjust(widths[2])
    ])
    print(line)
ljust 系列方法的优势是语义非常直观,适合已经拼接完成的字符串数组。但由于它无法直接处理浮点数的小数位格式化,数值类型通常需要先调用 str() 或格式化后再进行填充。
四、攻克难点:中英混排时的“视觉不对齐”与东亚宽字符补偿
在涉及中文商品名、用户姓名或本地化提示时,很多开发者会发现:哪怕使用了 f"{name:<10}",控制台输出依然发生严重错位。
1. 错位的根本症结
根本原因在于字符串字符数量与终端显示宽度不一致。Python 内置的 len() 以及 f-string 的 width 计数,都是按照 Unicode 代码点(Code Point)计算的。例如字符串 "苹果" 的 len() 值为 2,执行 f"{'苹果':<10}" 时,Python 认为当前长度为 2,因此会在其后补上 8 个普通空格。
但在等宽终端(Monospace Terminal)中,汉字属于全角字符(Fullwidth),每一个汉字实际占据 2 个半角字符的显示单元(Display Columns)。因此,“两个汉字 + 8个空格”在屏幕上实际占据了 2 * 2 + 8 = 12 个列单元,比起英文字符串 "Apple" 占据的 10 个列单元多出了整整 2 格,错位由此产生。
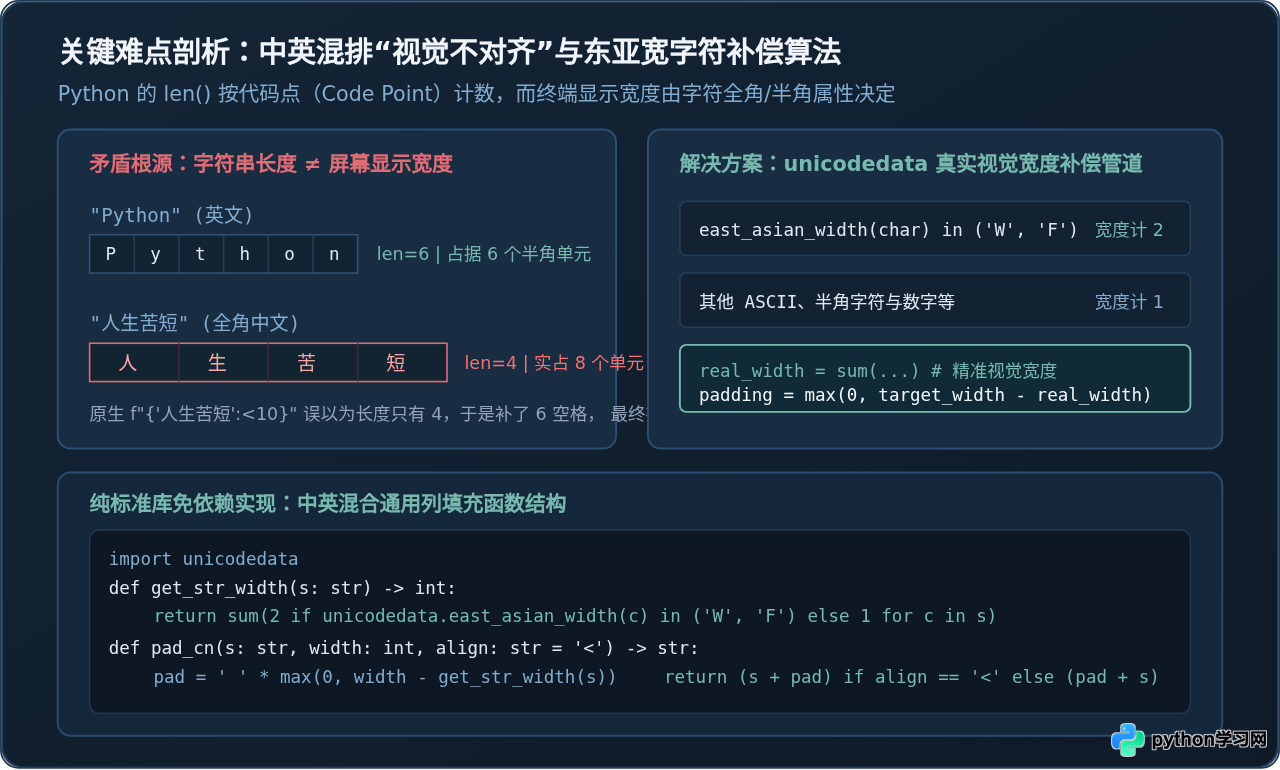
2. 基于 unicodedata 的标准库补偿方案
解决这一难题的最佳工程手段,是利用 Python 标准库中的 unicodedata.east_asian_width() 函数。该函数依据 Unicode 标准报告每个字符的东亚宽度属性:
'W'(Wide,宽字符)与'F'(Fullwidth,全角字符):显示时占用 2 个列宽度。'Na'(Narrow,窄字符)、'H'(Halfwidth,半角字符)与'N'(Neutral,中性字符):显示时占用 1 个列宽度。
我们可以据此编写一个高度健壮、无需任何第三方依赖的宽字符补偿对齐函数:
import unicodedata

def get_display_width(text: str) -> int:
    """计算字符串在终端等宽字体下的实际显示单元格宽度"""
    width = 0
    for char in str(text):
        # W (Wide) 和 F (Fullwidth) 在终端中显示为双倍宽度
        if unicodedata.east_asian_width(char) in ('W', 'F'):
            width += 2
        else:
            width += 1
    return width

def pad_display(text: str, target_width: int, align: str = '<') -> str:
    """
    根据视觉显示宽度对字符串进行补齐,消除中英混排错位
    align 支持 '<' (左对齐), '>' (右对齐), '^' (居中对齐)
    """
    s = str(text)
    current_w = get_display_width(s)
    padding_count = max(0, target_width - current_w)

    if align == '>':
        return (' ' * padding_count) + s
    elif align == '^':
        left_pad = padding_count // 2
        right_pad = padding_count - left_pad
        return (' ' * left_pad) + s + (' ' * right_pad)
    else:  # 默认左对齐 '<'
        return s + (' ' * padding_count)

# 验证测试:中英文混合列表对齐
records = [
    ("红富士苹果", 15.80, "特选一级"),
    ("Banana", 3.20, "进口优质"),
    ("有机西瓜", 28.50, "当季热卖"),
    ("Kiwi 果", 8.90, "促销"),
]

col_name = 16
col_price = 10
col_tag = 12

# 打印表头
header = (
    pad_display("商品品名", col_name, '<') + " " +
    pad_display("零售单价", col_price, '>') + " " +
    pad_display("规格标签", col_tag, '<')
)
print(header)
print("-" * get_display_width(header))

# 打印数据
for name, price, tag in records:
    price_str = f"{price:.2f}"
    line = (
        pad_display(name, col_name, '<') + " " +
        pad_display(price_str, col_price, '>') + " " +
        pad_display(tag, col_tag, '<')
    )
    print(line)
运行结果表明,无论字符串由纯中文、纯英文还是中英混杂组成,第二列和第三列的起跑线完全在一条垂直线上,彻底消除了视觉错位。
五、工业级方案:使用成熟的表格排版库
在复杂的报表、日志导出或运维 CLI 工具中,如果表格包含动态多列、自适应终端换行、多级表头或丰富的边框修饰,完全手写对齐代码可能会增加维护负担。此时引入成熟的专业表格库是更高效的选择。
1. 轻量通用工具:tabulate
tabulate 专注于将结构化数据(列表、字典、元组)转换为格式整洁的纯文本表格,支持多种流行风格(如 grid、github、pipe),且能自动计算每列的最大宽度。
from tabulate import tabulate

table_data = [
    ["WebServer-01", "192.168.1.10", "Active", "0.12%"],
    ["DBCluster-Primary", "192.168.1.25", "Active", "2.45%"],
    ["Cache-Redis-B", "192.168.1.30", "Degraded", "14.80%"],
]

headers = ["Node Name", "IP Address", "Status", "CPU Load"]

# 使用 grid 风格输出整洁网格
print(tabulate(table_data, headers=headers, tablefmt="grid"))
2. 现代化交互式终端 UI:Rich
如果项目针对现代终端开发,rich 是当下的黄金标准。其 Table 组件天然支持东亚宽字符计算、控制台宽度自适应、单元格换行、丰富色彩渲染及对齐配置:
from rich.console import Console
from rich.table import Table

console = Console()
table = Table(title="服务节点运行健康状态", show_lines=True)

# 添加列,明确指定对齐方向与样式
table.add_column("服务实例", justify="left", style="cyan", no_wrap=True)
table.add_column("部署区域", justify="center", style="magenta")
table.add_column("当前延迟", justify="right", style="green")
table.add_column("健康检查", justify="center")

table.add_row("北京核心网关", "华北一区", "12 ms", "[bold green]PASS[/bold green]")
table.add_row("上海计费系统", "华东二区", "45 ms", "[bold green]PASS[/bold green]")
table.add_row("海外同步节点", "亚太三区", "180 ms", "[bold yellow]WARN[/bold yellow]")

console.print(table)
六、总结与技术选型建议
替代 制表符并不存在单一的万能钥匙,关键在于根据数据字符特征、项目外部依赖约束以及终端交互复杂性做出最合适的架构选择:
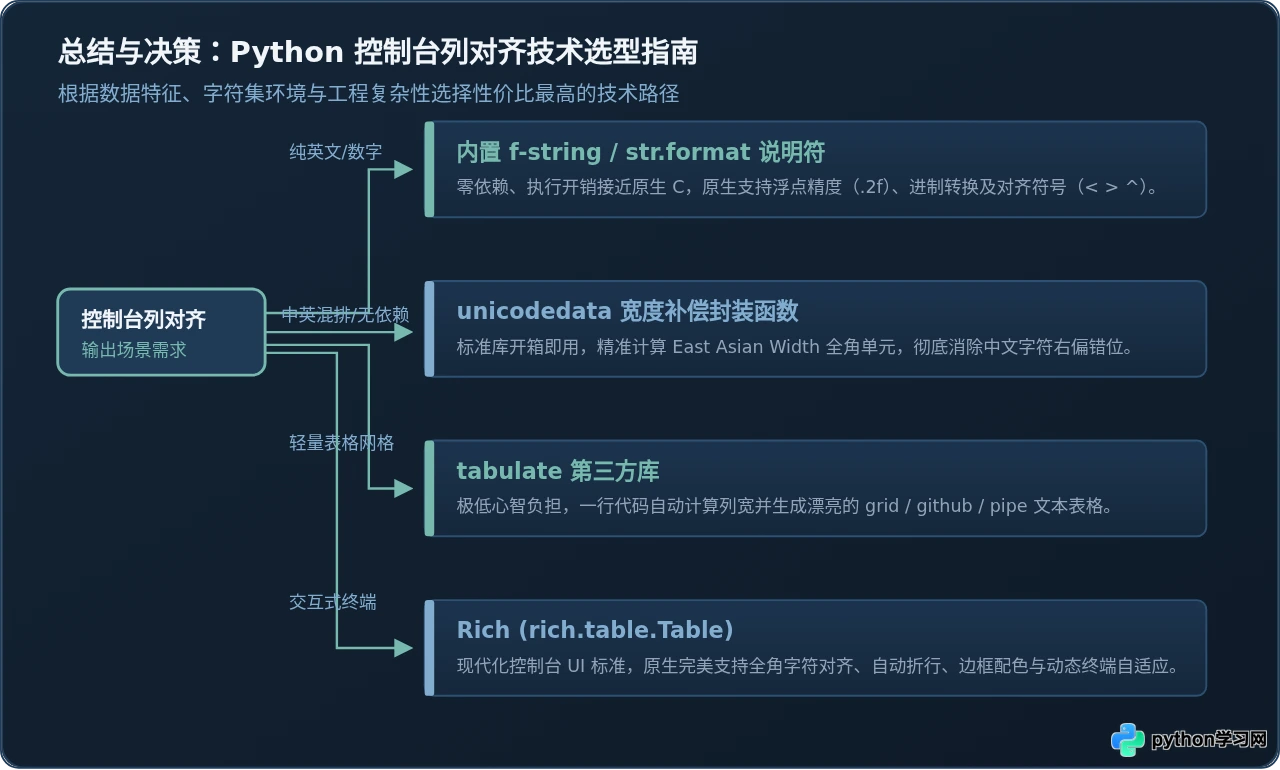
| 方案类型 | 典型语法 / 核心函数 | 外部依赖 | 适用场景与核心优势 |
|---|---|---|---|
| f-string 格式符 | f"{val:<15} {num:>8.2f}" |
无(内置语法) | 纯英文、数字或定长字符排版;运行性能最高,支持丰富的精度控制。 |
| 字符串方法 | s.ljust(w), s.rjust(w) |
无(内置方法) | 单个字符串的简单补齐或基于预先处理好的字符串数组拼接。 |
| unicodedata 补偿 | unicodedata.east_asian_width |
无(标准库) | 中英混排、包含全角符号的轻量级脚本,彻底解决中文字符列错位。 |
| tabulate 库 | tabulate(data, headers) |
tabulate | 纯文本报告、Markdown 文档生成、CLI 打印规整数据表格。 |
| Rich 终端框架 | rich.table.Table |
rich | 生产级 CLI 工具、复杂监控大屏、需彩色展示与动态宽度自适应的场景。 |
f"{col:<12}" 代替 f"{col} ";一旦业务涉及中文内容,引入两行的 unicodedata 宽度求和即可构建坚固的对齐屏障;在面对正式交付的工程项目时,果断采用成熟的结构化表格工具。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















