


Python字符串最常用的5个方法:split、join、replace、strip与format详解
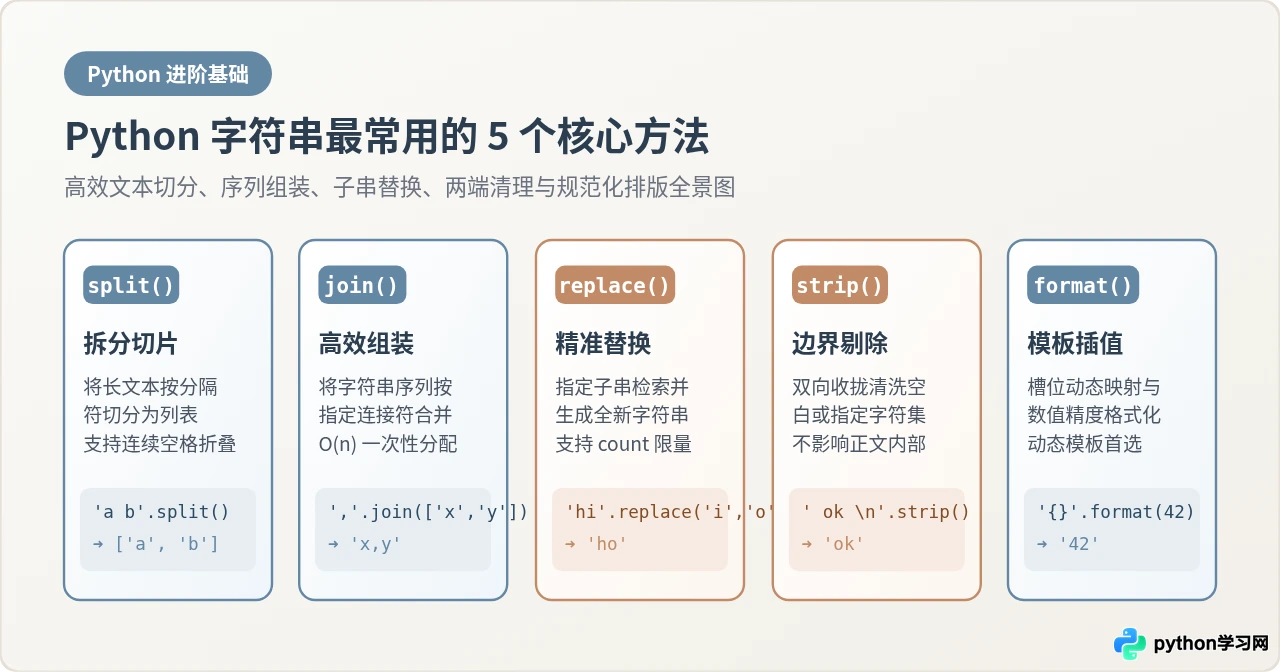
深入解析Python最常用的5个内置字符串方法:split、join、replace、strip与format。从底层不可变性、参数细节、内存性能到易错陷阱,结合实战代码与完整内联图解全面掌握。
在 Python 文本处理中,字符串(str)属于不可变序列(immutable)。这意味着任何对字符串的修改操作都不会直接改变原有对象,而是通过计算在内存中生成全新的字符串或列表。掌握 split、join、replace、strip 与 format 这 5 个最高频的方法,便足以应对绝大部分文本清洗、字段拆分、格式对齐与动态组装任务。本文通过底层运行机制、核心语法、典型示例与易错边界,逐一拆解这些方法的最佳实践。
一、split():字符串拆分与切片
split() 的核心任务是将一个连贯的长字符串,按照指定规则切分成若干子字符串,并以 list 列表的形式返回。它广泛应用于解析逗号分隔文件(CSV)、服务器访问日志、命令行参数以及分词统计场景。
1. 核心语法与参数机制
str.split(sep=None, maxsplit=-1)sep:指定用于拆分的分隔符。默认值为None。maxsplit:最大拆分次数。默认值为-1,表示不限制拆分次数,拆分所有匹配项。如果指定为正整数 n,则仅从左到右执行 n 次拆分,剩余部分作为一个整体保留在列表末尾。
2. 关键细节:sep=None 与 sep=" " 的本质差异
初学者极易忽视 sep 取默认值 None 与显式传入单个空格 sep=" " 之间的巨大区别:
sep=None(默认行为):Python 会将任意连续的空白字符(包括普通空格、制表符""。sep=" "(显式单个空格):严格按照单个 ASCII 空格字符精确比对。一旦遇到两个相邻的空格,两者之间就会产生一个长度为 0 的空字符串""项。
raw_text = "  python   java 	 c++
 go  "

# 默认行为:自动折叠任意连续空白
res_default = raw_text.split()
# 显式指定空格:保留空项
res_space = raw_text.split(" ")

print("res_default:", res_default)
print("res_space:", res_space)res_space: ['', '', 'python', '', '', 'java', ' ', 'c++', ' ', 'go', '', '']
s.split(),切勿画蛇添足地传入 s.split(" ")。只有在字段结构严格固定(例如以单个空格作为字段占位符的固定协议)时,才需要显式指定 sep=" "。
3. 利用 maxsplit 限制拆分粒度
在解析 "key=value" 键值对或日志时,内容本身可能也包含等号或空格。此时通过设定 maxsplit=1,可以精准提取键名并安全保留剩余值。
config_line = "database_url=postgres://user:pwd@localhost:5432/app_db"
key, val = config_line.split("=", maxsplit=1)

print("Key:", key)
print("Value:", val)Value: postgres://user:pwd@localhost:5432/app_db
二、join():高效序列拼接与逆运算
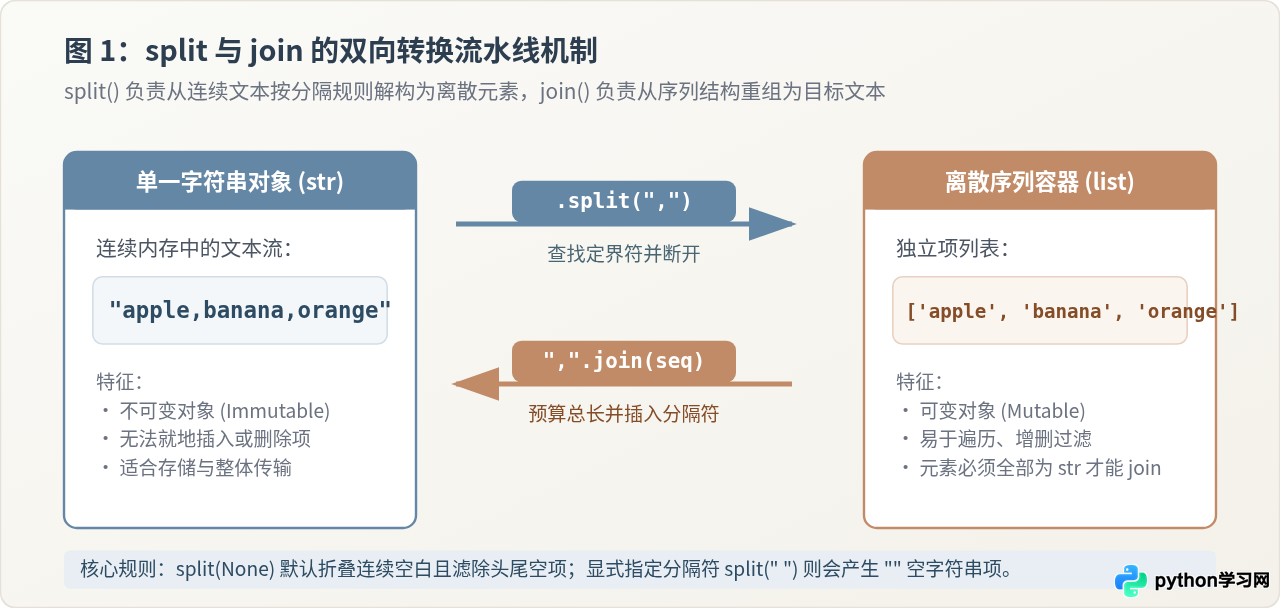
join() 是 split() 的互逆操作。它的职责是取出一个由字符串构成的可迭代容器(如 list、tuple、set),在每两个元素之间插入指定的连接字符串,最终融合成一个统一的 str 对象。
1. 核心语法与设计哲学
separator.join(iterable)许多刚接触 Python 的读者常产生疑问:为什么不是 list.join(separator),而是 separator.join(list)?这是因为 Python 遵循统一的迭代器协议:iterable 可以是列表、元组、生成器表达式甚至集合,而不需要强制要求必须是 list 的实例;将该方法定义在作为连接符的 str 上,能保证对所有序列类型一致可用。
2. 性能真相:为什么杜绝在循环中用 += 拼接?
由于 Python 字符串不可变,每次执行 s += item 时,底层解释器都必须新开辟一块内存,将原有字符串全部复制过去,再复制新追加的字符。在一个包含 n 个元素的循环中,时间复杂度将恶化为 O(n²)。
而 join() 在底层由 C 实现,会预先遍历一次序列计算出所有子项及连接符的总长度,一次性向系统申请所需的内存空间,随后直接按偏移量写入各子串,时间复杂度仅为线性 O(n),在处理数万级数据时性能差距可达百倍。
# 高效拼接序列
words = ["2026", "10", "31"]
date_str = "-".join(words)

# 与生成器表达式结合:将数值序列安全转为字符串拼接
ids = [101, 102, 103, 104]
sql_in_clause = ",".join(str(i) for i in ids)

print("Date:", date_str)
print("SQL Clause:", sql_in_clause)SQL Clause: 101,102,103,104
join() 要求待连接序列中的所有元素都必须是 str 类型。如果列表中混入了 int、float 或 None,解释器将立即抛出 TypeError: sequence item X: expected str instance。必须先通过列表推导式或 map(str, seq) 完成类型转换。
三、replace():精确查找与内容替换
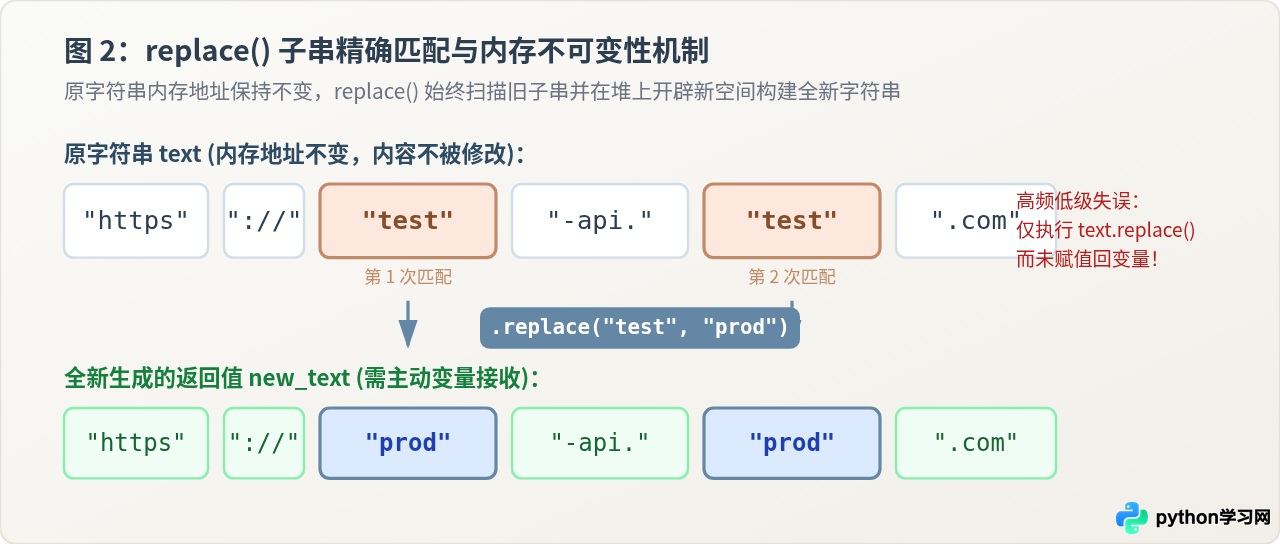
replace() 提供了字符串内部子串的精确检索与置换能力。无论用于批量消除特殊标点、替换敏感词汇还是修改路径中的分隔符,它都是最高效直接的工具。
1. 核心语法与参数机制
str.replace(old, new, count=-1)old:被查找的目标子字符串。new:用于替换的新子字符串。count:可选参数,指定最大替换次数。默认全量替换;若传入正整数,则仅从左往右替换前count次。
2. 常见低级错误:忘记重新赋值
由于不可变性,在原字符串上调用 text.replace("old", "new") 绝不会改变 text 本身。必须将返回值重新赋值给原变量或新变量:
origin = "Error: Code 404, Error: Page Missing"

# 错误写法:返回值未被接收,origin 依旧保持原样
origin.replace("Error", "Warning")
print("未赋值状态:", origin)

# 正确写法:重新绑定变量
updated = origin.replace("Error", "Warning", 1)  # 仅替换第 1 处
print("限制替换后:", updated)限制替换后: Warning: Code 404, Error: Page Missing
3. 链式替换技巧与边界
在简单文本规整任务中,可以连续调用 .replace() 形成链式管道,依次清理多个脏字符。但请注意:replace() 只支持确定性的字面常量子串,不支持通配符或正则表达式。若需要根据模式(如匹配所有手机号、匹配复杂邮箱)进行动态替换,应使用标准库 re.sub()。
dirty_phone = "+86 (010) 8888-9999"
clean_phone = (
    dirty_phone.replace("+86", "")
               .replace("(", "")
               .replace(")", "")
               .replace("-", "")
               .replace(" ", "")
)
print("Clean Phone:", clean_phone)四、strip():两端清洗与边界收拢
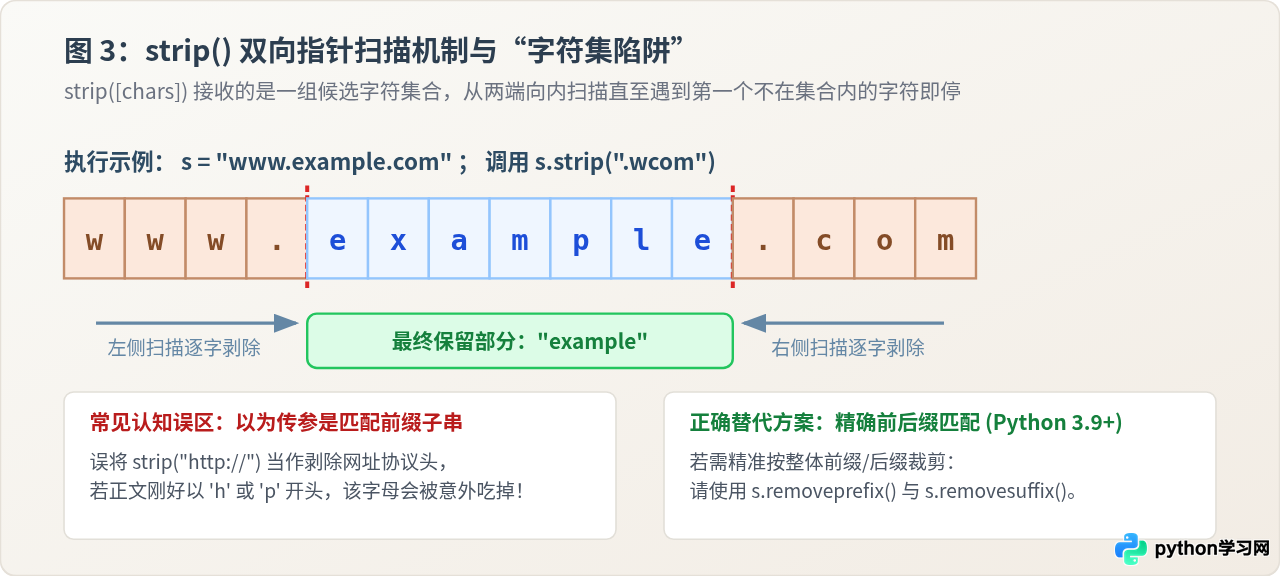
strip() 专门用于剥除字符串头部(左侧)与尾部(右侧)的无用内容,其兄弟方法还包括仅处理左侧的 lstrip() 与仅处理右侧的 rstrip()。它们从不触碰位于字符串中间正文的任何字符。
1. 核心语法与默认行为
str.strip([chars])
str.lstrip([chars])
str.rstrip([chars])
在不传 chars 参数时,strip() 默认剔除两端所有的空白字符(空格、 、
、 、 等)。这在读取文本文件时极为普遍——每行末尾通常自带换行符
,调用 line.rstrip("
") 或 line.strip() 即可快速恢复纯净内容。
2. 最具隐蔽性的陷阱:chars 是“字符集合”而非“前缀子串”
这是 Python 字符串处理中最高频的失误之一:chars 参数传入的是由候选字符组成的无序集合,而非一个严格按顺序匹配的固定单词或前缀。
其执行算法为:从字符串最外侧向内逐字符检查,只要该字符存在于 chars 集合中,就将其抹除;一旦遇到第一个不在 chars 集合内的字符,扫描立即停止。
url = "www.example.com"

# 开发者本意:想剥除 "www." 前缀与 ".com" 后缀
result = url.strip(".wcom")
print("strip 结果:", result)

# 危险案例:误将 strip 当作剥除前缀
bad_prefix_test = "http://hotel.com".strip("http://")
print("误删前缀测试:", bad_prefix_test)误删前缀测试: otel.com
"http://hotel.com".strip("http://") 本意是去掉协议头。但因为 hotel.com 的首字母 'h' 也恰好在 chars(包含了 h, t, p, :, /)集合中,导致左侧指针继续吞掉了 'h',最终产生残缺的 otel.com!
3. Python 3.9+ 的精准解法:removeprefix 与 removesuffix
如果你需要根据完整确定的前缀或后缀进行切除,请使用 Python 3.9 专门引入的 removeprefix() 与 removesuffix(),它们只执行严格的整词匹配:
secure_url = "http://hotel.com"
true_domain = secure_url.removeprefix("http://")
print("精准前缀剥除:", true_domain)五、format():动态文本组装与规范化输出
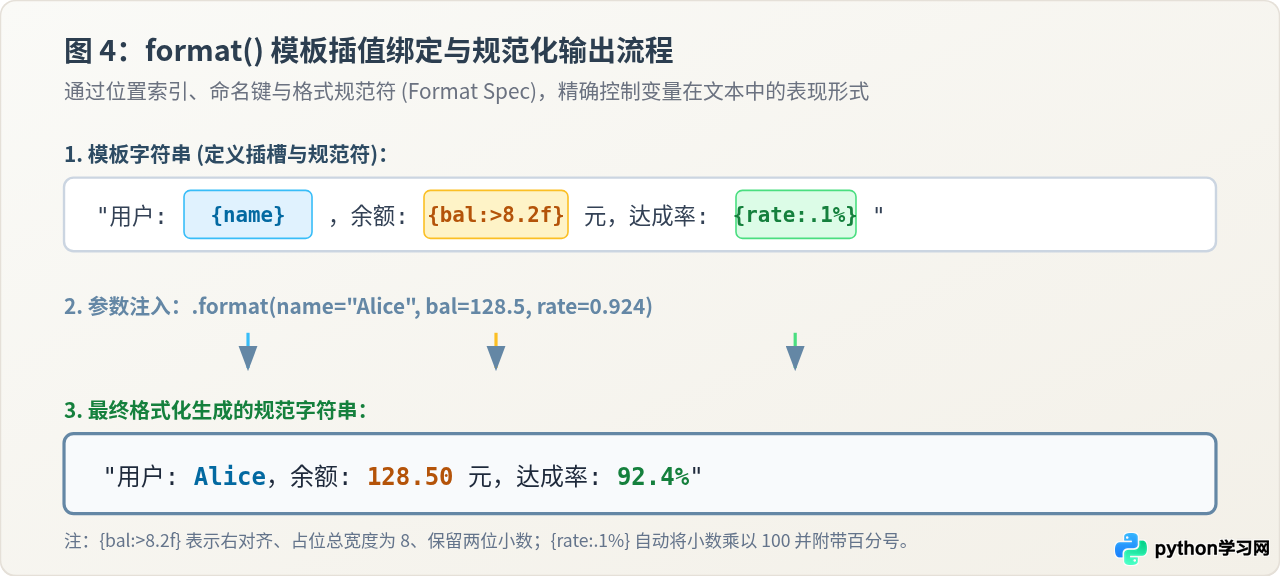
format() 是 Python 强大而灵活的格式化字符串方法。它通过在模板字符串中嵌入由花括号 {} 包裹的占位符,支持按位置、按关键字映射变量,并能附加丰富的格式规范说明符(Format Specification Mini-Language)实现对齐、填充与数值截断。
1. 占位符三大注入模式
- 自动顺位编号:
"Hello, {} and {}".format("Alice", "Bob") - 显式位置索引:
"{1} 优于 {0},再次强调 {1}".format("旧方案", "新方案"),支持重复复用同一参数。 - 关键字命名参数:
"坐标:X={x}, Y={y}".format(x=10, y=25),语义直观清晰,顺序无关。
2. 核心格式控制符(对齐、宽度与数值精度)
在占位符冒号 : 后面可以追加格式控制参数:
- 浮点数与小数位截断:
{:.2f}保留 2 位小数,采用四舍五入规则。 - 百分比展示:
{:.1%}自动乘以 100 并以 1 位小数附带%输出。 - 千分位分隔符:
{:,}为大数字自动按千位插入逗号(如1,000,000)。 - 宽度与对齐:
{:<10}左对齐,{:>10}右对齐,{:^10}居中对齐,支持指定填充符号如{:*^10}。
template = "商品: {name:<8} | 单价: ¥{price:>8.2f} | 折扣率: {disc:>6.1%} | 库存: {stock:,}"

print(template.format(name="机械键盘", price=399.5, disc=0.15, stock=12500))
print(template.format(name="鼠标垫", price=29.9, disc=0.05, stock=850))商品: 鼠标垫 | 单价: ¥ 29.90 | 折扣率: 5.0% | 库存: 850
3. format 与 f-string 的场景选型
在 Python 3.6 之后,代码内联场景推荐使用语法更为精炼的 f"{var}"(f-string)。但在以下工程场景中,str.format() 具有不可替代的优势:
- 模板外置与解耦:模板字符串保存在数据库、JSON 配置文件或国际化(i18n)多语言资源包中,在运行时由业务逻辑动态加载并填充。
- 延迟渲染:模板在程序初始化阶段定义,待请求参数抵达后再注入,无需在定义模板的作用域内提前持有变量。
format() 占位符的模板中输出真正的花括号字符本身,请使用双写形式转义:"{{保留自身大括号}}" 将输出 "{保留自身大括号}"。
六、实战串联与方法选型对比
在实际开发中,这 5 个方法往往组合协同工作。下面展示一段典型的脏数据清洗脚本:去除两端杂质空白、拆分有效字段、替换格式错误、标准化填充并重组成清晰的输出日志。
# 模拟从外部文件读取的脏数据行
raw_record = "  USER_092#2026-10-31#  450.789 #status:pending  \n"

# 1. strip 清除两端空白与换行
clean_line = raw_record.strip()

# 2. split 按井号拆分 4 个字段
parts = clean_line.split("#")

# 3. 提取字段并进一步清洗
uid = parts[0]
date = parts[1]
amount = float(parts[2].strip())
status_raw = parts[3].strip()

# 4. replace 将内部老旧标识统一
status_clean = status_raw.replace("pending", "processing")

# 5. format 规范化组织汇报信息
report_item = "订单[{0}] 日期:{1} 金额:¥{2:>8.2f} 当前状态:[{3}]".format(
    uid, date, amount, status_clean
)

print(report_item)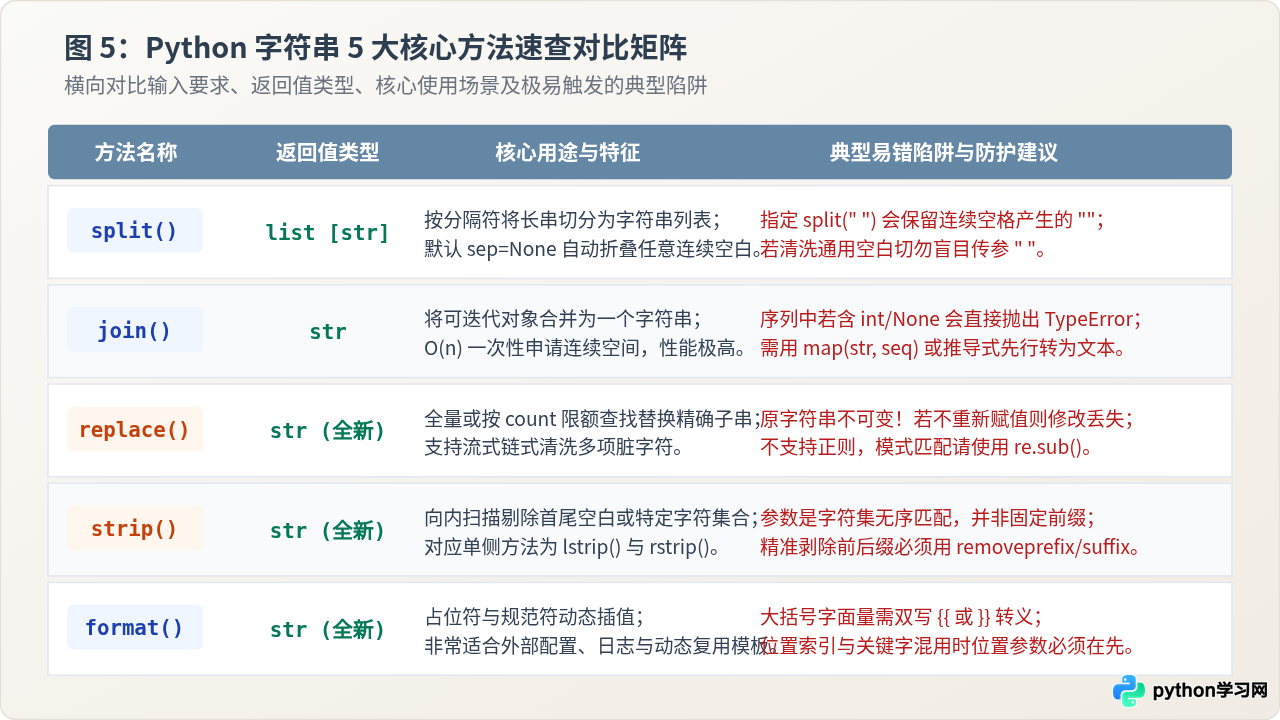
七、总结
处理 Python 字符串时,牢记不可变性是理解一切行为的根基:
- 需要将单一文本分散为局部单元时,用
split();清洗文本多余空格直接调用无参版本。 - 需要将序列融汇为连贯文本时,用
join(),警惕循环内部累加+=带来的性能灾难。 - 需要做确定性的局部更新时,用
replace(),务必使用变量接收返回值。 - 需要修剪两端外部游离字符时,用
strip(),切记其判定逻辑基于无序字符集合。 - 需要做复杂的结构化格式输出与模板复用时,用
format()。
将上述五个方法的底层原理与边界陷阱熟记于心,便能在处理各类文本解析、日志提取与数据清洗场景时胸有成竹、游刃有余。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















