


Python代码中处理中文字符串避免UnicodeEncodeError
深入解析在Python代码中处理中文字符串时触发UnicodeEncodeError的底层机理,提供文件读写、控制台重定向、子进程通信及环境变量配置的完整实操解决方案与容错工程规范。
在 Python 代码中出现 UnicodeEncodeError 的根本原因,是程序尝试将内存中的 Unicode 字符串(str)转换为物理字节序列(bytes)时,所选用的目标编码表(如 ASCII、系统默认代码页或非 UTF-8 字符集)无法映射其中的中文字符。彻底解决这一问题的路径主要包括两个维度:在代码逻辑中为所有文件读写、日志与子进程调用显式声明 encoding='utf-8';在运行环境层面通过配置 PYTHONUTF8=1 或调用 sys.stdout.reconfigure() 重构标准流编码。
一、报错表现与底层触发机理
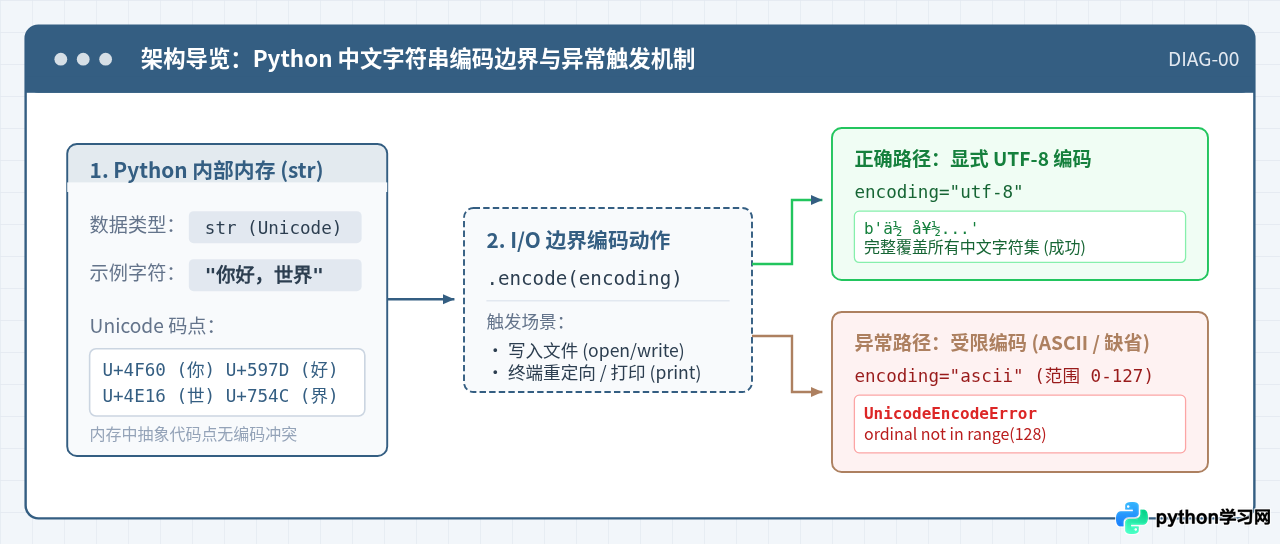
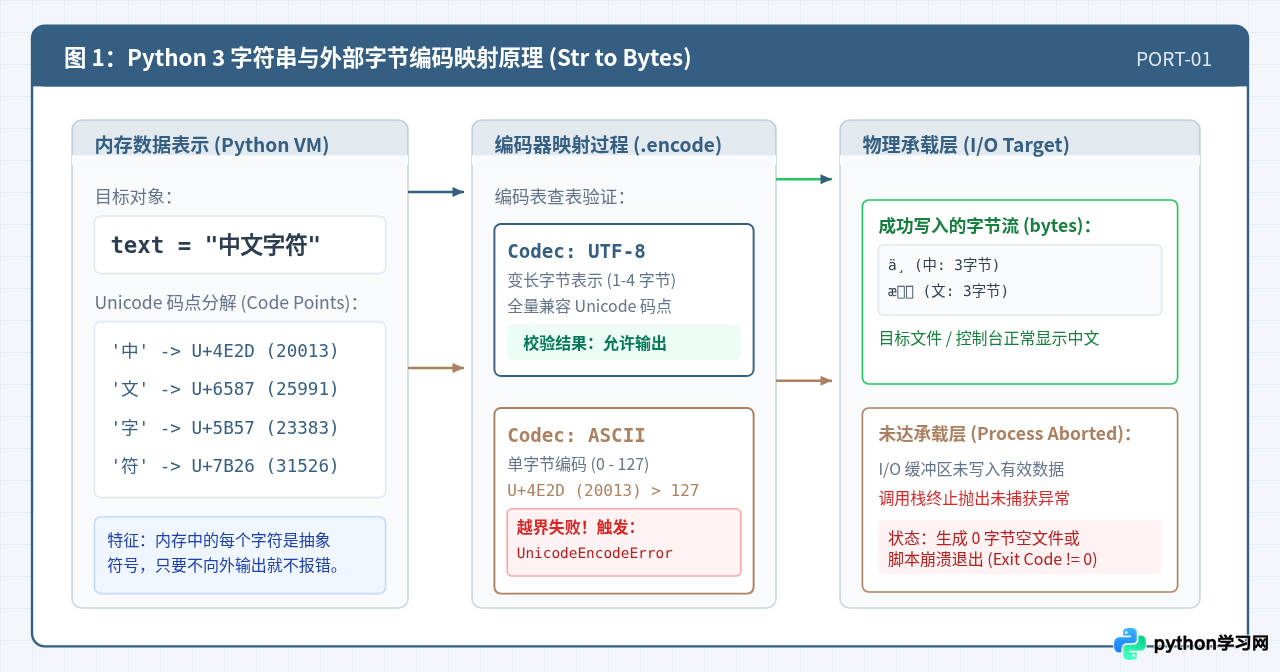
在 Python 3 中,所有字符串(str)在内存中统一以 Unicode 码点序列(Code Points)的形式存在,例如中文字符“中”在内存中表示为抽象数值 U+4E2D(十进制 20013)。只要数据仅在 Python 虚拟机的变量、字典或函数参数之间传递,就不会涉及编码计算,也不会触发异常。
只有当数据需要跨越边界输出到外部世界——包括写入磁盘文件、打印到控制台屏幕、重定向至管道、写入 Socket 套接字或传递给操作系统子进程时,Python 必须将 Unicode 字符编码(Encode)为由二进制八位字节构成的 bytes 对象。如果指定的编码规范不支持该字符,就会直接阻断运行并抛出异常:
# 典型报错信息示例
Traceback (most recent call last):
  File "export_data.py", line 18, in <module>
    f.write(user_content)
UnicodeEncodeError: 'ascii' codec can't encode characters in position 0-1: ordinal not in range(128)
上述报错信息清晰地揭示了三个关键事实:
- 使用的编码器(Codec):当前操作使用的是
'ascii'编码器。 - 失败原因:ASCII 编码只定义了 0 到 127 范围内的 128 个基本字符,而中文字符的 Unicode 码点均远超 127。
- 故障发生点:发生在向外部目标写入的时刻,而不是字符串在内存中创建的时刻。
二、常见触发场景排查与诊断
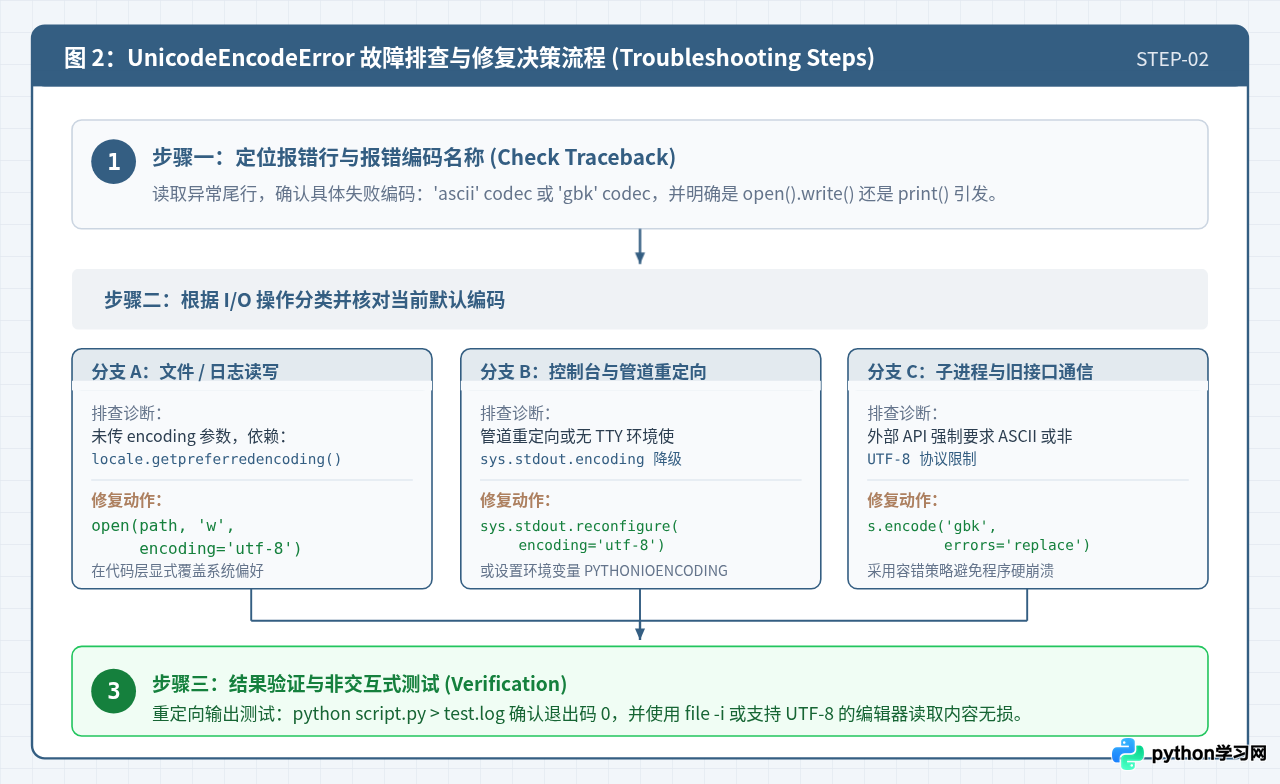
在实际工程开发与运维部署中,UnicodeEncodeError 通常隐藏在本地开发环境与线上生产环境的差异中。以下是三类最典型的触发场景及排查路径:
1. 文件写入未指定编码(依赖宿主系统的 Locale)
许多开发者习惯直接书写 open('data.txt', 'w')。在没有显式传递 encoding 参数时,Python 会调用底层的 locale.getpreferredencoding(False) 获取操作系统的默认字符集。在中文 Windows 系统下,该值通常是 cp936(GBK),当文本中含有 GBK 编码表未收录的生僻汉字、Emoji 或特定标点时,便会报错;在未正确配置 Locale 的 Linux 基础 Docker 容器或云函数中,系统默认编码极易回退为 ascii 或 ANSI_X3.4-1968,导致任何普通汉字在写入时直接崩溃。
2. 控制台输出重定向或 Cron 后台任务
本地在终端交互式执行 python main.py 时可以正常打印中文,但使用 nohup python main.py > output.log & 或配置在 Linux crontab 定时任务中执行时却频频报错。这是因为交互式终端(TTY)会协商编码并告知 Python 终端支持 UTF-8,而一旦标准输出被重定向到管道或文件,Python 的标准流就无法检测到 TTY,会将 sys.stdout.encoding 降级为默认的 ASCII 编码。
3. 外部子进程(subprocess)交互
在使用 subprocess.Popen 或 subprocess.run 向外部 CLI 工具发送或接收中文字符串时,若设置了 text=True 但未指定 encoding='utf-8',子进程管道同样会采用系统偏好编码,从而导致输入缓冲区编码中断。
三、具体修复方法与标准代码范式
针对上述触发原因,应按照操作规范对各个数据流通道实施显式编码控制,避免将编码决策权交给不确定的外部环境。
1. 规范文件读写与日志处理
在所有涉及文件落盘的操作中,必须一律显式传入 encoding='utf-8' 参数。无论是内建的 open() 函数、pathlib.Path 还是标准库 logging,均应保持这一工程习惯:
# 正确范式:基础文本写入
file_path = "output_report.txt"
chinese_text = "核心业务数据报表:处理成功"

# 始终显式声明 encoding='utf-8'
with open(file_path, mode="w", encoding="utf-8") as file_handle:
    file_handle.write(chinese_text)

# 正确范式:标准库日志配置
import logging

logger = logging.getLogger("service_logger")
logger.setLevel(logging.INFO)

# 确保 FileHandler 显式指定 UTF-8 编码,避免在后台日志记录时抛出异常
file_handler = logging.FileHandler("runtime.log", mode="a", encoding="utf-8")
formatter = logging.Formatter("%(asctime)s - %(levelname)s - %(message)s")
file_handler.setFormatter(formatter)
logger.addHandler(file_handler)

logger.info("中文字符日志记录正常,避免编码冲突。")
2. 重构标准输入输出流(sys.stdout / sys.stderr)
如果业务代码中存在大量现有的 print() 语句,且脚本经常在 CI/CD 容器、重定向管道或自动化运维工具中运行,可在程序主入口(main.py)的最顶层使用 Python 3.7+ 提供的 reconfigure 方法重新配置标准输出流:
import sys

# 检查并在入口处直接将标准输出与标准错误流重构为 UTF-8 编码
if hasattr(sys.stdout, "reconfigure"):
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")
if hasattr(sys.stderr, "reconfigure"):
    sys.stderr.reconfigure(encoding="utf-8", errors="replace")

# 后续的所有 print 调用均可安全处理各类中文字符
print("当前标准输出编码已确认:", sys.stdout.encoding)
print("输出包含中文字符与生僻字:测试完成。")sys.stdout.reconfigure() 是在 Python 运行时内部动态更改流的缓冲区封装。如果在第三方库加载之前就已经在控制台输出了内容,建议配合下文的环境变量方案一同使用。
3. 子进程通信显式指定编码
调用系统命令或跨进程传递中文参数时,务必在 subprocess 参数中加入编码定义:
import subprocess

# 正确示范:与外部进程通过文本通道交互中文字符
process = subprocess.run(
    ["echo", "传递中文参数"],
    capture_output=True,
    text=True,
    encoding="utf-8"  # 显式指定子进程管道编码
)
print("子进程返回内容:", process.stdout.strip())
四、字符编码容错与兜底策略(errors 参数)
在部分极端网络协议交互、旧式硬件设备指令通信或第三方受限代码页接口中,目标系统可能强制要求采用 GBK 或 ASCII 等受限字符集,无法使用 UTF-8。此时如果直接调用 .encode('gbk'),遇到不可表示的字符依然会抛出 UnicodeEncodeError。
Python 提供了 errors 参数来定义编码失败时的应对策略:
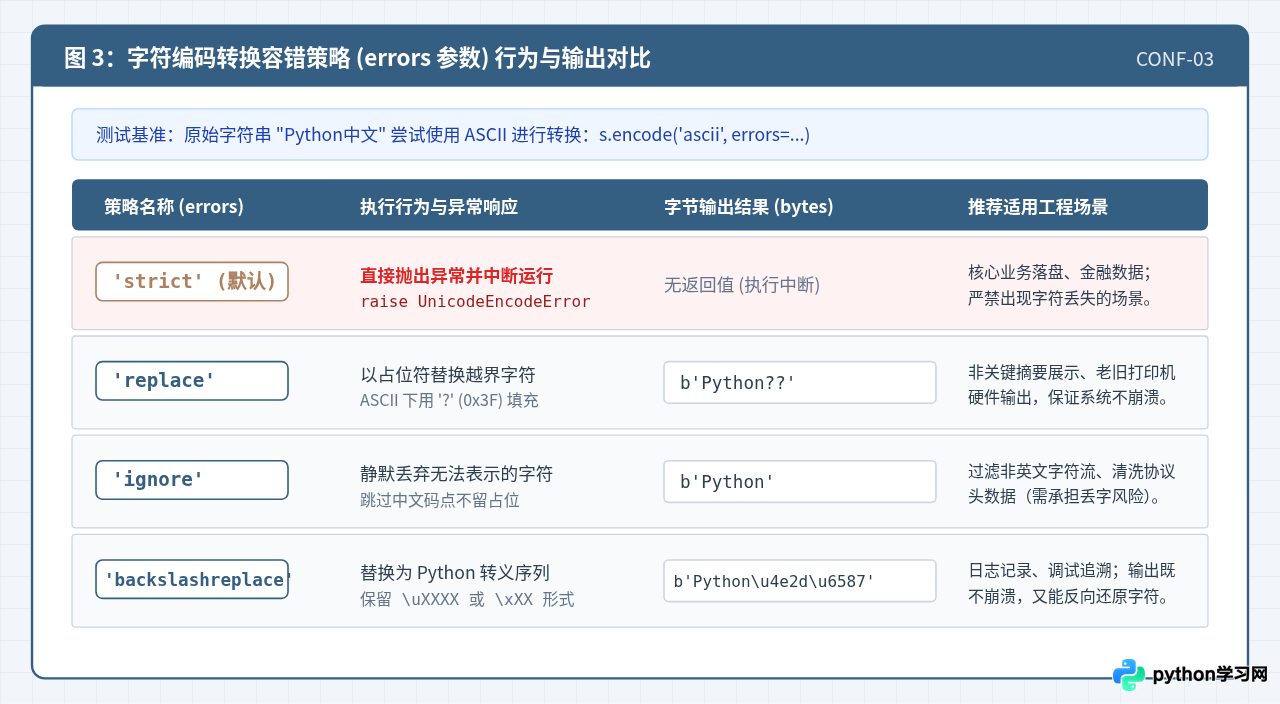
常用的 errors 处理策略及其代码实例如下:
source_text = "设备指令: A-102 (温度阈值)"

# 策略 1:'strict'(默认值)
# 无法编码时直接抛出异常,适用于金融落盘等强一致性场景
try:
    encoded_bytes = source_text.encode("ascii", errors="strict")
except UnicodeEncodeError as err:
    # 捕获异常进行告警与回滚
    print("strict 策略捕获到异常:", err)

# 策略 2:'replace'
# 无法编码的字符自动替换为系统占位符(ASCII 下为 '?')
safe_replace = source_text.encode("ascii", errors="replace")
print("replace 策略结果:", safe_replace)
# 示例输出:b'???: A-102 (????)'

# 策略 3:'ignore'
# 静默略过所有非 ASCII 字符(注意:会导致文本内容确实丢失)
safe_ignore = source_text.encode("ascii", errors="ignore")
print("ignore 策略结果:", safe_ignore)
# 示例输出:b': A-102 ()'

# 策略 4:'backslashreplace'(工程调试首选)
# 将不能编码的字符替换为标准 Python 字符串转义格式(\uXXXX)
# 既保证物理通道为 100% 纯 ASCII,又完整保留了字符语义,可无损逆向还原
safe_debug = source_text.encode("ascii", errors="backslashreplace")
print("backslashreplace 结果:", safe_debug)
# 示例输出:b'\u8bbe\u5907\u6307\u4ee4: A-102 (\u6e29\u5ea6\u9608\u503c)'
五、工程化四层防御体系与上线前验证
为了从根本上消除多节点部署、容器化调度过程中的编码隐患,建议在项目架构层面建立覆盖环境、运行时、业务代码和通信兜底的“四层工程防御体系”。
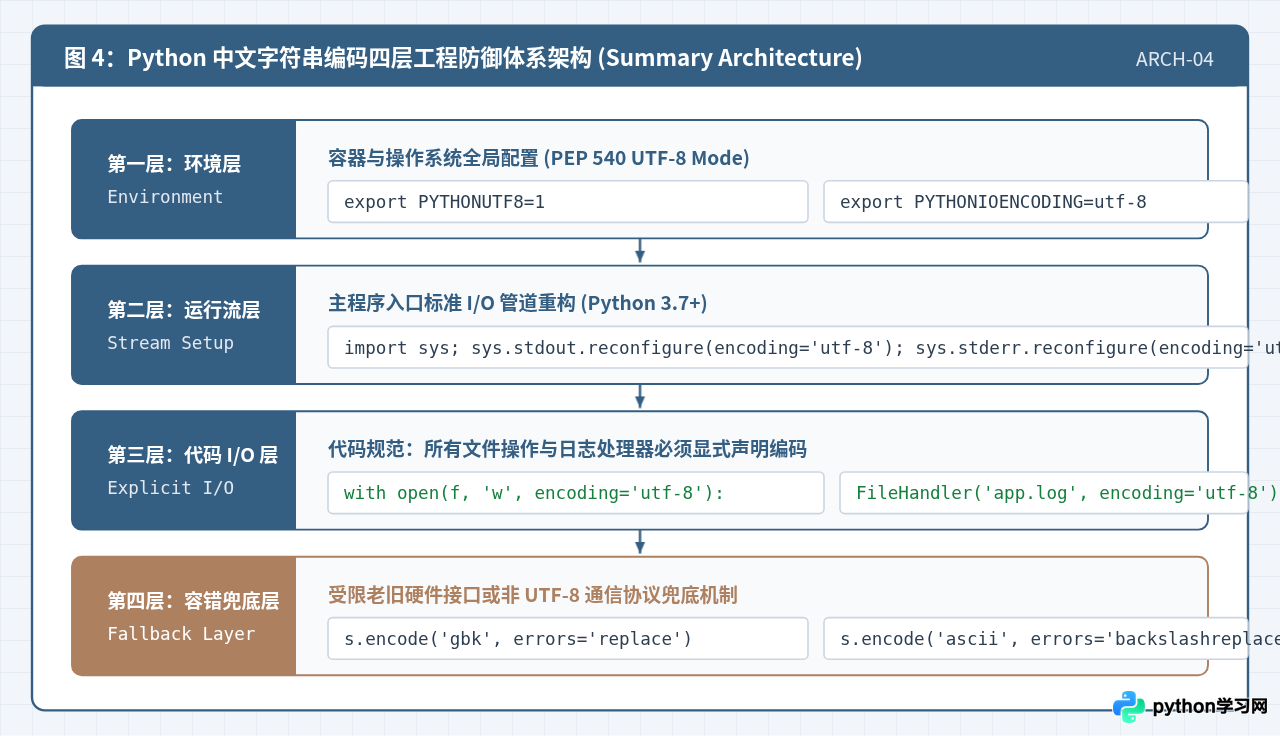
1. 容器环境与系统配置(PEP 540 UTF-8 Mode)
自 Python 3.7 起,引入了强大的 UTF-8 运行模式(PEP 540)。启用后,Python 会主动忽略系统的旧式 Locale 配置,强制将默认文本编码、标准输入输出编码统一重置为 UTF-8。可以通过以下方式在 Dockerfile 或环境变量中进行声明:
# 方式 A:在 Dockerfile 或宿主机环境变量中设置(推荐)
ENV PYTHONUTF8=1
ENV PYTHONIOENCODING=utf-8
ENV LC_ALL=C.UTF-8

# 方式 B:在命令行启动脚本时添加 -X 参数
python3 -X utf8 service_main.py > service.log 2>&1
2. 线上环境自我验证测试脚本
在代码部署到生产环境之前,可以通过执行以下测试脚本,快速验证当前执行上下文是否存在 UnicodeEncodeError 隐患:
import sys
import locale

def verify_encoding_environment():
    print("=== Python 编码环境自检 ===")
    print("Python 版本号       :", sys.version.split()[0])
    print("系统首选编码 (Locale):", locale.getpreferredencoding(False))
    print("标准输出流编码 (Stdout):", sys.stdout.encoding)
    print("标准错误流编码 (Stderr):", sys.stderr.encoding)
    print("默认内部编码 (Default):", sys.getdefaultencoding())

    test_string = "中文测试:生僻字𫚉与标点【】"

    try:
        # 测试 1: 文件写入通道
        with open(".test_encoding.tmp", "w", encoding="utf-8") as f:
            f.write(test_string)

        # 测试 2: 控制台流通道
        sys.stdout.write(f"[验证中文字符串流式输出正常] -> {test_string}\n")
        sys.stdout.flush()
        print("环境验证结论: [通过] 具备稳定的 UTF-8 处理能力,无 UnicodeEncodeError 风险。")
    except UnicodeEncodeError as e:
        print("环境验证结论: [未通过] 触发编码异常,请立即配置 PYTHONUTF8=1 或在 I/O 中指定 encoding='utf-8'。")
        print("异常明细:", e)

if __name__ == "__main__":
    verify_encoding_environment()
通过在代码层将显式 encoding='utf-8' 纳入代码审查基线,配合生产环境注入 PYTHONUTF8=1 环境变量,即可彻底消除 Python 中文字符串在各类复杂宿主环境下的 UnicodeEncodeError 异常。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















