


Python中append和extend有什么区别?
深入对比Python中列表append和extend方法的底层原理、操作流程、常见数据类型表现与性能差异,通过内联图解和实测代码帮助读者彻底理清两者的用法与避坑要点。
append() 与 extend() 都是列表(list)对象的就地修改方法,两者的返回值均为 None。其根本区别在于对传入参数的处理维度:append(object) 将传入的参数视为单一不可分割的独立实体追加到列表尾部,原列表长度确定增加 1;而 extend(iterable) 要求参数必须是可迭代对象,它会遍历该对象并将内部包含的各个元素逐一取出、平铺追加到列表尾部,原列表长度增加该迭代对象所含元素的总数。
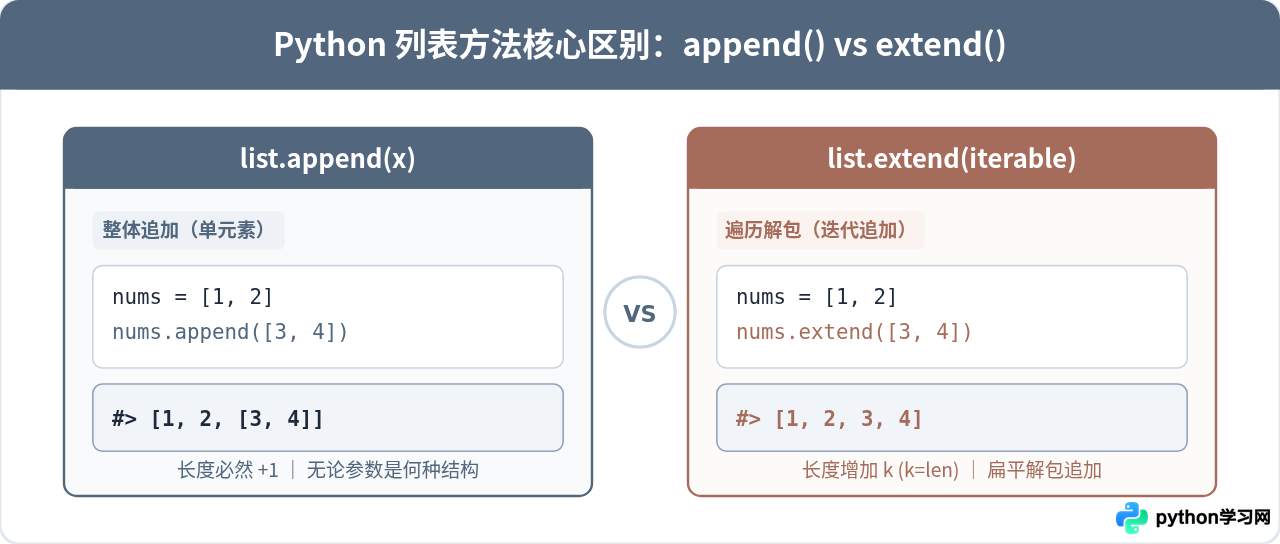
1. 从一个典型现象说起:直觉带来的“意外输出”
很多开发者在初学 Python 列表操作时,最先建立的直觉是“把一组数据加到列表里”。然而,往往在随后的代码执行中遇到困惑。例如下面两个非常普遍但极具代表性的场景:
# 场景 A:希望合并两个列表
numbers = [1, 2]
numbers.append([3, 4])
print(numbers)
# 很多初学者预期得到 [1, 2, 3, 4],但实际输出却是:
# => [1, 2, [3, 4]]
在这个例子中,初学者原本打算平铺合并两个列表,却意外构造出了一个嵌套的二维列表。列表 [3, 4] 被当成了一个整体元素存放在索引 2 的位置,len(numbers) 的结果只有 3,而不是预期的 4。
反过来,如果随意换用 extend,又可能遭遇另一种截然相反的“事故”:
# 场景 B:向日志列表中添加一条单词记录
logs = ["init", "start"]
logs.extend("stop")
print(logs)
# 期望得到 ['init', 'start', 'stop'],实际输出却是:
# => ['init', 'start', 's', 't', 'o', 'p']
字符串 "stop" 没有被当作一个完整的单词记录入驻,反而被无情地打散成了 4 个独立的单字符。这两个看似矛盾的现象并不是 Python 的偶发行为,而是由 append 和 extend 各自严格的接口契约决定的。
2. 操作执行流程:单对象追加与可迭代解包
为了看清两个方法在执行阶段的本质分工,我们需要拆解 Python 解释器在收到方法调用时的执行流水线:
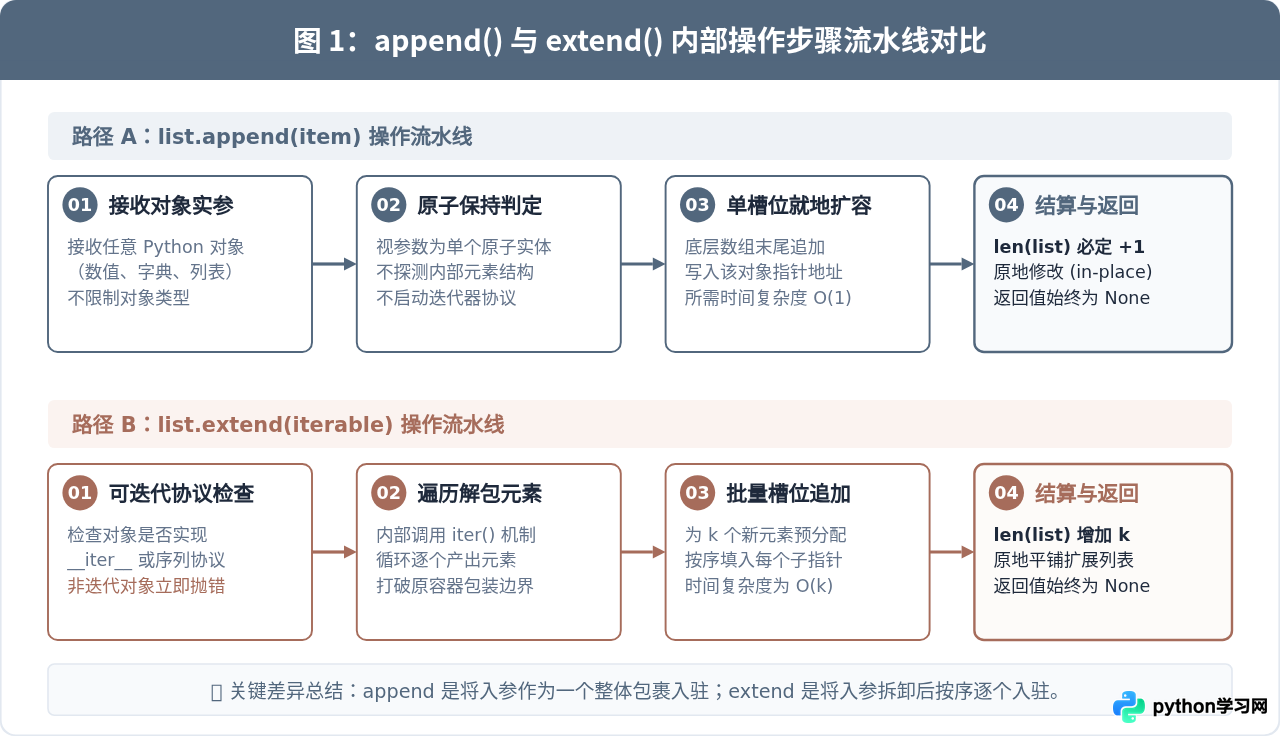
从上图的流水线对比中可以清晰发现两者的步骤断点:
append(item)的步骤流水线:解释器完全不关心item内部包含什么,哪怕它是一个拥有千万级条目的嵌套字典或复杂对象,解释器直接将其作为一个原子单元对待,只在底层数组末尾新增 1 个槽位,把该对象的内存地址写入即可。整个过程属于标准的常数级操作,执行效率为 \(O(1)\)。extend(iterable)的步骤流水线:解释器在接收到实参的第一时刻,会立即验证其是否支持 Python 的迭代协议(即是否实现了__iter__魔法方法或序列索引)。若不满足则直接中止并抛出TypeError;若满足,则隐式调用迭代器逐个产出元素,并一次性或按需扩充列表容量,将每一个产出元素的指针依次写入列表末尾。执行开销与待追加迭代对象的长度 \(k\) 成线性正比,时间复杂度为 \(O(k)\)。
3. 底层原理剖析:CPython 列表指针与内存模型
在 CPython 实现中,Python 的 list 实际上是一个名为 PyListObject 的 C 结构体。它并不是链表,而是一个动态指针数组。结构体核心字段包括:
ob_size:表示当前列表中存储的有效元素个数;ob_item:是一个指向指针数组的指针(PyObject**),每个槽位存放的是具体 Python 对象的内存地址引用。
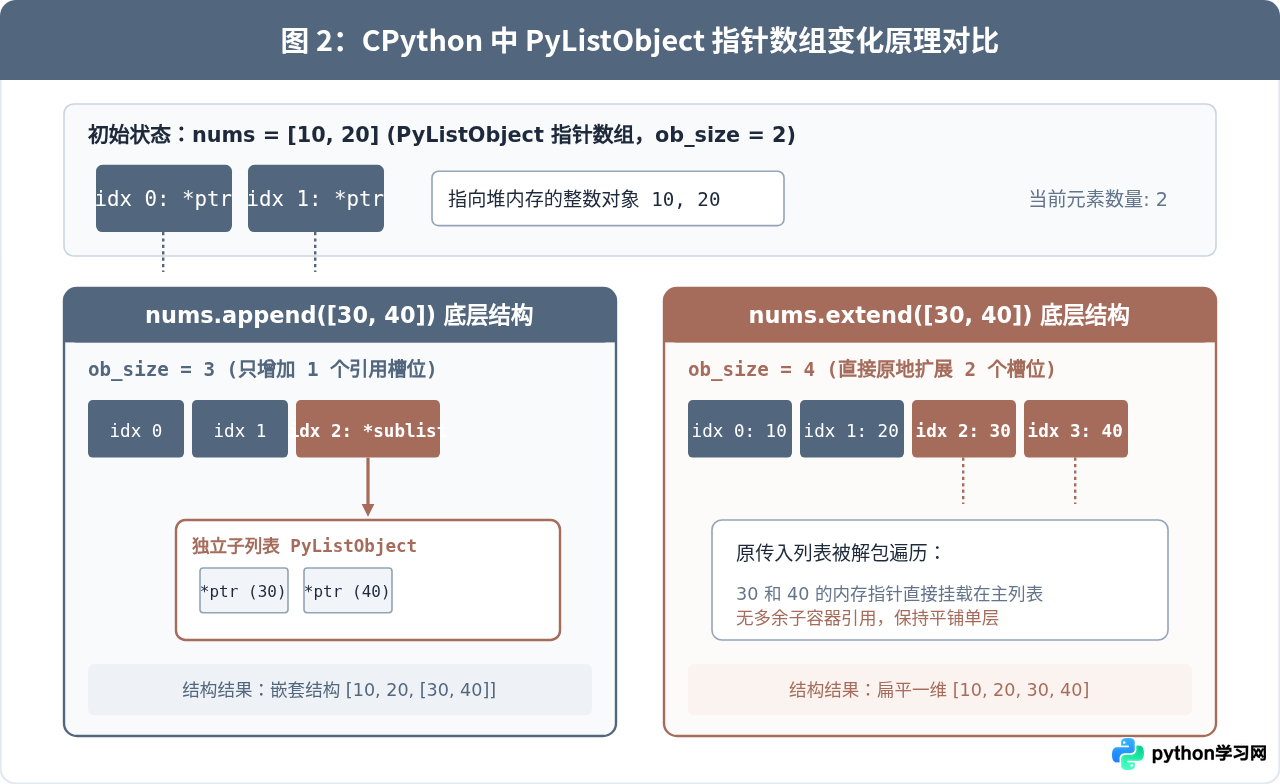
如图 2 所示,当我们对初始列表 [10, 20] 进行操作时,底层发生了截然不同的结构演变:
当调用 nums.append([30, 40]) 时,解释器在堆区创建了一个新的 PyListObject 实例来盛放 [30, 40],然后仅仅将外层 nums 的 ob_size 从 2 修改为 3,并在槽位索引 2 处写入新子列表的地址。因此,原列表仅增加了一次间接指针跳转,外层仍然是长度为 3 的结构。
而当调用 nums.extend([30, 40]) 时,解释器遍历获取了 30 和 40 这两个整数对象的原始指针,并将主列表 nums 的指针数组连续扩充 2 个槽位,分别将这两个指针填入索引 2 和索引 3 处,ob_size 直接增加为 4。临时承载传入数据的列表在遍历完成后使命结束。这解释了为什么 extend 能够实现列表的彻底“平铺融合”。
4. 常见数据类型的实测行为与避坑矩阵
由于 extend 强依赖 Python 的“可迭代”特性,不同类型的数据传入时会触发迥异的反应。理解这些细节是避免线上代码 Bug 的关键。
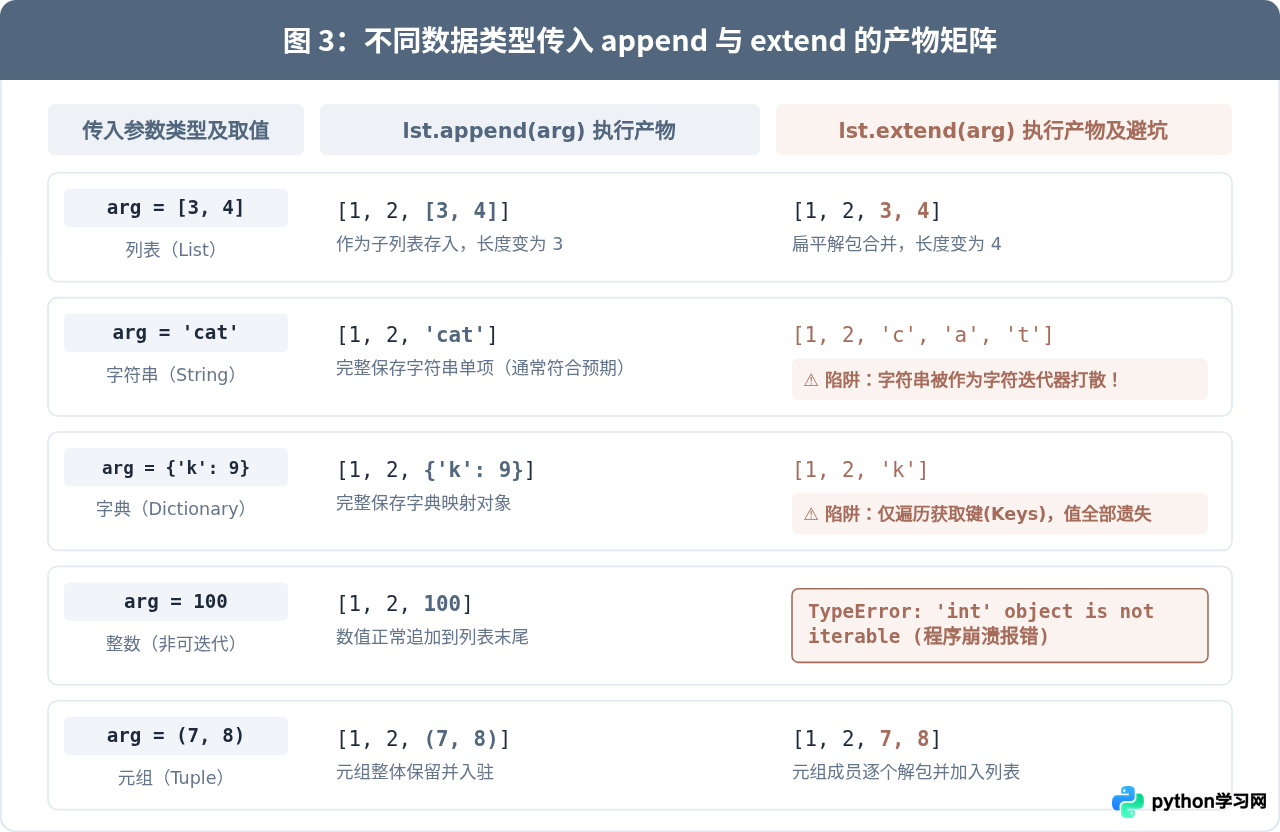
结合图 3 中的产物矩阵,我们重点解析以下三个极易让人栽跟头的类型:
4.1 字符串(String)
在 Python 中,字符串是不可变的字符序列,天然实现了可迭代协议。这导致 extend 会将其拆散为单个字符:
items = ["apple"]
items.extend("banana")
print(items)
# 输出: ['apple', 'b', 'a', 'n', 'a', 'n', 'a']
# 正确做法:若要添加单个字符串元素,务必使用 items.append("banana")
4.2 字典(Dictionary)
字典也是可迭代对象,但在 Python 的默认迭代行为中,字典只产出其键(Keys),而不会产出对应的值:
data = [1, 2]
data.extend({"name": "Tom", "age": 18})
print(data)
# 输出: [1, 2, 'name', 'age'] (值 'Tom' 和 18 均被丢弃)
# 若需要添加字典条目本身,应使用 data.append(...)
# 若需要解包添加键值元组,应显式传入 data.extend(d.items())
4.3 基础数值与布尔值(Int / Float / Bool)
整数、浮点数以及布尔值都不是可迭代对象。将它们传入 extend 会直接导致程序抛出运行时异常:
counts = [10, 20]
counts.extend(30)
# 抛出: TypeError: 'int' object is not iterableextend(),务必先用 isinstance(val, collections.abc.Iterable) 确认入参是否可迭代,或者在明确只想加一个实体时直接选用 append()。
5. 性能、语法糖与相关扩展方式辨析
在实际工程开发中,除了 append 和 extend,我们还经常看到加号运算符(+)、增量赋值(+=)以及切片赋值。理清它们之间的关系能够帮助我们写出兼具可读性与高性能的代码。
5.1 extend() 与 + 运算符的区别
list_a + list_b 操作会创建一个全新的第三方列表,并将 list_a 和 list_b 的所有元素指针拷贝进去。如果原列表包含数十万条数据,+ 操作需要申请双倍的内存空间并发生大量内存拷贝:
a = [1, 2]
b = [3, 4]
c = a + b  # a 和 b 均未改变,生成了新的列表对象 c
而 a.extend(b) 则是原地就地修改(In-Place) a,直接在 a 的末尾追加指针,没有新建第三个容器的内存开销。在批量数据追加场景下,extend 具有绝对的性能优势。
5.2 += 运算符的秘密
对于 Python 列表而言,表达式 a += b 内部调用的并不是 __add__,而是 __iadd__。在 CPython 的实现中,列表的 __iadd__ 底层代码正是直接复用了 extend() 的实现逻辑。因此:
a = [1, 2]
a += [3, 4]  # 实际效果等价于 a.extend([3, 4]),修改了原列表自身
5.3 切片赋值的等价写法
在 Python 语法中,切片不仅可以用于读取,还可以用于原地替换或插入。以下写法与 extend() 在语义上完全等同:
a = [1, 2]
a[len(a):] = [3, 4] # 在列表尾部区间插入元素,等价于 a.extend([3, 4])append() 和 extend() 都是典型的就地修改方法,它们执行完毕后的返回值始终为 None。请千万不要写出形如 new_list = old_list.append(5) 的代码,此时 new_list 的值将被赋值为 None,原列表虽然被修改了,但后续针对 new_list 的操作将全面报错。
6. 场景选型与总结决策
面对具体的工程需求,何时选择 append()?何时选择 extend()?何时又该考虑其他语法?通过下面的决策树可以快速做出明确判断:
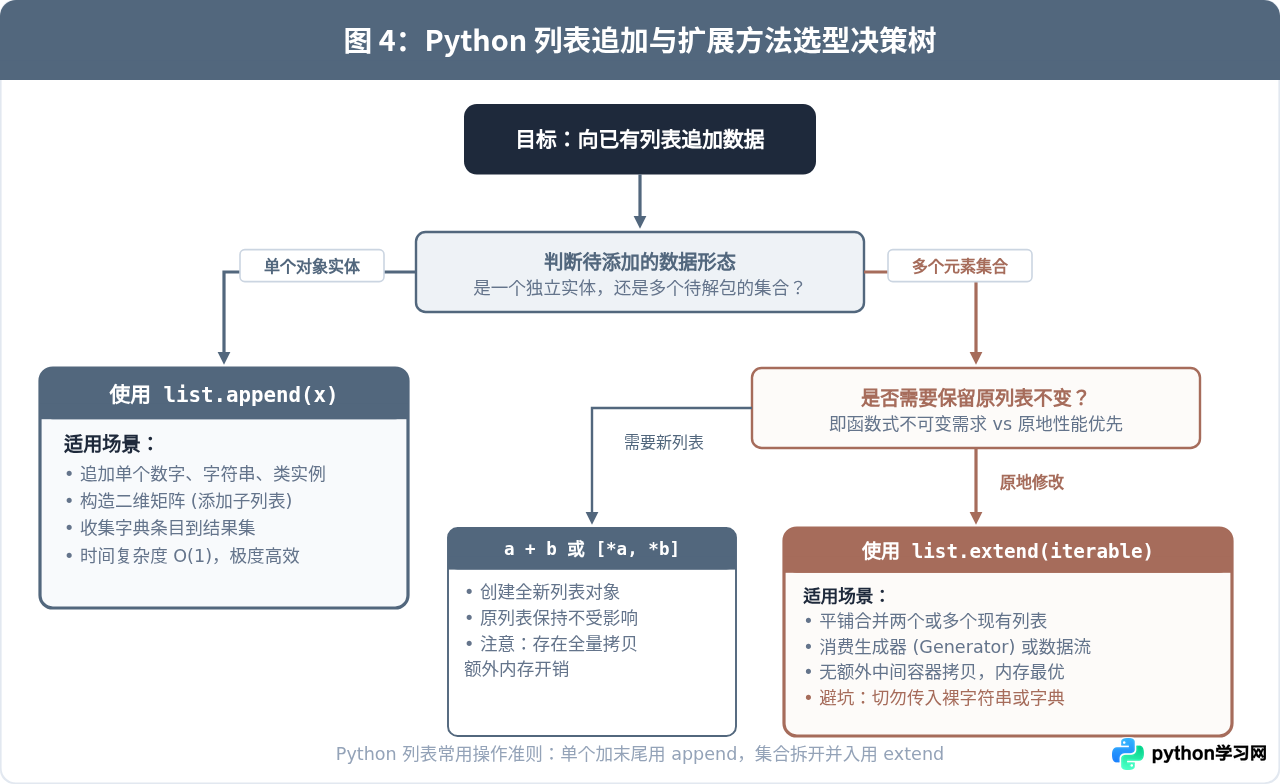
核心差异对照表
| 对比维度 | list.append(x) | list.extend(iterable) |
|---|---|---|
| 参数类型要求 | 任意 Python 对象(数值、字符串、列表、字典、对象实例等) | 必须是可迭代对象(Iterable),非可迭代对象抛出 TypeError |
| 处理机制 | 作为一个独立实体,直接放入末尾单一槽位 | 解包遍历该对象,将内部元素逐一追加到末尾 |
| 列表长度增量 | len(list) 严格增加 1 |
len(list) 增加 k(k 为迭代器元素数,若为空则增量为 0) |
| 时间复杂度 | 平摊 \(O(1)\) | \(O(k)\),其中 \(k\) 为传入迭代对象的元素长度 |
| 返回值 | None(原地修改,不可链式赋值) |
None(原地修改,不可链式赋值) |
| 典型应用场景 | 逐条收集数据、构建多维嵌套矩阵、向列表中保存字典或对象实体 | 平铺合并两个列表、展开元组或集合并入列表、消费生成器数据流 |
总结一句话:“加单个整体用 append,拆集合平铺用 extend”。只要在编码前明确待插入数据的语义边界和期望的列表维度,就能在两者的选用中游刃有余。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















