


汉诺塔递归调用栈怎么变化?Python执行过程图解
深入拆解汉诺塔递归算法在Python中的执行过程,结合详细的调用栈压栈与出栈图解,解析栈帧状态、参数传递变化与DFS遍历路径,理清递归底层运行逻辑。
很多初学者接触汉诺塔(Tower of Hanoi)递归算法时,能够背诵“将 $n-1$ 个盘子挪开、移动底盘、再把 $n-1$ 个盘子挪回”的三步口诀,但在脑海中很难形成清晰的底层执行模型:Python 解释器在内存中究竟是怎么处理这些层层嵌套的函数调用的?为什么柱子形参在不同层级会“反复颠倒”?函数返回时又是如何准确找回之前执行到哪一步的?
本文直接以 Python 的标准递归实现切入,以 3 阶汉诺塔(3 个圆盘)为基准场景,逐帧图解运行时函数调用栈(Call Stack)的压栈、挂起、弹栈与回溯过程,帮助读者彻底搞清递归背后的内存状态演变规律。
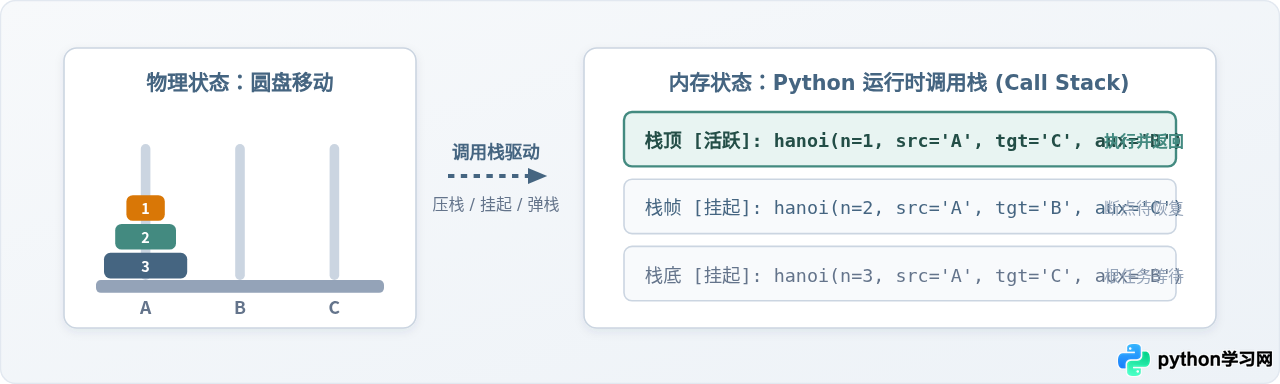
一、汉诺塔算法逻辑与 Python 标准实现
汉诺塔的目标是将 $n$ 个大小互不相同的圆盘从起始柱(A)搬运到目标柱(C),过程中可以借助辅助柱(B),且必须遵守两项刚性规则:每次只能移动一个盘子;任何时候大盘子都不能压在小盘子上面。
解决该问题的核心思想是将 $n$ 阶问题转化为两批 $n-1$ 阶子问题:
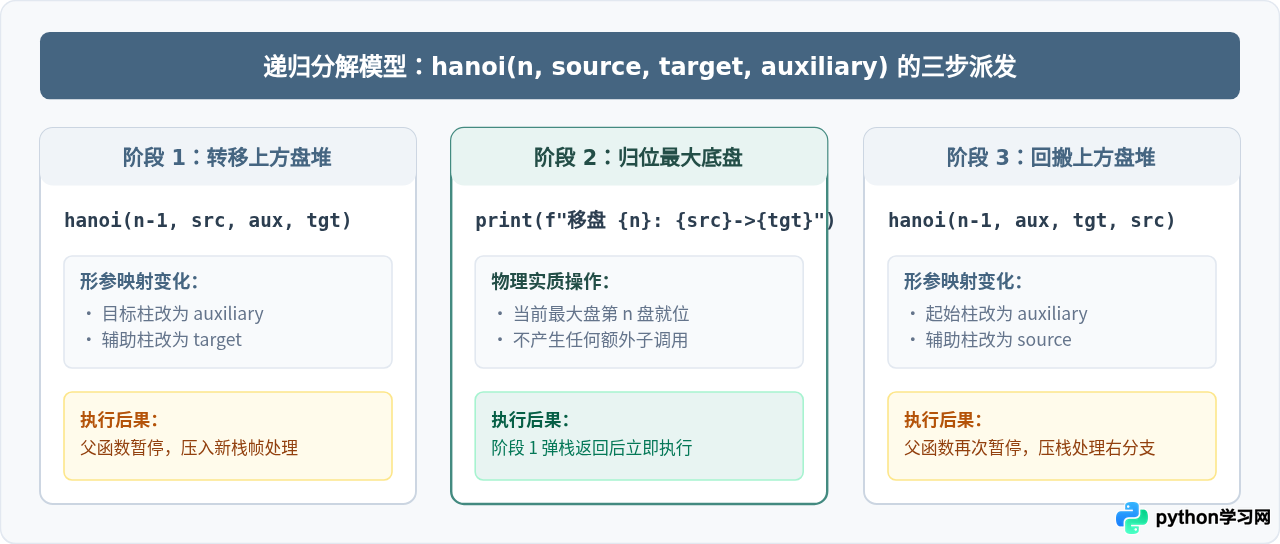
- 步骤一(子任务 1):把上面 $n-1$ 个较小圆盘从起始柱搬到辅助柱(目标柱暂时充当辅助)。
- 步骤二(基准动作):把位于起始柱底部的第 $n$ 个最大圆盘直接挪到目标柱。
- 步骤三(子任务 2):把放在辅助柱上的 $n-1$ 个圆盘从辅助柱搬到目标柱(起始柱暂时充当辅助)。
def hanoi(n, source, target, auxiliary):
    # 基准条件 (Base Case):当只有 1 个圆盘时,直接移动并返回
    if n == 1:
        print(f"移动圆盘 1: 从 {source} -> {target}")
        return

    # 阶段 1:将前 n-1 个盘子从 source 移至 auxiliary
    hanoi(n - 1, source, auxiliary, target)

    # 阶段 2:移动第 n 个大盘到 target
    print(f"移动圆盘 {n}: 从 {source} -> {target}")

    # 阶段 3:将 n-1 个盘子从 auxiliary 移至 target
    hanoi(n - 1, auxiliary, target, source)

# 启动执行:3 个圆盘,从 A 搬到 C,借助 B
hanoi(3, 'A', 'C', 'B')
运行上述代码后,终端依次输出以下 7 步移动记录:
移动圆盘 1: 从 A -> C
移动圆盘 2: 从 A -> B
移动圆盘 1: 从 C -> B
移动圆盘 3: 从 A -> C
移动圆盘 1: 从 B -> A
移动圆盘 2: 从 B -> C
移动圆盘 1: 从 A -> C要真正搞清楚为什么会出现这种顺序,关键在于理清形参在子调用中的传递映射。在两次递归调用中,形参 target 和 auxiliary 的位置交换了,这直接改变了新栈帧中变量的含义。
二、Python 函数调用栈与栈帧(Frame)底层原理
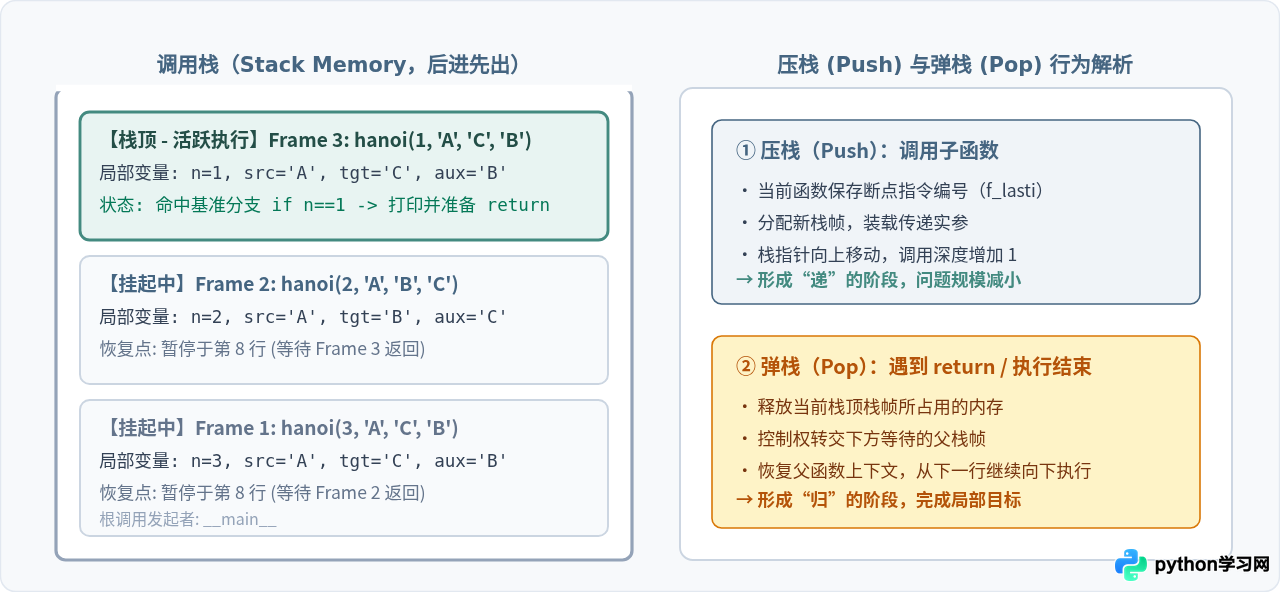
计算机在运行 Python 代码时,函数调用遵循后进先出(LIFO, Last In First Out)原则。每当 Python 解释器遇到一个函数调用语句时,就会在内存的调用栈区分配一块独立的存储空间,称为栈帧(PyFrameObject)。
栈帧中封装了该层函数执行所必需的全部私有信息:
- 局部变量表(Local Variables):存储当前层的形参值
n、source、target、auxiliary。每一层函数调用的变量虽然同名,但各自独立保存在自己的栈帧中,互不干扰。 - 指令指针与恢复点(Instruction Pointer / Last Instruction):记录当前函数暂停在字节码的哪一行。当它调用的子函数执行完毕并弹栈后,解释器凭借此指针回到父函数,继续执行下一条语句。
- 返回值地址(Return Address):子函数结束后将控制权交还给谁。
当 hanoi(3, 'A', 'C', 'B') 执行到第 8 行调用 hanoi(2, 'A', 'B', 'C') 时,原函数的栈帧并没有销毁,而是被就地挂起(Suspend)并压在栈底;新函数栈帧被压入栈顶成为“活动栈帧(Active Frame)”。只有处于栈顶的栈帧才拥有 CPU 的执行权。
三、3阶汉诺塔调用栈逐帧演变过程全景拆解
为了让读者直观感受调用栈在执行每一步输出时的真实内部状态,我们将 hanoi(3, 'A', 'C', 'B') 的全过程分解为 15 个具体时刻(包含函数调用、圆盘移动、函数返回)。
| 序号 | 当前动作 | 调用栈当前状态(栈底 → 栈顶) | 栈深度 | 终端输出 |
|---|---|---|---|---|
| 1 | 主函数发起调用 | [hanoi(3, A, C, B)] |
1 | - |
| 2 | 第一行递归发起 | [hanoi(3, A, C, B), hanoi(2, A, B, C)] |
2 | - |
| 3 | 深入基准情况 | [hanoi(3), hanoi(2), hanoi(1, A, C, B)] |
3 | - |
| 4 | 命中 n==1,执行打印并返回 | hanoi(1) 弹栈 |
2 | 移动圆盘 1: 从 A -> C |
| 5 | hanoi(2) 恢复,执行第 11 行 | [hanoi(3), hanoi(2, A, B, C)] |
2 | 移动圆盘 2: 从 A -> B |
| 6 | hanoi(2) 发起第二行递归 | [hanoi(3), hanoi(2), hanoi(1, C, B, A)] |
3 | - |
| 7 | 命中 n==1,执行打印并返回 | hanoi(1) 弹栈 |
2 | 移动圆盘 1: 从 C -> B |
| 8 | hanoi(2) 全部代码执行完毕 | hanoi(2) 弹栈 |
1 | - |
| 9 | hanoi(3) 恢复,执行第 11 行 | [hanoi(3, A, C, B)] |
1 | 移动圆盘 3: 从 A -> C |
| 10 | hanoi(3) 发起第二行递归 | [hanoi(3, A, C, B), hanoi(2, B, C, A)] |
2 | - |
| 11 | hanoi(2) 发起第一行递归 | [hanoi(3), hanoi(2), hanoi(1, B, A, C)] |
3 | - |
| 12 | 命中 n==1,执行打印并返回 | hanoi(1) 弹栈 |
2 | 移动圆盘 1: 从 B -> A |
| 13 | hanoi(2) 恢复,执行第 11 行 | [hanoi(3), hanoi(2, B, C, A)] |
2 | 移动圆盘 2: 从 B -> C |
| 14 | hanoi(2) 发起第二行递归 | [hanoi(3), hanoi(2), hanoi(1, A, C, B)] |
3 | - |
| 15 | 命中 n==1,执行打印并返回 | hanoi(1) 弹栈,随后 hanoi(2) 与 hanoi(3) 相继弹栈 |
0 | 移动圆盘 1: 从 A -> C |
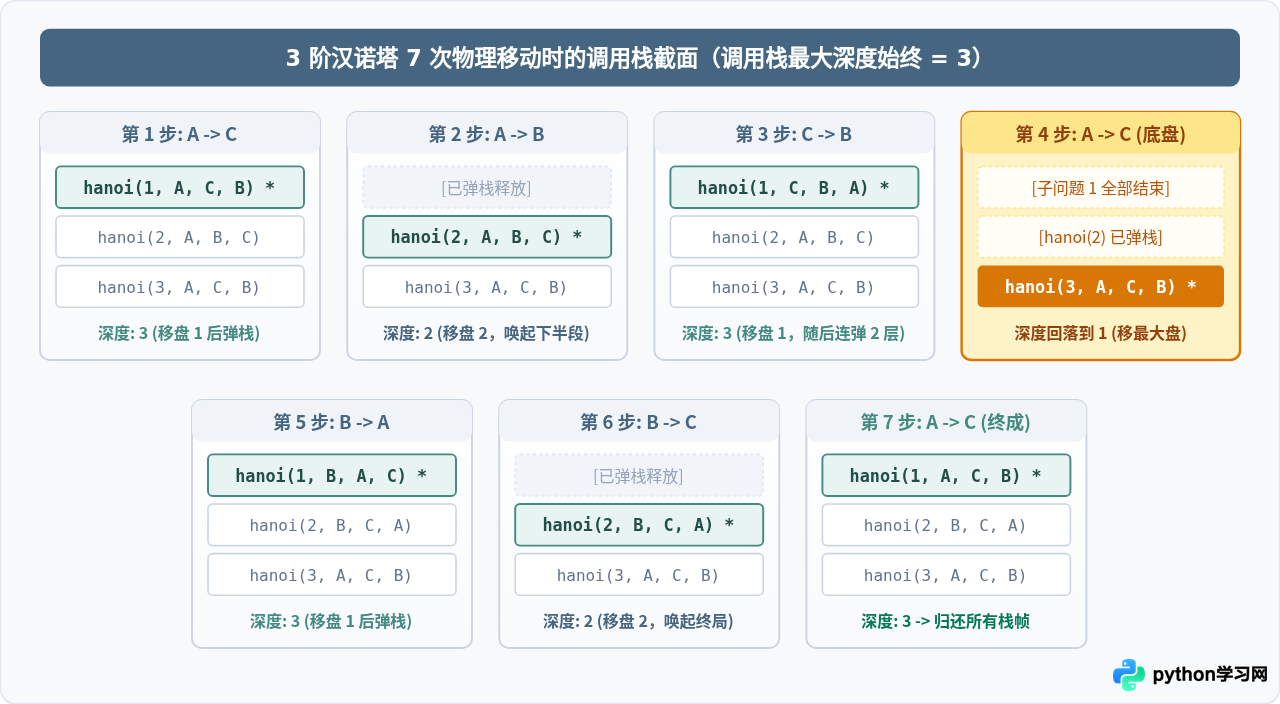
hanoi(1) 和 hanoi(2) 这两层栈帧已经完全执行完毕并彻底从内存中弹出销毁。因此在执行第 4 步打印最大盘时,调用栈上仅仅剩下一个孤零零的根栈帧 hanoi(3)。这证明调用栈并不会一直累加,而是随递归深入而上升、随遇到 return 而回落。
四、调用树与深度优先遍历(DFS)执行轨迹
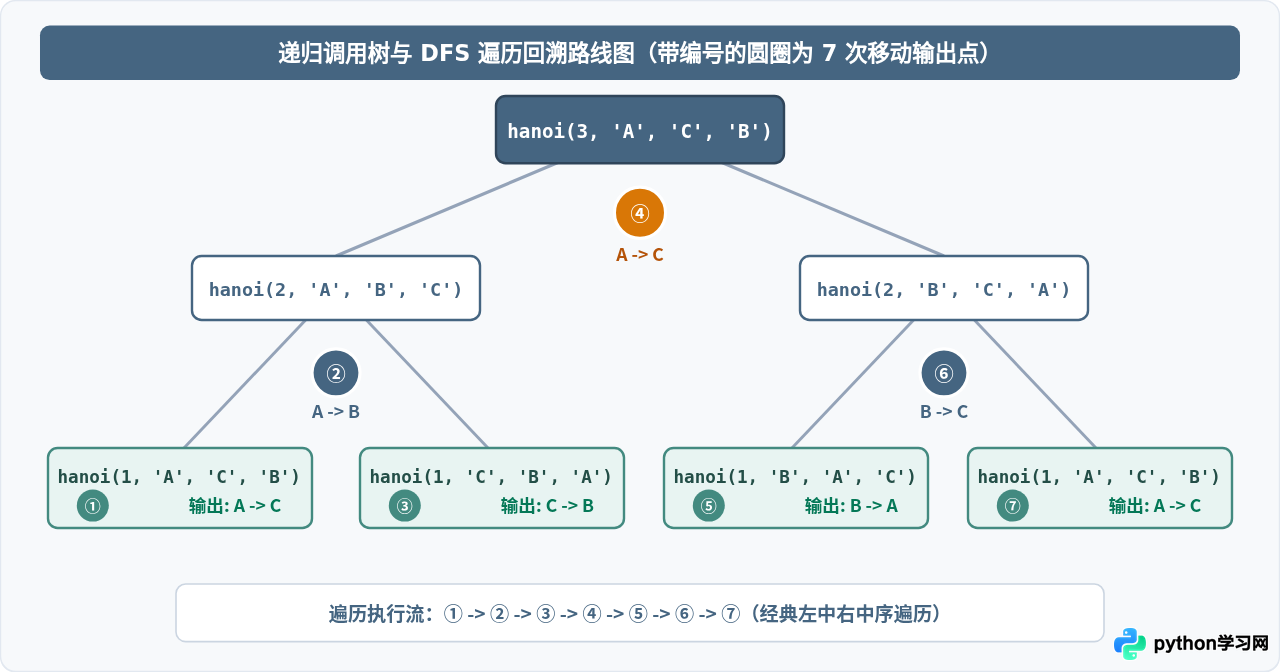
如果将每次函数调用视作树的一个节点,汉诺塔的执行过程本质上是一棵高度为 $n$ 的完全二叉树的深度优先搜索(DFS)中序遍历过程:
- 向左下深入(递):不断递归调用
hanoi(n-1, source, auxiliary, target),直到 $n=1$ 叶子节点。 - 访问当前节点(动作):执行
print语句,完成当前层圆盘移动。 - 向右下深入(递):递归调用
hanoi(n-1, auxiliary, target, source)。 - 回溯(归):当前节点所属子树全部执行完毕,销毁当前帧,返回上一级父节点。
五、时空复杂度对比与 Python 递归限制注意事项
很多开发者在分析汉诺塔时,常常把时间复杂度与空间复杂度混淆:
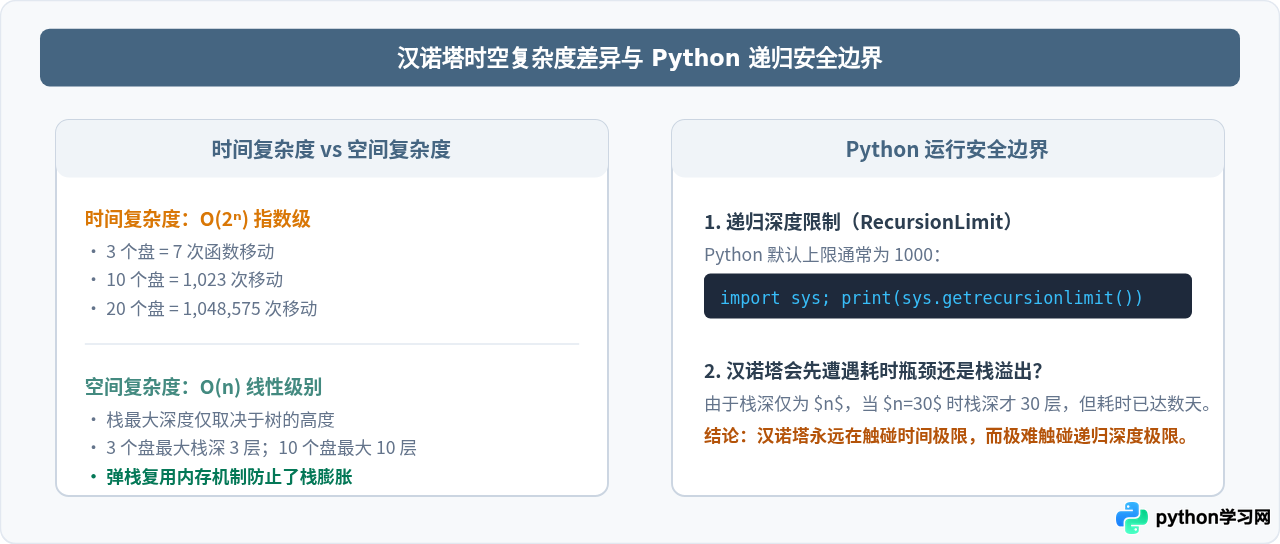
- 时间复杂度为 $O(2^n)$:对于 $n$ 阶汉诺塔,总共需要进行 $2^n - 1$ 次移动,也就是总共要创建 $2^n - 1$ 个函数调用节点。这是严格的指数级计算量。当 $n=64$ 时,计算机穷尽一生也无法算完。
- 空间复杂度仅为 $O(n)$:虽然总调用次数极其庞大,但任何时刻同时驻留在内存调用栈里的栈帧数量最多只有 $n$ 个。因为左边分支计算完毕后,对应的栈帧已全部弹栈回收,随后右边分支才复用这部分栈空间。
常见排错提示:为什么我的柱子名称经常“乱掉”?
新手在手写汉诺塔时,最常见的 Bug 是在 print 语句中直接硬编码柱子名称(例如写成 print("从 A 移到 C"))。请务必牢记:
- 形参是逻辑角色:
source是“当前子问题的起点”,target是“当前子问题的终点”,auxiliary是“当前子问题的缓冲柱”。 - 实参是物理实体:传递进入函数的是柱子的标识(如
'A'、'B'、'C')。 - 在每一层递归调用时,实参的位置发生了对调,因此必须始终通过变量名
{source}、{target}格式化输出,绝对不能在内部假定A永远是起点或C永远是终点。
总结
通过追踪 Python 执行 3 阶汉诺塔的完整生命周期,我们可以得出关于递归调用栈的三个核心结论:
- 栈帧是独立的执行现场:每次调用产生新栈帧,保存独立的形参值和返回地址;子函数返回后,父函数从挂起断点恢复。
- 最大内存开销由树高决定:由于深度优先搜索先探底、再弹栈回收、再探另一支的特性,汉诺塔的调用栈最大占用深度始终严格等于盘片数量 $n$。
- 逻辑不变,实参轮换:递归代码结构完全一致,但随着每次调用时交换
target和auxiliary的传参顺序,解释器在不断变幻的栈帧中,严丝合缝地驱动了每个圆盘的正确位移。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















