


学术研究中使用Python爬虫获取公开数据的常见场景
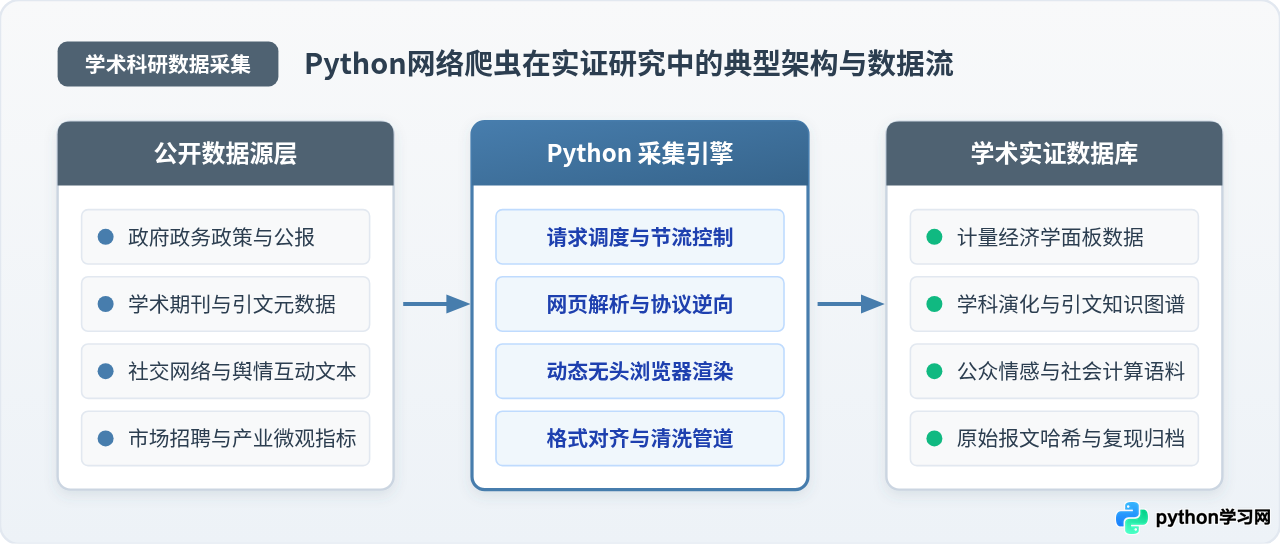
系统介绍学术研究中利用Python网络爬虫获取公开数据的四大核心应用场景,解析宏观政策、期刊引文、社交文本与微观市场数据的采集架构、技术选型、完整代码范例以及学术可复现性与合规规范。
一、学术数据定向采集的标准操作流水线
与商业爬虫追求高吞吐、强并发的逻辑不同,学术研究中的网络爬虫具有显著的“低冲击、重存证、高保真”特征。学术研究的结论需要经受同行评议与复现检验,因此数据采集过程不能随意破坏目标站点的正常运行,且必须完整固化原始数据链路。
规范的学术爬虫作业包含五个环环相扣的操作节点:从最初的权限核验、抓包逆向、调度请求,到后续的清洗规整与哈希存证。任何一个环节出现疏漏,都可能导致实证样本产生系统性选择偏差(Selection Bias),甚至引发数据失真。
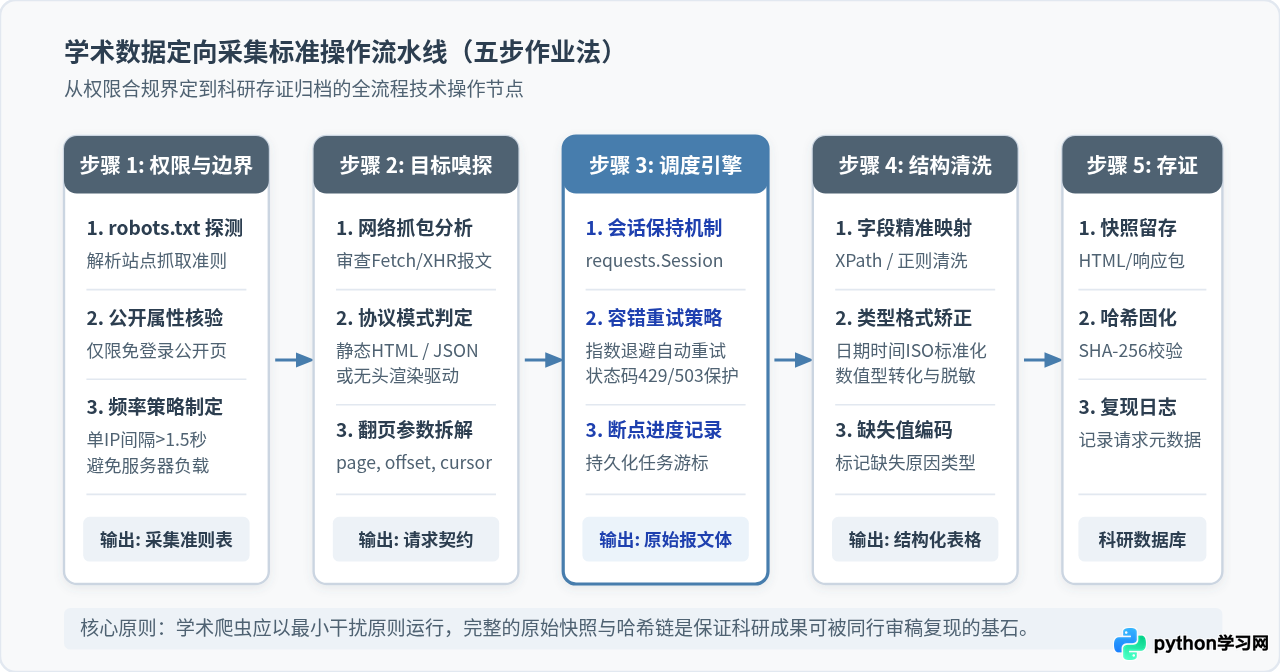
在开展实际采集前,研究者应使用 Python 自带的 urllib.robotparser 库检查目标站点的爬虫协议,明确允许采集的目录边界:
import urllib.robotparser

def check_site_robots(target_url: str, user_agent: str = "*") -> bool:
    rp = urllib.robotparser.RobotFileParser()
    rp.set_url(f"{target_url.rstrip('/')}/robots.txt")
    try:
        rp.read()
        return rp.can_fetch(user_agent, target_url)
    except Exception as e:
        # 当 robots.txt 不存在或网络连接超时时的防御性降级
        return True
二、四大核心学术应用场景与技术架构矩阵
不同的学科研究方向,其研究对象在网络空间中的存储结构、交互方式与反爬策略存在本质差异。研究者必须根据数据源的特征选择适配的技术组件,避免滥用重型自动化工具导致采集效率低下。
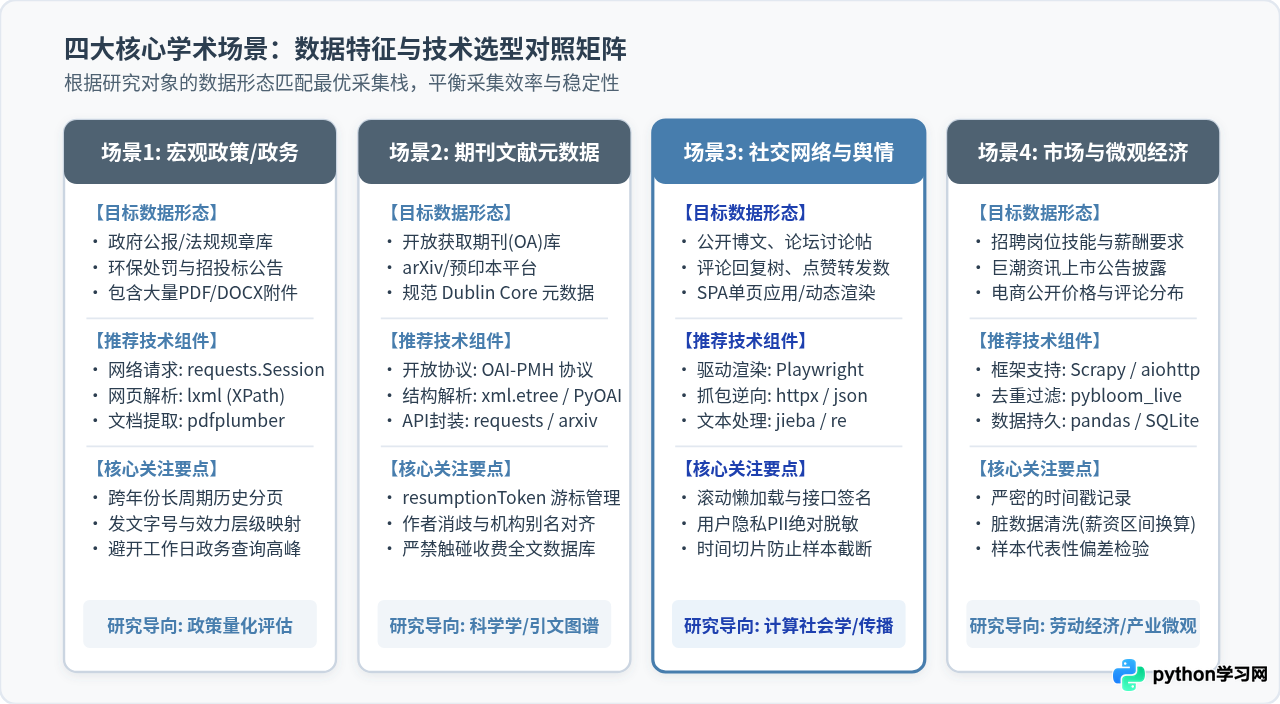
| 研究场景 | 典型数据源 | 核心技术栈 | 实证研究应用方向 |
|---|---|---|---|
| 宏观政策与政务公开 | 政府门户、环保通报、招投标网 | requests.Session + lxml + pdfplumber |
公共管理量化评估、政策力度量化、产业政策演化 |
| 期刊引文与科研文献 | arXiv、DOAJ开放仓储、机构知识库 | OAI-PMH 协议接口 + xml.etree |
科学学(Science of Science)、引文知识网络、学术前沿追踪 |
| 计算社会学与舆情文本 | 微博讨论、知乎问答、主流新闻平台 | Playwright + 异步抓包 + jieba |
突发事件情感演化、公众态度变迁、计算传播学 |
| 市场微观经济与招聘信息 | 招聘平台、巨潮资讯网、电商公开指数 | Scrapy / aiohttp + pandas |
技能溢价评估、企业ESG披露分析、市场价格粘性 |
三、场景一:宏观政策与政府政务公开信息采集
在公共管理、产业经济学及政治学实证研究中,研究人员通常需要收集中央及各级地方政府发布的政策文件、行政公报、环境执法处罚记录以及重大项目招投标公告。此类数据对于评估政策效能(如政策力度量化、文本相似度检验)至关重要。
数据特征与技术考量
政务门户网站的典型特征是:历史归档时间跨度长、分页结构相对规整、以静态 HTML 渲染为主,并且经常附带 PDF 或 DOCX 格式的红头文件附件。采集的重点在于精准提取发文字号、发文机构、成文日期与正文全文,同时将附件完整下载并留存校验哈希值。
完整操作实现范例
针对标准静态政务公开列表,采用连接池复用(requests.Session)与 lxml 的 XPath 解析是最稳定且轻量的方式:
import os
import time
import random
import hashlib
import requests
from lxml import etree

class GovPolicyCollector:
    def __init__(self, base_url: str, storage_dir: str):
        self.base_url = base_url
        self.storage_dir = storage_dir
        os.makedirs(storage_dir, exist_ok=True)

        # 配置长连接与标准学术抓取标头
        self.session = requests.Session()
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8"
        })

    def fetch_page(self, page_index: int) -> list:
        url = f"{self.base_url}/list_{page_index}.html"
        try:
            resp = self.session.get(url, timeout=12)
            resp.encoding = resp.apparent_encoding  # 自动处理中文编码(GBK/UTF-8)
            if resp.status_code != 200:
                return []

            tree = etree.HTML(resp.text)
            records = []

            # 使用 XPath 提取政策列表行
            rows = tree.xpath("//ul[@class='policy-list']/li")
            for row in rows:
                title = "".join(row.xpath(".//a/@title | .//a/text()")).strip()
                link = "".join(row.xpath(".//a/@href")).strip()
                date_str = "".join(row.xpath(".//span[@class='date']/text()")).strip()

                if link and not link.startswith("http"):
                    link = requests.compat.urljoin(self.base_url, link)

                records.append({"title": title, "url": link, "publish_date": date_str})
            return records
        except requests.RequestException as e:
            # 记录请求错误日志,支持断点补采
            return []

    def download_attachment(self, attachment_url: str) -> dict:
        """流式下载政策附件并计算 SHA-256 哈希值"""
        local_name = os.path.basename(attachment_url.split("?")[0])
        local_path = os.path.join(self.storage_dir, local_name)
        sha256 = hashlib.sha256()

        with self.session.get(attachment_url, stream=True, timeout=20) as r:
            r.raise_for_status()
            with open(local_path, "wb") as f:
                for chunk in r.iter_content(chunk_size=8192):
                    if chunk:
                        f.write(chunk)
                        sha256.update(chunk)

        return {"file_path": local_path, "sha256": sha256.hexdigest()}

# 采集执行示例
collector = GovPolicyCollector("https://example-gov.org/policy", "./policy_archive")
records = collector.fetch_page(1)
# 礼貌性随机延时,防止对政务服务器产生瞬时过载压力
time.sleep(random.uniform(1.8, 3.2))四、场景二:学术期刊仓储与文献引文元数据挖掘
在文献计量学、科学计量学以及科技创新政策研究中,研究团队常常需要抓取数万篇文献的标题、作者机构、摘要、关键词、基金项目号与参考文献列表,用于构建学术合作网络或前沿知识演化图谱。
开放归档协议(OAI-PMH)与标准 API 优先
多数开放获取期刊(Open Access)与预印本仓储(如 arXiv)均原生支持 OAI-PMH 协议。利用开放协议抓取文献元数据,远比解析混乱多变的前端 HTML 更加高效、规范且具有法律确定性。
OAI-PMH 协议返回标准 XML 格式数据,并且内置了分页游标机制(resumptionToken),能够支持不间断的断点续传:
import urllib.request
import xml.etree.ElementTree as ET

OAI_NS = {"oai": "http://www.openarchives.org/OAI/2.0/",
          "dc": "http://purl.org/dc/elements/1.1/"}

def harvest_arxiv_metadata(set_spec: str, max_records: int = 100):
    base_oai = "http://export.arxiv.org/oai2?verb=ListRecords"
    request_url = f"{base_oai}&metadataPrefix=oai_dc&set={set_spec}"

    collected = []
    while request_url and len(collected) < max_records:
        req = urllib.request.Request(request_url, headers={"User-Agent": "AcademicResearcher/1.0"})
        with urllib.request.urlopen(req) as resp:
            content = resp.read()

        root = ET.fromstring(content)
        records = root.findall(".//oai:record", OAI_NS)

        for rec in records:
            header = rec.find("oai:header", OAI_NS)
            identifier = header.find("oai:identifier", OAI_NS).text if header is not None else ""

            meta = rec.find(".//oai:metadata/dc:dc", OAI_NS)
            if meta is not None:
                title = meta.find("dc:title", OAI_NS)
                creators = [c.text for c in meta.findall("dc:creator", OAI_NS) if c.text]
                date_node = meta.find("dc:date", OAI_NS)

                collected.append({
                    "identifier": identifier,
                    "title": title.text.strip() if title is not None else "",
                    "authors": creators,
                    "date": date_node.text if date_node is not None else ""
                })

        # 提取下一页的续抓游标
        token_elem = root.find(".//oai:resumptionToken", OAI_NS)
        if token_elem is not None and token_elem.text:
            request_url = f"http://export.arxiv.org/oai2?verb=ListRecords&resumptionToken={token_elem.text.strip()}"
        else:
            request_url = None

return collected五、场景三:计算社会学与社交网络舆情交互数据抓取
计算社会学与新媒体传播研究常聚焦于重大公共事件中的舆论演变、社群分裂、谣言传播路径以及公众情绪变迁。研究数据主要来源于社交媒体讨论帖、评论回复树、点赞与转发互动链条。
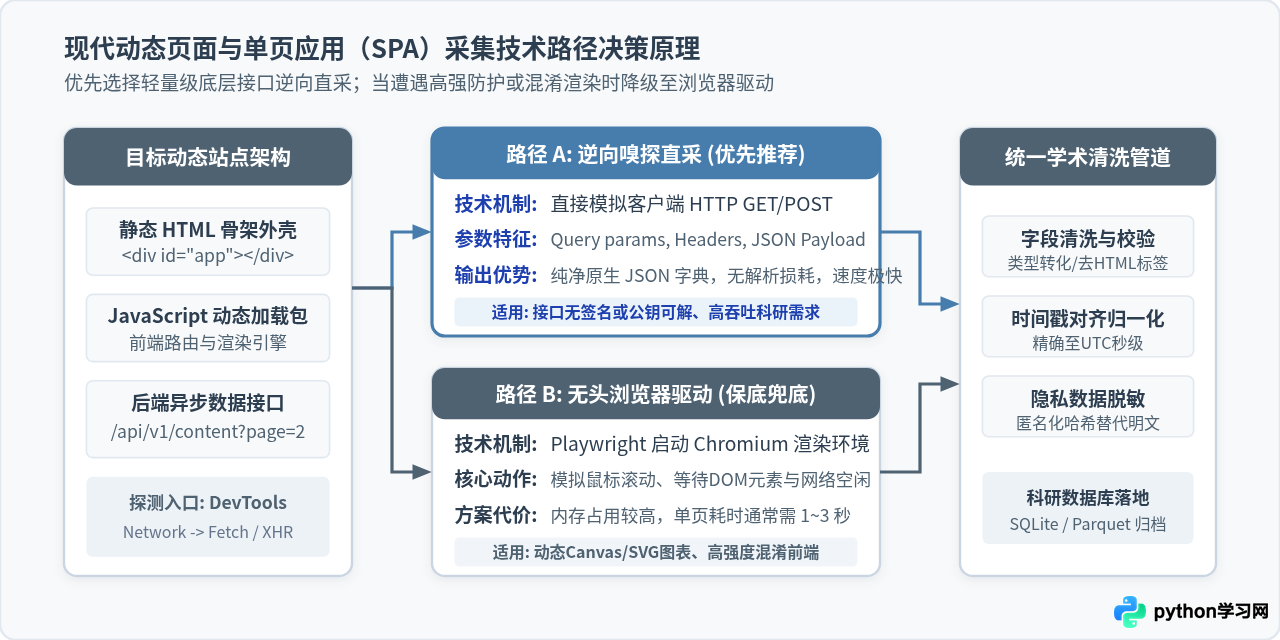
动态渲染站点的技术决策路径
现代社交平台普遍采用单页应用(SPA)技术架构,HTML 源代码中仅包含一个空的 <div id="app"></div> 容器,所有文本内容均通过后台异步接口(Fetch / XHR)加载或依靠客户端 JavaScript 动态生成。
面对此类平台,采集技术有两个分支选择:
- 路径 A(接口嗅探直采 - 优先推荐):通过浏览器开发者工具网络面板(Network)拦截实际返回 JSON 数据的底层 API 地址,复刻其请求头与 Query 参数。直接调用 API 的效率极高,返回的也是结构化字段,对系统资源消耗小。
- 路径 B(无头浏览器驱动 - 保底方案):当 API 接口采用了高强度的对称/非对称加密签名(如每次请求都计算动态 Token),逆向解密成本极高时,采用
Playwright无头浏览器驱动真实的 Chromium 引擎渲染,模拟鼠标滚动加载。
Playwright 异步拦截与动态交互示例
import asyncio
from playwright.async_api import async_playwright

async def scrape_social_topic(topic_keyword: str, scroll_times: int = 5):
    target_posts = []

    async with async_playwright() as p:
        # 启动 Chromium 无头浏览器,配置常用桌面视口
        browser = await p.chromium.launch(headless=True)
        context = await browser.new_context(
            viewport={"width": 1280, "height": 800},
            user_agent="Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36"
        )
        page = await context.new_page()

        # 监听背景网络接口响应,优先截获原生 JSON 报文
        async def handle_response(response):
            if "api/v1/topic/feed" in response.url and response.status == 200:
                try:
                    payload = await response.json()
                    for item in payload.get("data", []):
                        target_posts.append({
                            "post_id": item.get("id"),
                            "content": item.get("text"),
                            "timestamp": item.get("created_at"),
                            "reposts": item.get("reposts_count", 0)
                        })
                except Exception:
                    pass

        page.on("response", handle_response)

        # 打开搜索落地页
        await page.goto(f"https://example-social.org/search?q={topic_keyword}")
        await page.wait_for_selector(".feed-container", timeout=10000)

        # 模拟真实用户的滚动交互
        for _ in range(scroll_times):
            await page.mouse.wheel(0, 1200)
            await asyncio.sleep(2.0)  # 留出网络加载与渲染缓冲

        await browser.close()
    return target_posts
六、场景四:经济金融与微观市场公开行情/招聘信息监控
在劳动经济学实证研究中,研究者常通过长期监控主流网络招聘平台的岗位需求(职位描述、学历要求、薪资区间),用于测度“人工智能技术对劳动力技能替代效应”;在产业经济学中,通过抓取电商平台的公开价格变动与销量分布,可以精确度量商品市场的“价格黏性”与市场竞争结构。
高并发清洗与多维字段对齐
市场类微观数据的数据量往往达到数十万乃至数百万级别,通常需要采用基于事件循环的异步框架(如 Scrapy 或 aiohttp)配合内存去重机制。此类数据的最大挑战在于脏数据清洗与字段强类型对齐:
import re
import pandas as pd

def parse_salary_range(salary_raw: str) -> tuple:
    """
    清洗异构薪资字段并标准化为年薪(万元/年)
    示例输入: "15k-25k·14薪", "8000-12000元/月", "20-30万/年"
    """
    if not salary_raw or pd.isna(salary_raw):
        return (None, None)

    # 提取是否含有特定年终月数(如 14薪)
    months = 12
    month_match = re.search(r"(\d+)薪", salary_raw)
    if month_match:
        months = int(month_match.group(1))

    # 匹配核心数字区间
    nums = re.findall(r"(\d+(?:\.\d+)?)", salary_raw)
    if len(nums) < 2:
        return (None, None)

    low, high = float(nums[0]), float(nums[1])

    # 统一转换基准为万元/年
    if "k" in salary_raw.lower() or "千" in salary_raw:
        return (round(low * months / 10, 2), round(high * months / 10, 2))
    elif "万" in salary_raw:
        return (round(low, 2), round(high, 2))
    elif "元/月" in salary_raw:
        return (round(low * months / 10000, 2), round(high * months / 10000, 2))

return (low, high)七、学术爬虫的质量合规与科研可靠性评估全景
完成爬虫脚本的编写并产出数据表,仅完成了科研数据准备的一半工作。对于高质量的学术成果而言,原始数据的合法合规性与可复现性(Replicability)是决定论文能否通过同行评议的生命线。
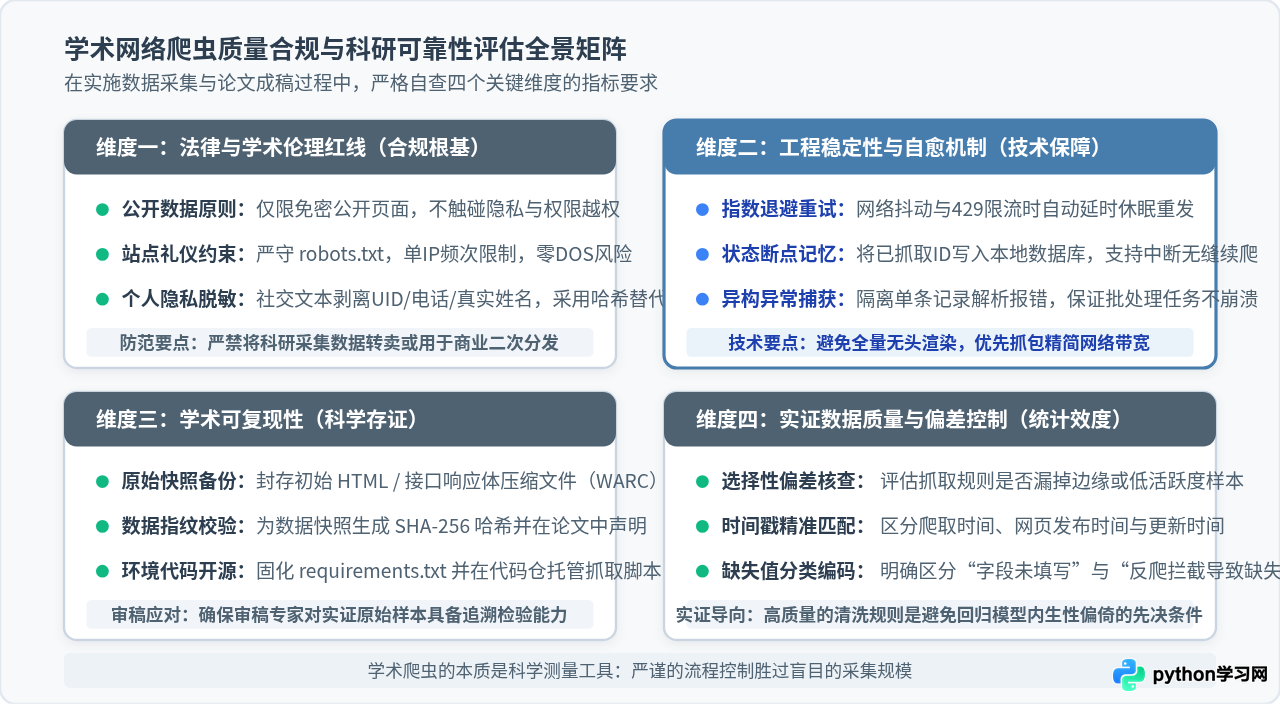
学术研究必须落实的四项存证规范
- 原始报文物理封存:在解析得到清洗后表格的同时,务必将未经修改的初始 HTML 文件或 API 原始 JSON 报文进行压缩保存(可采用标准的
.warc.gz网页归档格式)。若日后审稿人对字段提取规则产生质疑,原始快照是最无可辩驳的证据。 - 全量数据 SHA-256 固化:在数据采集完毕并冻结数据库时,对核心数据文件计算 SHA-256 校验哈希值,并在论文正文的数据来源章节予以明文声明。
- 代码与依赖环境固化:使用
pip freeze > requirements.txt固化执行环境中的依赖版本,并将爬取脚本上传至开放科学框架(OSF)、Zenodo 或 GitHub 存档仓库,附上详细的运行指引。 - 个人隐私信息(PII)绝对脱敏:针对社交网络评论数据,入库前必须对用户的唯一账号 UID、网名、头像 URL 进行单向哈希(One-way Salted Hash)加密替换,确保任何第三方无法从公开的研究数据集中反查出具体自然人的身份信息。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















