


Python数据类型转换陷阱:bool、int与str隐式转换中的常见错误
深入剖析Python中bool、int与str在隐式转换、等值比对及真值测试中的常见陷阱,解析CPython底层对象模型、字典哈希碰撞及字符串转布尔误区,提供生产级防御方案。
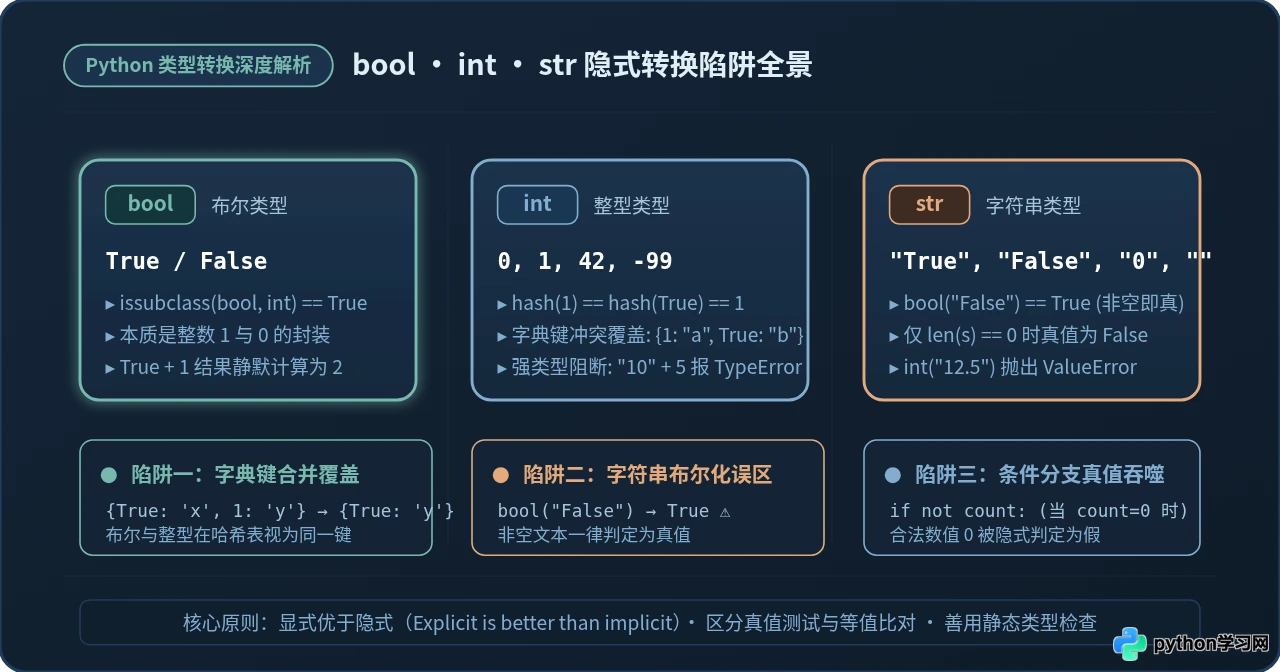
在编写 Web 接口参数解析、环境配置加载或字典状态缓存时,开发者常会写出类似 is_active = bool(request.args.get("active", "False")) 这样的代码,或者在字典中交替使用整数 1 和布尔值 True 作为状态键。然而,在实际运行中,传入的字符串 "False" 经过 bool() 转换后得出的结果依然是 True;而在字典中写入 {True: "admin", 1: "guest"} 后,最终字典中只保留了一个键,原本的值被意外覆盖。
这类问题既不是 Python 解释器的偶发异常,也不是简单的书写疏忽,而是植根于 Python 底层设计的三大基石:bool 作为 int 派生子类的历史实现、容器哈希槽判定准则,以及以对象长度与零值为核心的真值测试(Truth Value Testing)机制。本文将系统拆解 bool、int 与 str 之间的隐式转换、类型强行比对及真值判断陷阱,还原底层运行过程,并给出可在生产环境落地的可靠防御方案。
一、bool 与 int 的血缘关系:为什么 True == 1 会引发数据覆盖?
很多从其他强类型语言转到 Python 的开发者通常认为:布尔类型与整型是完全正交、互相隔离的两个数据类型。但在 Python 中,布尔类型并不是独立的基础标量,而是直接派生自整数类型 int。
1.1 bool 是 int 的直接子类
我们可以通过 Python 内建函数直接验证两者的继承关系:
# 验证类型派生关系
print(issubclass(bool, int))      # 输出: True
print(isinstance(True, int))       # 输出: True
print(isinstance(False, int))      # 输出: True
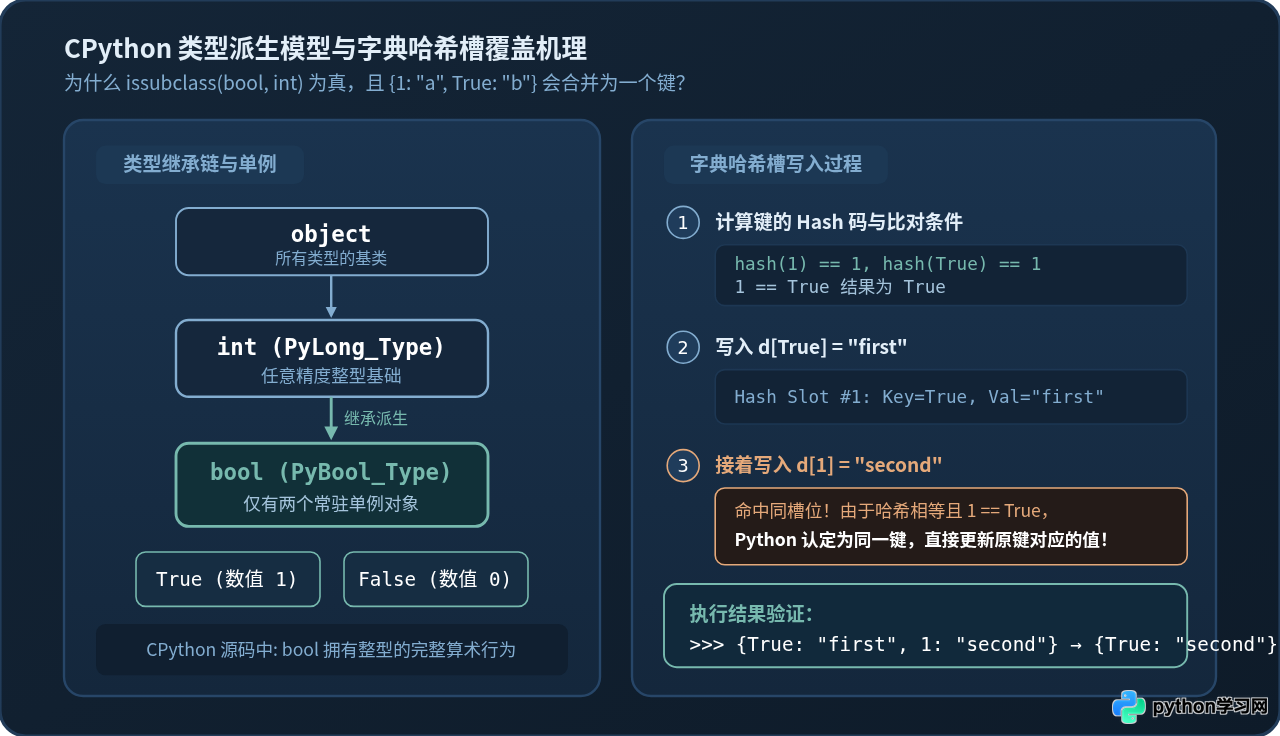
在 CPython 底层实现中,PyBool_Type 实际上是以 PyLong_Type 作为基类进行结构体扩展的,并且全局仅创建了两个持久驻留内存的单例对象:True(其底层数值存储为 1)和 False(其底层数值存储为 0)。这意味着,任何接受整数运算的操作符都可以毫无阻碍地直接作用于布尔值,而且不会产生任何类型告警:
# 布尔值静默参与数值算术运算
total = True + True + False + 5
print(total)                       # 输出: 7

# 在聚合统计中容易误触类型扩散
counts = [True, False, True, True]
print(sum(counts))                 # 输出: 3 (直接将布尔视作 1 与 0 累加)
1.2 字典与集合中的键冲突覆盖陷阱
如果说 True + 1 == 2 还能在某些特定场景(例如统计列表中满足条件的元素个数)下被当作语法糖使用,那么在字典(dict)和集合(set)中,bool 与 int 的数值等价性则会直接导致严重的数据覆盖事故。
假设我们编写了一个用户权限与角色状态缓存模块,错误地将整数状态码与布尔标志混用:
cache = {}
cache[True] = "认证已通过"
cache[1] = "系统保留ID_1"

print(cache)                       # 实际输出: {True: '系统保留ID_1'}
print(len(cache))                  # 实际输出: 1,而非预期的 2!
为什么字典中没有出现两个独立的键?这是因为 Python 字典在定位和插入键值对时遵循以下严格判定准则:
- 计算键的哈希值:对于整数
1和布尔单例True,二者的哈希计算结果完全一致,即hash(1) == 1且hash(True) == 1。 - 哈希槽位冲突判定:计算出的哈希码映射到同一个哈希表槽位(Slot)。此时解释器会执行等值比对
key1 == key2。 - 等值性满足:由于
1 == True的判定结果为True,Python 判定当前要写入的键与已存在的键为“逻辑同一键”。 - 覆写值而保留原始键:解释器保留最初插入的键对象(
True),但将其关联的值更新为最新写入的"系统保留ID_1"。
同样的逻辑完全适用于集合:set([1, True, 1.0]) 的最终计算结果只包含单个元素 {1}。此外,成员运算符 in 同样依据等值性判断,表达式 True in [1, 2, 3] 的返回结果为 True,这在进行严格权限标志匹配时极易引发安全漏洞。
1.3 等值比对(==)与同一性比对(is)的区别
要打破这种隐式混淆,核心在于严格区分值相等与对象同一性:
a == b:调用__eq__比较两个对象包含的数值或逻辑内容是否等价。a is b:比较两个变量在内存中的底层指针地址(即id(a) == id(b)),判定是否为同一个对象。
# 区分值等价与单例同一性
flag = 1
print(flag == True)                # 输出: True  (跨类型数值等价)
print(flag is True)                # 输出: False (内存指针不同,安全阻断)
二、str 与 bool 的直觉误区:为什么 bool("False") 永远是 True?
在所有类型转换错误中,将包含布尔语义的文本转换为 bool 类型是出现频率最高的低级陷阱。许多初学者甚至部分有经验的工程师常误以为 bool("False") 会根据字符串字面含义将其转换为布尔值 False。
2.1 真值测试(Truth Value Testing)的判定原理
Python 内建的 bool(x) 函数从来不是一个“字符串语义词法解析器”,它的核心语义是真值测试。根据 Python 官方语言规范,一个对象在转换为布尔值时遵循以下规则:
- 若对象实现了
__bool__()方法,则直接取该方法的返回结果。 - 若对象未实现
__bool__()但实现了__len__()方法,则当len(obj) == 0时返回False,当len(obj) > 0时返回True。 - 字符串类型
str正是实现了__len__()。因此,只要字符串长度大于 0,其真值测试结果就必然为 True。
# 字符串真值测试陷阱示例
print(bool("False"))               # 输出: True  (长度为 5 > 0)
print(bool("0"))                   # 输出: True  (长度为 1 > 0)
print(bool("None"))                # 输出: True  (长度为 4 > 0)
print(bool("[]"))                  # 输出: True  (长度为 2 > 0)
print(bool(""))                    # 只有空字符串输出: False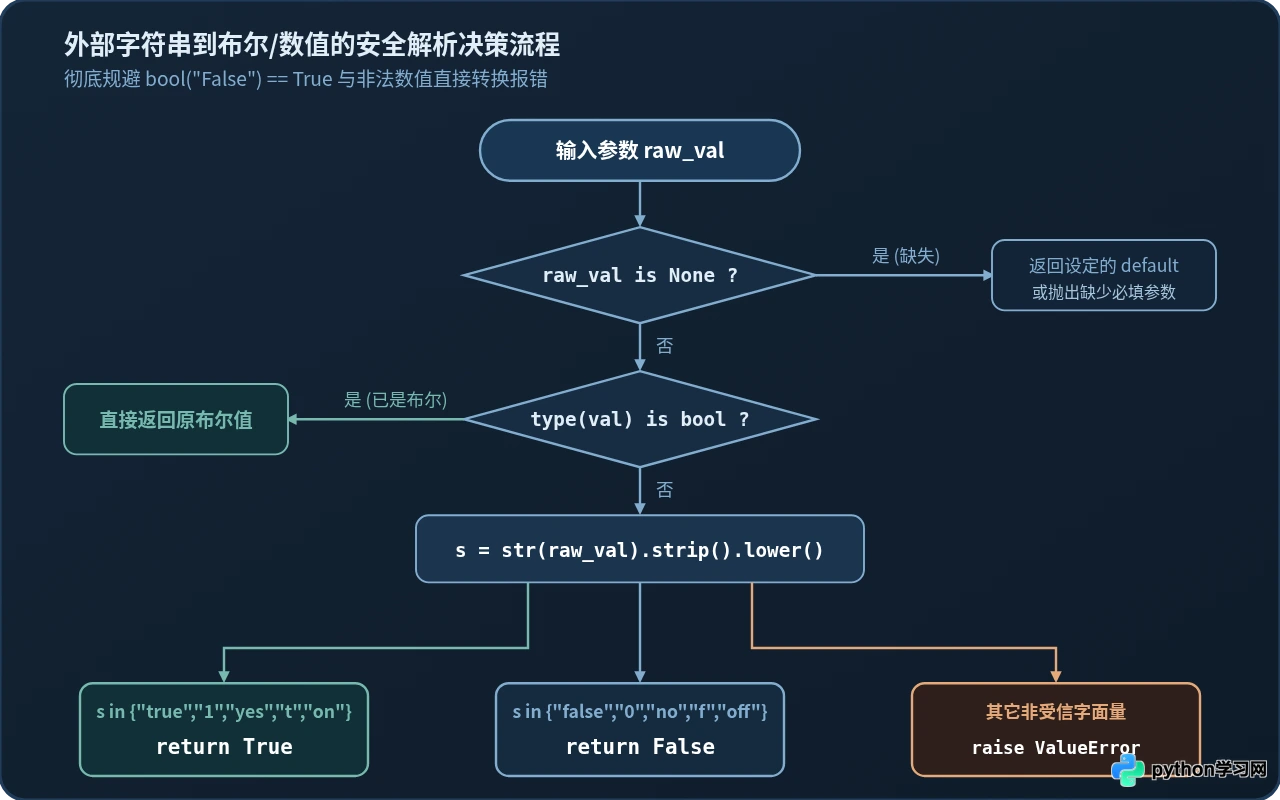
2.2 生产环境中的高频事故场景
考虑以下两个极其常见的线上场景:
场景一:读取环境变量开关
import os

# 运维人员在配置中声明了 DEBUG=False
os.environ["DEBUG"] = "False"

# 错误做法:直接使用 bool() 转换环境变量字符串
IS_DEBUG = bool(os.getenv("DEBUG"))
print(IS_DEBUG)                    # 输出: True (Debug 模式意外开启,产生敏感信息泄露!)
场景二:Web API 传入的查询参数
# 前端发起请求: GET /api/v1/users?include_deleted=false
query_param = "false"

# 错误做法
include_deleted = bool(query_param)
# include_deleted 变为 True,本不该展示的软删除数据被错误暴露
2.3 规范的字符串转布尔实现方案
要把外部输入的字符串安全可靠地转为布尔类型,必须使用显式白名单映射,并在遇到非预期的脏数据时主动抛出异常,拒绝静默假定:
def parse_bool_strict(val, default=None) -> bool:
    """安全且严格地将外部输入解析为 bool 类型"""
    if val is None:
        if default is not None:
            return default
        raise ValueError("输入值不能为空")

    # 如果已经是布尔类型,注意避开普通 int 的干扰
    if type(val) is bool:
        return val

    normalized = str(val).strip().lower()
    true_set = {"true", "1", "yes", "t", "on"}
    false_set = {"false", "0", "no", "f", "off"}

    if normalized in true_set:
        return True
    if normalized in false_set:
        return False

    raise ValueError(f"无法解析布尔字面量: '{val}'")
三、int 与 str 的转换鸿沟与隐式格式化风险
Python 是一门动态强类型语言。“强类型”的核心特征在于:不同类型的数据在执行运算时不会发生隐式的自动降级或强制转换。这与 JavaScript(例如 "10" + 5 == "105"、"10" - 5 == 5)形成了鲜明反差。
3.1 运算符强类型阻断 vs 格式化隐式转换
在 Python 中,尝试将字符串与数值直接通过加号拼接会立即引发类型异常:
# 强类型语言的安全拦截
count = 42
# result = "Total count: " + count
# 抛出: TypeError: can only concatenate str (not "int") to str
然而,在字符串格式化操作(例如 f-string、str.format() 或日志模块)中,Python 会隐式调用对象的 __str__() 方法。这虽然带来了书写的便利,但如果缺乏类型检查,可能会导致类型错误在程序中向后扩散:
# 隐式字符串化掩盖了未预期的 None 或 bool 类型
user_id = None
log_message = f"Processed order for user_{user_id}"
print(log_message)                 # 输出: Processed order for user_None
# 系统在后续数据库查询或下游调用时才发生故障,增加溯源成本
3.2 浮点数字符串无法直接通过 int() 转换
另一个关于 int 与 str 的经典语法陷阱是:int() 能够接收整数类型的字符串字面量(如 "100"),也能接收浮点数值(如 100.8 并截断小数),但无法直接转换带有小数点的字符串:
# 合法操作
print(int("100"))                  # 输出: 100
print(int(100.85))                # 输出: 100 (截断小数)

# 语法陷阱:直接传入带小数点的字符串
try:
    int("100.85")
except ValueError as err:
    print(f"转换失败: {err}")       # 抛出: invalid literal for int() with base 10: '100.85'

# 正确转换路径:先转 float 再转 int,或通过 Decimal 保证精度
safe_int = int(float("100.85"))
print(safe_int)                    # 输出: 100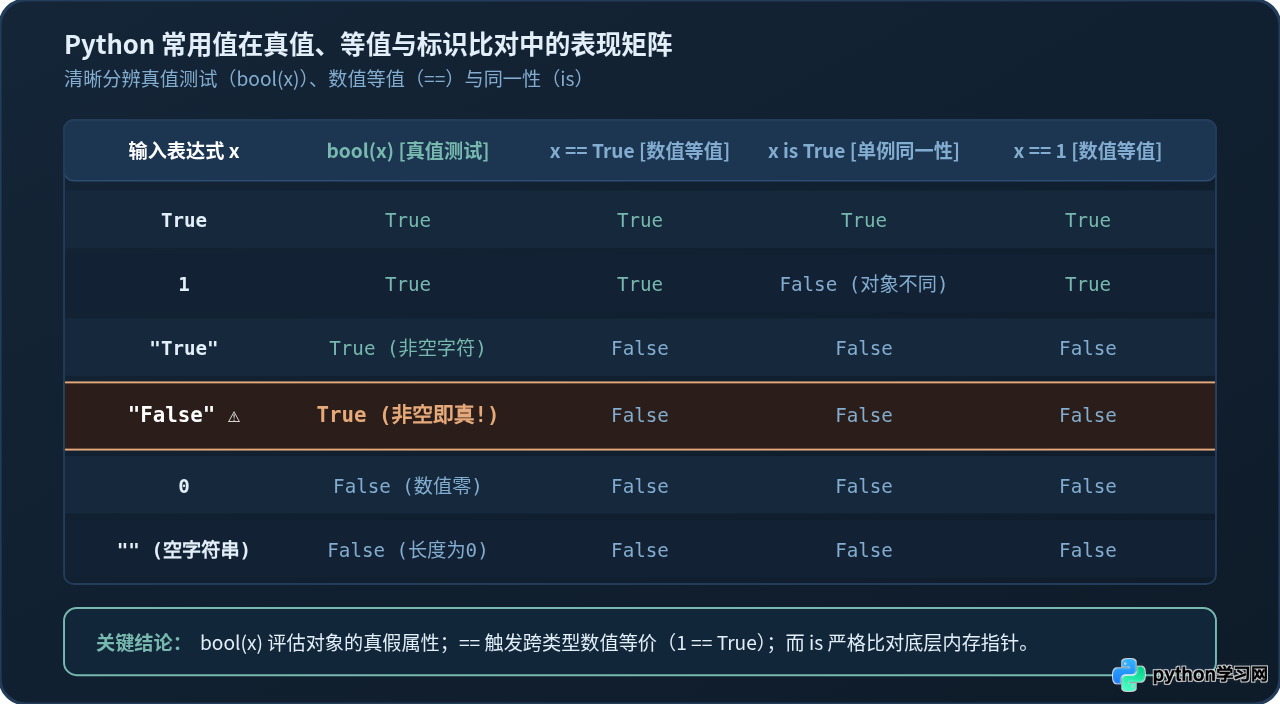
四、条件分支中的隐式真值判定陷阱
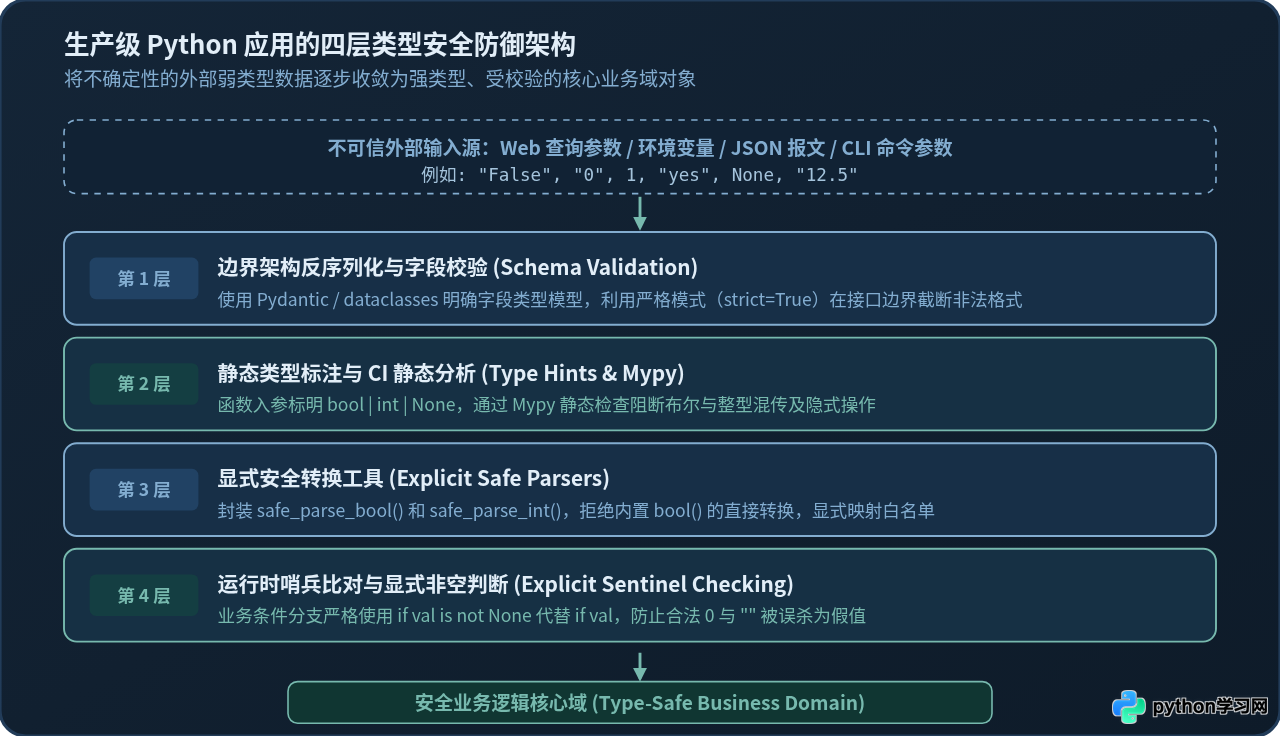
Python 鼓励编写简洁的“Pythonic”代码,常见的写法如 if value: 常被用来判断变量是否存在。然而,由于 bool(0) == False 和 bool("") == False,当业务逻辑中包含合法的数值 0、空字符串或布尔值 False 时,这种简写会引发静默的业务逻辑旁路。
4.1 函数默认参数与数值 0 的误杀
观察以下处理系统重试或超时配置的典型代码:
# 存在漏洞的默认参数处理逻辑
def connect_service(timeout=None):
    # 开发者本意:如果未传参,则使用默认超时 30 秒
    if not timeout:
        timeout = 30
    print(f"最终生效超时时间: {timeout} 秒")

# 当业务需要设置非阻塞(立即超时返回,timeout=0)时:
connect_service(timeout=0) # 输出: 最终生效超时时间: 30 秒!(被强制重置)判断可选参数是否未传,应当始终显式使用 is None,绝对不要依赖 not timeout 的隐式真值转换:
def connect_service_fixed(timeout=None):
    if timeout is None:
        timeout = 30
    print(f"最终生效超时时间: {timeout} 秒")

connect_service_fixed(timeout=0)   # 输出: 最终生效超时时间: 0 秒 (符合预期)
4.2 or 运算符的短路回退陷阱
表达式 x = a or b 在前端与后端开发中常被用于赋予默认值。但在处理布尔型或整型时极易出错:
# 场景:用户设置关闭消息推送 (enabled=False)
user_setting = False
default_setting = True

# 错误写法:利用 or 设置兜底
final_setting = user_setting or default_setting
print(final_setting)               # 输出: True!用户的关闭意图被覆盖

# 正确写法:三元表达式显式判定是否为 None
final_setting = user_setting if user_setting is not None else default_setting
print(final_setting)               # 输出: False (符合预期)
五、防御性编码与工程级落地方案
要彻底杜绝 bool、int 与 str 的隐式转换陷阱,不能仅依赖工程师的个人记忆与经验,必须在软件架构的各个关键节点建立多层次的类型防御体系。
5.1 第一层:输入边界采用强模式 Schema 校验
在接收 HTTP 请求参数、RPC 报文或解析 JSON 时,使用成熟的验证库(如 Pydantic V2)建立严格模式模型,拒绝任何非预期的隐式字符串到数值/布尔的强制扭曲:
from pydantic import BaseModel, StrictBool, StrictInt, ValidationError

class TaskConfig(BaseModel):
    task_id: StrictInt
    is_active: StrictBool

# 严格模式下,拒绝将 "False" 或 1 隐式赋给布尔字段
try:
    config = TaskConfig(task_id=101, is_active="False")
except ValidationError as e:
    print("成功拦截类型污染:", e.errors()[0]['msg'])
    # 输出: Input should be a valid boolean
5.2 第二层:全面接入 Type Hints 与 Mypy 静态检查
Python 3.10+ 引入的增强联合类型(Union Type)配合 mypy 静态分析工具,可以在编写代码阶段自动捕获混合类型的非法操作:
def calculate_discount(price: int, apply_voucher: bool) -> int:
    # 如果开发者误写为 price - apply_voucher (利用 True==1)
    # Mypy 会在静态分析中发出类型异味警告
    if apply_voucher:
        return price - 10
    return price
5.3 第三层:封装统一健壮的基础解析模块
在项目中统一提供基础类型转换工具函数,禁止业务代码直接调用内置的 bool(str_val):
from typing import Any, Optional

def safe_parse_int(val: Any, default: Optional[int] = None) -> int:
    """安全解析整数,规避 float 字符串直接 int() 报错及 bool 渗透"""
    if val is None:
        if default is not None:
            return default
        raise ValueError("Value cannot be None")

    # 杜绝 bool 类型当作 int 传入
    if type(val) is bool:
        raise TypeError("Explicit bool value rejected for integer conversion")

    try:
        return int(val)
    except ValueError:
        # 兼容带小数点的字符串,如 "10.0"
        return int(float(val))
六、常见类型转换速查与避坑清单
下表归纳了本文探讨的核心判定规则,可作为日常代码审查(Code Review)的速查基准:
| 测试场景 / 表达式 | 实际执行结果 | 产生机理 | 规范写法 / 修复方案 |
|---|---|---|---|
bool("False") |
True ⚠️ | 非空字符串 len(s) > 0 真值测试恒为 True |
显式映射集合:s.lower() in {'true', '1'} |
{True: "a", 1: "b"} |
{True: "b"} ⚠️ | hash(True) == hash(1) 且两者等值,槽位键覆盖 |
字典键统一数据类型,禁止混用 bool 与 int |
True + 1 |
2 | bool 派生自 int,单例数值为 1 |
使用显式条件分支,不依赖隐式算术提升 |
int("10.5") |
ValueError ⚠️ | int() 无法直接解析带小数点的字符串 |
先转换浮点再取整:int(float("10.5")) |
if not timeout: |
对 0 误判 ⚠️ | 0 的真值测试为 False,导致非阻塞被重置 |
显式检查空值:if timeout is None: |
1 is True |
False | 数值虽然等价,但两者指向不同的底层内存对象 | 判断布尔单例时使用 is True 或 is False |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















