


Python自学路线图:零基础怎么高效掌握编程基础
针对零基础学习者的Python自学路线图,聚焦最小语法集、核心数据容器、函数模块化与调试排错闭环,帮助初学者在4到6周内高效掌握编程基础。
零基础自学 Python 的核心在于避免陷入“只看教程不写代码”的囤积陷阱,以“最小语法子集 → 即时交互反馈 → 核心容器选型 → 独立调试交付”为主线,在 4 到 6 周内建立起稳定的编程直觉与排错能力。本文梳理了一条精炼、可执行的自学路径,明确每个阶段学什么、不学什么,以及如何验证自己是否真正掌握了编程基础。
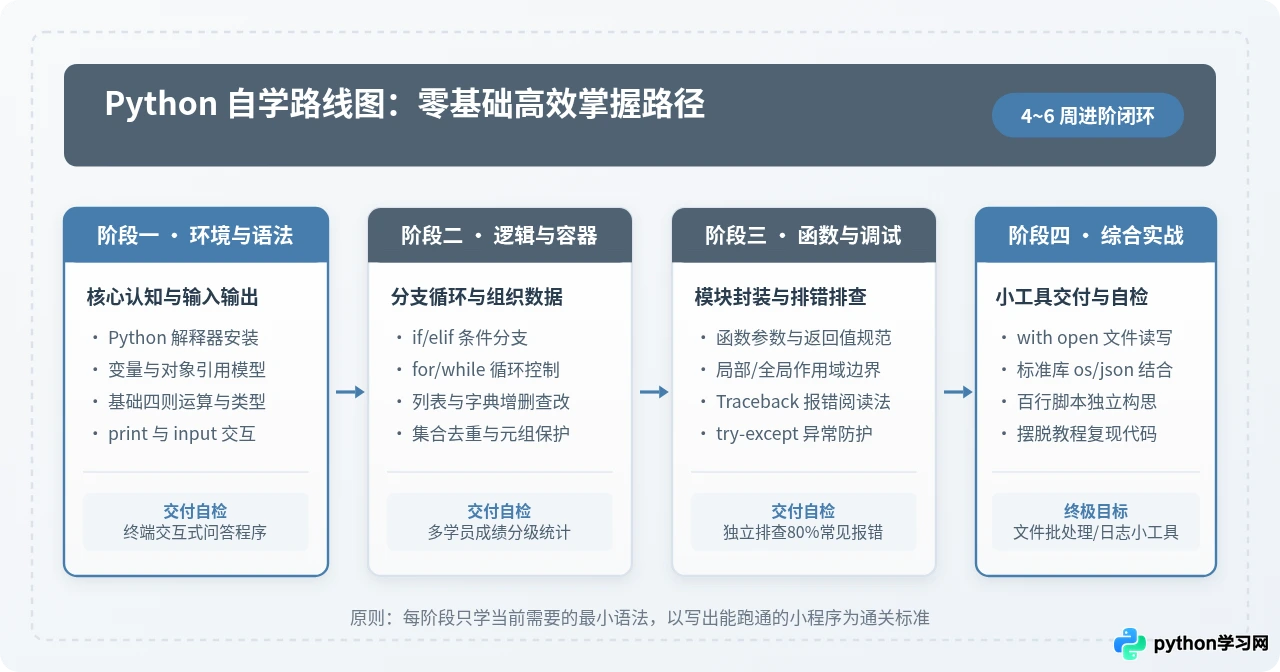
第一阶段:搭建环境与建立“变量引用”心智模型
很多初学者在第一天就耗费大量时间在庞杂的环境搭建上。零基础入门不需要配置复杂的虚拟化容器,也不需要一上来就安装动辄数个 G 的商业 IDE。进入官网下载对应的最新稳定版 Python 安装包,勾选“Add python.exe to PATH”,配合系统终端或 VS Code 即可开始运行代码。
在语法层面,第一阶段只需掌握四项内容:基本算术运算、四种基础数据类型(整数 int、浮点数 float、字符串 str、布尔值 bool)、屏幕输出 print() 以及控制台输入 input()。其中最重要的不是记住语法格式,而是建立对“变量”的正确物理直觉。
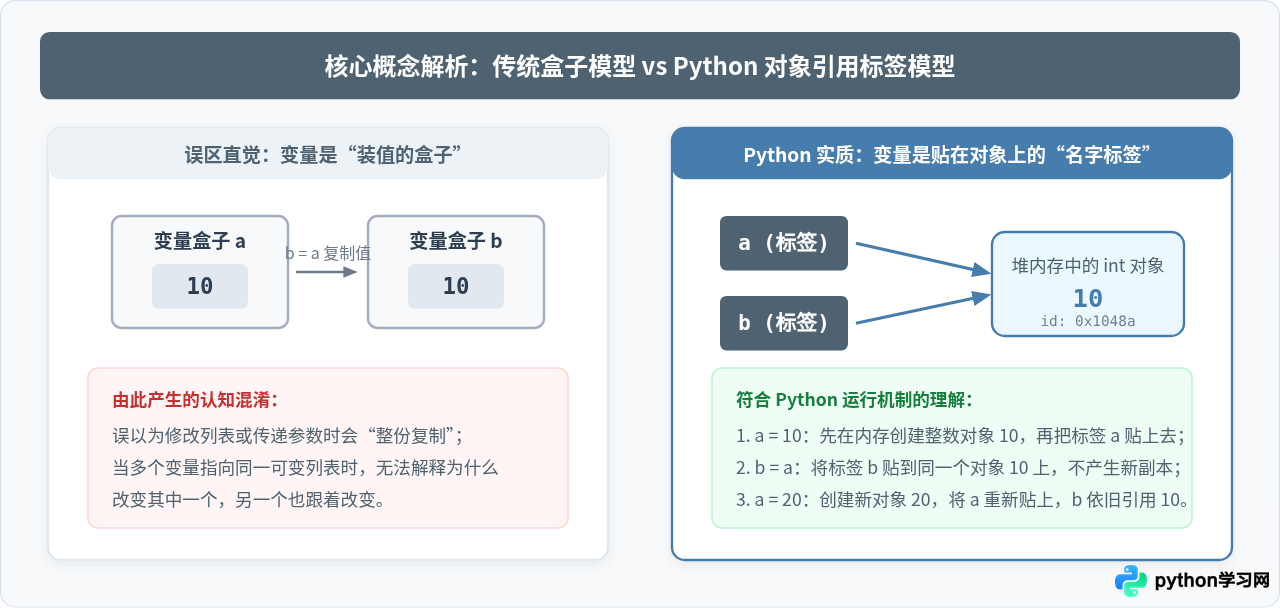
在 Python 中,变量并非用于装载数据的物理盒子,而是一个贴在内存对象上的名字标签。执行 a = 10 时,Python 解释器先在内存堆中创建整数对象 10,随后将标签 a 指向该对象;执行 b = a 时,仅仅是将标签 b 也贴到同一个 10 上,并不会发生复制。这个概念对后续理解列表传参、深浅拷贝至关重要。
编写一个能够运行的终端交互脚本:提示用户输入姓名与出生年份,利用 input() 接收输入,通过 int() 完成显式类型转换,计算当前年龄并使用 f-string 格式化打印出完整的问候语句。能独立完成该脚本且理解每一行数据流向,即为合格。
第二阶段:分支、循环与四大内置数据容器
程序之所以具备自动化处理能力,依靠的是条件判断与重复执行。在这一阶段,需要熟练使用 if / elif / else 表达多分支逻辑,以及使用 for 和 while 处理迭代。掌握循环的关键是理解“退出边界”:for 适合已知序列或明确次数的遍历,while 则用于未达到目标条件前持续轮询。
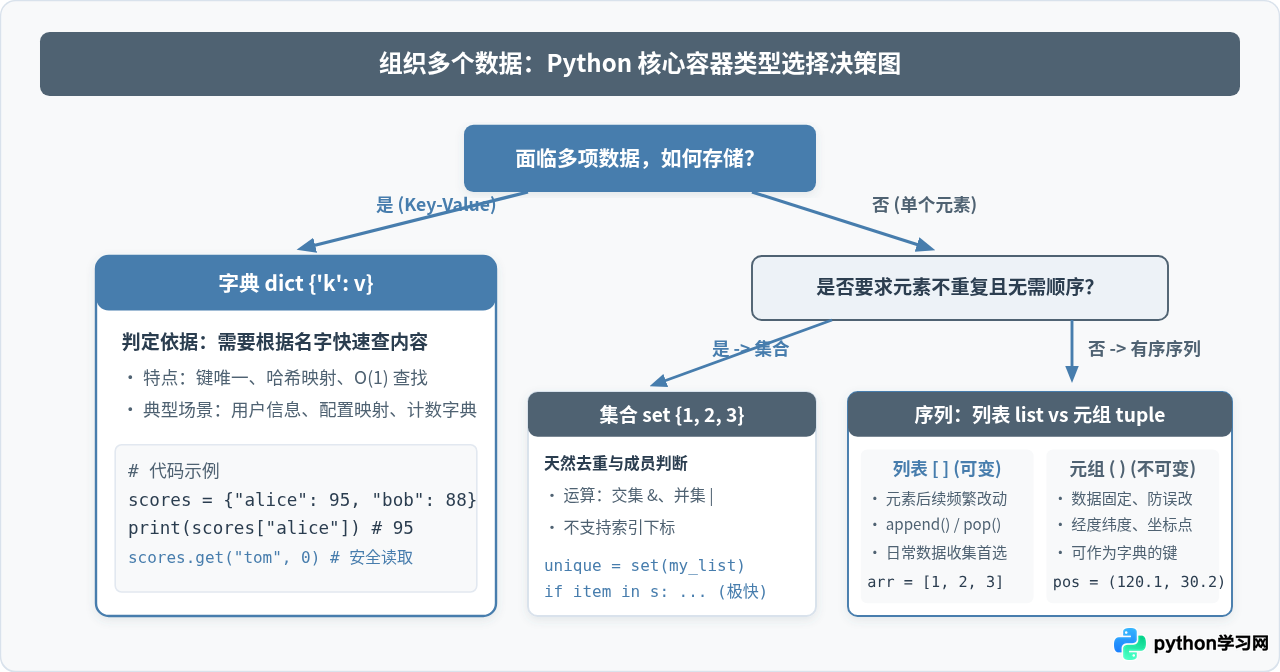
当单一变量无法承载复杂数据时,容器的选型直接决定了程序的简洁性与执行效率:
- 列表(list):用方括号
[]标识,元素有序、可变,适合作为按顺序收集或动态追加的数据队列。 - 字典(dict):用花括号
{}存储键值对,通过唯一的键实现 \(O(1)\) 时间复杂度的即时检索,是管理关联属性(如学生学号与成绩)的最佳选择。 - 集合(set):元素无序且绝对唯一,自带高效的交集、并集运算,常用于高频去重与成员存在性检查。
- 元组(tuple):用圆括号
()标识,不可更改。用于表达固定结构(如坐标点、数据库记录),避免数据被误改。
实战示例:成绩等级划分与统计
# 示例:结合字典与循环完成批量成绩统计
scores = {"张伟": 85, "李娜": 92, "王强": 58, "赵敏": 74}
level_summary = {"优秀": [], "及格": [], "待提升": []}

for name, score in scores.items():
    if score >= 90:
        level_summary["优秀"].append(name)
    elif score >= 60:
        level_summary["及格"].append(name)
    else:
        level_summary["待提升"].append(name)

print("成绩统计结果:", level_summary)成绩统计结果: {'优秀': ['李娜'], '及格': ['张伟', '赵敏'], '待提升': ['王强']}
在执行 for item in my_list: 时,若在循环体内直接调用 my_list.remove(item),会导致列表内部索引偏移,从而漏掉紧随其后的元素。正确的做法是使用列表推导式生成新列表,或者倒序遍历。
第三阶段:函数封装与防御性调试排错
写出长达上百行的“面条式代码”是初学者经常遭遇的瓶颈。当一段逻辑需要在多处使用时,就必须使用 def 抽象为函数。函数的本质是“输入 → 确定处理 → 输出”:通过形参接收输入,通过 return 返回结果。
初学者极易混淆 return 与 print()。print() 仅是在屏幕上投射字符,函数执行完后并没有向调用者交出任何实际对象(默认返回 None);而 return 是将计算出的内存对象正式交还给调用它的上下文,以便后续链式处理。
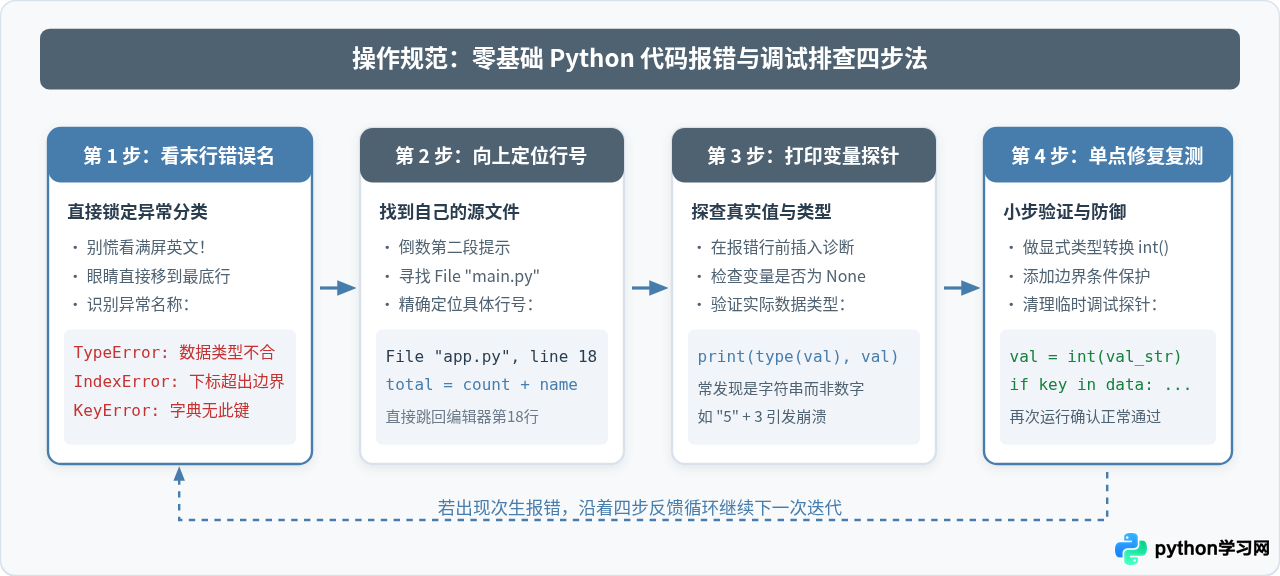
自学过程中超过半数的时间都在与报错打交道。高效自学者与放弃者的分水岭,在于是否具备自主看懂 Traceback 的能力。遇到报错时,遵循规范的四步法:
- 先读最底行:确认错误类型。
TypeError说明传入了不匹配的类型(如字符串加整数);IndexError说明列表访问越界;KeyError说明字典中不存在该键;IndentationError说明缩进层级不统一。 - 向上找行号:在错误回溯信息中,忽略第三方库的内部文件,直接找到最后一行属于自己
.py文件的代码行号。 - 插入打印探针:在报错行之前一行添加
print(type(val), repr(val)),直观检验变量在崩溃瞬间的真实状态。 - 单点验证与修复:通过类型转换或添加
if key in dict:边界判断实施保护,再次运行以确认报错消除。
第四阶段:标准库运用与完整小脚本闭环
检验编程基础是否扎实的最高标准,不是能否在白纸上背诵语法,而是能否结合内置标准库,独立写出一个能解决实际日常工作小痛点的自动化脚本。在这一阶段,应重点掌握:
- 上下文管理器(
with open(...)):安全地读写本地.txt或.csv文件,确保文件句柄在异常发生时也能被正常释放。 - 内置
pathlib或os模块:遍历文件夹目录、拼接跨平台文件路径、筛选指定后缀的文件。 json模块:实现 Python 字典/列表与通用数据交换格式的相互转换。
实践范式:本地文件批量整理器
# 示例:根据文件扩展名分类整理当前目录下的杂乱文件
from pathlib import Path
import shutil

def organize_files(folder_path):
    base_dir = Path(folder_path)
    if not base_dir.exists():
        print(f"指定的目录不存在: {folder_path}")
        return

    for file_path in base_dir.iterdir():
        if file_path.is_file() and not file_path.name.startswith("."):
            ext = file_path.suffix.lower().lstrip(".")
            target_subfolder = base_dir / (ext if ext else "misc")
            target_subfolder.mkdir(exist_ok=True)
            shutil.move(str(file_path), str(target_subfolder / file_path.name))
            print(f"已移动: {file_path.name} -> {target_subfolder.name}/")

# organize_files("./downloads")
该脚本综合了路径存在性验证、目录迭代、字符串前缀与后缀处理、分支防御以及文件系统的安全操作。当能够不照抄源码、仅凭功能需求构思出类似结构的代码时,就代表已经跨过了编程基础的门槛。
基础掌握程度评估与自检标尺
自学者最容易产生的焦虑是“我到底学到什么程度才可以停下来,进入具体的方向(如爬虫、数据分析或 Web 开发)?”。编程基础不需要学得无限深,只需要建立起清晰的边界与解题逻辑。
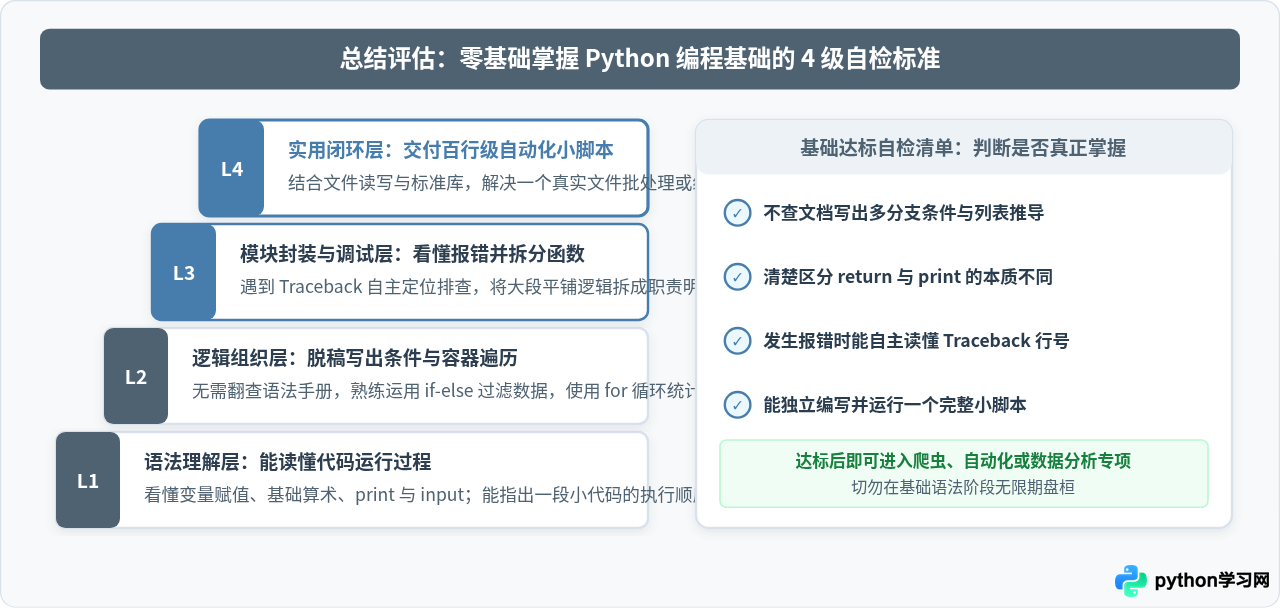
对照以下四条硬性标尺进行自测:
| 能力维度 | 合格表现(达标) | 需补充练习的表现(未达标) |
|---|---|---|
| 语法迁移 | 能够独立用 if-else 与 for 完成多维列表或嵌套字典的数据过滤。 |
仍需频繁打开教程复制粘贴循环结构的骨架。 |
| 概念辨析 | 清晰理解变量是对象的引用,能在纸上准确画出赋值与传参的指针指向。 | 依然认为 a = b 会把整个数据完整复制一份。 |
| 排错韧性 | 看到终端 Traceback 提示后,能在 30 秒内指出是哪一行、由什么类型引发。 | 一看到报错英文就陷入慌乱,不知从何看起。 |
| 项目交付 | 能综合运用文件读写与标准库,独立写出 50~100 行有输入输出的实用脚本。 | 只会写每段不足 5 行的单行练习题,无法串联业务逻辑。 |
一旦达到上述合格表现,就应当立即停止在“语法入门书”上的反复空转,直接根据个人兴趣或工作场景选择后续专项,在真实的实际需求中继续巩固与扩展技能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















