


Python中使用time.sleep实现间隔重复执行任务
详解在Python中使用time.sleep配合循环实现固定间隔重复执行任务的方法,分析固定休眠与动态补偿时间漂移的原理、优雅退出机制及选型边界。
在 Python 中,通过 while True 循环配合 time.sleep(seconds) 是实现定时轮询、间隔重复执行任务最直接且零外部依赖的方案。该方法利用标准库原生的线程休眠能力控制循环频率,适合后台日志同步、心跳检测与状态巡检等轻量场景。本文将从基础实现讲起,深入分析固定休眠导致的“时间漂移”现象及其动态补偿算法,并提供兼具异常隔离与优雅退出的健壮工程模板。
一、基础实现:while 循环与 time.sleep 的标准写法
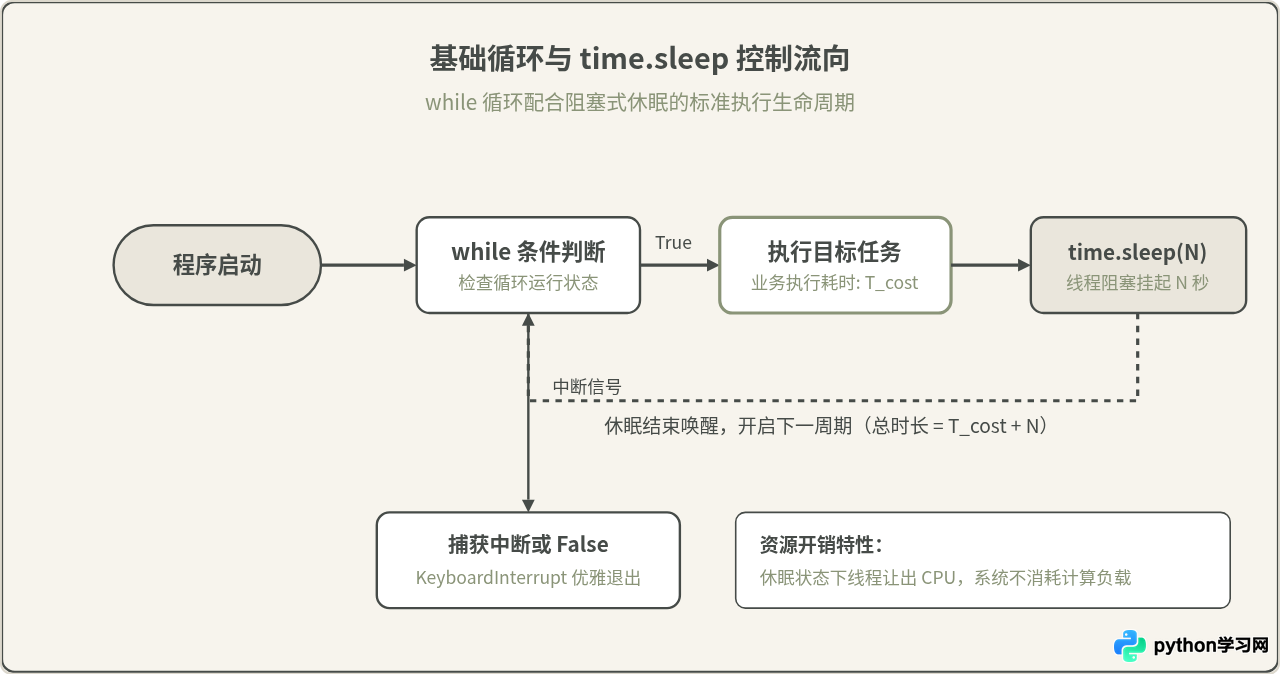
Python 标准库中的 time 模块提供了 sleep() 函数。该函数接收一个浮点数或整数,代表休眠的秒数。在休眠期间,当前线程会主动交出 CPU 控制权并进入挂起状态,直到设定的时间跨度结束再被操作系统重新唤醒。
最基本的间隔重复执行模型,就是将需要执行的业务函数放在一个无限循环(while True)内部,并在每次执行完毕后调用 time.sleep()。以下为标准实现示例:
import time

INTERVAL = 5  # 设定循环间隔为 5 秒

def fetch_system_status():
    """模拟具体业务任务,例如抓取系统状态"""
    now_str = time.strftime("%Y-%m-%d %H:%M:%S")
    print(f"[{now_str}] 正在检查服务运行健康状态...")

print("任务调度器启动,按 Ctrl+C 可停止。")
try:
    while True:
        fetch_system_status()
        time.sleep(INTERVAL)
except KeyboardInterrupt:
    print("\n接收到中断信号,安全退出循环。")
运行上述代码后,终端会每隔约 5 秒输出一条当前时间的检查日志。使用 try...except KeyboardInterrupt 结构可以在用户按下快捷键 Ctrl+C 时平滑退出,避免终端抛出混乱的回溯异常堆栈。
二、深入辨析:为什么固定 sleep 会出现“时间漂移”?
许多初学者往往直观地认为:只要写下 time.sleep(5),任务就会“严格每隔 5 秒整执行一次”。这种认知在日常开发中十分普遍,但若用于精度要求较高的轮询,就会暴露出明显的时间偏差。
为什么该想法看似合理? 如果业务操作非常轻量(例如仅在内存中改变某个计数器,耗时仅 0.001 秒),整个循环一轮的总耗时约为 5.001 秒。在短时间内,人类观察日志输出很难察觉出这一微秒级差别,直观体验与“每 5 秒执行一次”几乎无异。
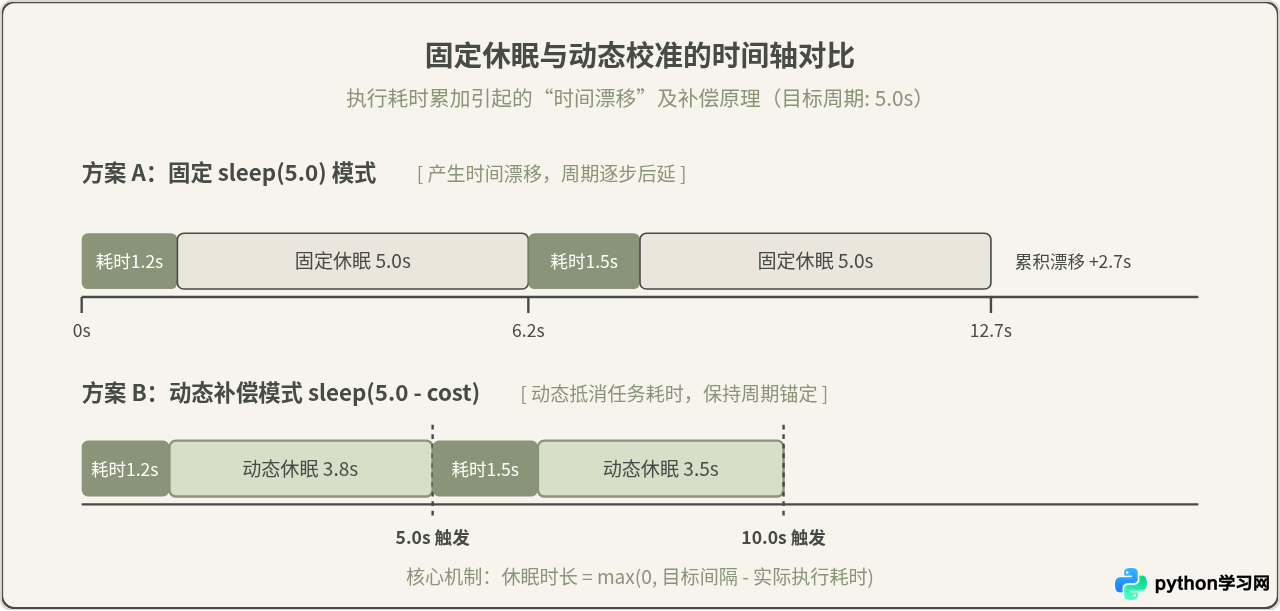
为什么需要修正? 在真实工程中,业务任务通常包含数据库读写、文件 I/O 或网络 HTTP 请求。若一次网络请求耗时 1.2 秒,固定 time.sleep(5) 就会导致该轮循环的实际周期变成 1.2 + 5 = 6.2 秒。每一次任务所花费的时间都会直接叠加到总耗时中,导致下一次任务触发的时间点不可逆地向后推迟。经过 100 次循环后,累积延迟可能高达两分钟以上,这就是所谓的时间累积漂移(Drift)。
三、进阶方案:基于时间差的动态校准休眠
为了解决时间漂移,可以在进入任务前记录起始时间戳,在任务执行结束后计算出实际消耗时长,再用期望的循环周期减去该耗时,得到真正应该休眠的时间。
该算法的核心计算公式如下:
sleep_duration = max(0.0, INTERVAL - (time.time() - start_time))使用 max(0.0, ...) 是为了防御边缘情况:如果某次任务处理特别慢,耗时已经超过了预设的 INTERVAL,剩余休眠时间会算成负数。将其限定在 0 即可避免报错,并让程序立刻开始下一次处理。
以下是具备动态校准机制的核心代码:
import time

INTERVAL = 5.0  # 期望严格维持的执行周期为 5 秒

def process_sync_task():
    """模拟耗时波动的业务操作"""
    start_ts = time.time()
    print(f"[{time.strftime('%H:%M:%S')}] 任务开始执行...")

    # 模拟耗时约 1.2 秒的业务操作
    time.sleep(1.2)

    cost = time.time() - start_ts
    print(f"[{time.strftime('%H:%M:%S')}] 任务执行完成,耗时: {cost:.2f} 秒")
    return cost

while True:
    cycle_start = time.time()

    # 执行业务逻辑
    task_cost = process_sync_task()

    # 计算需要补足的休眠时间
    sleep_time = INTERVAL - (time.time() - cycle_start)
    if sleep_time > 0:
        time.sleep(sleep_time)
    else:
        print(f"警告:单次任务耗时({task_cost:.2f}s)超过了设定周期({INTERVAL}s),跳过本轮休眠。")
四、稳健性与可控性:异常隔离与优雅退出
将循环逻辑放到生产环境长期运行(例如作为守护脚本或在 Docker 容器中执行)时,还需解决两个关键问题:
- 异常崩溃隔离:如果业务代码内部发生网络闪断、接口抛错或数据库短时不可用,未受保护的异常会直接导致整个 Python 主进程崩溃退出。必须在循环内部对任务做单独的
try...except Exception隔离。 - 平滑终止(Graceful Shutdown):当收到系统停止信号(如容器编排平台发送的
SIGTERM或本地的SIGINT)时,应当让当前正在执行的一轮单次任务处理完毕后再退出,避免由于强行截断造成脏数据。
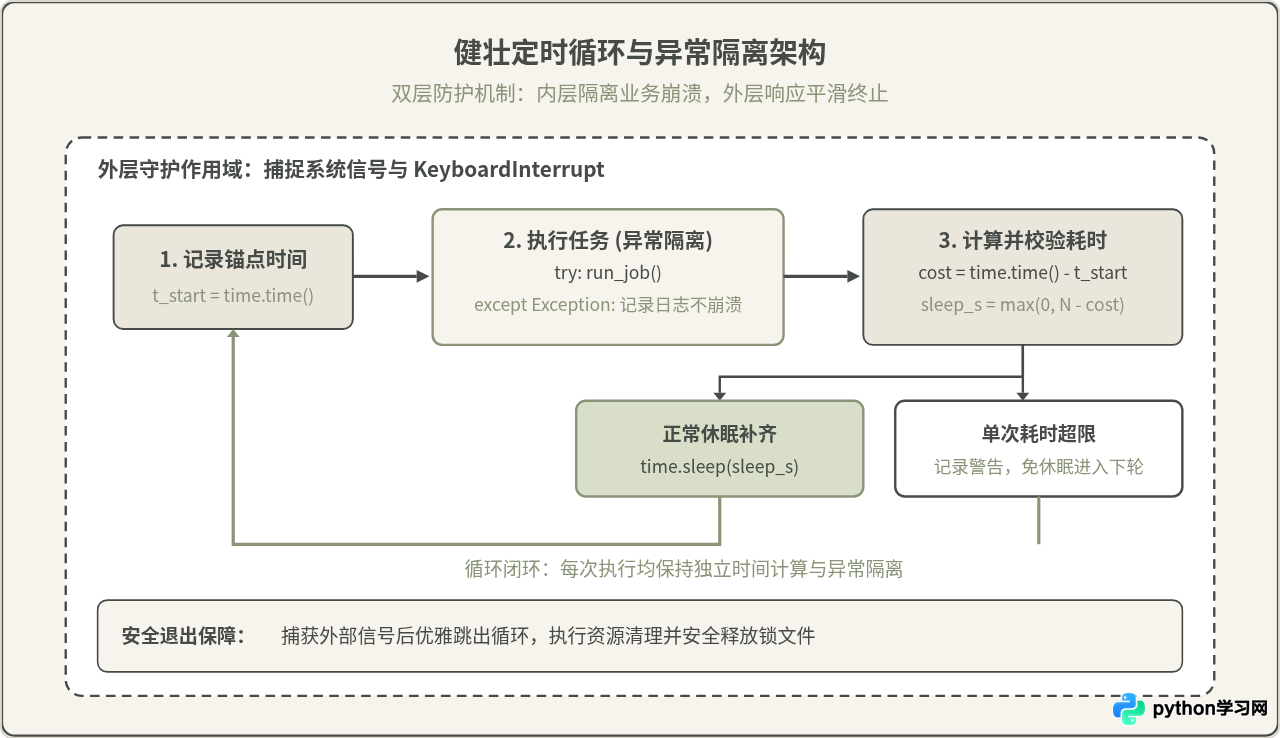
结合上述设计,一个可直接投入生产使用的完整 Python 定时轮询模板如下:
import time
import signal
import sys
import logging

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

INTERVAL = 10.0  # 循环基准周期(秒)
running = True

def handle_exit_signal(signum, frame):
    """拦截退出信号,修改运行标志"""
    global running
    logging.info(f"接收到系统退出信号 ({signum}),等待当前任务完成...")
    running = False

# 注册操作系统信号处理句柄
signal.signal(signal.SIGINT, handle_exit_signal)
signal.signal(signal.SIGTERM, handle_exit_signal)

def perform_job():
    """具体业务逻辑处理函数"""
    # 示例业务:执行特定数据检查
    logging.info("开始拉取最新远程配置...")
    # 模拟网络操作
    time.sleep(0.8)
    logging.info("配置同步完成并验证成功。")

def main():
    logging.info("定时任务服务已启动。")
    while running:
        loop_start = time.time()

        # 内层隔离异常,防止单次业务失败导致整个守护进程崩溃
        try:
            perform_job()
        except Exception as err:
            logging.error(f"业务执行发生非预期异常: {err}", exc_info=True)

        # 计算校准休眠时长
        elapsed = time.time() - loop_start
        sleep_duration = INTERVAL - elapsed

        if sleep_duration > 0:
            # 分步小段休眠,以便能够快速响应退出信号
            step = 0.5
            slept = 0.0
            while running and slept < sleep_duration:
                current_sleep = min(step, sleep_duration - slept)
                time.sleep(current_sleep)
                slept += current_sleep
        else:
            logging.warning(f"单次执行耗时 {elapsed:.2f}s 超过了指定周期 {INTERVAL:.2f}s")

    logging.info("清理资源完毕,服务平稳终止。")

if __name__ == "__main__":
main()在上面的完整模板中,休眠阶段被拆解为了短步长(step = 0.5 秒)的循环判定。如果直接调用 time.sleep(10),当用户在休眠刚开始的第一秒按下终止键时,系统需要等待整整 9 秒休眠结束才会退出;而拆解判定后,可以在最多 0.5 秒内响应退出信号,极大提升了守护进程的停机敏捷度。
五、适用边界与方案选型总结
虽然 time.sleep 结合循环是极其方便的定时执行手段,但在实际架构设计中,它也有明确的能力边界。了解其优缺点有助于我们在合适的情景下做出最理性的技术选型。
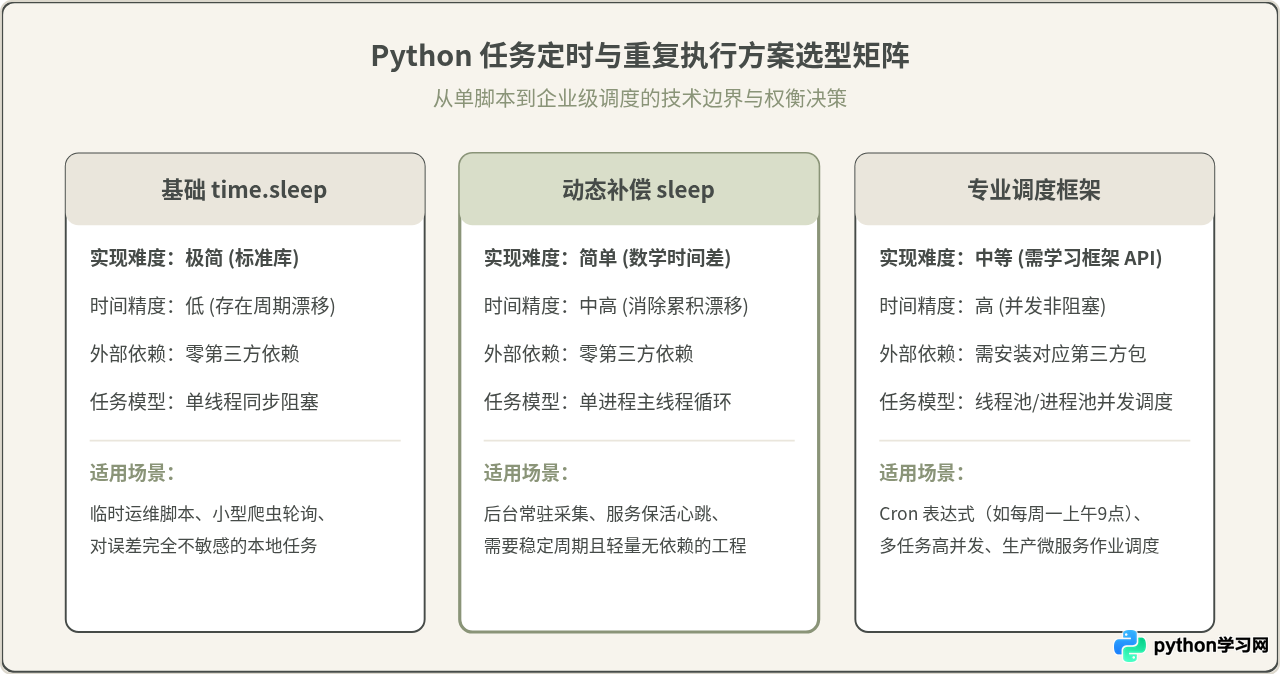
总结与最佳实践建议
使用 time.sleep 实现间隔重复任务,核心在于根据任务的业务属性评估精度需求:
- 对于简单脚本与测试验证,直接使用基础
while True: do_job(); time.sleep(N)即可满足需求。 - 对于需要长期稳定运行的中小后台任务,推荐采用基于时间差的动态校准方案,并配合
try...except隔离和短步长退出判断,以消除周期漂移并保证优雅停机。 - 如果需求涉及复杂的日历规则(例如“每个月的最后一个工作日 18:00 执行”)、多任务并发编排或错过执行后的补偿机制(Misfire Execution),则应当选择
APScheduler、Celery Beat或 Linux 系统自带的crontab。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















