


Python在线编译器与本地IDE开发环境有什么区别
深度解析Python在线编译器与本地IDE开发环境的核心机制差异、操作流程对比、能力边界以及工程选型指南。
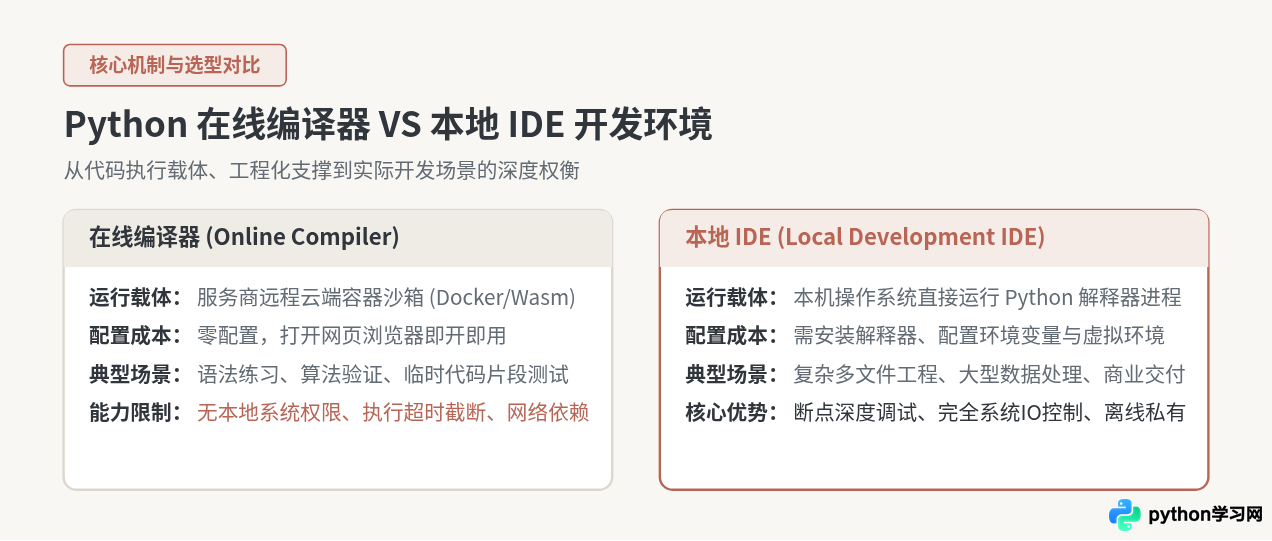
一、核心机制:云端沙箱与本地操作系统的本质差异
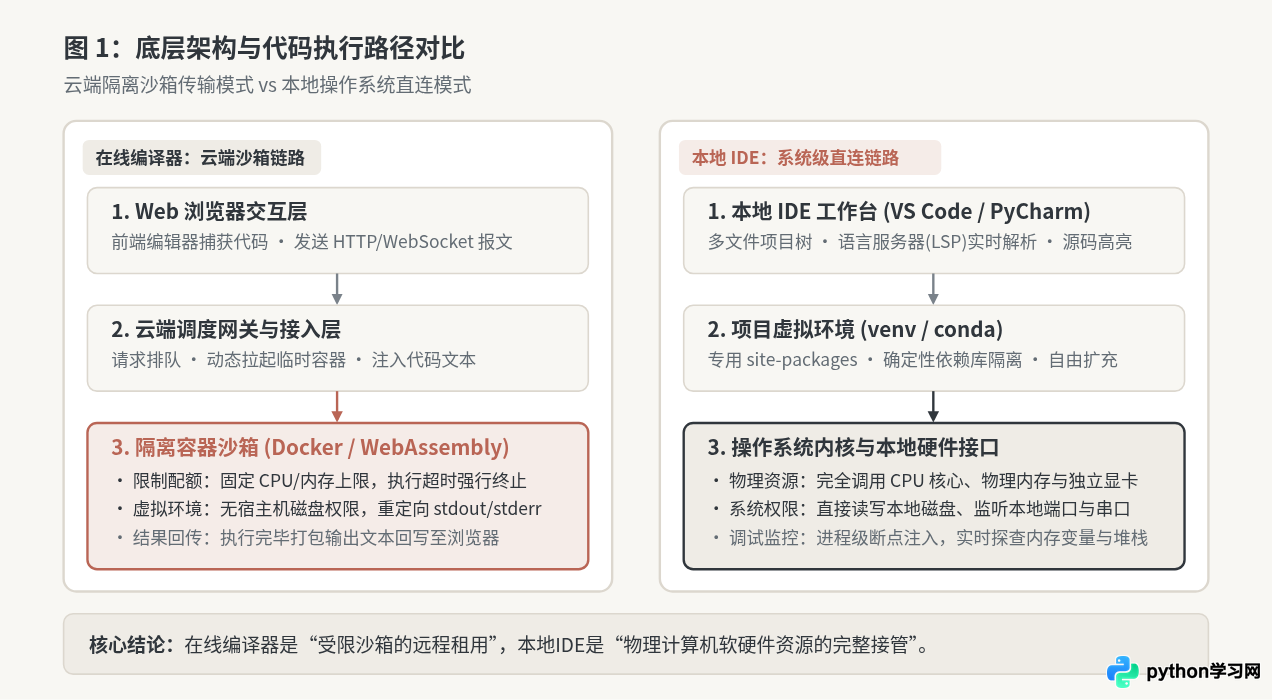
从底层执行路径来看,两者在代码提交后的物理流转完全不同。理解这一底层差异,能够直接解释为什么许多在本地能跑通的操作无法在线上执行,或者反之在线上极为简便的操作在本地却需要繁复的环境准备。
在线编译器的远程沙箱执行模式:当你在网页中输入一段 Python 脚本并点击运行后,代码会以文本报文的形式通过网络传输至云端服务端。服务器接收到请求后,将其调度至预置的轻量容器(如 Docker 实例或 WebAssembly 运行环境)内执行。为了保障多租户安全与服务器稳定性,该容器严格限定了单次运行的最大 CPU 配额、物理内存上限以及执行超时时间(通常限制在几十秒内)。容器完成代码执行后,将标准输出流(stdout)或异常错误流(stderr)重定向打包,回传给浏览器控制台渲染,随之临时会话可能被销毁或休眠。
本地IDE的物理硬件直连模式:本地开发环境由“编辑器界面 + 本地 Python 解释器 + 操作系统运行库”协同构成。代码保存在本地磁盘的真实路径下,IDE 通过进程调用直接启动本地安装的 python.exe(或 python3 二进制文件)。该进程拥有宿主操作系统的常规用户态权限,可以直接向磁盘写入大型数据文件、监听本地端口建立网络通信、调用物理显卡(GPU)进行硬件加速,甚至通过底层驱动接口操作 USB 或串口硬件。
二、关键能力维度深度对比
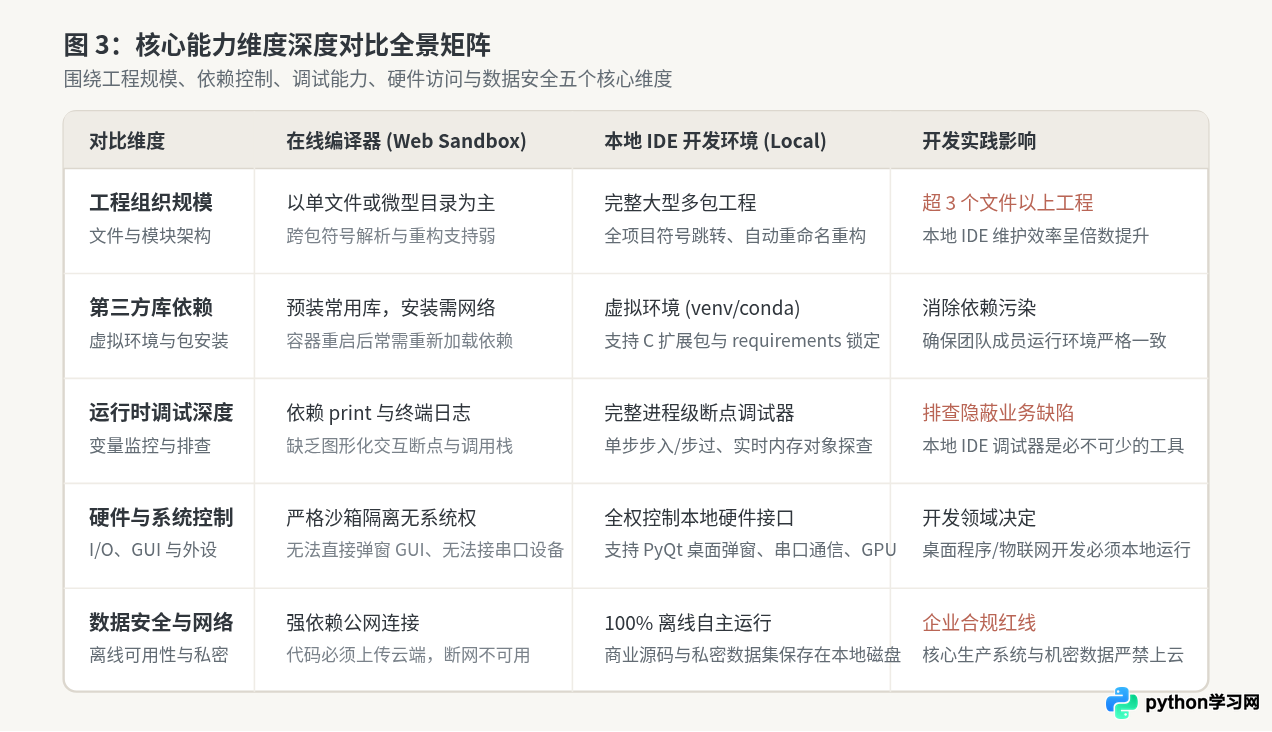
在实际项目演进过程中,代码规模的增长往往会迅速触碰在线环境的功能天花板。以下五个核心维度是区分两者的关键指标:
1. 项目与文件组织规模
在线编译器绝大多数设计为“单文件脚本执行模式”或极简的多文件列表。虽然部分现代在线平台(如 Replit)提供了虚拟文件树,但其对深层包结构(Package)、相对与绝对导入路径、复杂资源文件关联的处理能力依然脆弱。本地 IDE(如 VS Code 配合 Pylance 扩展,或 PyCharm 专业版)则原生支持超大规模项目的工程模型,提供全项目符号索引、跨文件函数重命名重构、语法树静态分析与依赖依赖关系图谱。
2. 第三方库管理与环境隔离
Python 社区拥有庞大的第三方库生态,而依赖管理是工程稳定性的生命线。
- 在线编译器:平台通常预装固定版本的通用库(如
requests、math、基础版pandas)。若需额外安装库,需要平台沙箱具备外网包下载权限,且在容器被回收重启后,之前安装的包可能直接丢失;更关键的是,许多需要调用本地 C/C++ 编译器构建动态链接库的扩展包,在云端沙箱中无法顺利编译。 - 本地IDE:通过原生虚拟环境工具(如
python -m venv .venv或conda),开发者可以在本机为每一个项目创建完全独立的依赖沙盒,自由安装任意版本的第三方库,并导出确定性的requirements.txt或poetry.lock,实现多人协作与生产环境的一致性。
3. 运行时调试与可观测性
代码出错时如何排查,是区分学习工具与生产力工具的分水岭。在在线编译器中,开发者排查错误主要依赖在代码中穿插 print() 打印语句和分析抛出的回溯(Traceback)文本。
本地 IDE 提供了基于底层进程挂钩(Debug Adapter Protocol)的交互式图形调试器。开发者可以在任意代码行下设断点(Breakpoint),程序执行到断点时会精准冻结当前线程,允许开发者步入(Step Into)、单步跳过(Step Over)、逐层查看函数调用栈(Call Stack),并在独立面板中实时探查全局与局部变量的内存地址与内部数据结构,甚至可在即时求值终端中动态输入表达式执行。在排查深层逻辑漏洞或高并发竞态条件时,这种能力具有不可替代的作用。
4. 操作系统权限与硬件交互能力
受限于云端安全防护,在线编译器切断了对客户端真实操作系统的直接交互通道。这意味着:
- 如果你编写需要弹出本地图形界面窗口的程序(如
tkinter、PyQt、pygame),在线编译器通常无法正常弹出原生桌面窗口(除非平台借助复杂的 WebVNC 或 Canvas 间接模拟,且存在极高延迟与卡顿); - 如果你需要操作本地扫描仪、单片机串口(
pyserial)、USB 调试设备,在线编译器完全无法访问你的本地物理总线; - 本地 IDE 则具备完整的系统特权,只要本地操作系统当前用户拥有权限,即可随心所欲调度所有本地硬件外设。
5. 数据安全与网络依赖性
在线编译器必须在连接公网的条件下运行,且所有键入的代码与传入的数据必须上传至服务商的远程服务器。在涉及企业商业源码、个人身份信息、敏感数据库连接凭据时,将数据输入公共在线沙箱存在合规与泄漏风险。本地 IDE 则支持 100% 离线脱网运行,代码与数据资产完全留存在本地硬盘,满足保密开发规范。
三、操作流程与工作流链路拆解
两者的区别直观体现在日常开发时的具体步骤上。在线编译器追求极短的“即时验证”,而本地 IDE 遵循规范的“软件工程生命周期”。
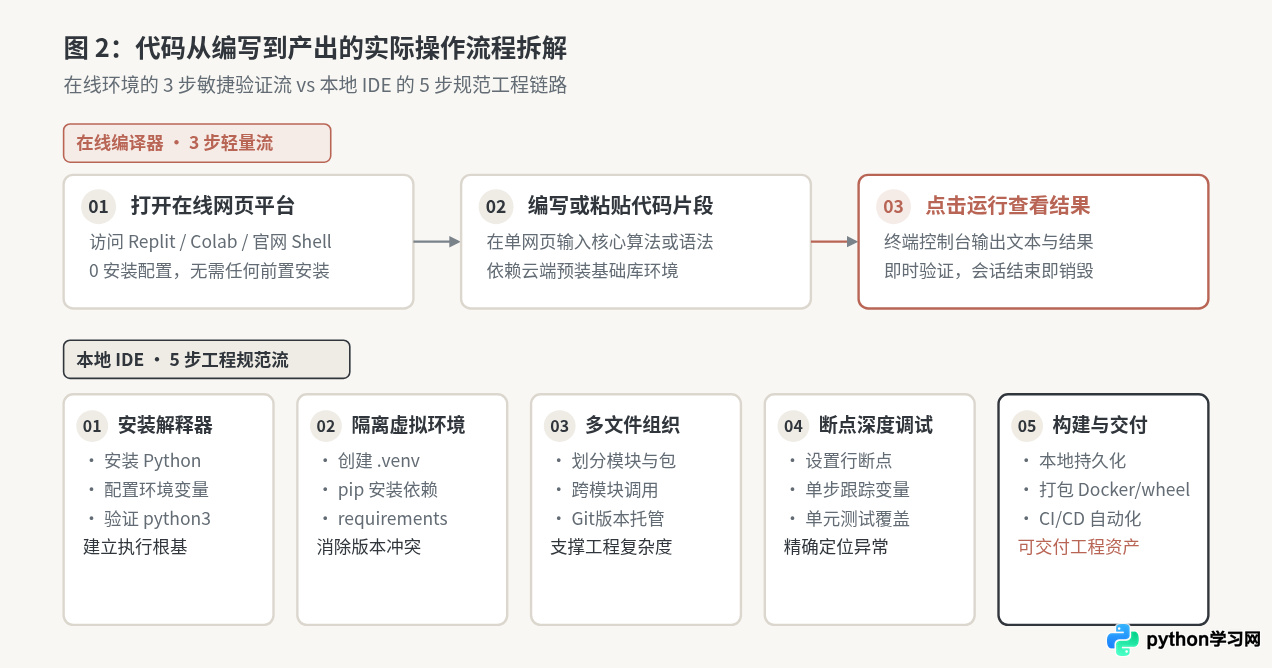
在线编译器的操作流程(3步轻量流)
- 打开网页终端:打开浏览器,访问在线编译器网址(如 Replit、Google Colab 或 Python 官方网站的交互 Shell);
- 编写或粘贴代码:在网页内的单窗口代码框中直接敲入核心函数或算法逻辑;
- 点击运行(Run):点击运行按钮,云端容器秒级返回执行结果并打印在右侧控制台,关闭网页即完成验证。
本地IDE的标准工程化流程(5步规范流)
- 解释器安装与环境变量配置:从官方渠道下载对应操作系统的 Python 安装包,勾选添加 PATH 环境变量,并在系统终端中验证
python3 --version可用; - 初始化项目与隔离虚拟环境:在项目根目录下通过终端执行命令构建隔离沙箱:
# 创建项目专用的虚拟环境 python3 -m venv .venv # 激活虚拟环境 (macOS/Linux) source .venv/bin/activate # Windows 环境则执行: .venv\Scriptsctivate # 安装并锁定工程依赖 pip install requests pandas pip freeze > requirements.txt - 工程化组织与代码编写:在 IDE 中打开项目文件夹,根据业务规划将代码拆分为
main.py、config.py、models/、utils/等模块,利用 IDE 的智能感知完成跨模块引用; - 断点调试与自动化测试:配置
launch.json调试文件,设置条件断点,编写pytest单元测试用例,确保各模块边界逻辑严谨无误; - 本地持久化与构建交付:将代码提交至本地 Git 仓库,生成可分发的 Wheel 包或打包为 Docker 镜像,实现向生产环境的无缝交付。
四、开发环境选型决策指南
许多初学者常陷入两个误区:一是认为“既然本地 IDE 这么强大,就必须在第一天死磕环境变量配置”;二是认为“在线编译器只是玩具,没有任何严肃价值”。合理的做法是依据当前的任务目标与条件边界,做出明确的选择。
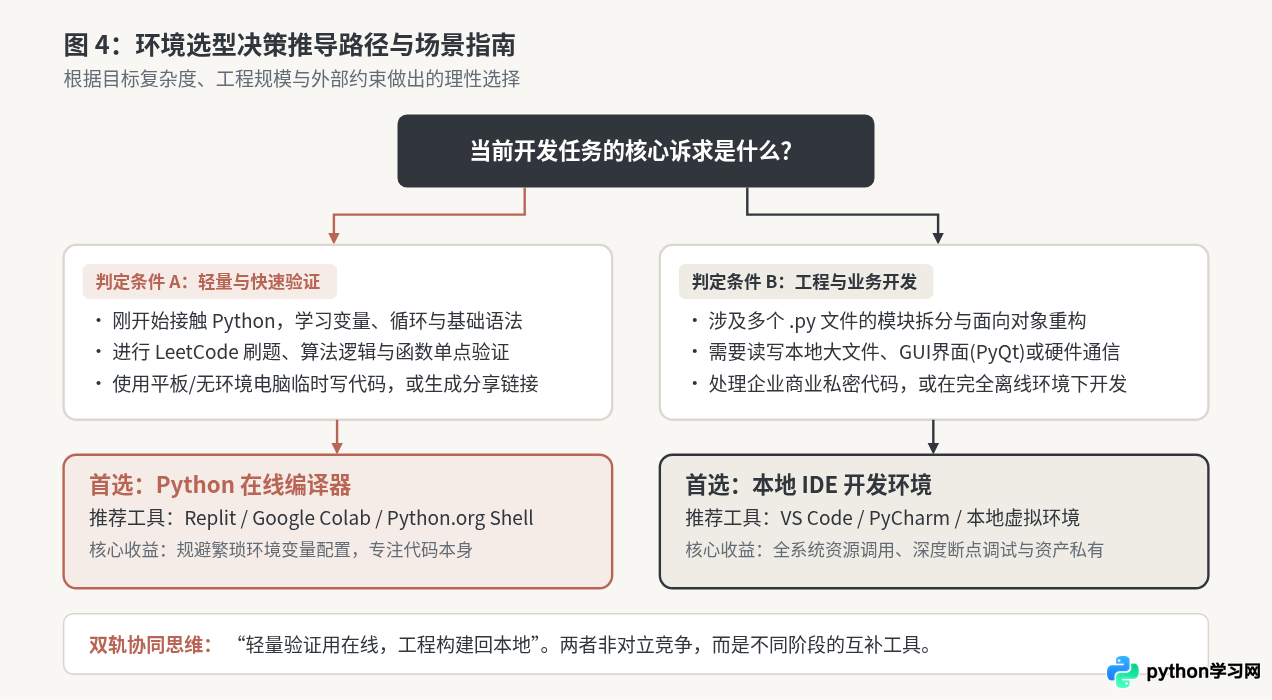
当核心诉求是“快速获知单一逻辑片段的输出结果”时,优先使用在线编译器;当核心诉求是“构建可维护、长期迭代、与本地资源紧密关联的软件系统”时,必须使用本地 IDE。
优先选择在线编译器的典型场景
- 语法学习与基础语法试练:初学 Python 的前两周,重点是理解
if/else、循环结构、列表推导式、字典用法。此时使用在线编译器能够直接避开路径配置、PATH 丢失、权限报错等挫败感极强的非语法干扰; - 算法刷题与原型快速推导:在 LeetCode、牛客等平台练习算法题目时,在线沙箱可在数秒内验证边界用例的正确性;
- 临时设备与轻量终端协作:在 iPad、Chromebook、临时公共电脑或无开发权限的终端上,只需浏览器即可即时编写并调试代码片段;
- 团队即时复现与分享:生成一条可分享的在线执行 URL,同事无需在本地配置相同版本的解释器即可直接在线点击复现 Bug;
- 借助云端特殊算力(如 Google Colab):在机器学习与深度学习领域,Google Colab 这类进阶在线笔记本环境提供了免费的云端 GPU/TPU 算力,非常适合跑模型演示与学术论文复现。
必须转向本地IDE环境的典型场景
- 实际业务与工程化项目开发:包含多个自定义
.py文件的系统、Web 服务(Django/FastAPI)、爬虫系统、企业自动化脚本; - 处理本地私有文件与大型数据集:需要读取本机磁盘上的几十吉字节日志、读取本地 Excel 报表或读写本地 SQLite/MySQL 数据库;
- 桌面软件与图形应用开发:使用 PyQt、Tkinter 开发桌面窗体,或使用 Pygame 编写需要高刷新率与本地键盘鼠标事件响应的游戏;
- 硬件通信与自动化控制:操作本地连接的串口设备、物联网传感器、摄像头(OpenCV 视频流实时捕获);
- 敏感资产与保密合规要求:企业商业系统、个人财务模型等绝对禁止上传到公共第三方云端的数据与代码。
五、常见认知误区与避坑建议
在实际使用中,开发者还需要注意以下几个容易被忽视的技术细节与避坑点:
- 注意环境版本的隐性差异:在线编译器使用的 Python 解释器版本由服务商决定(例如固定的 3.10 或 3.11)。在在线环境写好使用了新语法(如 3.10+ 的
match/case模式匹配)的代码后,如果复制回本地一台运行老旧 Python 3.8 的机器上运行,会直接报SyntaxError语法错误。迁移代码时应首先核对两端的sys.version。 - 警惕数据与代码丢失风险:免费公共在线编译器多为无状态或临时会话机制。长时间闲置、浏览器缓存清理或标签页异常崩溃,可能导致未导出的代码片段瞬间丢失。涉及重要逻辑时,务必养成随时将代码复制保存到本地文本或代码仓库的习惯。
- 文件读写的相对路径陷阱:在部分在线编译器中读写文件(如
open('data.txt', 'w')),文件保存在云端沙箱的当前工作目录中,页面刷新后该文件往往不复存在;而在本地 IDE 中,相对路径的基准通常取决于执行时的工作目录(Working Directory),两者在路径解析逻辑上有明显差别。
总结:Python 在线编译器与本地 IDE 并非替代关系,而是开发者工具链中互为补充的两个端点。善用在线编译器的“敏捷轻盈”,可使概念学习与片段验证事半功倍;熟练掌握本地 IDE 的“系统工程掌控力”,则是通向专业软件开发与稳定业务落地的坚实基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















