


免费网页版Python运行慢或超时怎么办?常见限制与解决技巧
深入解析免费网页版Python常见的运行慢、卡死与超时报错原因,涵盖前端WebAssembly与云端容器沙箱的限制机制,提供从代码优化、I/O控制到架构排查的完整解决技巧。
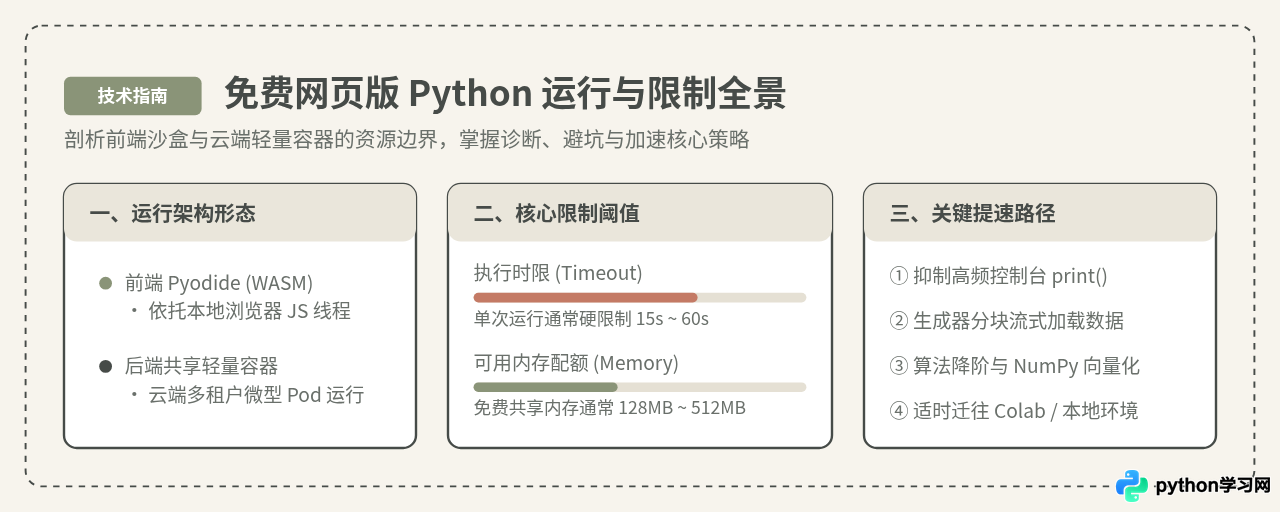
一、为什么免费网页版 Python 会变慢或超时?
很多初学者在本地电脑运行良好的 Python 代码,粘贴到免费在线编辑器(如各大编程学习网站的内置运行框、轻量级在线 Notebook 工具)后,却频繁遇到“卡死不动”或提示“Execution Timed Out / 504 Gateway Timeout”。要解决这一现象,首先必须理解免费网页版背后的运行架构差异。
目前市面上的免费网页版 Python 主要分为两大架构形态,各自面临完全不同的物理瓶颈:
- 前端执行型(基于 WebAssembly / Pyodide):代码完全在用户本地浏览器的 JavaScript 引擎中编译并运行。由于浏览器出于安全考虑将页面运行在单线程沙盒内,一旦 Python 脚本执行密集的 CPU 计算,就会直接霸占浏览器的主渲染事件循环,导致网页瞬间出现“页面无响应”的假死状态。同时,浏览器标签页存在严格的内存上限与跨域请求(CORS)阻断。
- 服务端容器沙箱型(共享 Linux 容器):用户的代码通过 WebSocket 或 HTTP 请求被发送到服务商的后端服务器,并在一个临时的轻量级 Docker 容器或沙箱 Pod 中运行,执行完毕后再将控制台输出传回前端。为了防止个别用户的恶意死循环或大算力程序拖垮整台母机,服务商必定在负载均衡层和容器宿主机上配置了强制的硬超时(通常单次请求严格限制在 15 秒至 60 秒内)与微小的内存配额(通常为 128MB 至 512MB)。一旦超限,系统内核的 OOM Killer 会直接强杀进程。
二、运行异常自查:4 步排查操作步骤
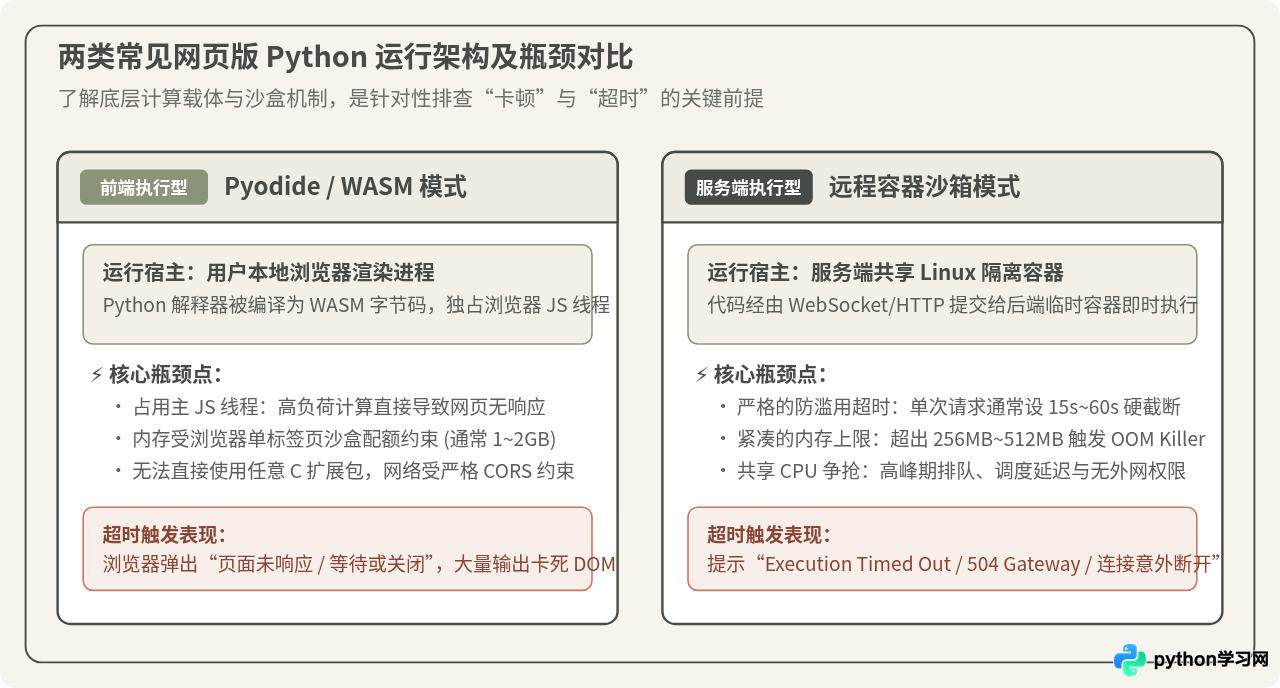
当网页端 Python 停止响应或报错时,不要盲目刷新重试。刷新往往只会清空当前已写好的上下文,或者重新排队。按照以下 4 个步骤由表及里地排查,可以在一分钟内准确定位原因:
第 1 步:观察报错特征,区分“前端假死”与“后端断连”
首先通过界面表现判断问题发生在哪一端:
- 界面完全冻结、滚动条无法拖动、浏览器弹窗“等待或关闭标签页”:这几乎必定是前端 DOM 渲染过载或 Pyodide 独占主线程。通常是因为你在循环中输出了数万行日志,浏览器渲染队列被塞满。
- 代码执行一段时间后,控制台直接打印
TimeoutError、504 Gateway Time-out或Execution timed out after 30s:这表明代码成功送达后端,但纯运行耗时超过了平台设置的安全阈值。 - 毫无前兆地提示
Kernel died、Connection reset by peer或无任何报错直接重置输出区域:这通常是内存超限(OOM)的典型表现。容器内存触顶后被 Linux 内核直接SIGKILL,Python 解释器甚至来不及捕获异常并打印 traceback。
第 2 步:审查算法死循环与复杂度陷阱
排除了界面假死后,检查代码本身的逻辑循环:
# 常见隐蔽死循环示例:浮点数累加无法精确命中终止条件
val = 0.0
while val != 1.0:    # 由于浮点数精度误差,val 可能直接从 0.9999999 跳到 1.0000001
    val += 0.1       # 导致循环永不终止,直至触发平台硬超时
另一个常见重灾区是嵌套双重循环。如果外层循环 10,000 次,内层也在 10,000 个元素的列表中进行 if item in my_list: 线性查找,总运算次数达到 1 亿次。在本地高性能 CPU 上原生 Python 可能需要跑 5~10 秒,而在分配了 0.2 核共享 CPU 的免费沙盒中,耗时往往会膨胀到 30 秒以上,必定触发超时断开。
第 3 步:测量数据体量与内存消耗
检查脚本中是否存在一次性将整个文件载入内存的行为。例如直接使用 lines = f.readlines() 读取数十兆的日志文件,或使用 pandas.read_csv("large_data.csv")。在免费网页版中,只要瞬间分配的内存超过 256MB~512MB,容器就会静默崩溃。
第 4 步:检查依赖拉取与网络 I/O
很多网页版工具在首次运行包含 import scipy 或 import matplotlib 的脚本时,需要在后台实时下载对应的 WASM 轮子文件或安装环境。如果当前网络环境连接海外源不稳定,下载过程本身就可能耗尽运行时间配额,导致超时报错。
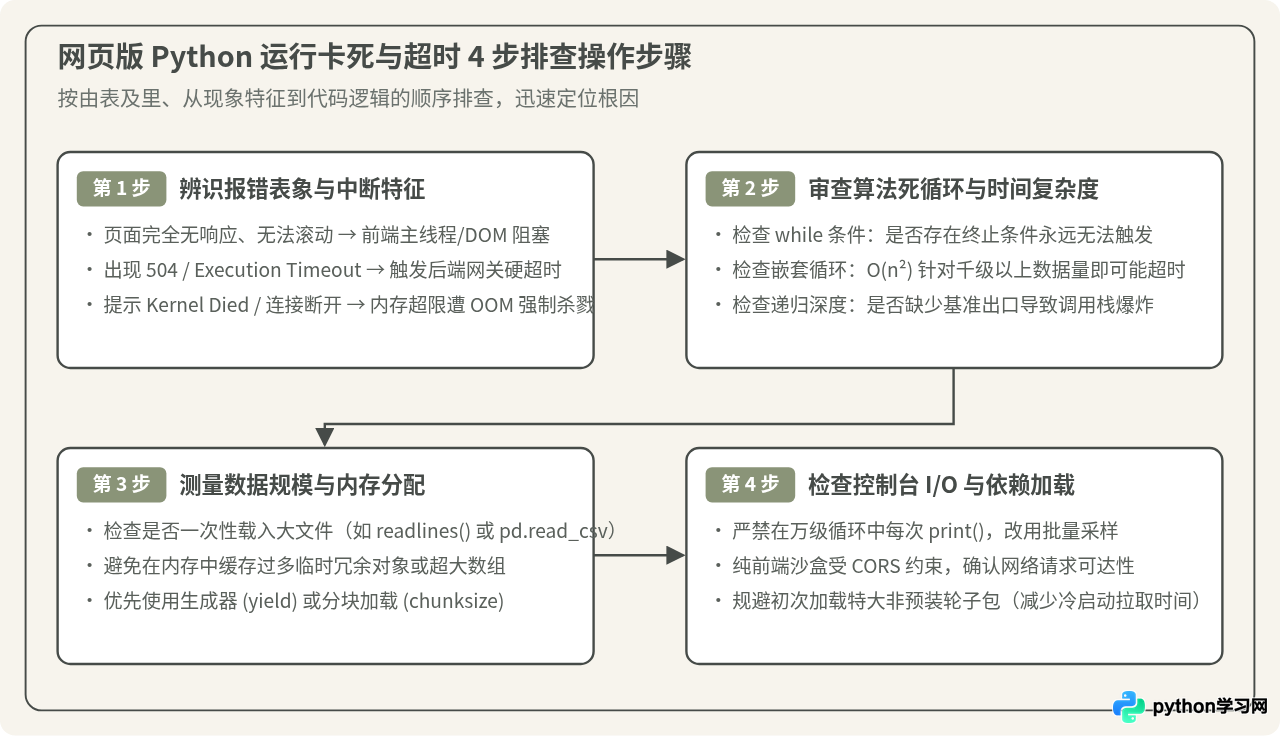
三、针对沙盒限制的高效解决与优化技巧
在理解了限制之后,大多数运行超时问题并不需要升级付费服务,只需对代码做几处细微的习惯性调整即可迎刃而解。
技巧 1:控制台高频输出抽稀(拯救渲染性能)
在本地终端中连续打印 10,000 行文字可能只需几十毫秒,但在网页版中,每一次 print() 都需要经过“Python 输出捕获 → WebSocket 打包传输 → 浏览器 DOM 节点创建与样式重排”这一冗长链条。高频 print() 是导致网页卡死的第一大元凶。
# ❌ 错误做法:在循环中每次都 print,导致数万次 DOM 重绘
for i in range(100000):
    # 执行某些轻量计算
    res = i * 2
    print(f"当前计算进度: {i}")  # 极易导致浏览器假死或运行超时

# ✓ 推荐做法:按固定步长采样输出,或仅在计算完成后汇总输出
for i in range(100000):
    res = i * 2
    if i % 20000 == 0:        # 抽稀为每 20000 次输出一次进度
        print(f"进度更新: {i} / 100000")
print("全部计算完成!")
在实测中,仅将高频 print() 优化为采样输出,即可将代码的整体运行耗时从 20 多秒骤降至 0.1 秒以内,提速效果超过 200 倍。
技巧 2:采用生成器与分块加载(规避内存 OOM)
当需要处理稍大规模的数据时,切忌一次性在内存中构建出庞大的数据列表。使用 Python 的生成器(Generator)进行惰性求值(Lazy Evaluation),可以让内存占用保持在接近常数级的极低水平。
# ❌ 错误做法:一次性在内存中生成包含 500 万元素的巨型列表
# 该操作需要一次性申请数百兆连续内存,极易导致轻量容器直接崩溃
huge_list = [x ** 2 for x in range(5000000)]
total_sum = sum(huge_list)

# ✓ 推荐做法:使用生成器表达式进行流式求值
# 生成器每次只在内存中保留一个当前元素,内存占用不足 1MB
total_sum = sum(x ** 2 for x in range(5000000))
对于文件读取和 CSV 处理,同样应当优先使用分块迭代的方式:
# 针对大文件的安全逐行读取方式(避免 f.readlines() 一次性载入)
with open("sample_data.txt", "r", encoding="utf-8") as f:
    for line in f:   # 迭代器协议:内存仅保留当前单行内容
        process(line)
技巧 3:利用哈希查表与内置函数降阶
Python 原生的解释型执行开销较大。对于频繁的查找操作,必须将线性列表转换为基于哈希表的集合(set)或字典(dict),将时间复杂度从 $O(n)$ 直接降为 $O(1)$。
# ❌ 低效:在万级列表中执行线性查找,整体复杂度 O(m * n)
target_pool = list(range(1, 20000))
check_items = list(range(10000, 30000))
matched = [x for x in check_items if x in target_pool]  # 极慢,极易超时

# ✓ 高效:先将目标池转换为集合,整体复杂度降为 O(m + n)
target_set = set(range(1, 20000))                       # 构建哈希表仅需瞬间
matched = [x for x in check_items if x in target_set]   # 单次查找 O(1),瞬间完成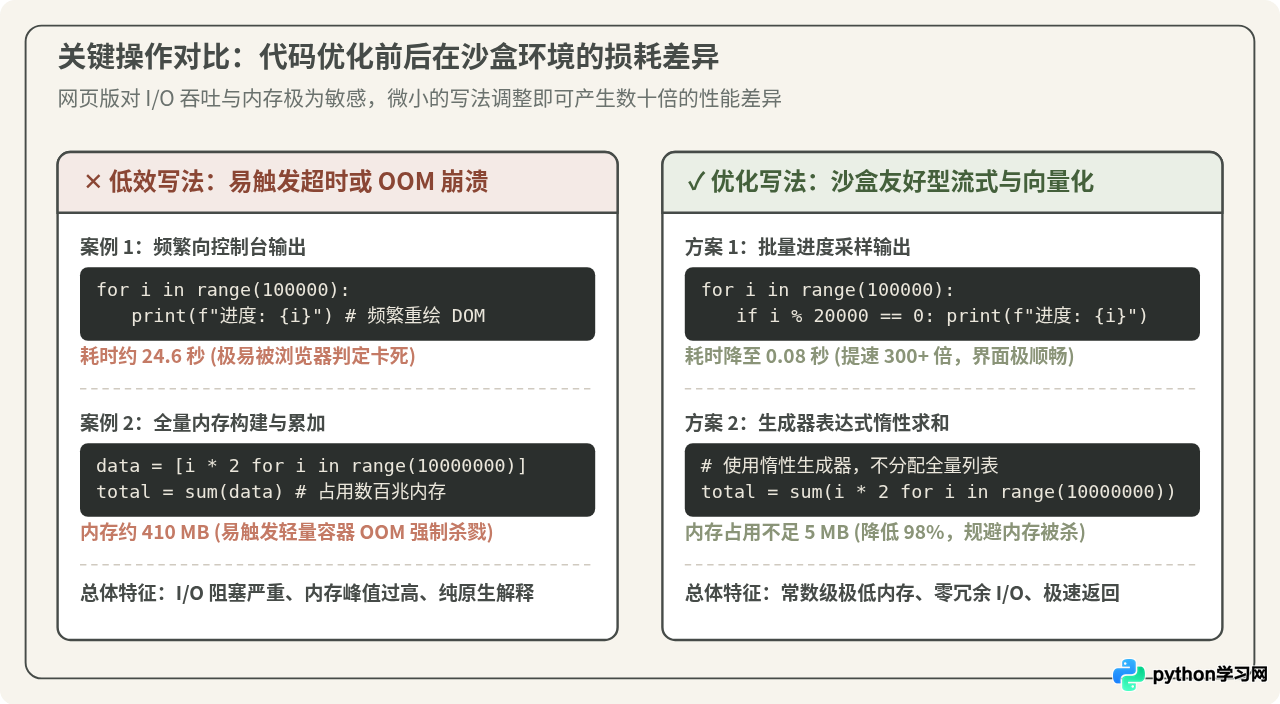
常见说法:“网页版 Python 运行超时,只要在代码里找到设置 timeout 的参数或者在网页设置里改大超时时间就行了。”
合理之处:在进行网络爬虫或外部 API 请求时(如使用 requests.get(url, timeout=30)),显式设置合理的网络等待时间确实能容忍较慢的第三方响应。
修正说明:但在免费网页版 Python 的运行机制中,限制执行时间的并不是 Python 脚本内部的代码逻辑,而是外部的基础设施守护进程(Nginx 反向代理、API 网关及 K8s Job 限额)。这些限额是服务商在基础设施层写死的防火墙规则,普通网页用户无法通过代码或客户端配置来突破。如果是由于内存泄漏、算法死循环或海量数据导致的卡顿,即便允许程序多跑 30 秒,通常也只会延长白屏等待时间并最终返回 504 错误。只有优化算法结构与内存模式,才是解决超时的根本之道。
四、何时应继续在网页版优化,何时该转向本地环境?
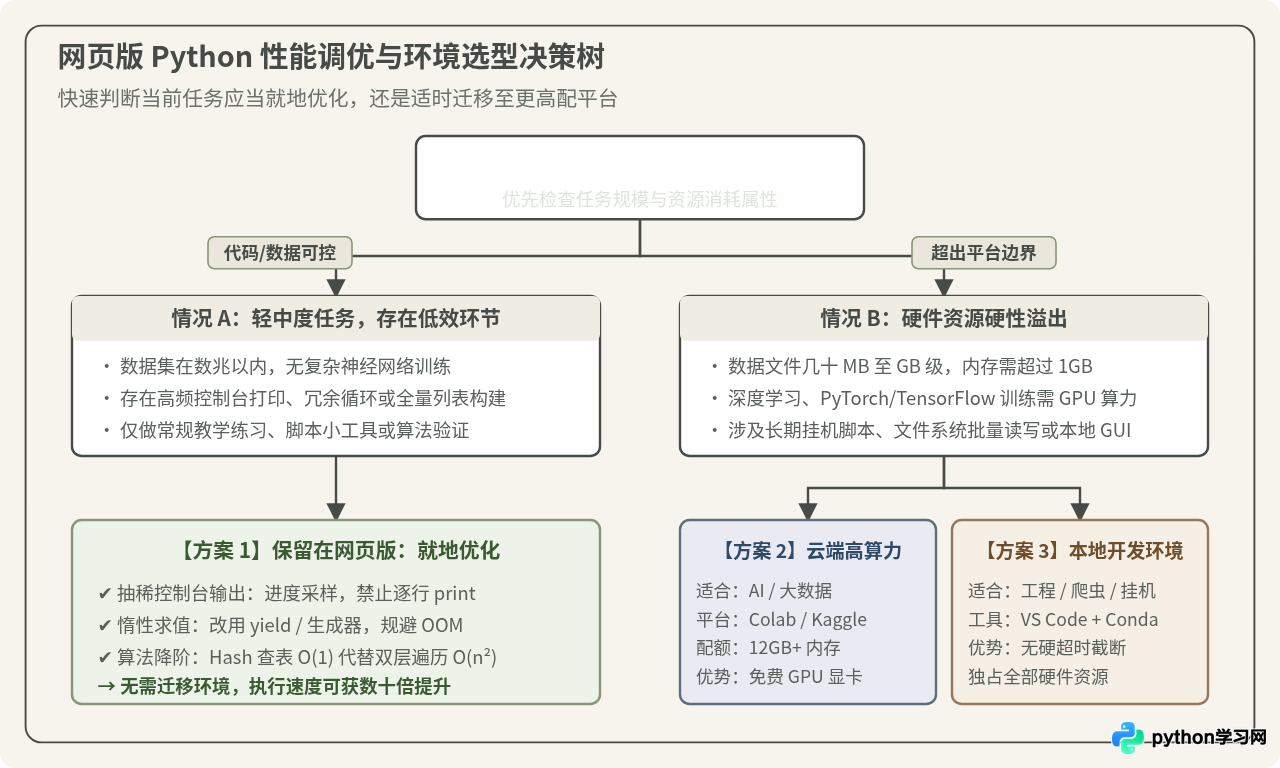
虽然通过代码优化可以解决 80% 以上的网页版超时问题,但免费在线环境终究有其不可逾越的物理边界。清楚认识这一边界,能帮助你避免在错误的环境中浪费大量调试时间。
| 任务类型与场景 | 推荐运行环境 | 选择依据与环境边界 |
|---|---|---|
| 语法基础学习、短算法练习、代码片段分享验证 | 免费网页版 Python(轻量在线 IDE) | 即开即用、零配置,数据规模在数兆以内,耗时通常在 5 秒以内。 |
| 中大规模数据分析、Pandas 复杂处理、机器学习入门 | Google Colab / Kaggle Notebook | 免费提供 12GB+ 内存及充足单核算力,单 Cell 允许运行数十分钟。 |
| 深度学习、PyTorch/TensorFlow 模型训练 | 带 GPU 实例的云端平台(Colab/Kaggle) | 需调用 CUDA 和显存(T4/P100),普通轻量网页版完全无法支持。 |
| 长周期爬虫、后台守护服务、桌面 GUI 开发、硬件联动 | 本地 Python 环境(VS Code + Miniconda) | 需要独占硬件、本地文件系统权限、无断网超时、保护商业隐私数据。 |
五、总结与自查速查清单
面对免费网页版 Python 的运行慢或超时问题,建议在每次点击运行前保持以下良好的编码自查习惯:
- 检查控制台日志密度:循环次数超过 1,000 次时,绝不逐轮执行
print(),务必使用模运算if i % step == 0抽稀输出。 - 检查数据结构复杂度:高频元素检索优先使用
set或dict,避免两层嵌套的线性列表in扫描。 - 检查内存占用形态:处理长序列或外部文件时,优先采用生成器表达式
(x for x in ...)和逐行迭代,规避内存峰值。 - 检查循环终止条件:确保
while循环有明确且必定能够到达的退出边界,避免浮点数等值判断陷阱。 - 理性评估任务量级:若数据量超过 50MB 或包含大型第三方神经网络库,及时切换至 Google Colab 或本地 VS Code 环境,不再与轻量沙盒的物理配额强行较劲。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















