


Python for循环中怎么同时获取索引和元素值
本文详细讲解在 Python 的 for 循环中如何同时获取当前索引和元素值,深入解析标准函数 enumerate() 的使用技巧、元组解包工作原理、自定义 start 参数,以及对比辨析 range(len()) 与计数器写法的适用边界与注意事项。
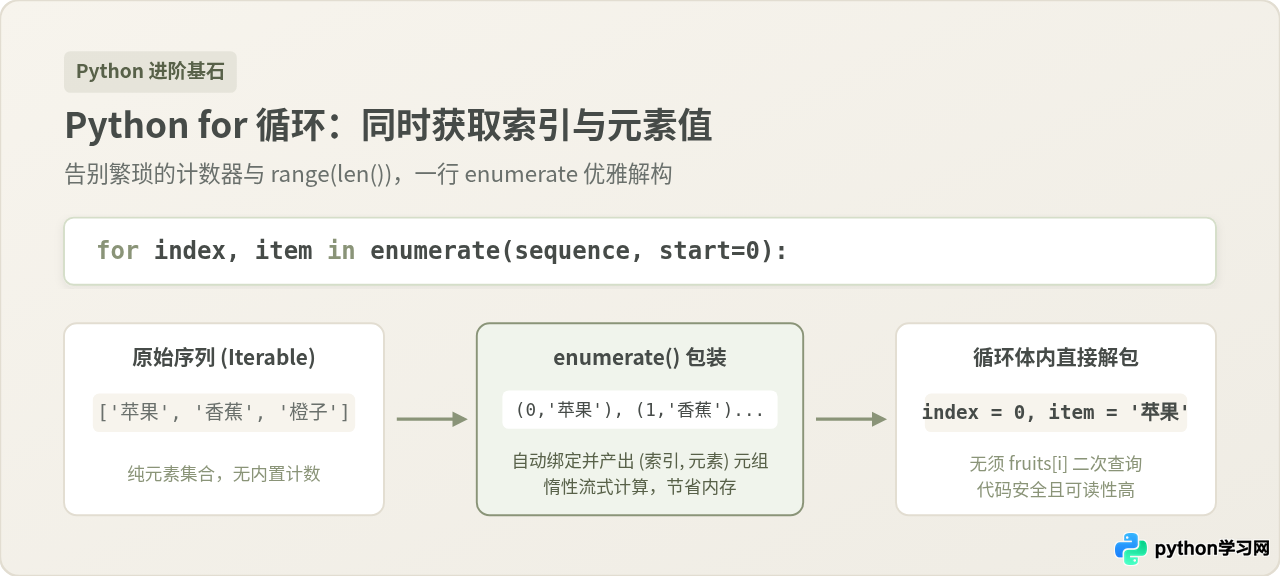
在 Python 的 for 循环中,同时获取当前索引和元素值的标准且推荐的做法是使用内置函数 enumerate()。它能在每次循环迭代时,将当前元素的序号与元素本身自动打包为一个二元元组,开发者可以直接利用 Python 的变量解包特性在一行语句中分别接收索引和数值。这种写法不仅语法紧凑、表达意图明确,而且适用于列表、元组、字符串以及无固定长度的生成器等所有可迭代对象。
一、基础用法与标准代码示例
在实际编码中,直接将需要遍历的对象传入 enumerate(),并在 for 关键字后声明两个变量(通常命名为 index 和 item,或者简写为 i 和 val)即可。
# 示例代码:使用 enumerate 同时获取索引与水果名称
fruits = ['苹果', '香蕉', '橙子']

for index, fruit in enumerate(fruits):
    print(f"序号: {index}, 水果: {fruit}")
序号: 1, 水果: 香蕉
序号: 2, 水果: 橙子
从输出中可以看出,index 变量从 0 开始自动递增,精准对应当前元素在列表中的物理下标,而 fruit 则直接保存了当前轮次对应的元素值。整个过程无需事先查询序列长度,也无需编写任何下标访问代码。
二、工作原理:enumerate 与元组解包
要真正用好这一技巧,需要理解它底层的运行逻辑。当我们将一个列表传入 enumerate() 时,Python 并没有复制原列表,而是创建了一个枚举迭代器对象(enumerate object)。
这个枚举对象内部维护着一个计数状态,每当循环推进一次,它就从原序列中取出下一个元素,并将其与内部计数打包成一个元组 (index, item)。而在 Python 语法中,逗号分隔的两个变量名 index, fruit 会触发元组解包(Tuple Unpacking),元组中的第一个元素赋给 index,第二个元素赋给 fruit。
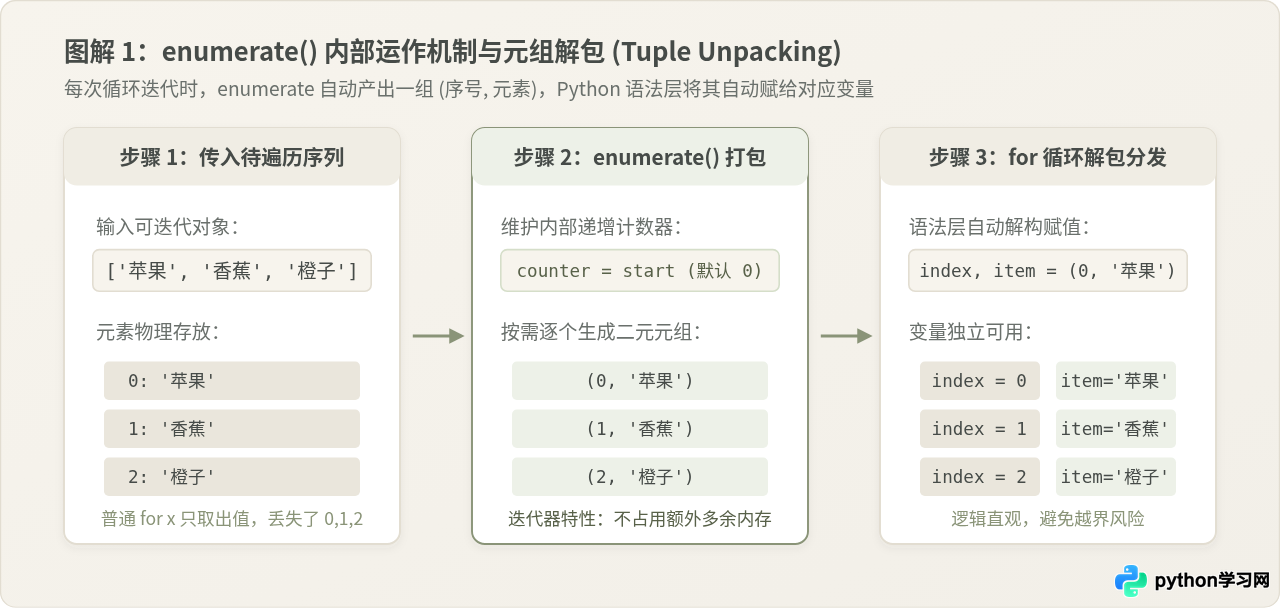
如果只用单个变量接收循环项,例如 for item in enumerate(fruits):,那么每次循环得到的其实就是一个元组,如 (0, '苹果')。显式写成两个变量正是利用了这种解包语法糖,从而让代码兼具优雅与直观。
三、常见写法辨析:range(len(...)) 为什么常见,何时需要修正?
很多刚从 C/C++、Java 或 JavaScript 转到 Python 的开发者,或者初学者,常常习惯写出基于下标遍历的代码:
# 常见写法:利用 range 与 len 计算索引
fruits = ['苹果', '香蕉', '橙子']
for i in range(len(fruits)):
    fruit = fruits[i]
    print(f"索引 {i}: {fruit}")
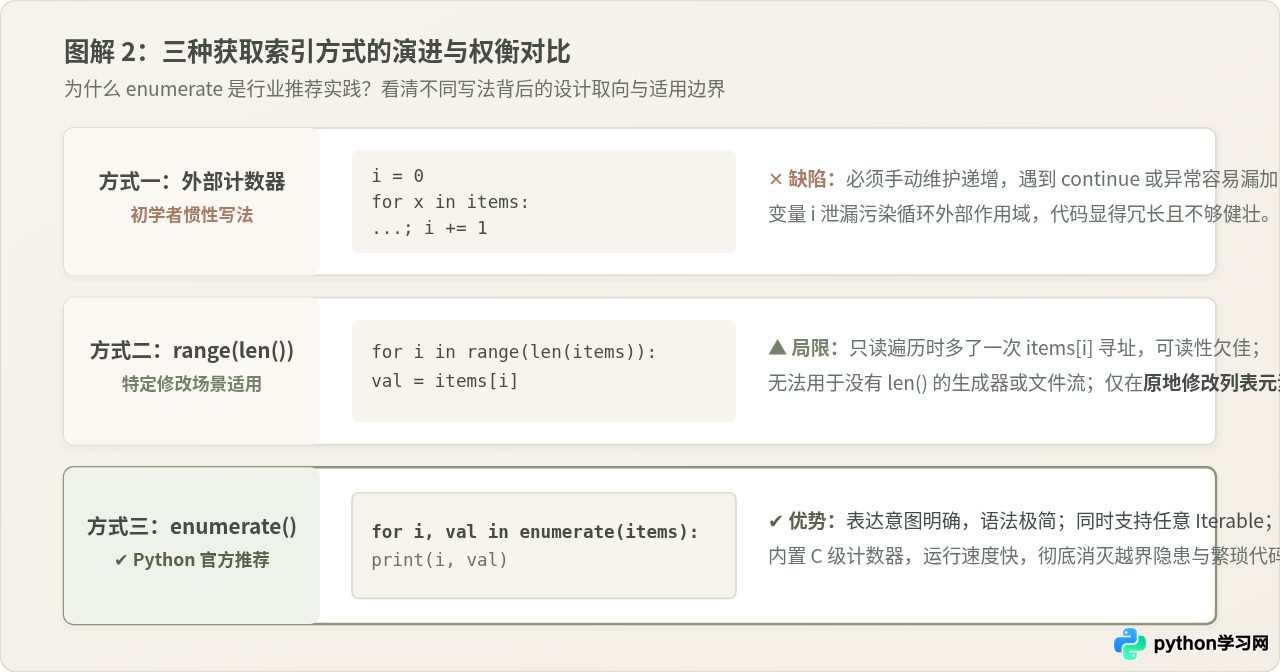
这种写法为什么看似合理且广泛存在?
- 成立条件与合理性:在逻辑上,它通过
len()得到序列长度,再由range()产生0到N-1的数字序列,最后通过fruits[i]回查元素,运行结果完全正确。如果业务场景确实需要就地修改列表内容(例如执行fruits[i] = fruits[i].strip())或者依据步长跳跃访问,基于索引赋值是非常直接的操作。 - 通常场景下的缺陷与修正理由:
- 代码冗长且重复:每一次访问数据都需要显式调用
fruits[i],增加了视觉噪音和键盘输入量。 - 性能与安全性劣势:频繁的下标检索需要额外的边界检查与哈希/偏移量计算。更关键的是,如果循环体内涉及列表增删,极易诱发
IndexError。 - 容器兼容性差:
len()仅对具有确定大小的容器(如list,tuple,dict)有效。如果处理的是生成器(generator)、文件句柄(file stream)或过滤迭代器(filter/map),该写法会直接抛出TypeError: object of type 'generator' has no len()。
- 代码冗长且重复:每一次访问数据都需要显式调用
另外一种“外部维护计数器”(即在循环外定义 count = 0,并在循环体末尾 count += 1)的做法同样存在隐患:一旦循环体内部出现 continue 或发生异常提前跳出,容易漏掉递增语句引发逻辑错误;同时计数变量泄漏在外部作用域中,增加了变量污染风险。因此,在纯粹读取索引和值的场合,应当优先修正为 enumerate()。
四、进阶用法:自定义起始索引 start 参数
在日常业务开发中,我们展示给用户的行号、工单号或排行榜往往需要从 1 开始,而不是计算机常用的 0。很多人会写成 index + 1,但 enumerate() 本身提供了一个更为优雅的参数:start。
# 示例代码:设置起始编号为 1
tasks = ['清理数据', '训练模型', '部署服务']

for rank, task in enumerate(tasks, start=1):
    print(f"步骤 {rank}: {task}")
步骤 2: 训练模型
步骤 3: 部署服务
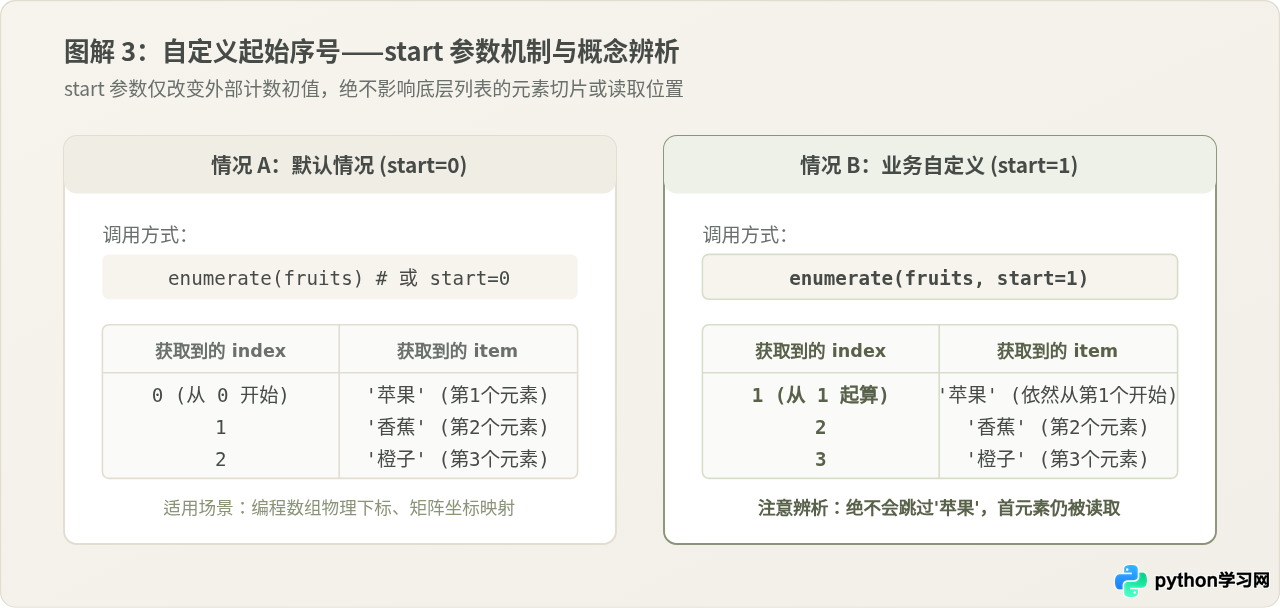
注意辨析:start 参数只改变计数器输出的起始数值,绝对不会跳过任何元素。例如即便设置 start=5,循环首轮拿到的依然是序列中的第一个元素('清理数据'),其对应的序号只是被标记为 5。如果需要跳过前 N 个元素,应当配合切片 enumerate(tasks[1:], start=2) 或 itertools.islice 实现。
五、多序列同步遍历场景:结合 zip() 使用
如果需要在循环中同时遍历两个或多个有关联的列表,并且还需要行号,可以将 enumerate() 与 zip() 嵌套搭配。此时需要注意解包时的括号层级:
# 示例代码:同时遍历姓名和分数,并获取名次索引
names = ['小明', '小红', '小华']
scores = [95, 88, 92]

# 注意: (name, score) 用圆括号括起,对应 zip 产出的元组
for i, (name, score) in enumerate(zip(names, scores), start=1):
    print(f"名次 {i}: 选手 {name},得分 {score}")
名次 2: 选手 小红,得分 88
名次 3: 选手 小华,得分 92
这里的关键细节在于解包结构:enumerate 产生的是形如 (i, (name, score)) 的复合结构,外层解包出序号 i 与复合项,内层的 (name, score) 进一步解包出各项值。如果漏掉了内层圆括号,Python 会抛出 ValueError: too many values to unpack 错误。
六、常见误区与避坑指南
在实际使用中,以下几个容易出错的细节值得特别留意:
- 解包变量数量不匹配:写成
for a, b, c in enumerate(items):会因为enumerate只生成二元组而报ValueError: not enough values to unpack。 - 字典遍历默认只对键枚举:直接对字典使用
enumerate(my_dict)时,获取到的元素值只是字典的 键(Key)。若要同时获取索引、键和值,应写作:for i, (k, v) in enumerate(my_dict.items()): print(f"{i}: {k} -> {v}") - 遍历中增删原列表导致索引错位:无论是使用
enumerate还是range(len()),在遍历过程中直接通过pop()或remove()改变原列表的长度都会造成后续元素索引偏移或漏检。若需过滤列表,建议优先使用列表推导式或倒序遍历。
七、总结与选型指南
综合来看,Python 提供了多种获取循环索引和元素的方法,每种方式都有其明确的设计目的与适用场景:
| 遍历方式 | 典型语法 | 主要优势 | 推荐使用场景 |
|---|---|---|---|
| 直接遍历 | for x in items: |
最简练,性能最好 | 只需要使用元素值,不需要序号 |
| enumerate (首选) | for i, x in enumerate(items): |
安全、优雅、支持所有可迭代对象与自定义起点 | 同时需要索引与元素值的绝大多数只读场景 |
| range(len()) | for i in range(len(items)): |
能拿到原生下标进行写操作 | 需要就地修改原列表元素,或依步长跳跃访问 |
| enumerate + zip | for i, (a, b) in enumerate(zip(x, y)): |
多列表同步解构,同时维护行号 | 关联数据的并排处理与多列输出 |
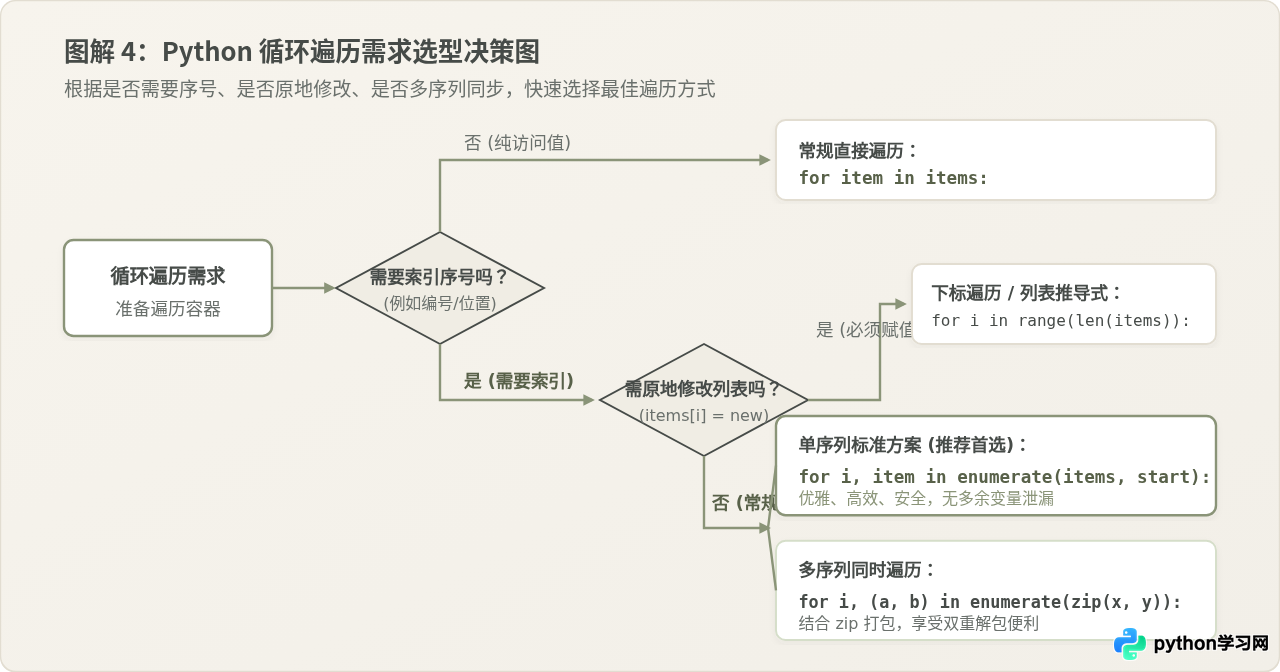
牢记 for index, item in enumerate(iterable): 这一规范写法,不仅能让你的 Python 代码更加地道、简洁,也能有效规避越界和变量泄漏隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















