


企业级Python项目架构:微服务后端与分布式爬虫系统设计
深入解析企业级Python微服务后端与分布式爬虫系统的解耦架构、高并发任务调度、分布式去重、反爬风控治理及数据分层落地方案。
一、系统整体架构设计与分层职责边界
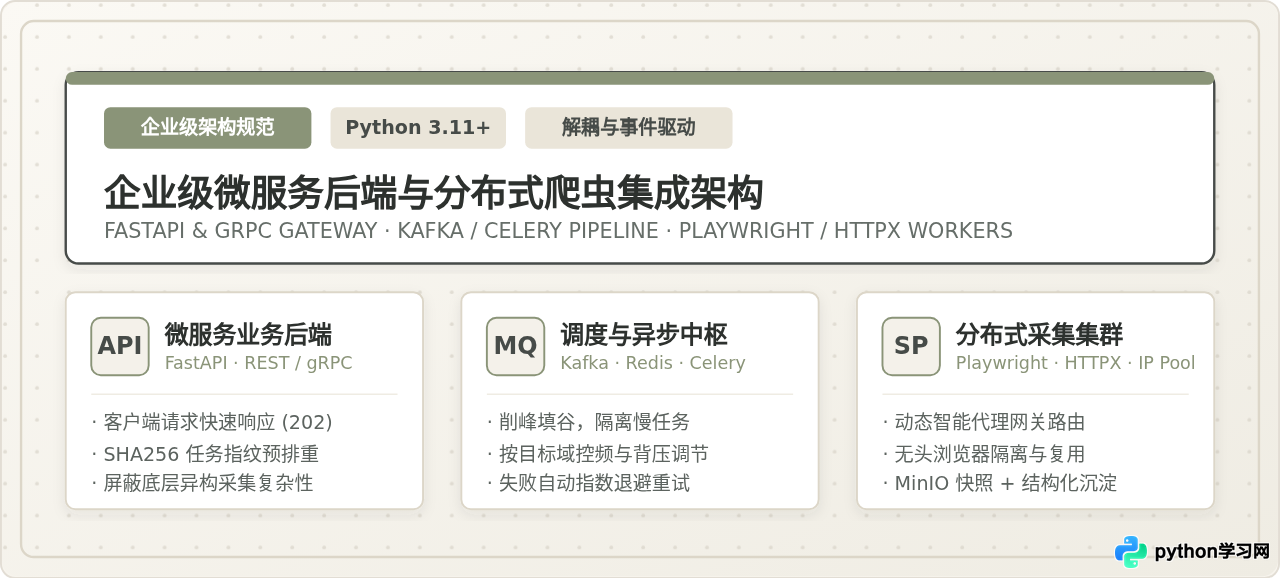
企业级架构的首要原则是“故障隔离与职责单一”。在设计同时包含对外业务与海量网页抓取的系统时,切忌在 FastAPI 或 Django 的请求处理链路中直接发起目标网站抓取。完整的生产架构应当分为五层体系:接入网关层、核心微服务层、异步调度中枢层、分布式采集 Worker 集群,以及多级存储分析层。
在这一架构下,客户端的查询、报表分析以及手动采集请求首先进入 API 网关。网关负责统一鉴权、限流与路由分发。当收到抓取需求时,任务服务(Task Service)仅负责参数校验、生成全局唯一任务凭证与计算哈希指纹,并立即向客户端返回接受回执(202 Accepted)。实际抓取完全交由后端的事件管道驱动,避免上游 HTTP 连接池被下游爬虫的目标站网络延迟所耗尽。
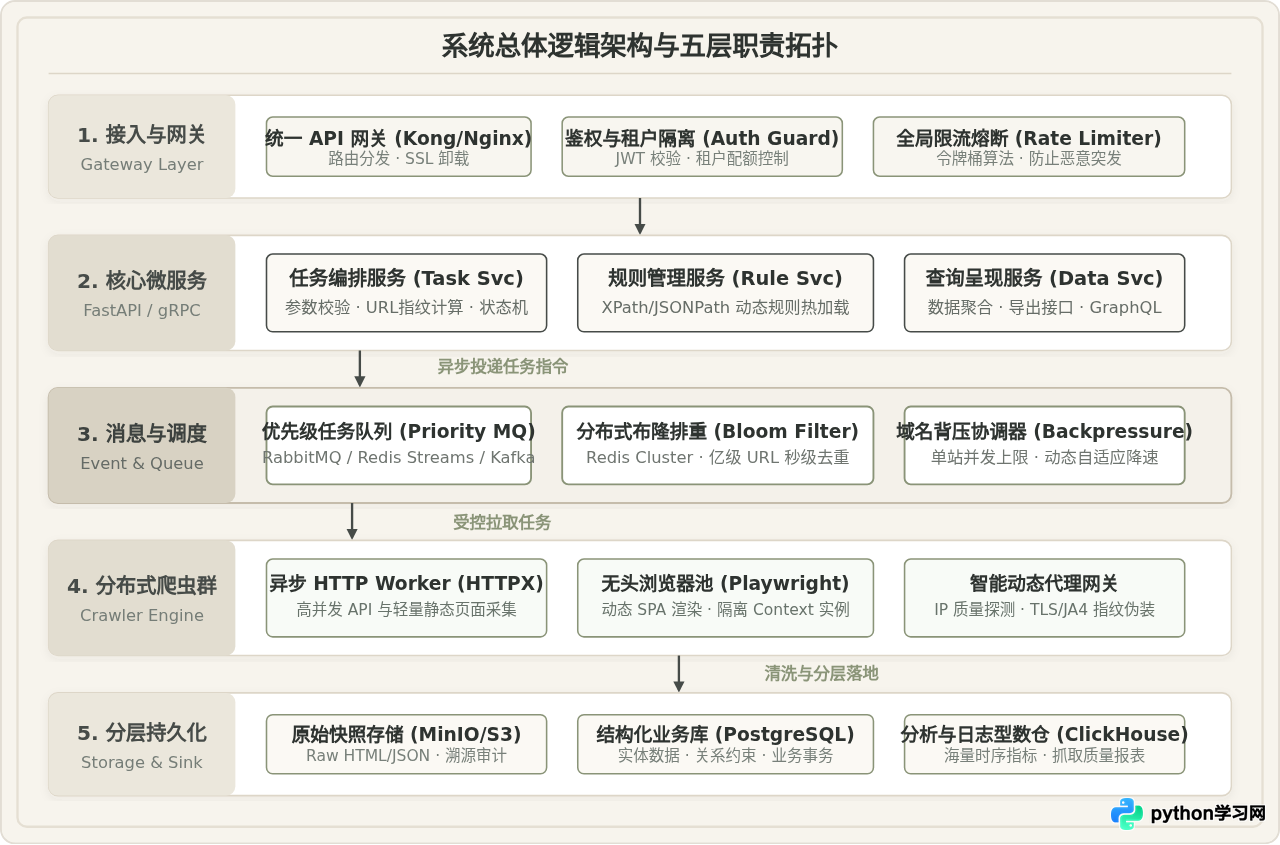
各层级在此架构中的关键职责划分如下:
- 接入与网关层(API Gateway):采用 Kong、Traefik 或 Nginx,统一承载外部流量,施加 JWT 鉴权、IP 白名单及全局令牌桶限流,屏蔽底层微服务拓扑。
- 核心微服务层(FastAPI / gRPC):包含采集配置服务、任务管理服务、元数据管理服务与业务呈现服务。该层无状态设计,支持横向伸缩(Horizontal Pod Autoscaling)。
- 异步事件与调度中枢(Kafka / RabbitMQ / Redis):承接上游派发的抓取指令,维护按业务域划分的主题队列、优先级队列及分布式布隆过滤器去重池。
- 分布式采集引擎层(Crawler Nodes):基于轻量级异步 Worker(HTTPX / aiohttp)与无头浏览器集群(Playwright / Selenium Grid),挂载动态智能代理路由与请求指纹模拟插件。
- 分层存储与数据管道(MinIO / PostgreSQL / ClickHouse):原始 HTML/JSON 快照入 MinIO 对象存储;清洗后的业务实体数据写入 PostgreSQL/MongoDB;行为日志与统计指标流向 ClickHouse。
二、采集任务全生命周期与状态机编排
网络爬虫与常规微服务调用的最大差异在于“高度不确定性”。由于目标站点的宕机、反爬策略升级、动态验证码弹窗或网络抖动,任务具备极高的长尾延迟与失败率。因此,必须将每一次采集动作抽象为带有严格状态机控制的有向流转过程。
一个标准的抓取任务生命周期包含:创建(CREATED)、排重入队(QUEUED)、调度拉取(DISPATCHED)、节点执行(RUNNING)、风控拦截退避(BACKOFF_RETRY)、以及终态(COMPLETED / FAILED / DEAD_LETTER)。全过程通过分布式锁与 CAS(Compare-And-Swap)机制防止状态回溯与重复消费。
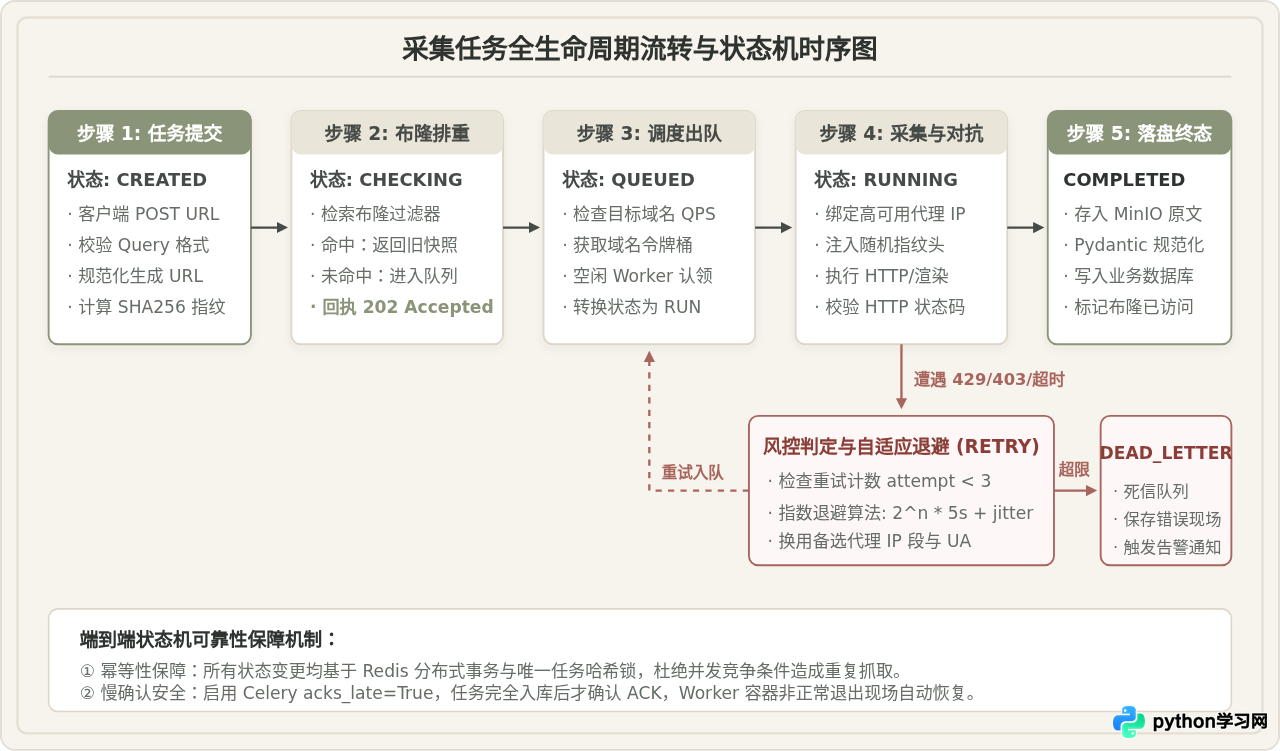
为了确保海量任务流转过程中的系统吞吐,全链路采用了两阶段落盘与异步回执机制:
- 预判去重阶段:利用目标 URL 规范化算法(去除跟踪参数、排序 Query 键值)生成 128 位哈希摘要,在 Redis 布隆过滤器中检索。若已完成抓取且未过有效期,直接返回历史快照索引。
- 资源分配与令牌申请:Worker 节点在真正向外发包前,必须从分布式令牌桶(Redis Token Bucket)申请对应域名(Domain)的请求配额,并由代理中间件附加上下文专用的高可用住宅/机房 IP。
- 自适应重试与死信兜底:遇到 HTTP 429(Too Many Requests)或 403 触发熔断保护,进入递增退避队列(Exponential Backoff)。重试超过上限(例如 5 次)后转入死信队列(DLQ),通知人工审计,杜绝阻塞常规任务通道。
三、关键设计抉择与常见认知辨析
在搭建企业级采集架构时,工程师往往容易陷入几种看似合理但极易在规模扩大后引发灾难的设计误区。清晰厘清这些技术选型的边界,是保证系统平稳演进的前提。
认知辨析一:“分布式爬虫只要多开进程或容器节点,性能就会线性提升”
看似合理的原因:爬虫大部分时间处于网络 I/O 阻塞状态,增加 Worker 数量自然能够发起更多并发连接,在初期往往能观察到单位时间吞吐量的提升。
实际局限与修正:没有全局背压(Backpressure)机制的无序扩容是致命的。一方面,对单一目标域名的过度并发会瞬间触发对方的风控防御(IP 封锁、风控黑洞、假数据注入);另一方面,海量未经控制的响应内容会瞬间打爆爬虫节点自身的带宽与内存。真正的企业级架构要求以“域名维度的令牌桶与动态反馈调节”为核心——当检测到目标域名出现延迟毛刺或 4xx 错误比率上升时,自动压缩该域名的并发通道,将抓取算力动态倾斜到其他健康域名。
认知辨析二:“直接采用 Scrapy-Redis 单库模式就足够,无需引入独立微服务架构”
看似合理的原因:Scrapy-Redis 开发门槛低,内置了 Redis 队列与基础去重,几行配置就能让多个 Scrapy 进程协同工作。
实际局限与修正:Scrapy-Redis 将调度逻辑、去重逻辑与抓取执行深度绑定在单体 Python 框架内,适合单纯的站外数据清洗项目。但在企业级生态中,爬虫系统往往需要对接用户权限、计费扣费、审核流、动态规则配置与跨语言服务交互。如果继续使用 Scrapy-Redis,业务系统将不得不直接操作底层 Redis 的私有数据结构,导致接口破坏与高风险耦合。微服务架构将采集抽象为标准 RPC/HTTP 契约,爬虫引擎退化为纯粹的受控执行计算单元,可以随时用 Go、Rust 或基于 Playwright 的轻量 Worker 无缝替换,而业务层代码无需任何修改。
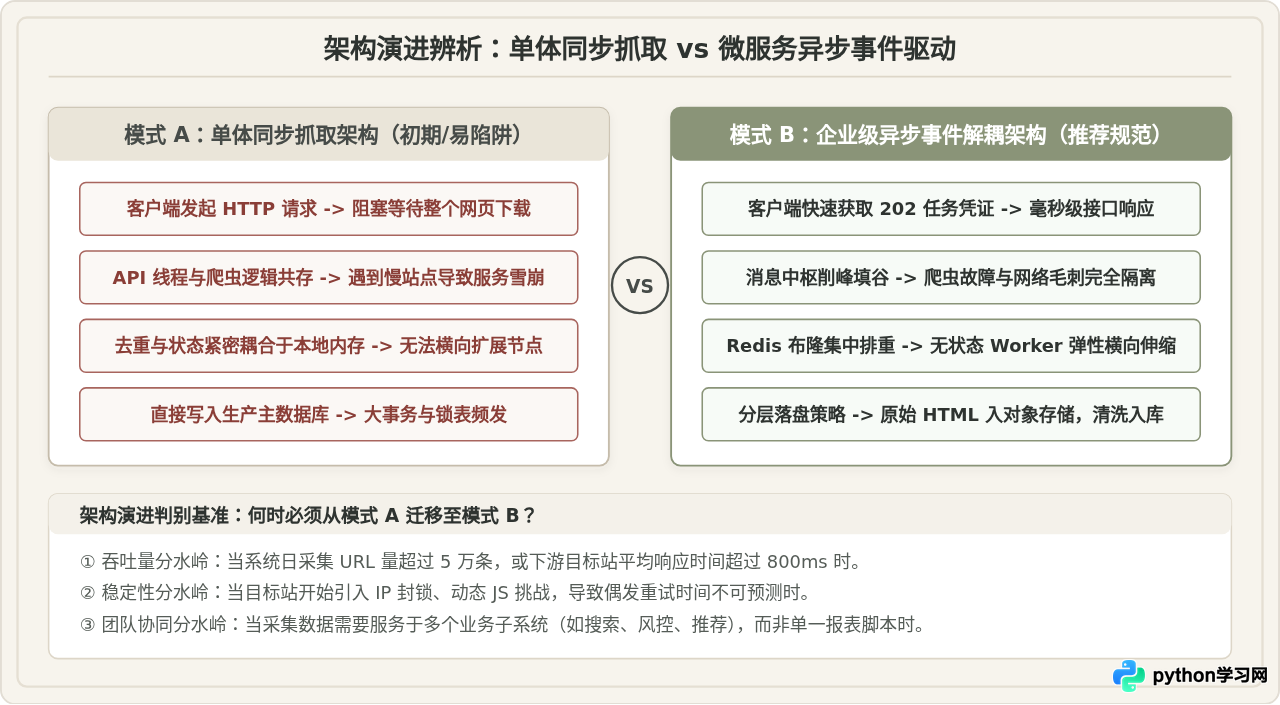
| 架构对比维度 | 传统单体混合架构 | 企业级解耦微服务架构 | 生产落地决策条件 |
|---|---|---|---|
| 服务边界与耦合度 | API 与抓取进程同机共享,依赖强耦合 | 业务 API 与 Crawler 独立演进,契约协议通信 | 团队规模 > 3人,或采集业务需要向多个外部系统赋能 |
| 抗波动与容错隔离 | 目标站慢请求导致业务线程池耗尽,服务雪崩 | 消息队列削峰填谷,单个 Worker 崩溃不影响对外服务 | 目标站网络延迟不稳定、存在复杂反爬措施 |
| 反爬资源共享效率 | 各爬虫实例自建代理池与 Session,资源严重浪费 | 中央代理池服务 + 统一指纹池网关,智能动态路由 | 月度代理 IP 支出较大,需要按业务分账与命中率监控 |
| 存储持久化策略 | 原始数据与解析实体直接写入单一业务数据库 | 原始 HTML 入对象存储,清洗后流向结构化数仓 | 单日新增网页量 > 10万页,需保留原始凭证供规则复算 |
四、核心模块工程实现范例
下面以具体生产代码说明关键服务节点的构建方案:包含基于 FastAPI 的微服务任务投递网关、基于 Redis 的高效指纹去重算法、以及搭载健壮重试与网络超时控制的异步 Celery/HTTPX Worker。
4.1 任务分发服务(FastAPI 生产者契约)
任务入口负责验证输入模式、计算 URL 标准指纹,并通过异步连接池将指令投递至消息代理,整个过程要求响应时间控制在 15ms 以内。
# task_service.py - FastAPI 任务接入服务
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, HttpUrl, Field
import hashlib
import redis.asyncio as aioredis
import json
import uuid
import datetime

app = FastAPI(title="Distributed Crawler Dispatch Service", version="2.0.0")
redis_client = aioredis.from_url("redis://localhost:6379/0", decode_responses=True)

class CrawlRequest(BaseModel):
    url: HttpUrl = Field(..., description="目标网页绝对路径")
    priority: int = Field(default=5, ge=1, le=10, description="任务优先级 1-10")
    render_js: bool = Field(default=False, description="是否启用无头浏览器渲染")
    tenant_id: str = Field(..., description="调用租户标识")

class CrawlTaskResponse(BaseModel):
    task_id: str
    fingerprint: str
    status: str
    created_at: str

def generate_fingerprint(url: str) -> str:
    # 规整化 URL 并计算 SHA256 指纹
    canonical_url = url.strip().lower().split("#")[0]
    return hashlib.sha256(canonical_url.encode("utf-8")).hexdigest()

@app.post("/v1/tasks/crawl", response_model=CrawlTaskResponse, status_code=status.HTTP_202_ACCEPTED)
async def submit_crawl_task(payload: CrawlRequest):
    fp = generate_fingerprint(str(payload.url))

    # 1. 检查布隆过滤器/去重哈希表(以 Redis 集合为例)
    is_duplicate = await redis_client.sismember("crawler:seen_fingerprints", fp)
    if is_duplicate:
        # 命中去重,返回已存在标识或指向已有数据快照
        return CrawlTaskResponse(
            task_id=f"dup_{fp[:12]}",
            fingerprint=fp,
            status="ALREADY_PROCESSED",
            created_at=datetime.datetime.utcnow().isoformat()
        )

    task_id = str(uuid.uuid4())
    task_body = {
        "task_id": task_id,
        "url": str(payload.url),
        "fingerprint": fp,
        "priority": payload.priority,
        "render_js": payload.render_js,
        "tenant_id": payload.tenant_id,
        "attempt": 0
    }

    # 2. 投递到优先级任务队列
    await redis_client.lpush(f"crawler:queue:p{payload.priority}", json.dumps(task_body))
    # 记录任务初始状态元数据
    await redis_client.hset(f"crawler:task:{task_id}", mapping={"status": "QUEUED", "fp": fp})

    return CrawlTaskResponse(
        task_id=task_id,
        fingerprint=fp,
        status="QUEUED",
        created_at=datetime.datetime.utcnow().isoformat()
)4.2 高弹性采集 Worker(Celery + HTTPX 异步连接池)
Worker 节点必须具备完善的容错拦截能力。以下展示集成了动态代理挂载、用户代理(User-Agent)轮换以及针对 429/503 的指数退避重试执行单元。
# crawler_worker.py - Celery 任务消费与采集执行
from celery import Celery
import httpx
import logging
import random
import time

celery_app = Celery("crawler_engine", broker="redis://localhost:6379/1", backend="redis://localhost:6379/2")
celery_app.conf.update(
    task_serializer="json",
    accept_content=["json"],
    result_serializer="json",
    worker_prefetch_multiplier=1, # 严格按照任务优先级拉取,避免单个 Worker 囤积任务
    task_acks_late=True           # 采集完成且落盘后再确认,确保节点崩溃不丢任务
)

logger = logging.getLogger("CrawlerWorker")

USER_AGENTS = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/121.0.0.0 Safari/537.36",
    "Mozilla/5.0 (X11; Linux x86_64; rv:123.0) Gecko/20100101 Firefox/123.0"
]

@celery_app.task(bind=True, max_retries=3, default_retry_delay=5)
def execute_http_crawl(self, task_data: dict):
    url = task_data["url"]
    task_id = task_data["task_id"]
    headers = {
        "User-Agent": random.choice(USER_AGENTS),
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
    }

    # 模拟从动态代理服务获取代理节点(实际生产应调用代理网关服务)
    proxies = "http://gate.proxy-pool.internal:8080"

    try:
        with httpx.Client(proxies=proxies, timeout=10.0, follow_redirects=True) as client:
            response = client.get(url, headers=headers)

            # 检测风控与流控响应
            if response.status_code in (429, 503):
                # 计算指数退避时间: 5s, 10s, 20s + 抖动
                backoff = (2 ** self.request.retries) * 5 + random.uniform(0.5, 2.0)
                logger.warning(f"触发目标站限流状态码 {response.status_code},进入退避重试: {backoff:.2f}s")
                raise self.retry(countdown=int(backoff))

            response.raise_for_status()
            raw_html = response.text

            # 存入对象存储并触发清洗事件通知(此处以提取元数据为例)
            doc_meta = {
                "task_id": task_id,
                "url": url,
                "status_code": response.status_code,
                "content_length": len(raw_html),
                "timestamp": int(time.time())
            }
            logger.info(f"任务 {task_id} 采集成功,页面字节数: {len(raw_html)}")
            return doc_meta

    except (httpx.ConnectTimeout, httpx.ReadTimeout, httpx.NetworkError) as err:
        logger.error(f"网络异常: {err},正在尝试重试")
        raise self.retry(exc=err)
    except Exception as exc:
        if self.request.retries >= self.max_retries:
            logger.critical(f"任务 {task_id} 达到最大重试次数,转入死信队列")
            # 投递至 DLQ 逻辑
raise exc五、反爬风控治理、资源管控与全链路高可用
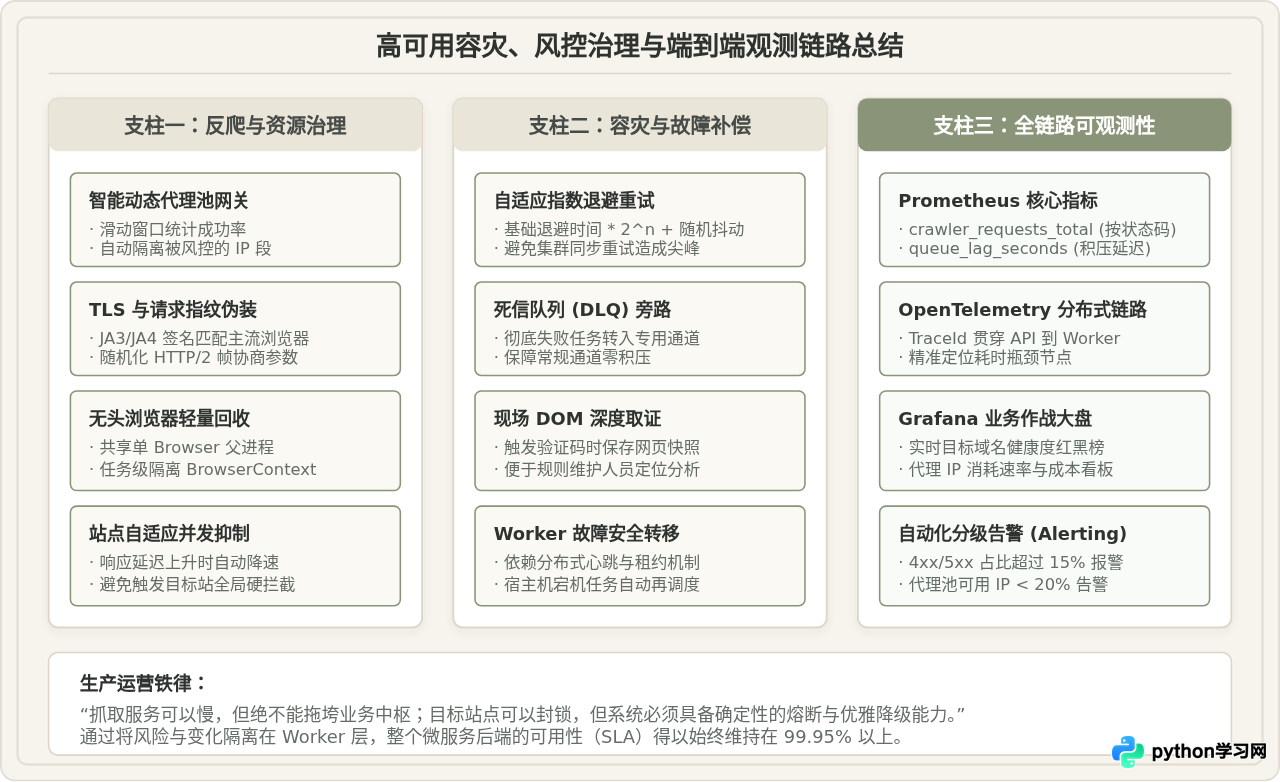
分布式爬虫系统在线上稳定运行的最大阻碍是反爬虫对抗。现代网站普遍部署了 Web 应用防火墙(WAF)、TLS 指纹探测与行为模式识别系统。单纯依靠更换 IP 无法解决复杂站点的稳定采集问题,必须从协议栈、渲染引擎及运维观测三位一体推进防御治理。
在生产运维治理中,需要重点落实以下四套防护措施:
- Headless 浏览器池的生命周期隔离:使用 Playwright 或 Puppeteer 进行动态页面渲染时,浏览器进程极易发生内存膨胀与僵死。必须采取“每个 BrowserContext 只执行单次任务”的轻量隔离模式,且单个 Chrome 父进程每处理 50~100 个页面后强制回收重启,杜绝内存雪崩。
- 动态代理质量评分与自适应熔断:代理调度器以滑动窗口统计各代理节点的拨测成功率。若某个 IP 段在 30 秒内连续出现 3 次验证码拦截,自动将其标记为“风控冷却态”,隔离 15 分钟后再行探测,避免浪费抓取配额。
- 死信队列(DLQ)与人机协同旁路:无法自动攻破的滑块验证码或严重反爬拦截,系统自动截取当前 DOM 树与上下文快照,推入人工复核队列。人工标注后的特征规则反哺至爬虫解析引擎,形成自动化闭环。
- 全链路指标埋点(OpenTelemetry + Prometheus):核心监控大盘必须覆盖关键指标:按域名维度的成功率、平均 HTTP 耗时、代理池可用率、任务排队延迟以及死信增长速率。
六、系统部署拓扑与生产演进路线
在将该架构落地到真实生产集群时,建议遵循循序渐进的容器化演进路径:
- 第一阶段(开发与初创期):采用单台高性能宿主机配合 Docker Compose,将 FastAPI 后端、Redis(去重与小队列)、Celery Worker 以及 MinIO 部署在同一 Docker 内部网桥中。该阶段核心在于固化契约协议与数据清洗标准,无需过早引入复杂的 Kafka 集群。
- 第二阶段(业务爆发期):将后端业务服务与爬虫 Worker 完全拆离到不同的 Kubernetes 节点池(Node Pool)。爬虫 Worker 节点使用专用的网络出口(NAT 网关或第三方住宅代理通道),并配置基于队列积压长度(KEDA 自动扩缩容)的 HPA 策略。
- 第三阶段(企业级多租户成熟期):引入统一 API 网关进行租户配额控制,底层调度中枢升级为 Kafka 事件总线,分析层接入 ClickHouse 与 Iceberg 数据湖,形成支持离线重放、实时分析与敏捷反爬规则热更新的企业级数据中台基座。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















