


pandas3.0.1相比3.0.0修复了哪些问题?
详细解析pandas 3.0.1相比3.0.0修复的核心问题,涵盖ExtensionArray.item()缺失、PyArrow RE2正则转义、旧版HDF5时间戳兼容、Copy-on-Write边界扩展、GroupBy分类变量空值以及pd.col一元运算符等关键修复与升级指南。
核心结论:pandas 3.0.1 是紧随 3.0.0 重大里程碑版本之后发布的首个敏捷维护补丁(于 2026 年 2 月发布)。它本身不引入任何破坏性 API 变更,而是集中修复了 3.0.0 在全量启用“默认字符串扩展类型(ExtensionArray / PyArrow)”和“写时复制机制(Copy-on-Write)”后暴露的一批回归问题(Regressions),重点解决了 ExtensionArray.item() 缺失导致的标量提取崩溃、PyArrow 正则 RE2 语法受阻、旧版 HDF5 时间戳解析兼容、分组统计在分类空值下的边缘异常,以及 pd.col() 语法在一元取反操作时的语法支持。
一、核心修复全景:为什么 3.0.0 之后急需 3.0.1?
pandas 3.0.0 是该项目历史上重构幅度最大的版本之一,其底层做出了两项根本性改造:第一,废除了历史遗留的 NumPy object 存储字符串的做法,默认推断为专用的 str dtype(底层由 PyArrow 或 StringArray 驱动);第二,全面强制开启写时复制(Copy-on-Write, 简称 CoW),废弃了长期存在的 SettingWithCopyWarning。这两项改动大幅提升了吞吐效率与内存安全性,但由于生态内第三方库与业务存量代码对底层 NumPy 对象的深度依赖,新版本的架构调整在某些特定调用链路中触发了非预期的回归故障。
pandas 3.0.1 的定位正是“消除架构跃迁带来的边角断点”。它在严格保持 3.0.0 核心演进方向不变的前提下,迅速恢复了与下游生态和既有文件格式的兼容性。
二、默认字符串类型(ExtensionArray)与 PyArrow 相关的回归修复
在 3.0.0 之前,字符串 Series 的底层存储形态为 NumPy 的一维 ndarray。3.0.0 将其改为继承自 ExtensionArray 的字符串专用数组。这一结构转变引出了以下关键回归:
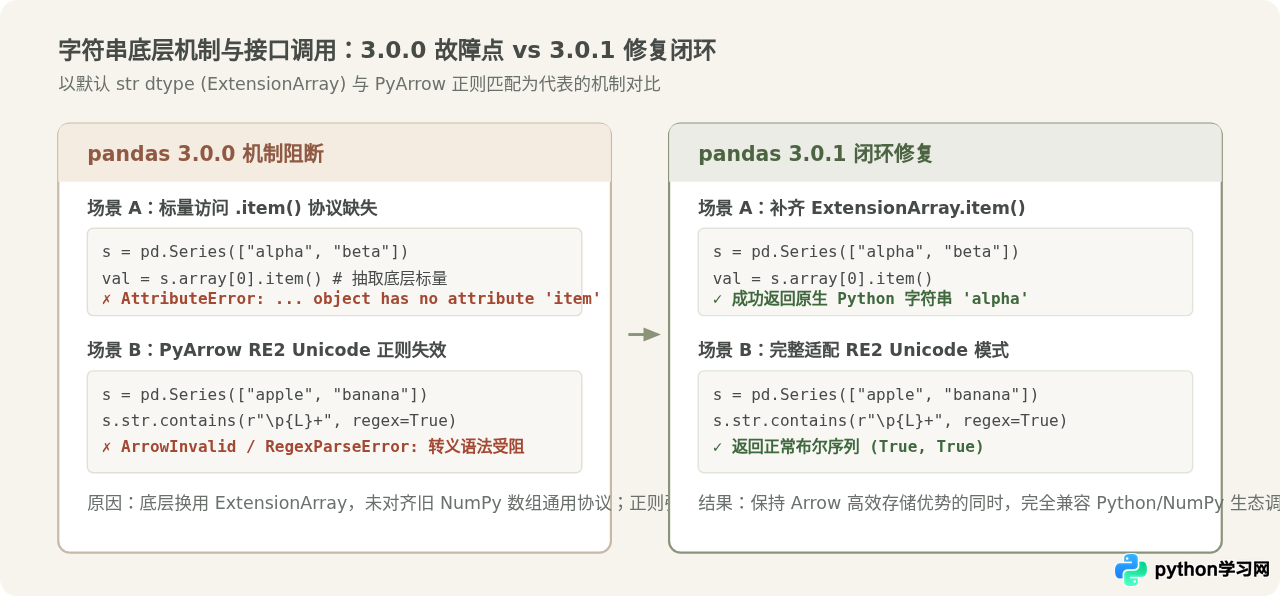
1. 补齐 ExtensionArray.item() 标量提取协议
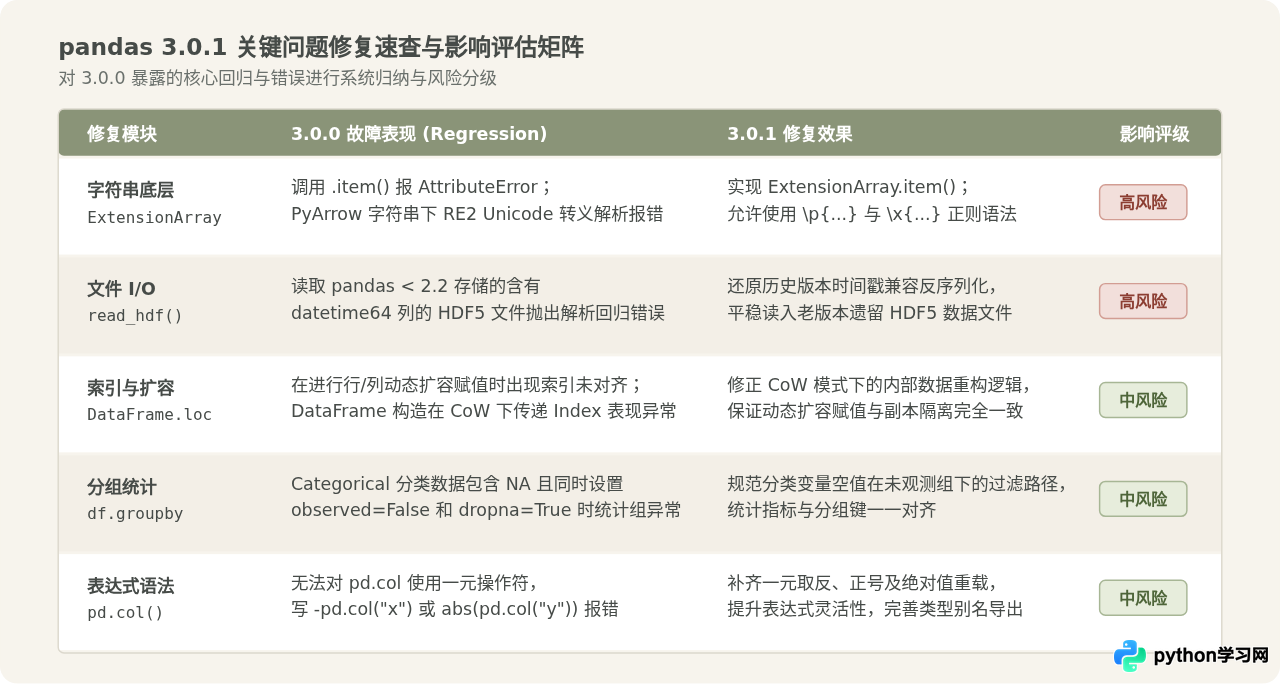
NumPy 数组原生具备 .item() 方法,用于从长度为 1 的数组中提取纯 Python 标量类型。许多通用数据转换库和算法在处理单元格数据时,会直接调用 series.array.item() 或 series.values.item()。在 3.0.0 中,由于字符串 ExtensionArray 未实现该方法,代码会直接抛出 AttributeError。
3.0.1 修复措施:在 pandas.api.extensions.ExtensionArray 基类中正式实现了 item() 方法,确保与 NumPy 标量协议完全对齐:
# 示例:从单值字符串序列的底层数组抽取标量
import pandas as pd

s = pd.Series(["alpha"])

# 在 pandas 3.0.0 中执行:
# s.array.item()  -> 抛出 AttributeError: 'ArrowStringArray' object has no attribute 'item'

# 在 pandas 3.0.1 中执行:正常返回 Python 原生 str
val = s.array.item()
print(f"提取结果: {val}, 类型: {type(val)}")
# 示例输出:提取结果: alpha, 类型: <class 'str'>
2. PyArrow 正则支持 RE2 Unicode 转义语法
当安装了 PyArrow 时,3.0.0 默认采用 PyArrow 引擎驱动字符串矢量运算。但 PyArrow 底层的正则表达式依赖 Google RE2 引擎,在 3.0.0 下,当用户在 Series.str.contains() 或 Series.str.replace() 中传入 Unicode 类别转义符(如 \p{L} 匹配字母)或 16 进制字符转义符(如 \x{...})时,未能正确通过中间解析层,造成匹配异常。
3.0.1 修正了 RE2 模式字符串的桥接传递,使得现代 Unicode 正则表达式在 PyArrow 驱动的 Series 上可以按预期正常执行。
3. numpy.random.permutation 与 Arrow 字符串兼容
在数据清洗与打乱阶段,使用 np.random.permutation(df['str_col']) 是一种常见写法。3.0.0 中该操作在处理 PyArrow 支撑的字符串列时会导致底层缓冲区拷贝异常。3.0.1 修复了内部切片与内存视图协议,恢复了对 NumPy 打乱函数的支持。
三、写时复制(Copy-on-Write)边缘缺陷与索引扩展修复
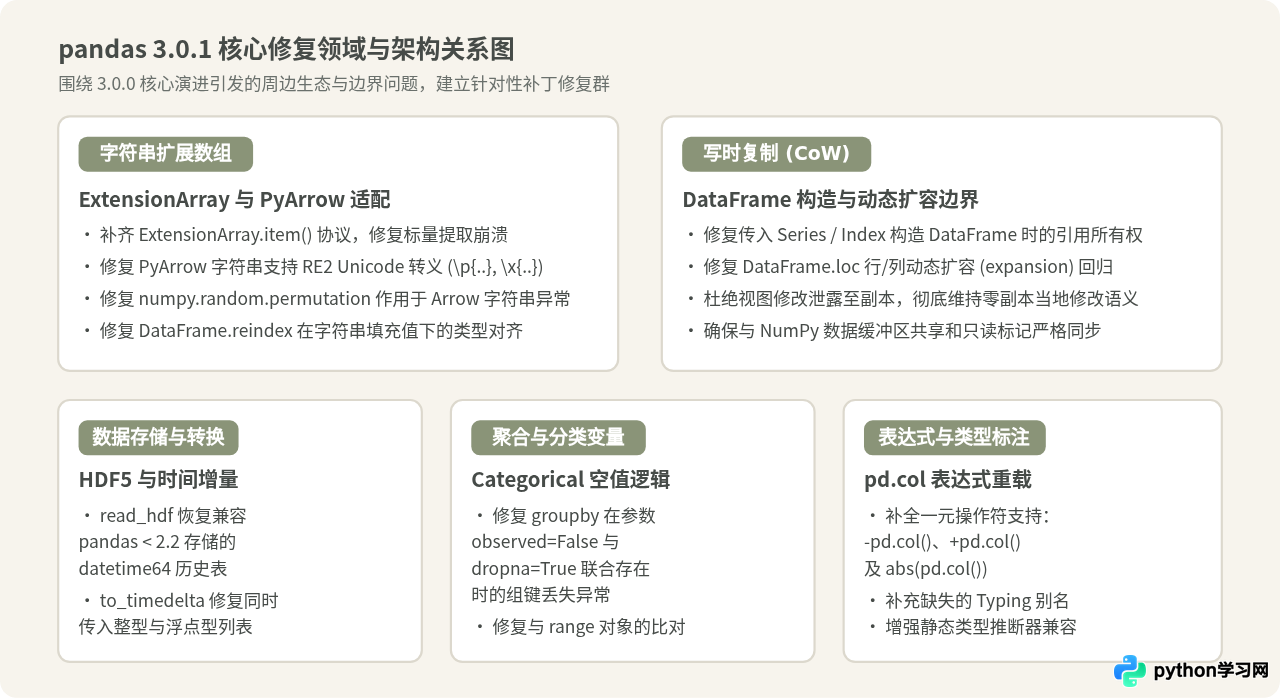
3.0.0 全面推行 CoW 后,对所有索引切片操作默认不生成浅拷贝引用,防止意外原地覆写。但在构造函数和动态写入等极限边界场景中,3.0.0 存在少量未处理完整的 corner cases:
1. DataFrame 构造函数处理 Series / Index 入参
当通过已有的 Series 或 Index 实例构造新的 DataFrame(例如 pd.DataFrame({'col': existing_series}))时,3.0.0 的 CoW 引用计数器在特定嵌套组合下未能及时剥离旧对象写权限,可能引起后续修改时的不一致。3.0.1 明确了构造函数内部的所有权转移规则,确保引用安全。
2. DataFrame.loc 动态扩容(Row/Column Expansion)
在数据分析中,常使用 df.loc['new_row', :] = values 或 df.loc[:, 'new_col'] = values 为数据帧动态新增行列。3.0.0 在结合 CoW 与混合数据类型扩容时,偶尔出现行索引未正确定位或填充值为 NaN 的回归现象。3.0.1 重构了扩容时的底层数据块重构逻辑,修复了此问题。
3. reindex 搭配字符串填充值(fill_value)
当对 DataFrame 执行 .reindex(..., fill_value="missing") 时,若目标轴存在新增标签,3.0.0 因推断新列类型与默认字符串类型的相互转换而抛出类型对齐警告或异常。3.0.1 规范了字符串填充值在重建索引时的自动类型提升机制。
四、历史数据存储兼容与时间序列转换修复
工程落地中往往有大量历史数据需要持久化读取,3.0.1 在文件 I/O 领域重点修复了一处影响极广的向后兼容断点:
1. read_hdf() 读取旧版 datetime64 数据崩溃
pandas 3.0 调整了时间戳的默认解析精度策略(不再强制一律转换为纳秒 ns,更加宽容支持微秒 us 与毫秒 ms)。然而,这一调整导致 pd.read_hdf() 在读取由 pandas 2.2 之前版本 写入的含有 datetime64 类型的 HDF5 表格时发生反序列化回归错误,阻碍了存量数据资产的迁移。
3.0.1 针对 HDFStore 的元数据读取逻辑打上了补丁,能够准确向下识别旧版时间戳存储头,平滑恢复旧版文件的读入功能。
2. to_timedelta() 混合列表解析
当调用 pd.to_timedelta([1, 2.5], unit='s') 向其传递同时混合了整型(int)与浮点型(float)的 Python 列表时,3.0.0 会发生类型推断歧义报错。3.0.1 统一了混合数值序列的时间增量单位换算逻辑。
五、分组聚合(GroupBy)与分类变量(Categorical)空值处理
在使用分类类型(CategoricalDtype)进行分组统计时,参数 observed=False 表示保留尚未在数据中出现的所有可能类别组合,而 dropna=True 表示剔除分组键本身的缺失值(NA)。
在 3.0.0 中,当数据集中确实存在缺失值,且这两个参数同时指定时,分组引擎在构建分组键索引的笛卡尔积过程中发生了键丢失与聚合统计行错位的问题。3.0.1 彻底修缮了分类变量在空值过滤与未观测分组组合之间的处理时序,确保聚合报表数据与预期完全一致。
# 示例:分类变量包含空值的多维分组聚合
import pandas as pd

cat_type = pd.CategoricalDtype(categories=["A", "B", "C"])
df = pd.DataFrame({
    "group": pd.Series(["A", "B", None], dtype=cat_type),
    "val": [10, 20, 30]
})

# 在 3.0.1 中正确输出:包含未观测到的类别 C,且剔除 None 分组
result = df.groupby("group", observed=False, dropna=True)["val"].sum()
print(result)
# 示例输出:
# group
# A    10
# B    20
# C     0
# Name: val, dtype: int64
六、新表达式语法 pd.col() 的一元操作符与静态类型补充
pandas 3.0.0 引入了类似于 Polars 和 PySpark 风格的 pd.col() 语法,允许在 .assign() 或筛选中摆脱繁琐的 lambda x: x['a'] 匿名函数写法:
# 3.0.0 支持的二元运算:
df.assign(total=pd.col("price") * pd.col("qty"))
但在 3.0.0 的初版实现中,遗漏了一元操作符(Unary Operators)的魔术方法重载,导致以下常见代码抛出 TypeError:
- 一元取负:
df.assign(loss=-pd.col("profit"))—— 3.0.0 报错; - 绝对值运算:
df.assign(deviation=abs(pd.col("error")))—— 3.0.0 报错。
3.0.1 补全了 __neg__、__pos__ 和 __abs__ 等一元运算符的重载。同时,3.0.1 补充了此前缺失的类型标注别名(Typing Aliases),改善了 VS Code (Pylance) 和 PyCharm 在使用 ExtensionArray 时的代码补全与静态检查准确性。
七、认知辨析:常见误区与升级评估
观点:“3.0.1 修了这么多底层字符串和 CoW 问题,是不是说明 3.0 版本的架构变更太激进、还不稳定,现阶段应该退回 2.x?”
分析与纠正:这个观点在直觉上容易让人产生共鸣,但结论并不准确。3.0.0 引入的 Copy-on-Write 和 Arrow 字符串默认化,是 pandas 社区经过数个小版本(2.1、2.2、2.3)充分验证后的必然演进。3.0.1 暴露出的问题绝大多数是下游存量代码调用了某些非公开或边界协议(如内部直接调 .item()、旧版本特有二进制 HDF5 头)。
3.0.1 并没有回退任何架构设计,反而将这些原本未规范的边界协议正式标准化。因此,正确的做法不是退回 2.x,而是跳过 3.0.0,直接将基线设定为 3.0.1 或更高补丁版本。
八、操作指南:升级至 3.0.1 的推荐步骤
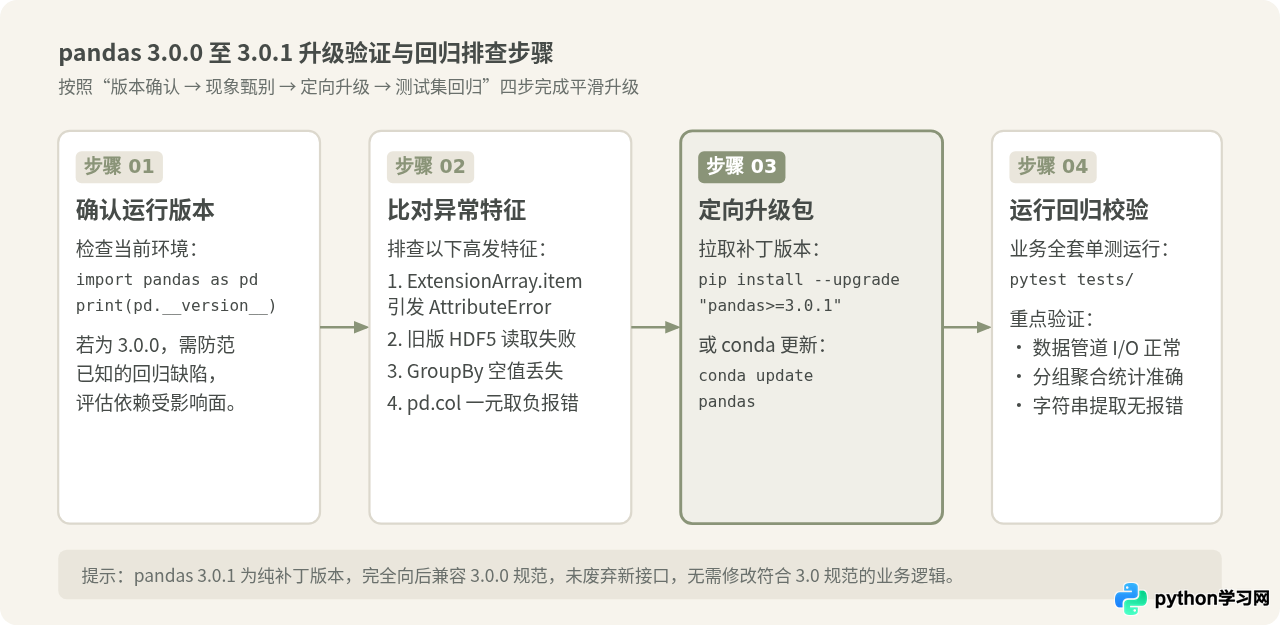
为了保障生产环境和现有数据分析项目的平稳运行,推荐按照以下流程完成升级与回归验证:
1. 升级命令与依赖更新
在你的虚拟环境或容器镜像中,执行以下升级命令:
# 使用 pip 进行更新
pip install --upgrade "pandas>=3.0.1"

# 若使用 conda / mamba 环境
conda update -c conda-forge pandas
2. 确认版本与生效验证
更新完成后,在 Python 控制台确认当前已加载的版本号:
import pandas as pd
print("当前 pandas 版本:", pd.__version__)
# 预期输出: 当前 pandas 版本: 3.0.1

# 快速冒烟测试:验证 ExtensionArray 标量访问与一元表达式
test_series = pd.Series(["valid_check"])
assert test_series.array.item() == "valid_check"

df_test = pd.DataFrame({"a": [1, -2, 3]})
df_res = df_test.assign(neg=-pd.col("a"), absolute=abs(pd.col("a")))
assert list(df_res["neg"]) == [-1, 2, -3]
print("3.0.1 核心修复冒烟验证通过!")
3. 升级注意事项
- 若项目高度依赖 HDF5 存储:升级到 3.0.1 后,可立即测试旧版
.h5文件读取流程,此前在 3.0.0 遇到的时间列解析报错将自动消失。 - 不需要重写符合 3.0 的代码:3.0.1 为纯补丁版本,API 层面完全向后兼容 3.0.0,无需因升级而调整任何业务逻辑代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















