


Python列表基础操作:创建、增删改查与常用方法
系统讲解Python列表的核心概念与常用操作,包括列表创建、正负索引与切片访问、元素增删改查机制,以及sort、sorted、reverse等常用方法的关键差异对比与避坑指南。
Python 列表(list)是一种基础且使用频率极高的数据结构,它通过按顺序保存对象的引用,实现了有序存储与动态扩容。掌握列表的初始化、双向索引检索、切片截取、元素增删改机制,以及各类常用方法的底层逻辑,是编写高效、健壮 Python 代码的前提。
一、认识与创建 Python 列表
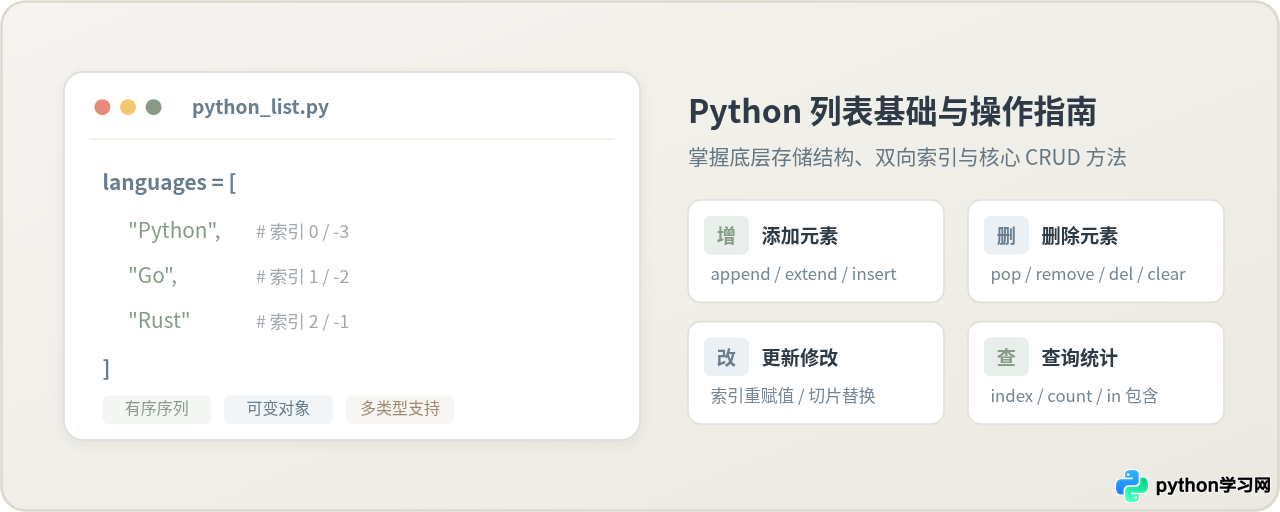
在 Python 中,列表是一种有序、可变(Mutable)的序列类型。与数组不同的是,Python 列表内部保存的是指向各对象的指针引用,因此它允许在同一个列表中混合存放任意类型的对象,如整数、浮点数、字符串、字典乃至另一个列表。
创建列表最直观、高效的方式是使用方括号 [] 字面量;若需要将元组、字符串、区间等其他可迭代对象转化为列表,则可以使用内置的 list() 函数。
# 1. 直接通过字面量创建空列表与多类型列表
empty_list = []
numbers = [10, 20, 30, 40, 50]
mixed_list = ["Python", 3.12, True, [1, 2]]

# 2. 通过内置函数 list() 将其他可迭代对象转换为列表
chars = list("HELLO")
seq_list = list(range(1, 6))

# 3. 通过列表推导式快速生成带规则的数据
squares = [x ** 2 for x in range(5)]seq_list: [1, 2, 3, 4, 5]
squares: [0, 1, 4, 9, 16]
使用 [0] * 5 快速初始化一维列表非常便捷。但如果初始化嵌套列表,如 [[0] * 3] * 3,外层列表存储的实际上是同一个内部子列表的 3 次引用副本。修改其中任意一行的某一列,其他行也会发生连锁变动。正确方式应使用列表推导式:[[0] * 3 for _ in range(3)]。
二、查询与访问:正负索引与切片规则
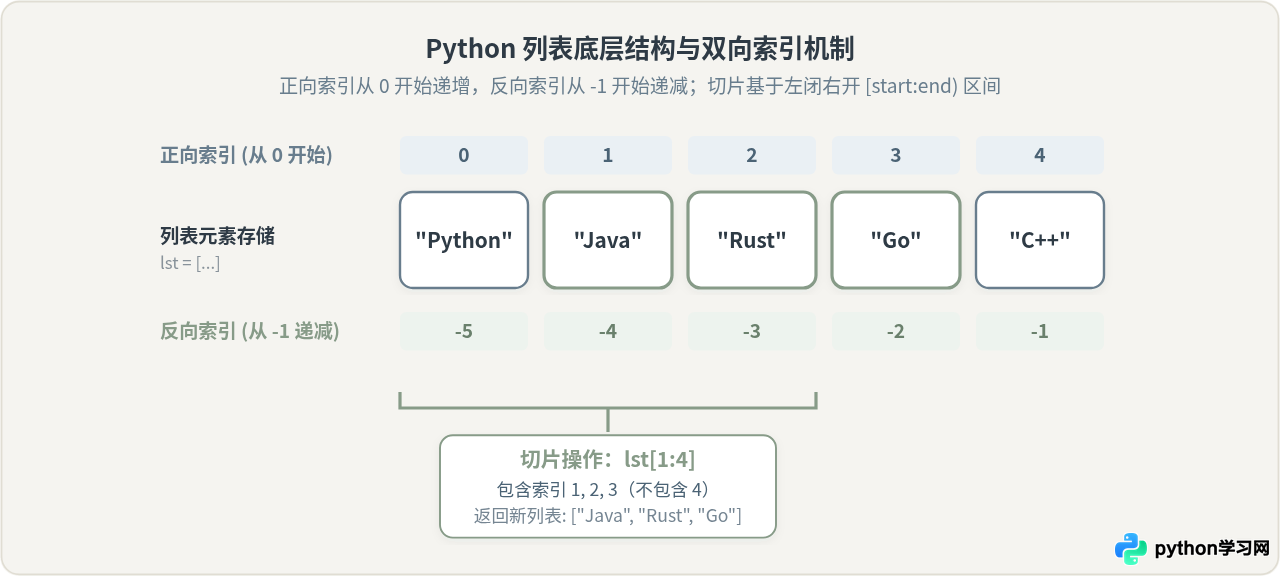
列表中的每个元素都有确定的物理次序。Python 提供了双向索引机制:正向索引从 0 开始,自左向右递增;反向索引从 -1 开始,自右向左递减(-1 代表末尾最后一个元素)。
1. 单个元素的索引访问
通过 lst[index] 即可直接读取目标元素。当指定的索引超出当前列表范围(例如长度为 5 时访问索引 5 或 -6)时,Python 会抛出 IndexError: list index out of range 异常。
fruits = ["苹果", "香蕉", "橙子", "葡萄", "西瓜"]

print(fruits[0])    # 正向首位
print(fruits[-1])   # 反向末位
print(fruits[-2]) # 倒数第二位西瓜
葡萄
2. 切片访问:获取子列表
切片语法采用 lst[start:end:step] 的形式。其中 start 为起始位置,end 为结束位置(遵循左闭右开原则,包含 start 但不包含 end),step 为步长。与单个索引访问不同,切片在越界时具有极强的容错能力,不会抛出异常,而是安全截取有效范围。
numbers = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

print(numbers[2:6])     # 获取索引 2 到 5 的元素
print(numbers[:4])      # 省略起始,默认从 0 开始
print(numbers[7:])      # 省略结束,默认截取到末尾
print(numbers[::2])     # 步长为 2,隔项提取
print(numbers[::-1]) # 步长为 -1,快速反转列表副本[0, 1, 2, 3]
[7, 8, 9]
[0, 2, 4, 6, 8]
[9, 8, 7, 6, 5, 4, 3, 2, 1, 0]
3. 检索值与频次统计
若需要确认某个元素是否存在或查找其所在索引,可以使用以下方法:
in/not in:成员运算符,判断某元素是否存在于列表中,返回布尔值。lst.index(value, [start, end]):返回指定值首次出现的正向索引。若元素不存在,则抛出ValueError。lst.count(value):统计指定值在列表中出现的总次数;若不存在则返回0。
三、添加元素:append、extend 与 insert 的操作差异
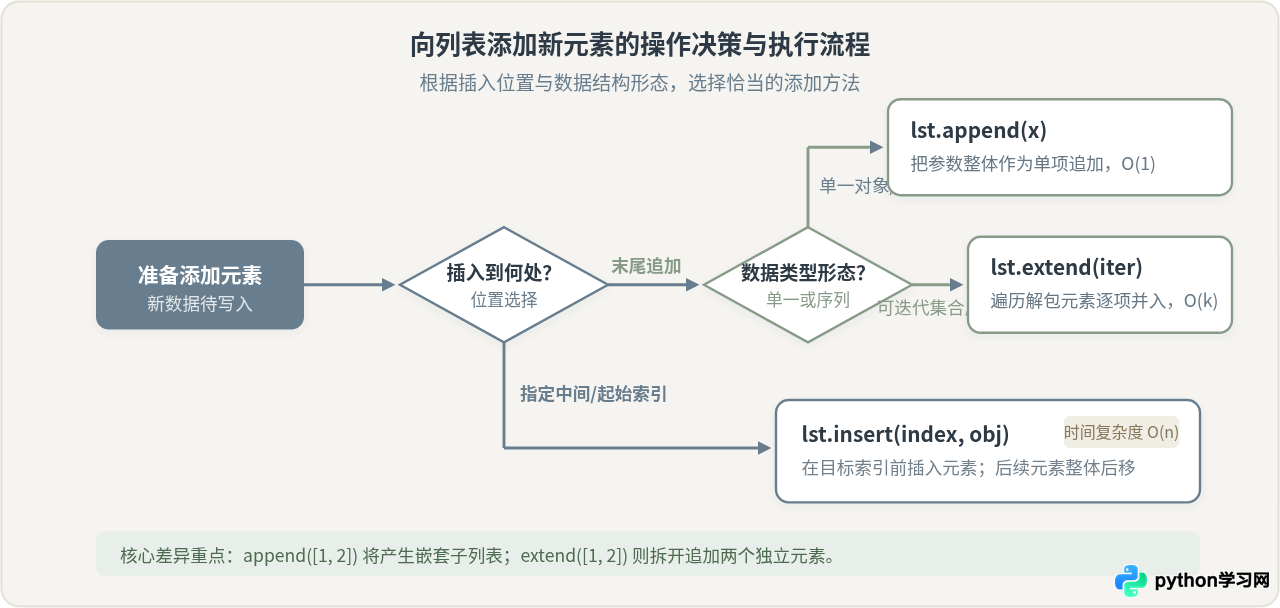
Python 列表支持动态扩容,主要提供了 append()、extend() 和 insert() 三种方法向列表写入新元素。选择哪种方法取决于待写入的数据结构以及目标位置。
关键差异解析:append() 与 extend() 的本质对比
在向列表末尾添加元素时,初学者极易混淆 append() 与 extend():
1. 处理机制差异:append(obj) 将传入的参数整体作为一个单独的元素追加到末尾。哪怕传入的是一个包含多个项的列表或元组,它也只作为一项子列表被收纳。而 extend(iterable) 会遍历传入的可迭代对象,将其内部的每一个元素逐一取出并追加到原列表末尾。
2. 对列表长度的影响:调用一次 append(),原列表的长度 len(lst) 必定严格增加 1;而调用一次 extend(iterable),原列表的长度增加值等于该迭代器所含元素的个数 len(iterable)。
# 对照实验:相同初始列表与相同的追加参数 [100, 200]
list_a = [1, 2, 3]
list_b = [1, 2, 3]

list_a.append([100, 200])
list_b.extend([100, 200])

print("append 结果:", list_a, "长度:", len(list_a))
print("extend 结果:", list_b, "长度:", len(list_b))

# insert 在指定索引处插入
list_b.insert(1, "插入项")
print("insert(1) 结果:", list_b)extend 结果: [1, 2, 3, 100, 200] 长度: 5
insert(1) 结果: [1, '插入项', 2, 3, 100, 200]
append() 在列表末尾追加元素的分摊时间复杂度为 O(1),效率极高。而 insert(0, x) 在列表头部或中间插入元素时,由于需要将目标位置之后的所有元素在连续内存中整体向右挪动一位,时间复杂度为 O(n)。在处理高频首部入队操作时,更建议使用 collections.deque 双端队列。
四、修改与更新元素
列表是可变对象,可以直接通过索引或切片对指定位置的元素进行重新赋值与更新。
1. 单索引直接赋值
利用赋值语句 lst[index] = new_value 即可直接替换旧值。注意索引必须已存在,不能通过 lst[len(lst)] = x 的方式新增元素(必须使用 append)。
2. 切片批量替换与伸缩
利用切片赋值 lst[start:end] = iterable 可以一次性替换连续区间内的多个元素。传入的新序列长度无需与被替换切片的长度一致,列表会根据新元素的数量自动收缩或扩容。
scores = [85, 90, 78, 92, 60]

# 单项修改
scores[2] = 88

# 切片批量修改:将索引 3 到 4(即 92 和 60)替换为三个新分数
scores[3:5] = [95, 98, 100]
print("更新后的分数列表:", scores)

# 清空某段区间(切片替换为空列表)
scores[1:3] = []
print("删除区间后的列表:", scores)删除区间后的列表: [85, 95, 98, 100]
五、删除元素:remove、pop、del 与 clear 的机制差异
Python 提供了四种移除列表中数据的途径,它们在定位方式、返回值以及错误处理上各具特点。
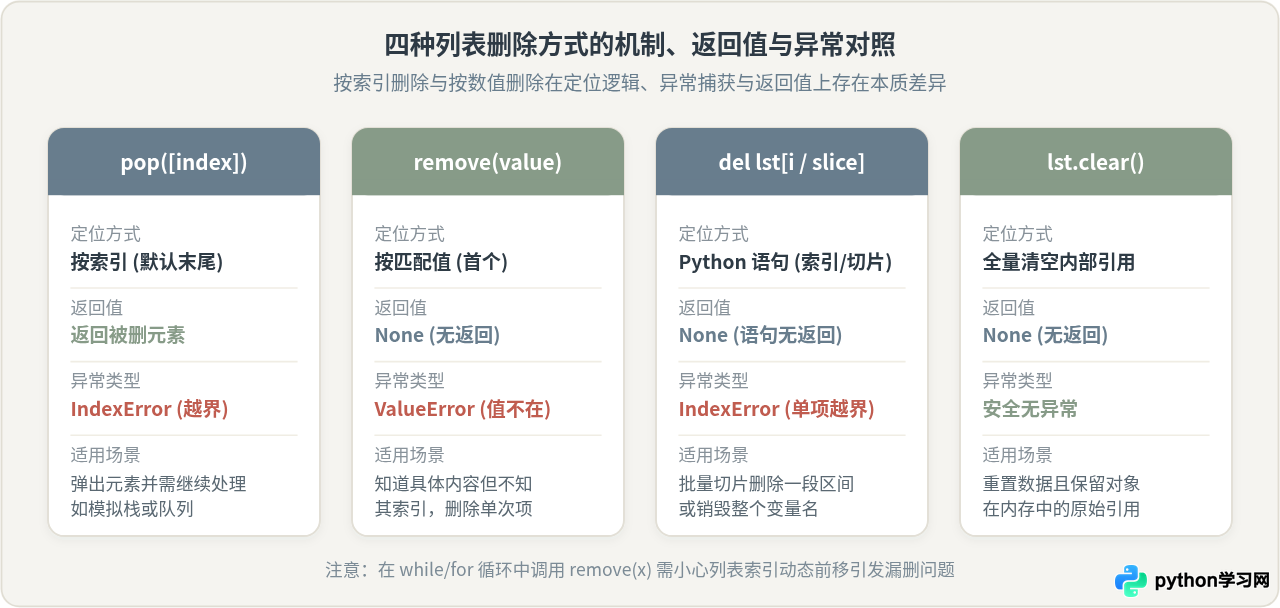
| 方法 / 语句 | 定位依据 | 返回值 | 异常类型 | 核心适用场景 |
|---|---|---|---|---|
lst.pop([index]) |
位置索引(默认末尾 -1) |
返回被删除的元素对象 | IndexError |
弹出元素并需要继续使用该值(如模拟栈或队列) |
lst.remove(value) |
按值匹配(仅删首个命中项) | 无(返回 None) |
ValueError |
已知要剔除的具体内容,且无需知道其所在索引 |
del lst[i / slice] |
位置索引或切片区间 | 无(语句无返回值) | IndexError(单索引越界) |
批量区间删除、按索引快速释放或清理变量 |
lst.clear() |
清空全部元素 | 无(返回 None) |
无异常 | 保留当前列表对象的内存地址/引用,快速重置为空 |
items = ["apple", "banana", "cherry", "banana", "durian"]

# 1. pop() 弹出末尾元素并接收
last_item = items.pop()
print("pop() 弹出项:", last_item, "当前列表:", items)

# 2. remove() 按值删除首个 "banana"
items.remove("banana")
print("remove('banana') 后:", items)

# 3. del 语句按索引删除
del items[0]
print("del items[0] 后:", items)

# 4. clear() 原地清空
items.clear()
print("clear() 后结果:", items)remove('banana') 后: ['apple', 'cherry', 'banana']
del items[0] 后: ['cherry', 'banana']
clear() 后结果: []
在遍历列表时直接调用 lst.remove() 会导致迭代器的内部指针错位,从而跳过紧邻的下一个元素。正确的过滤方式应采用列表推导式生成新列表:filtered_list = [x for x in lst if x != target],或倒序遍历索引删除。
六、常用内置方法与操作技巧
除了增删改查的基础动作外,在日常开发中经常需要对列表进行排序、翻转和复制。深入理解它们对原始数据的影响尤为关键。
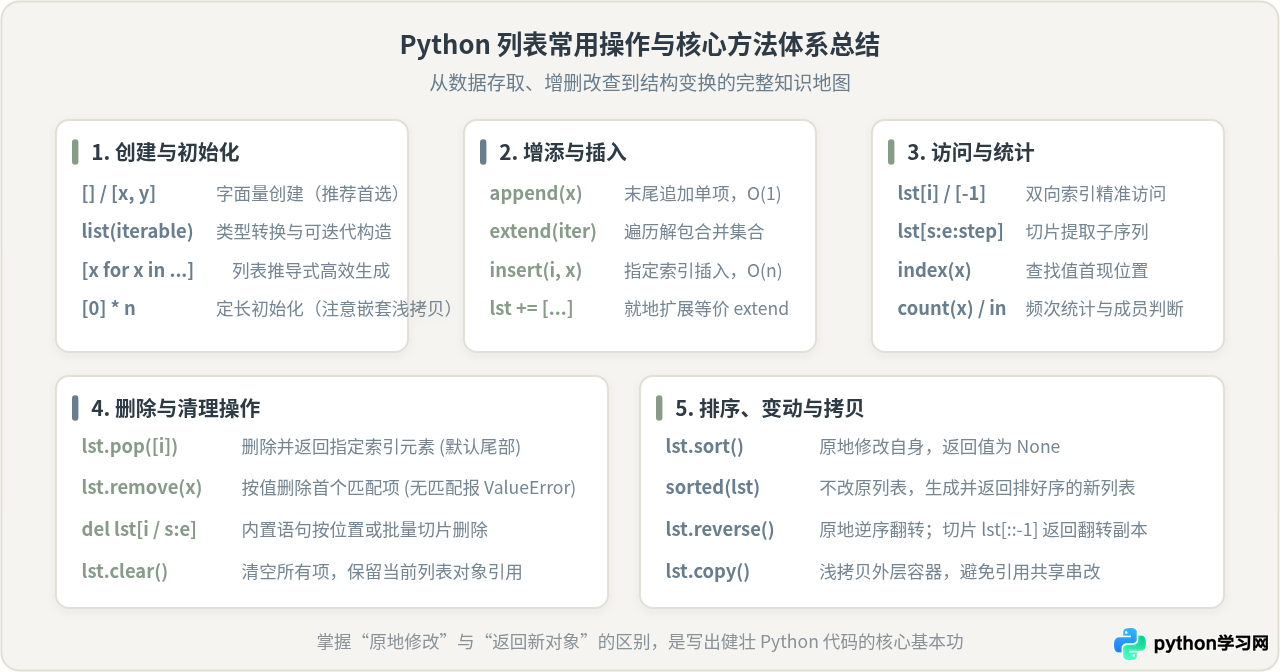
关键差异解析:sort() 原地排序 与 sorted() 内置函数
在对数据进行升序或降序排列时,Python 提供了列表专属方法 lst.sort() 和通用内置函数 sorted(iterable)。它们在设计目标和副作用上有着明确边界:
- 原地修改与返回值:
lst.sort()是列表的专属方法,它会直接修改原列表内部的排列顺序,其方法返回值为None。如果写出res = lst.sort(),则res将得到None,这是初学者非常常见的赋值失误。 - 生成新副本:
sorted(lst)是 Python 核心内置函数,它完全不改动原始列表,而是将原数据复制并在排序后返回全新的列表对象。原列表保持原本的顺序不变。 - 适用对象范围:
sort()仅可作用于 list 对象;而sorted()可以接受元组、字典键、生成器等任意可迭代对象,并统一返回一个排好序的 list。
raw_data = [42, 12, 88, 5, 23]

# 做法 A:使用 sorted(),保留原始数据完整性
sorted_copy = sorted(raw_data, reverse=True)
print("sorted() 返回的新列表 (降序):", sorted_copy)
print("原 raw_data 未被改变:", raw_data)

# 做法 B:使用 lst.sort(),原地修改以节省内存
raw_data.sort()
print("调用 raw_data.sort() 后的自身结果:", raw_data)

# 配合 key 参数按自定义规则排序(例如按字符串长度排序)
words = ["Python", "C", "JavaScript", "Go", "Rust"]
words.sort(key=len)
print("按长度排序后:", words)原 raw_data 未被改变: [42, 12, 88, 5, 23]
调用 raw_data.sort() 后的自身结果: [5, 12, 23, 42, 88]
按长度排序后: ['C', 'Go', 'Rust', 'Python', 'JavaScript']
反转与浅拷贝操作
类似地,lst.reverse() 会就地翻转原列表中的元素排列(返回 None);若要保留原列表并获得翻转副本,推荐使用切片 lst[::-1]。
在赋值列表时,直接使用 b = a 仅为变量名绑定同一个列表对象的引用,修改 b 会连带影响 a。若需要相互独立的副本,应使用 b = a.copy() 或 b = a[:] 执行浅拷贝(对于嵌套对象则需使用 copy.deepcopy())。
七、总结与最佳实践准则
Python 列表作为动态连续内存序列,在快速索引查询和末尾增删场景下表现极其出色。在实际开发中,保持以下实践准则能有效规避大多数逻辑隐患:
- 首选字面量创建:优先使用
[]代替list(),运行速度略快且符合 Pythonic 风格。 - 区分追加语义:追加单个值使用
append();合并多个序列项使用extend()或切片拼接,避免意外制造深层嵌套。 - 区分按值与按位删除:已知位置用
pop()(带返回值)或del;已知内容用remove(),并提前用in检查或配合try-except ValueError预防报错。 - 警惕就地修改方法:时刻牢记
sort()、reverse()、extend()、clear()均返回None,不可将其直接连缀或赋予新变量。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















