


Python字符串处理语法:格式化、切片与常用方法
全面解析Python字符串的核心处理语法,包括双向索引与切片规则、三代字符串格式化方法演进、高频内置清洗判断函数,以及性能调优与工程最佳实践。
在 Python 编程中,文本数据的清洗、分析与展示是最基本且高频的操作。Python 将字符串实现为不可变(immutable)的字符序列,这意味着对字符串的任何修改都会生成新对象,而不会改变原对象。掌握字符串切片的索引推导、三代格式化语法的演进规律以及高频内置方法的选型边界,是写出优雅、高效 Python 代码的基础。
一、字符串切片语法与双向索引机制
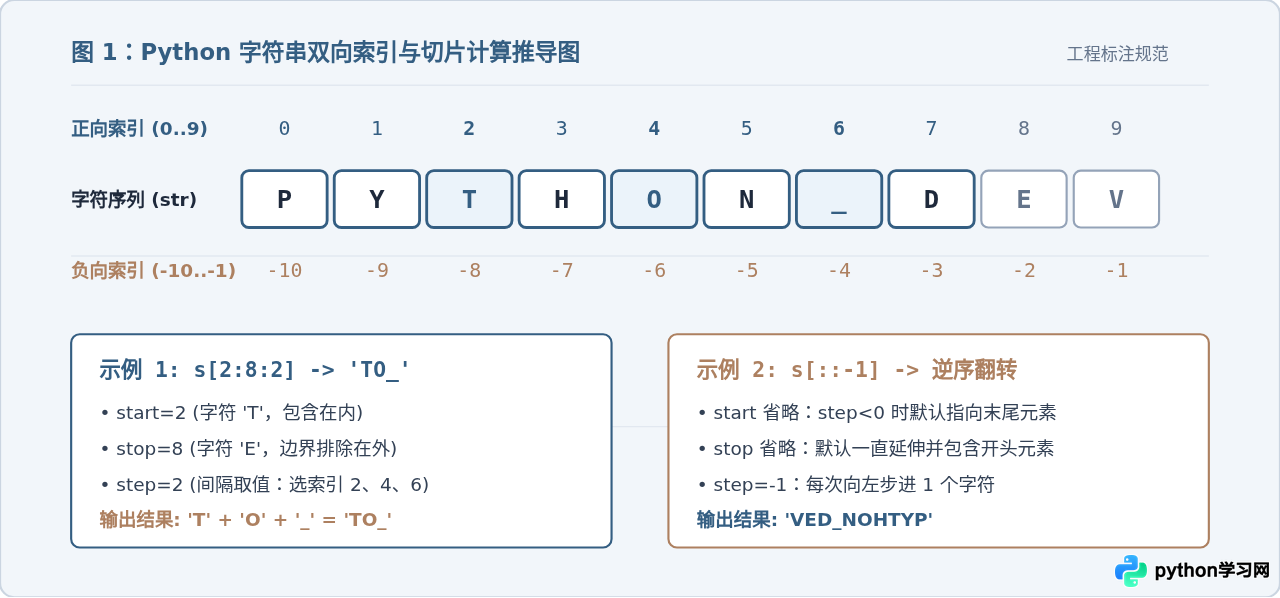
Python 字符串属于有序序列,每个字符对应唯一的位置编号。为了兼顾从前往后与从后往前的访问需求,Python 设计了正向与负向两套对称的索引系统。
1. 正负索引机制
正向索引从字符串首字符开始,序号为 0,向右依次递增至 len(s) - 1;负向索引则从最后一个字符开始,序号为 -1,向左依次递减至 -len(s)。若通过单下标访问越界位置,解释器会立即抛出 IndexError 异常。
2. 切片完整语法规则
切片操作通过下标中括号配合冒号完成,通用形式为:
sequence[start:stop:step]- start(起始索引):切片开始提取的位置。包含该位置的字符(左闭)。
- stop(终止索引):切片结束提取的边界。不包含该位置的字符(右开)。
- step(步长与方向):提取的间隔数。正数表示从左向右提取,负数表示从右向左逆向提取。默认值为
1。
3. 常见切片模式与边界安全特性
切片在处理空缺参数和超出范围的索引时,表现出极强的宽容度。与单个索引越界直接报错不同,切片在越界时会自动截断至有效边界,而不会中断程序执行。
text = "Python"

# 1. 提取前缀与后缀
prefix = text[:2]    # 等价于 text[0:2],结果: 'Py'
suffix = text[-2:]   # 从倒数第2个到末尾,结果: 'on'

# 2. 复制与隔位提取
copy_text = text[:]  # 浅拷贝完整序列,结果: 'Python'
evens = text[::2]    # 步长为2采样,结果: 'Pto'

# 3. 越界安全机制测试
safe_sub = text[2:100]  # 终止索引虽超过长度,但静默截断为到末尾
print(safe_sub)         # 输出: 'thon'

empty_sub = text[10:20] # 起始索引完全越界,返回空字符串而不报错
print(repr(empty_sub)) # 输出: ''step 为负数时,提取方向强制变为由右向左,此时 start 的物理位置必须在 stop 的右侧(即 start > stop)。例如 text[1:5:-1] 会产生空字符串 '',因为从索引 1 向左走永远无法到达索引 5。
二、三代字符串格式化方法演进与对比
在程序运行中,将数值、变量或对象动态组装成可读文本是开发的核心环节。Python 语言历经多次大版本迭代,共推出了三套主流的格式化方式。
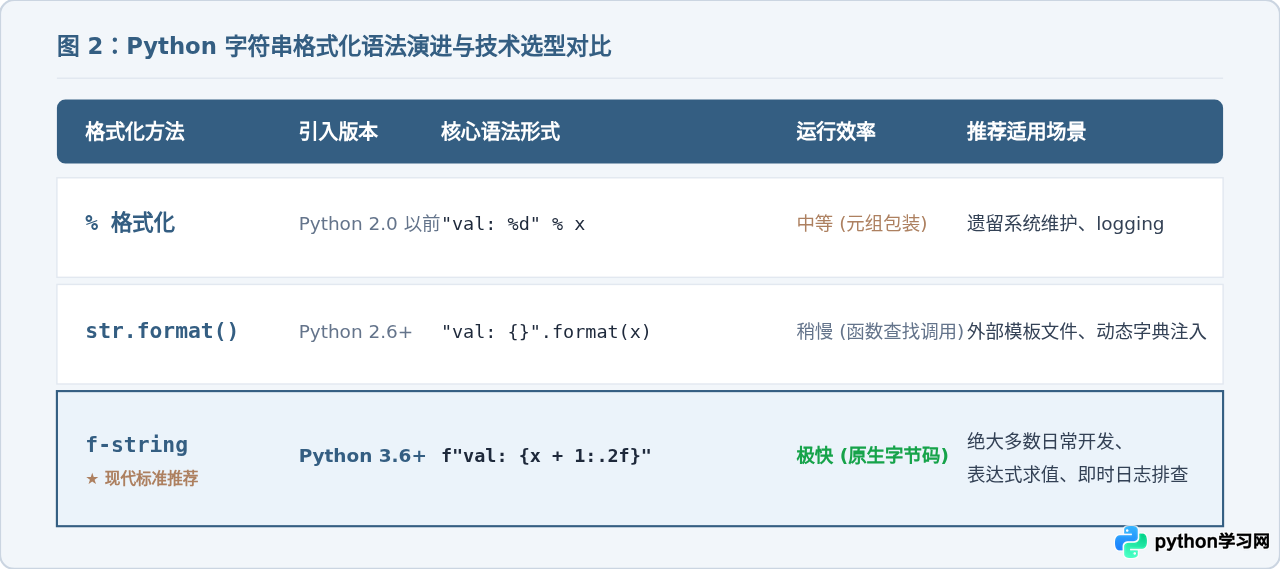
1. 第一代:% 操作符(printf 风格)
继承自 C 语言的 printf 语法,使用 %s、%d、%f 等占位符:
name = "Alice"
score = 95.5
msg = "学员: %s, 得分: %.1f" % (name, score)
这种写法在参数较少时直观,但当参数较多时必须严格按元组传参,容易因类型不匹配或参数数量错位引发异常,目前主要用于维护旧代码或配合 logging 模块的延迟插值。
2. 第二代:str.format() 方法(Python 2.6+)
引入了基于大括号 {} 的占位符,支持位置参数、关键字参数以及对象属性访问:
template = "学员: {name}, 得分: {score:.1f}"
msg = template.format(name="Alice", score=95.5)
format() 的核心优势在于可以将格式化模板提取为独立变量或配置文件,在运行时动态传入不同字典或参数,非常适合动态组装外部模板。
3. 第三代:f-string 格式化字符串字面量(Python 3.6+)
以字母 f 或 F 开头的字符串字面量。在运行时由 Python 解释器在语法解析层面直接编译为高效的字节码,不仅语法最为紧凑,而且执行效率远超前两代方法。
4. 深度应用:f-string 常用高级语法规范
f-string 支持在大括号内嵌入任意合法的 Python 表达式,并支持丰富的格式控制符(Format Specifier):
import math

# 1. 浮点精度与千分位分隔符
pi_val = math.pi
print(f"PI保留三位小数: {pi_val:.3f}")        # 输出: PI保留三位小数: 3.142

large_num = 1234567890
print(f"千分位展示: {large_num:,}")          # 输出: 千分位展示: 1,234,567,890

# 2. 百分比格式化
ratio = 0.856
print(f"达标率: {ratio:.1%}")                # 输出: 达标率: 85.6%

# 3. 文本对齐与填充字符
text = "DATA"
print(f"{text:>10}")                         # 右对齐,宽度10,默认空格填充: '      DATA'
print(f"{text:*^12}")                        # 居中对齐,宽度12,星号填充: '****DATA****'

# 4. 进制转换与前导零补齐
num = 42
print(f"二进制补零: {num:08b}")               # 输出: 二进制补零: 00101010
print(f"十六进制: 0x{num:02X}")               # 输出: 十六进制: 0x2A

# 5. Python 3.8+ 变量与表达式调试语法(等号说明符)
x = 10
y = 25
print(f"{x=}, {y=}, {x + y=}")               # 输出: x=10, y=25, x + y=35
三、常用字符串内置方法与文本清洗流水线
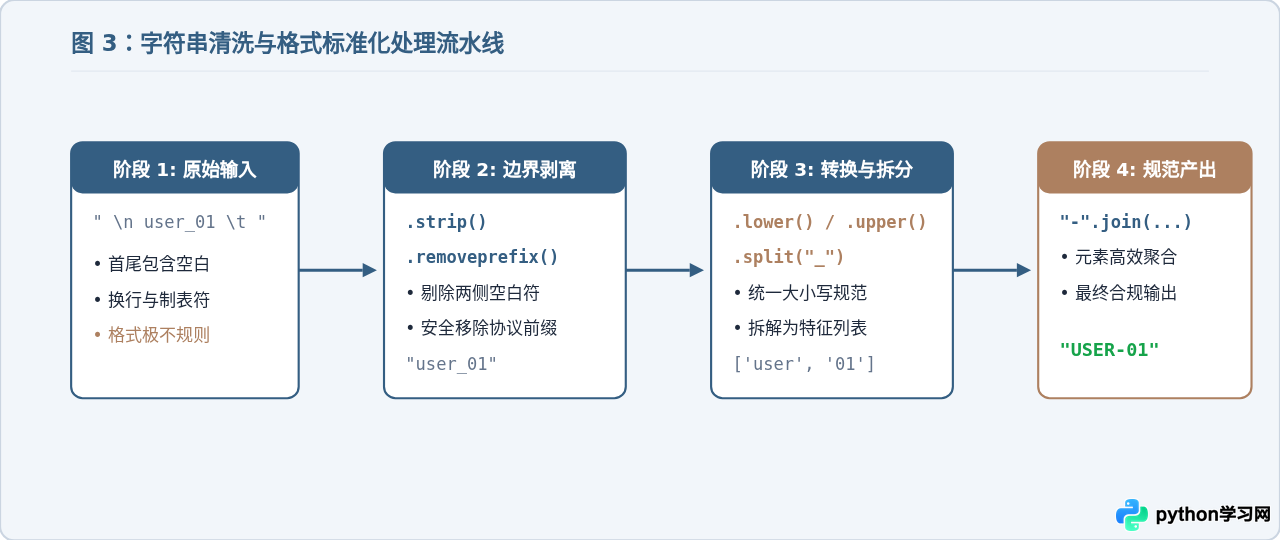
在工程实践中,从网络抓取、用户表单提交或日志文件中获取的原始文本,通常包含不规则的空格、换行符和混杂字符。熟练组合内置方法能够快速搭建出高可靠的文本清洗流水线。
1. 去除首尾空白与特定前缀/后缀
strip([chars]):移除首尾所有空白符(空格、换行\n、制表符\t)或指定字符集。对应单侧版本为lstrip()与rstrip()。removeprefix(prefix)(Python 3.9+):精准移除指定前缀字符串。若前缀不存在则完整返回原串,杜绝了过去用lstrip()错误剥离非前缀字符的隐患。removesuffix(suffix)(Python 3.9+):精准移除指定后缀字符串。
raw_url = "  https://example.com/api/v1/data.json  "
cleaned_url = raw_url.strip()

# 安全剥离协议头与扩展名
domain_path = cleaned_url.removeprefix("https://")
clean_name = domain_path.removesuffix(".json")

print(clean_name)  # 输出: 'example.com/api/v1/data'
2. 查找、统计与内容判断
| 方法名称 | 参数说明 | 返回值特征 | 注意事项与常见陷阱 |
|---|---|---|---|
find(sub) |
子串、可选起止范围 | 成功返回最小索引,失败返回 -1 |
适合判断存在性,不会抛出程序异常。 |
index(sub) |
子串、可选起止范围 | 成功返回最小索引,失败抛出 ValueError |
必须确保目标一定存在,或配合 try...except 使用。 |
count(sub) |
子串、可选起止范围 | 子串在母串中非重叠出现的次数 | 如在 'aaa' 中计算 'aa' 返回 1(不重叠计算)。 |
startswith(prefix) |
前缀字符串或元组 | 布尔值 True / False |
可传入元组:s.startswith(('http://', 'https://'))。 |
endswith(suffix) |
后缀字符串或元组 | 布尔值 True / False |
常用于按文件扩展名过滤文件。 |
isdigit() / isnumeric() |
无参 | 布尔值 | isdigit() 仅识别基础数字字符,无法识别负号与浮点数的小数点。 |
3. 分割(split)与拼接(join)的最佳组合
处理 CSV、TSV 或以特定符号隔开的数据行时,split() 与 join() 是一对互逆的操作:
# 1. 默认无参 split:按任意空白字符切分,并自动合并连续空白
line = "admin   192.168.1.100    200   OK"
parts = line.split()
print(parts)  # 输出: ['admin', '192.168.1.100', '200', 'OK']

# 2. 指定分隔符与最大分割次数 maxsplit
config = "database:mysql:3306:production"
tokens = config.split(":", maxsplit=2)
print(tokens) # 输出: ['database', 'mysql', '3306:production']

# 3. 聚合拼接:str.join(iterable)
fields = ["2026-10-24", "order_8892", "SUCCESS", "199.00"]
csv_line = ",".join(fields)
print(csv_line) # 输出: '2026-10-24,order_8892,SUCCESS,199.00'+= 大量累加字符串。由于字符串的不可变性,每次 += 都会申请新的内存空间并将旧内容复制过去,导致 \(O(N^2)\) 的时间复杂度;应当先使用 list.append() 收集所有分段,最后统一调用 "".join(list),在 \(O(N)\) 时间内完成高效构造。
四、综合应用案例与知识体系总结
为了加深对上述语法与方法的融会贯通,下面通过一个实际场景中的日志解析函数,演示如何将切片、内置方法清洗与 f-string 格式化结合使用:
def parse_server_log(log_entry: str) -> str:
    # 步骤 1: 清理首尾空白
    cleaned = log_entry.strip()
    if not cleaned or not cleaned.startswith("[LOG]"):
        return "无效日志条目"

    # 步骤 2: 利用切片剔除 "[LOG] " 标签(长度为 6)
    payload = cleaned[6:]

    # 步骤 3: 拆分等级与正文
    level, sep, content = payload.partition(" - ")
    if not sep:
        return "日志格式损坏"

    # 步骤 4: 规范化处理与格式化重构
    normalized_level = level.strip().upper()
    message = content.strip().capitalize()

    return f"【{normalized_level:^7}】: {message}"

# 测试样例
raw_data = "   [LOG] warning - disk capacity reaches 90% threshold.   \n"
print(parse_server_log(raw_data))
# 输出结果: 【WARNING】: Disk capacity reaches 90% threshold.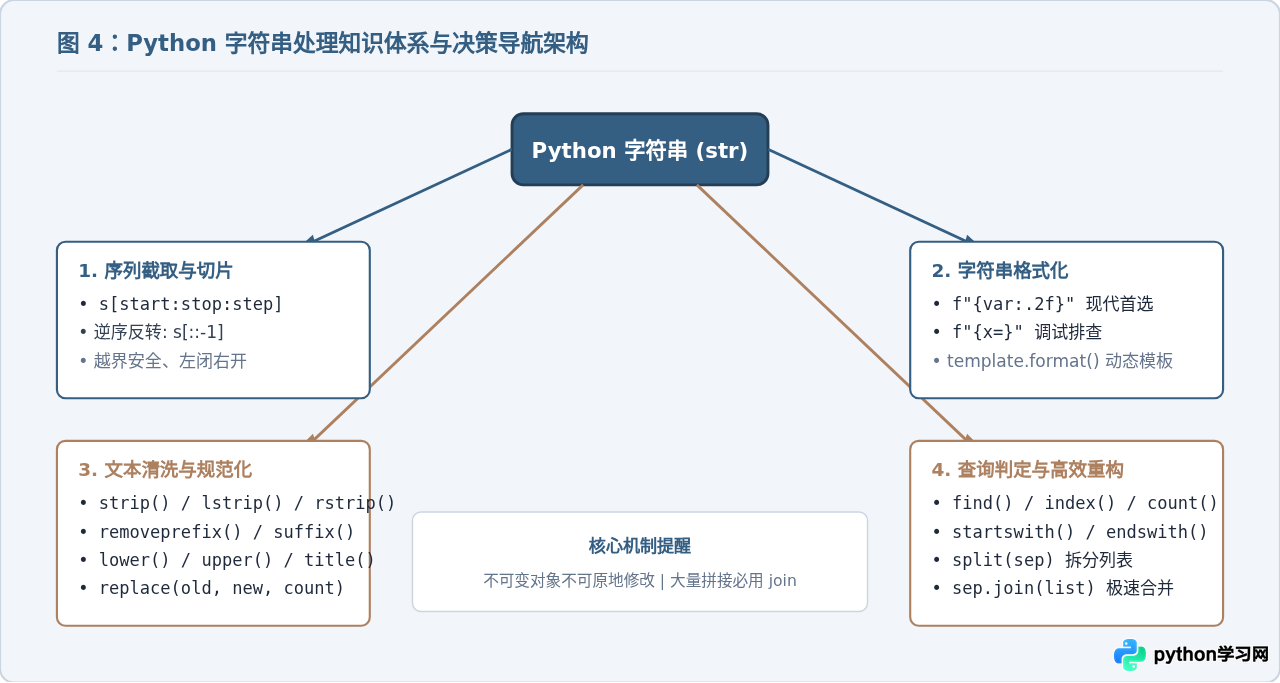
Python 的字符串处理语法体系逻辑严密且富有表现力。熟练利用双向索引与切片的 [start:stop:step] 语法能够安全、高效地提取子串;在变量组装与显示时,优先使用 Python 3.6+ 的 f-string 实现性能与可读性的平衡;在数据清洗阶段,利用 strip、removeprefix、split 与 join 的组合管线,可大幅降低由于格式脏乱带来的边界 Bug。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















