


python怎么在函数中打印输出
详细介绍在Python函数中使用print()进行打印输出的具体方法、执行机制、与return语句的核心区别、格式化参数技巧以及常见不输出问题的排障指南。
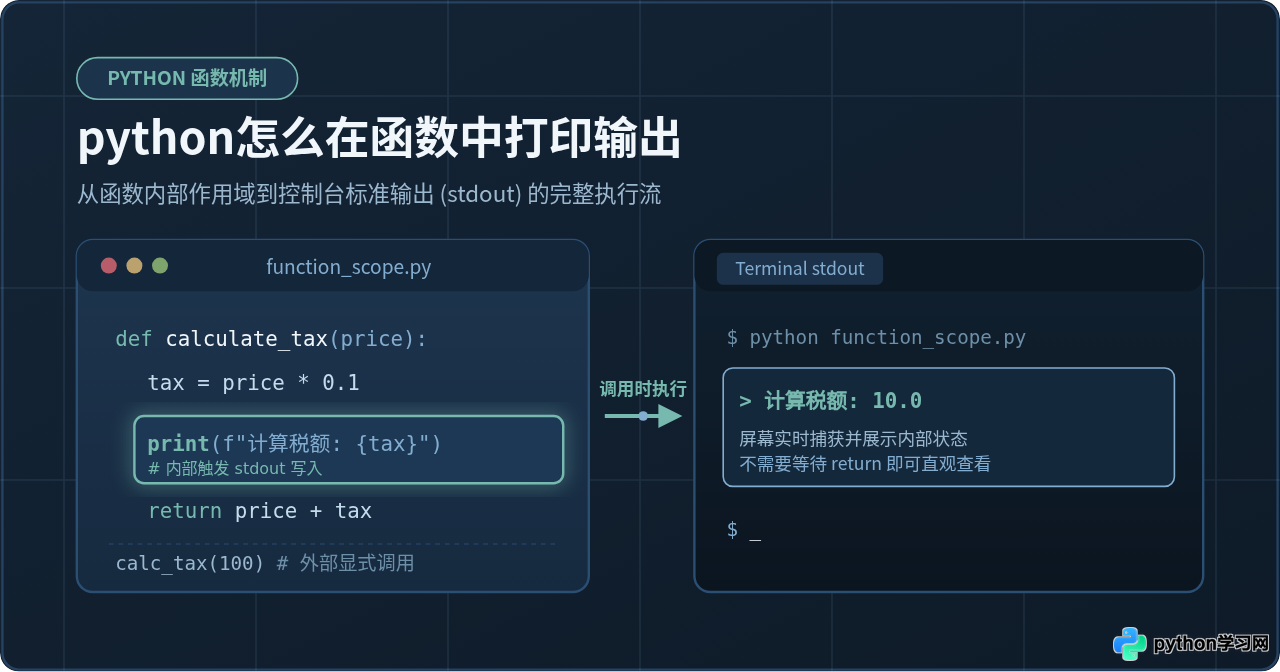
calc_discount(price, rate),把运算过程写进去了,但运行脚本后控制台却毫无反应;或者你想在函数执行时查看某个中间计算变量的值,却不清楚应该把输出语句写在哪个位置。在 Python 中,解决办法非常直接:只需在函数定义 def 的代码块内部直接调用内置函数 print(...)。当你在后续代码中显式调用该函数时,中间数据或提示文字就会自动输出到终端屏幕上。
一、在函数中调用 print() 的基础写法
在 Python 中,函数是通过 def 关键字声明的。要在函数执行时打印内容,最关键的一点是遵循缩进规则——将 print() 语句放置在 def 的作用域内部。
我们来看一个直接的示例:编写一个接收单价和数量并打印小计金额的函数。
def show_subtotal(price, count):
    # 在函数体缩进内部执行计算
    total = price * count
    # 在函数内部直接调用 print 打印信息
    print(f"商品单价: {price} 元,购买数量: {count} 件,小计: {total} 元")

# 注意:必须在外部显式调用函数,函数体内的 print 才会真正执行
show_subtotal(25, 4)这段代码展示了两个关键要素:
- 作用域内直接访问:函数体内部的
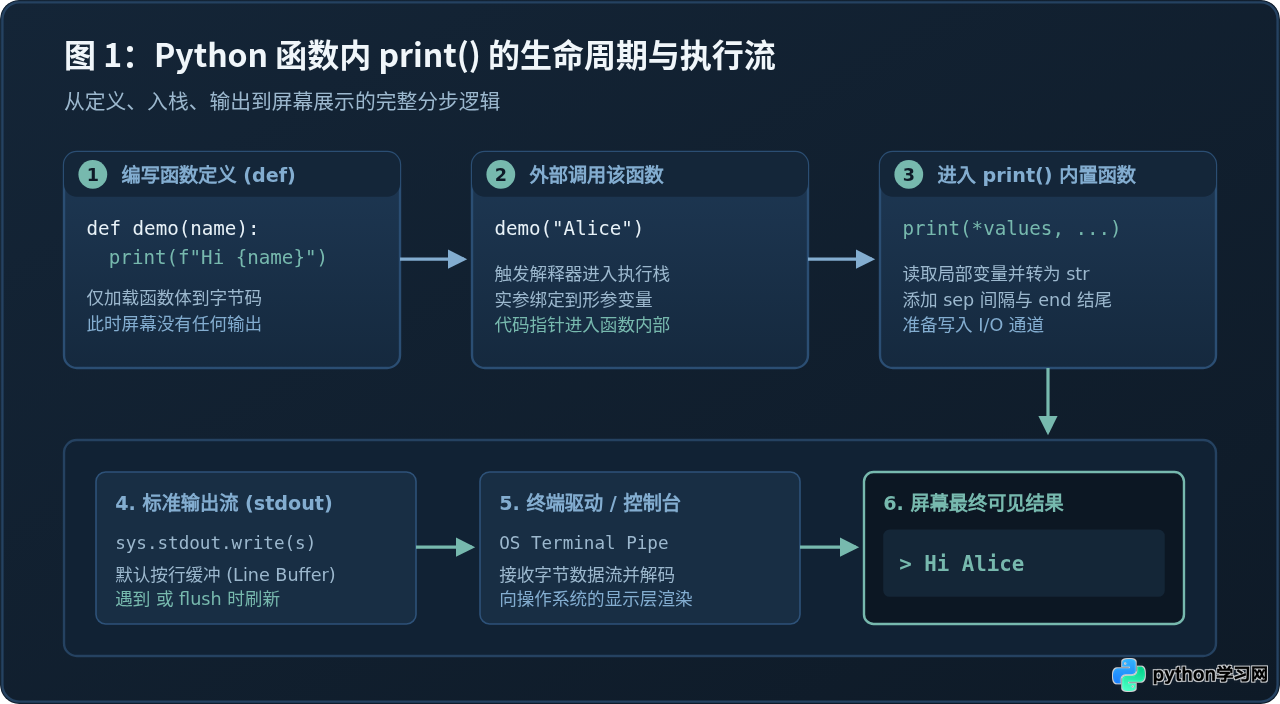
print()可以直接打印外部传入的实参(如price和count),也可以打印函数内部新生成的局部变量(如total)。 - 定义与执行的时序关系:仅编写
def show_subtotal(...)只会把函数声明注册到内存中,控制台绝不会产生任何输出;只有在外部执行了带括号的函数调用show_subtotal(25, 4),解释器才会真正跳转进函数内部,依次执行计算和打印。
二、关键区别:print() 打印与 return 返回值
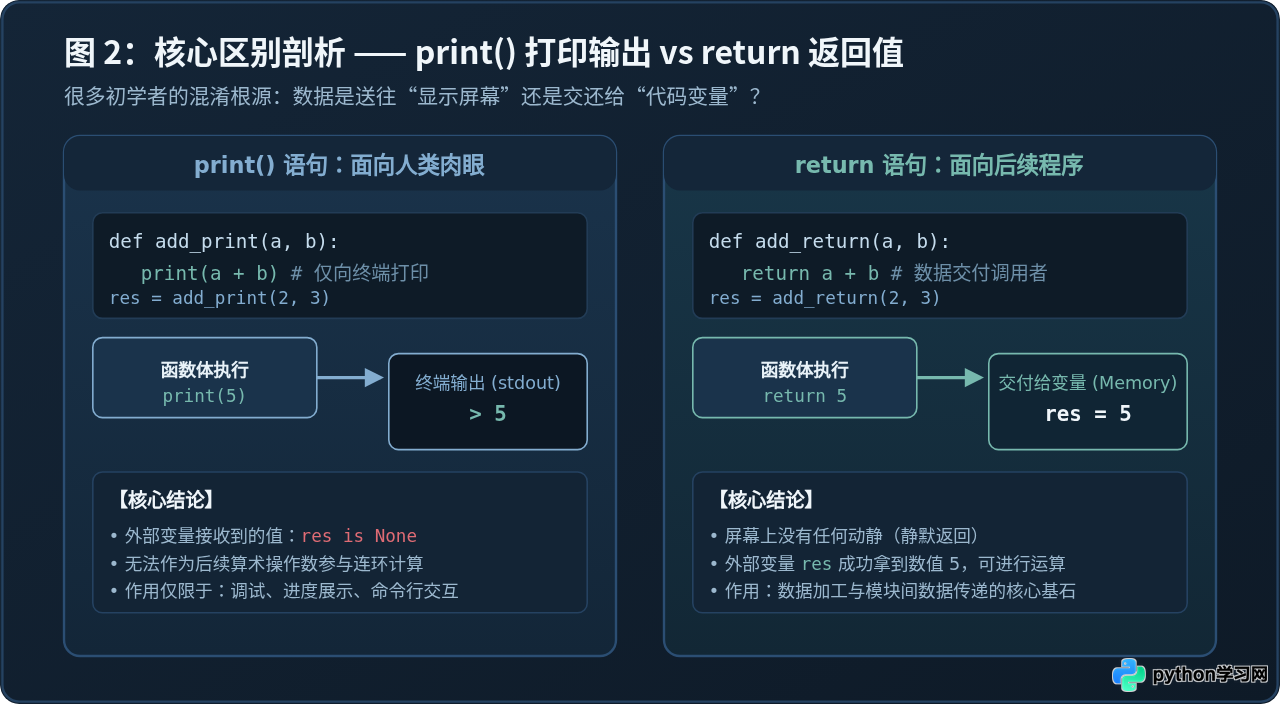
很多初学者在编写函数时,容易把 print() 和 return 混淆。甚至有人认为“在函数里 print 出来了,就代表函数把结果返回了”,这种理解会导致后续代码逻辑出现严重错误。
| 对比维度 | print() 打印输出 | return 返回语句 |
|---|---|---|
| 主要目标 | 将数据转换为人类可读的字符并展示在屏幕上 | 将计算结果交还给函数调用者,供后续程序继续运算 |
| 接收对象 | 标准输出流(终端屏幕、控制台或日志文件) | 程序运行时的内存变量(如 result = func()) |
| 执行后返回值 | print() 自身的返回值为 None |
返回开发者指定的任何 Python 数据对象 |
| 是否终止函数 | 不会终止,打印完后继续执行下一行语句 | 立即终止函数执行并退出函数栈帧 |
我们可以通过一段对比代码清晰地验证两者的不同表现:
def calc_with_print(a, b):
    print(a + b)  # 屏幕上能看到 5,但函数并没有 return 值

def calc_with_return(a, b):
    return a + b  # 屏幕静默无反应,但把 5 赋予了调用者

# 尝试用变量接收函数产出的结果
val_1 = calc_with_print(2, 3)
val_2 = calc_with_return(2, 3)

print(f"val_1 的真实值: {val_1}")
print(f"val_2 的真实值: {val_2}")val_1 的真实值: None
val_2 的真实值: 5
三、函数内打印的格式化与高级参数技巧
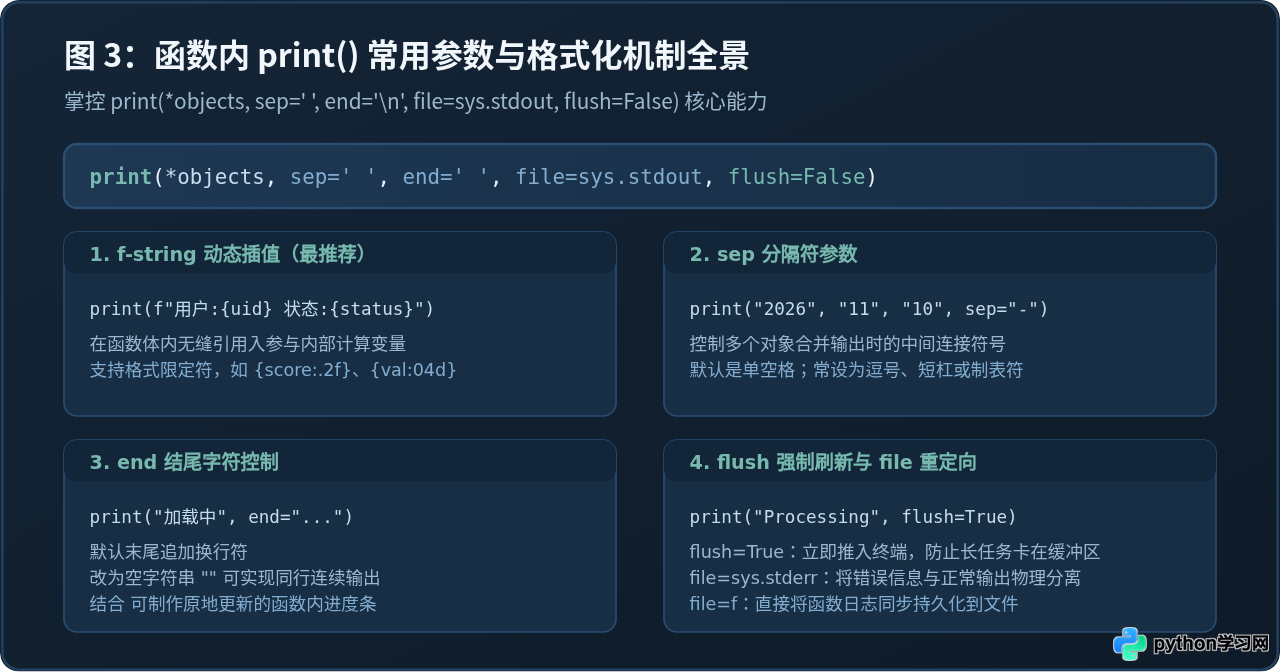
在实际项目或调试场景中,单纯打印单一变量往往不够直观。合理使用格式化字符串与 print() 的内置参数,能让函数输出的信息更具可读性与条理性。
1. 结合 f-string 呈现上下文信息
Python 3.6 引入的 f-string 是在函数中打印变量的最佳方式。你可以在字符串的大括号内嵌入入参、局部变量甚至是表达式:
def monitor_memory(task_name, used_mb, max_mb):
    ratio = used_mb / max_mb * 100
    # 使用 :.1f 保留一位小数,并在输出中带上函数任务名标识
    print(f"[{task_name}] 内存占用: {used_mb}MB / {max_mb}MB ({ratio:.1f}%)")

monitor_memory("DataSync", 512, 1024)2. 使用 sep 参数改变多项之间的连接符
默认情况下,当给 print() 传入多个逗号隔开的参数时,它们以空格相连。通过设置 sep 参数,可以指定任意自定义分隔符:
def print_route_path(*nodes):
    # 使用箭头连接所有传入的节点
    print(*nodes, sep=" -> ")

print_route_path("Client", "Gateway", "AuthService", "Database")3. 使用 end 与 flush 制作函数内实时进度提示
在处理批量任务或循环迭代的函数中,默认的换行符
会让每次打印都另起一行。如果你希望在同一行更新信息,可以修改 end 参数;配合 flush=True 能够立刻刷新缓冲区,避免输出延迟卡顿:
import time

def batch_process(items):
    total = len(items)
    print("开始处理批次任务...")
    for idx, item in enumerate(items, start=1):
        # 模拟耗时操作
        time.sleep(0.05)
        # 使用
 返回行首,end="" 阻止自动换行,flush=True 强制立即推送到终端
        print(f"
正在处理: {idx}/{total} [{item}]", end="", flush=True)
    print("
任务全部处理完成。")

batch_process(["file_a.csv", "file_b.csv", "file_c.csv"])正在处理: 3/3 [file_c.csv]
任务全部处理完成。
四、为什么函数内的 print 没有任何输出?常见原因排查
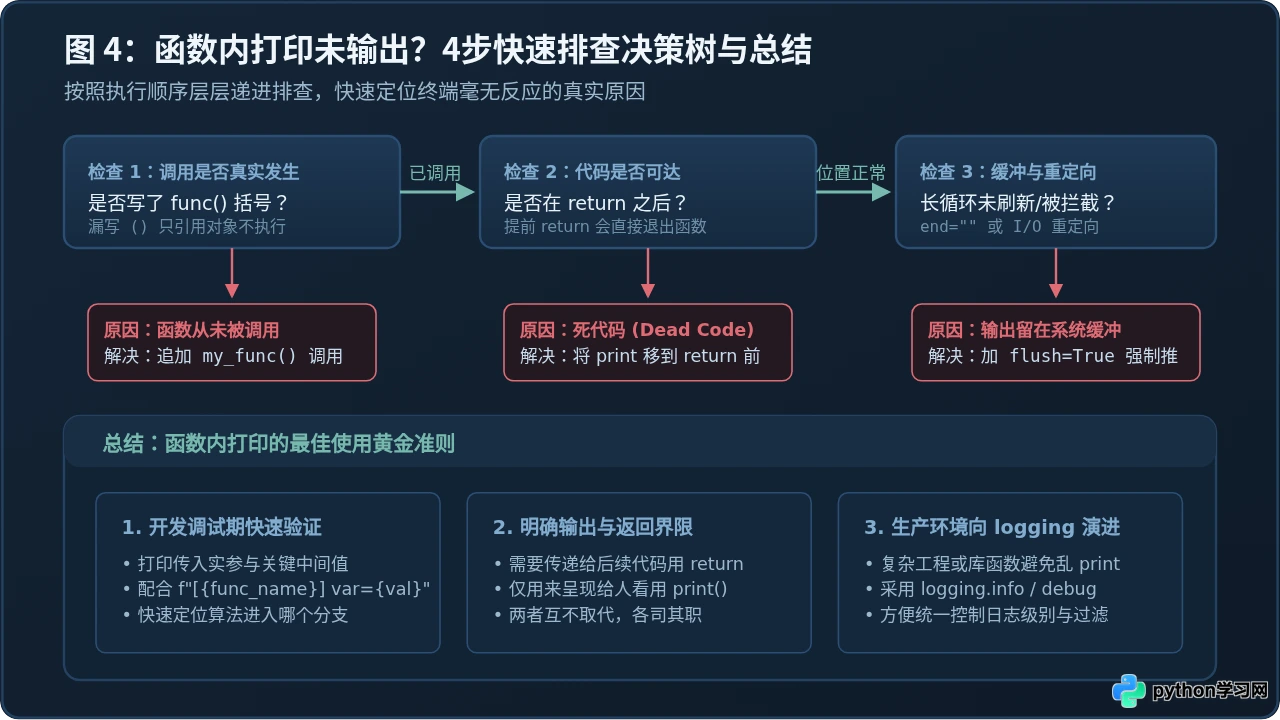
当你已经在函数里写了 print(),但运行程序时控制台依然空白,绝大多数情况下属于以下四种典型情形:
1. 仅定义了函数,却从未调用,或漏写了括号
初学者容易忘记在 def 外部写调用语句;或者把 my_function() 误写成了 my_function。在 Python 中,只有带有小括号 () 的表达式才会触发函数执行,写成 my_function 仅仅是对该函数对象本身的引用,不会进入函数体内部。
2. print 语句位于 return 之后(不可达死代码)
如果在 print() 之前执行了 return 语句,函数就会立刻弹出调用栈并返回,写在 return 下方同级缩进的代码将永远没有机会执行:
def wrong_order(x):
    return x * 2
    # 错误:位于 return 之后的 print 属于不可达代码,永远不会被执行
    print(f"计算结果为: {x * 2}")
3. 条件分支或循环没有满足触发条件
如果 print() 嵌套在 if 分支或 for / while 循环内部,当传入的条件判断为 False,或者传入的可迭代对象为空列表 [] 时,程序会直接跳过整个代码块,导致看起来像“没有打印”。
4. 缓冲区未刷新或标准输出被重定向
如果在非交互式脚本、后台守护进程或者将输出重定向到了日志管道中,Python 可能会对标准输出开启块缓冲(Block Buffering)。如果程序中途异常崩溃或未显式调用 flush=True,缓冲区中的字符串便可能未能及时刷入控制台。
五、总结
要在 Python 函数中实现打印输出,核心要点可以归纳为三步:
- 位置正确:将
print()写在def函数内部并保持正确的层级缩进; - 时机正确:确保
print()位于return语句之前,并在函数外部通过func_name()真正触发调用; - 表达清晰:优先结合
f-string、sep与flush等参数,准确输出变量名与上下文状态。
理解了函数内部作用域与标准输出管道的协同机制,就能在日常开发与代码调试中得心应手地掌控程序的实时状态。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















