


Python正则表达式入门:re标准库的核心语法与实例
深入讲解Python标准库re的核心语法与实用实例,涵盖字符集合、边界锚点、量词机制、分组捕获以及常用函数选型与常见避坑指南。
split 或 find)很难应对格式多变的复杂文本。Python内置的 re 标准库通过统一的正则表达式引擎,为字符串检索、精准捕获、内容校验与批量替换提供了底层支持。理解 re 的核心运转机制、元字符系统、贪婪控制以及高频函数,是高效编写文本处理代码的基石。
一、Python 正则执行机制与原生字符串规则
在Python中使用正则表达式,本质是由 re 引擎将编写的模式字符串(Pattern)解析为底层状态机,随后在目标字符串(Text)中滑动扫描,并返回包含匹配位置与内容的 Match 对象。
编写正则表达式模式时,首要准则就是始终使用原生字符串(Raw String,即前缀 r"...")。原因在于Python解释器本身会对常规字符串中的反斜杠进行一次转义解析,而正则表达式引擎又需要通过反斜杠识别特殊字符(例如 \d 或 )。如果使用普通字符串,匹配一个文本中的真实反斜杠字符 \ 需要编写四个反斜杠 "\\";使用原生字符串 r"\" 则能彻底关闭Python层面的转义干扰,保持代码与正则语法的一致性。
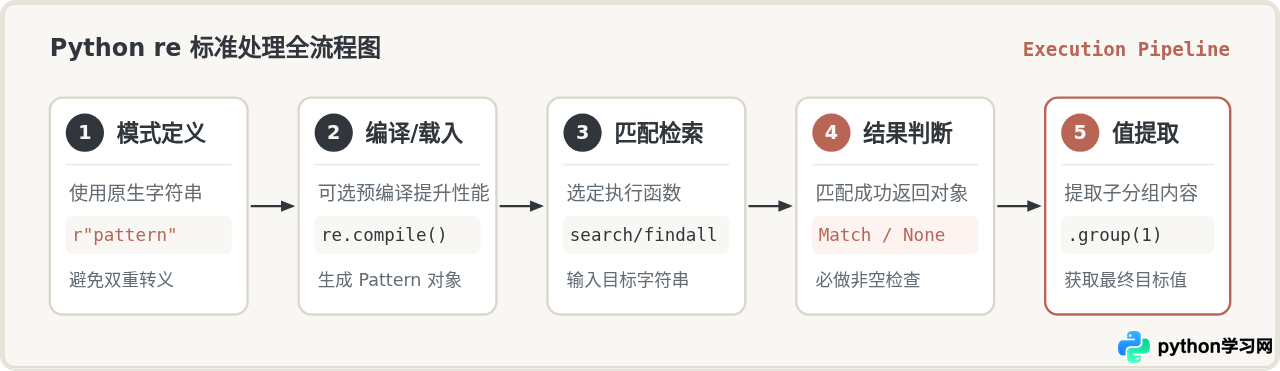
典型的执行生命周期由五个节点构成:模式书写、编译载入、检索扫描、有效性验证与数值提取。执行检索后,必须先判断返回值是否为 None,随后才能调用 .group() 提取结果,否则在没有匹配项时会抛出 AttributeError。
二、核心元字符分类与语法规则
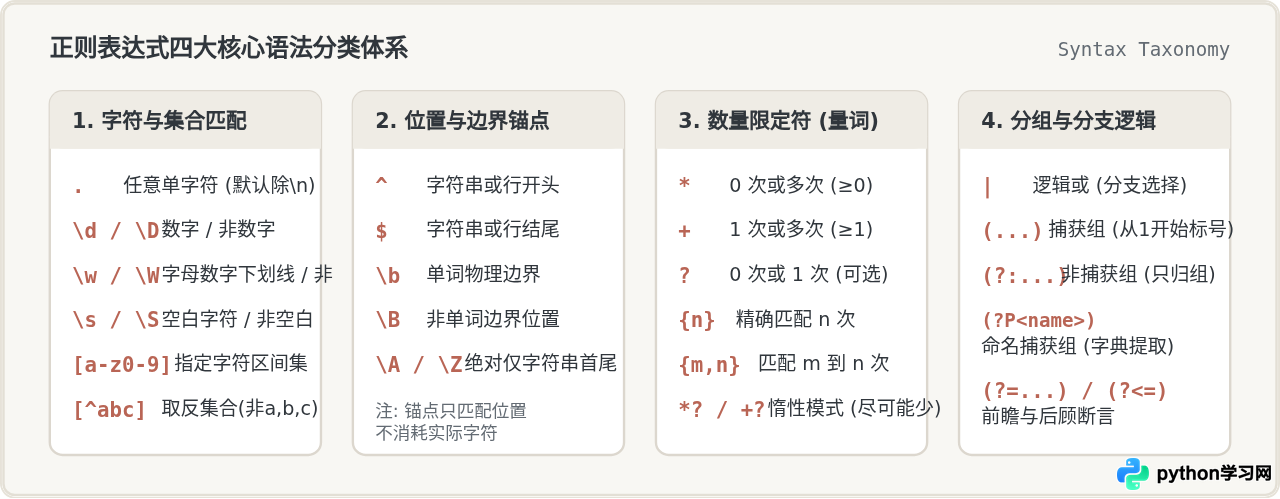
正则表达式的语法虽然丰富,但整体上可以划分为四大核心支柱:字符匹配符、位置锚点、量词限定符以及分组逻辑。分类掌握各组符号的作用范围,能迅速建立模式构造的直觉。
1. 字符匹配与集合
字符匹配符定义了单个字符位的取值规则:
.:匹配除换行符re.DOTALL标志位,则可匹配包含换行符在内的所有字符。\d与\D:\d匹配任意单个数字字符(等价于[0-9]),大写的\D则匹配非数字。\w与\W:\w匹配字母、数字及下划线,\W匹配非单词字符。在Python 3中,默认包含Unicode字符。\s与\S:\s匹配任意空白符(包括空格、制表符[abc]与[^abc]:方括号定义字符集合,只匹配其中列出的任一字符;若方括号首位为脱字符^,则表示排除集合内字符。
2. 位置锚点:不消耗字符的边界判断
与普通字符不同,位置锚点不占据任何字符宽度,它们仅负责核验当前匹配光标所处的物理边界:
^与$:分别限定字符串的起始与结尾。如果启用多行模式re.MULTILINE,它们将分别匹配每一行的开头与行末。:匹配单词边界,即\w与\W(或字符串起止)的交界缝隙。例如用r"cat"检索时,可以精准命中独立的cat,而排除category或concatenate。
3. 数量限定符(量词)
限定符修饰紧挨其左侧的前置表达式,决定其出现的频次:
*:匹配 0 次或多次(出现或不出现均可)。+:匹配 1 次或多次(至少出现 1 次)。?:匹配 0 次或 1 次(常用于修饰可选元素,如https?兼容 http 与 https)。{n}、{m,n}:明确指定出现次数区间,如\d{4}严格匹配连续 4 位数字。
三、贪婪模式与非贪婪(惰性)机制
在默认情况下,所有的重复量词(*、+、{m,n})都是贪婪(Greedy)的。这意味着正则引擎会在保证整个模式能够匹配的前提下,尽可能多地吞食输入字符,直到遭遇终止符号,必要时再进行回溯。
在解析嵌套结构或成对标签(如HTML/XML或括号文本)时,贪婪匹配极易导致越界吞食。只需在量词后紧跟一个问号(*?、+?、??、{m,n}?),即可将其转换为非贪婪(惰性)模式,使引擎在命中第一个合法终止条件时立即完成匹配。
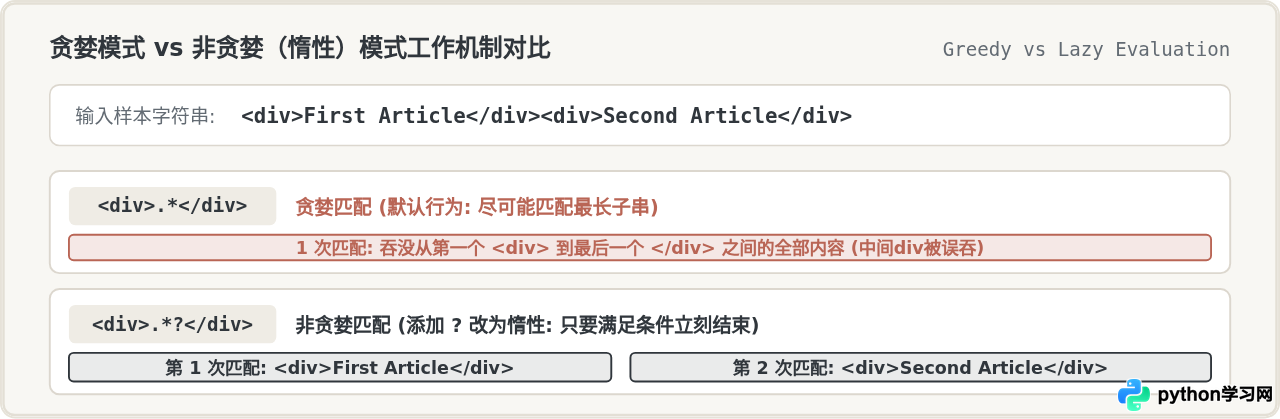
通过一段代码可以直观验证两者的差异:
# 环境:Python 3.6+ 标准库交互环境
import re

html_doc = "<div>First Article</div><div>Second Article</div>"

# 1. 贪婪匹配:.* 尽可能长地捕获
greedy_result = re.findall(r"<div>.*</div>", html_doc)
print("贪婪模式结果:", greedy_result)

# 2. 非贪婪匹配:.*? 遇到首个闭合标签立即截断
lazy_result = re.findall(r"<div>.*?</div>", html_doc)
print("非贪婪模式结果:", lazy_result)非贪婪模式结果: ['<div>First Article</div>', '<div>Second Article</div>']
四、分组捕获与结构化数据提取
使用圆括号 () 可以把模式拆解为多个逻辑单元。括号不仅能限定量词的作用域,还能将匹配结果分割保存到独立的分组中。
1. 普通捕获组与索引获取
使用 () 括起目标部分,匹配成功后,match.group(0) 返回完整匹配文本,match.group(1) 返回第 1 个括号内的内容,以此类推;match.groups() 则返回包含所有捕获组的元组。
2. 命名捕获组:增强代码健壮性
当正则表达式包含多个捕获组时,依赖数字索引(如 group(3))容易因模式后续改动而错位。使用 (?P<name>...) 可以为分组显式命名,并通过 match.group("name") 或 match.groupdict() 直接提取为 Python 字典。
import re

log_line = "2026-10-30 18:25:40 [ERROR] Connection timed out (client: 192.168.1.104)"

pattern = r"(?P<timestamp>\d{4}-\d{2}-\d{2} \d{2}:\d{2}:\d{2}) \[(?P<level>[A-Z]+)\] (?P<msg>.*) \(client: (?P<ip>[\d\.]+)\)"

match = re.search(pattern, log_line)
if match:
    data = match.groupdict()
    print("提取字典:", data)
print("单独获取IP:", match.group("ip"))单独获取IP: 192.168.1.104
3. 非捕获组 (?:...)
如果仅仅需要将若干字符组合起来应用量词或分支选择(例如 (?:http|https)://),但不需要单独从结果中抽取该段子文本,应在括号起始加上 ?:。非捕获组不会分配分组编号,能显著减轻正则引擎在回溯时的内存开销。
五、re 标准库常用核心函数速查与选型
Python标准库 re 提供了功能明确的顶级函数。选型不当(例如在需要全文本搜索时误用 re.match)是导致初学者代码返回 None 的最高发原因。
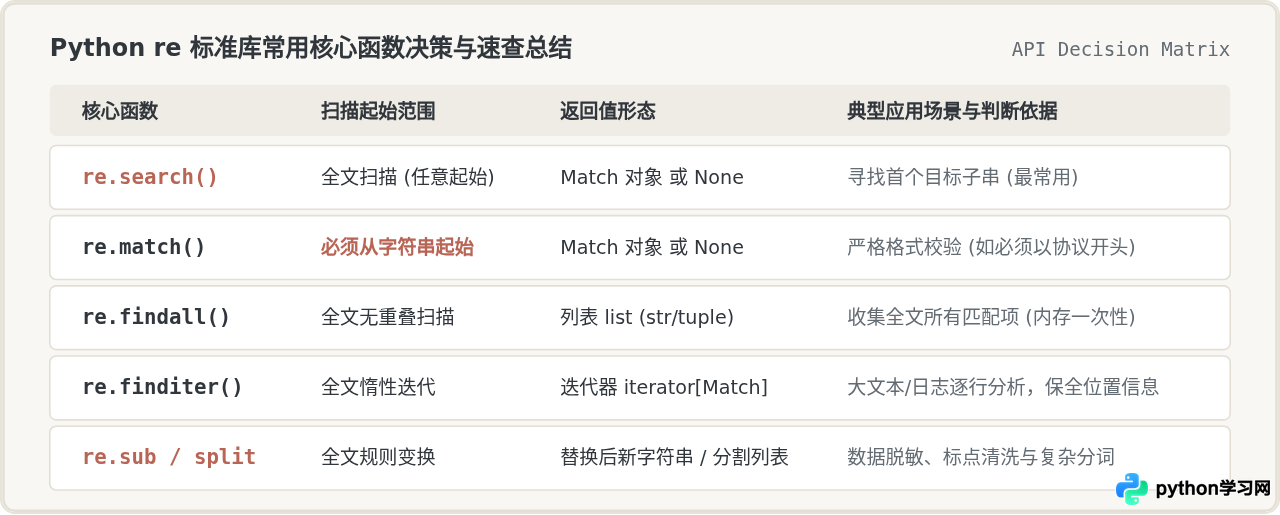
1. 全文搜索 re.search() 与首部匹配 re.match()
核心区别:re.match() 强制要求匹配必须从字符串的第一个字符(索引 0)开始成立,否则直接返回 None;而 re.search() 会在全文中由前向后滑动扫描,返回首次命中的位置。在绝大多数非全字段验证的场景中,应优先使用 re.search()。
import re

text = "系统提示: 订单编号 20268891 支付成功"

# match 失败:因为字符串起始是 "系统提示",非数字
print("match 结果:", re.match(r"\d+", text))

# search 成功:扫描全文找到首个连续数字
search_res = re.search(r"\d+", text)
print("search 结果:", search_res.group() if search_res else "未找到")search 结果: 20268891
2. 多项提取:re.findall() 与 re.finditer()
re.findall() 一次性遍历全文,将所有互不重叠的匹配内容作为 list 返回。如果模式中包含多个捕获组,它会返回一个由元组构成的列表。
面对数十兆的大型文本或日志文件时,一次性生成列表会占用大量内存。此时应改用 re.finditer(),它返回一个生成器,逐个生成 Match 对象,不仅节省内存,还能通过 .start() 和 .end() 精确掌握每个匹配项在原文中的字符偏移量。
3. 正则替换与数据清洗:re.sub()
re.sub(pattern, repl, string, count=0) 将匹配到的内容替换为指定文本。repl 不仅可以是一个固定字符串,还可以传入一个回调函数,实现精细的动态清洗计算。
import re

phone_record = "用户A: 13812345678, 用户B: 15987654321"

# 将手机号中间 4 位替换为星号脱敏
masked = re.sub(r"(\d{3})\d{4}(\d{4})", r"\g<1>****\g<2>", phone_record)
print("脱敏结果:", masked)4. 性能优化:re.compile() 的使用时机
在批量处理数万行数据或在循环体内部使用正则时,如果每次迭代都调用 re.search(),虽然 re 模块内部自带小型 LRU 缓存,但直接使用 pattern = re.compile(r"...") 将模式预先编译为 Pattern 对象,能够省去重复的缓存查表与正则词法解析损耗,代码结构也更为清晰。
六、新手高频陷阱与注意事项
re.findall()与分组的交互陷阱:当模式中引入了(),findall()的返回行为会发生突变——它将仅返回括号内捕获的内容,而非整个匹配项!如果不希望这样,请务必使用非捕获组(?:...),或者改用re.finditer()调用match.group(0)。- 转义符与原生字符串遗漏:匹配真实的点号
.或括号()时,必须用\.或\(转义;若未在字符串前加r,Python会将某些反斜杠序列静默解释,造成难以排查的逻辑偏差。 - 警惕灾难性回溯(ReDoS):避免嵌套贪婪量词(例如
(a+)+$或(\w+)*)。当遭遇畸形或超长不匹配字符串时,正则引擎会执行指数级的分支尝试,导致CPU利用率瞬间冲高至100%出现假死。
结语
正则表达式不是孤立的记忆游戏,而是基于有限状态自动机的模式匹配工具。掌握 r"" 原生字符串规范、理解贪婪与惰性的截断机制、善用命名捕获组提取结构化数据,并在 search、finditer 与 sub 之间做出恰当选型,就能以极高的一致性解决绝大部分Python文本处理难题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















