


为什么Python复数不能比较大小?解决TypeError报错
深入解析Python中复数类型(complex)不支持大小比较引发TypeError的原因,从数学有序域公理与Python设计哲学切入,并提供基于模长、实虚部和字典序的具体代码解决方案与排查步骤。
在 Python 中,当你尝试对复数(complex)执行 <、<=、> 或 >= 等大小比较运算时,解释器会立即抛出 TypeError: '<' not supported between instances of 'complex' and 'complex' 异常。发生这一现象的核心原因在于:在纯数学中,复数域是一个二维平面系统,不存在与加减乘除算术运算相容的“全序关系”(Ordered Field);而在计算机语言工程实现中,Python 严格遵循代数公理与“显式优于隐式”的设计哲学,仅定义了复数的等价性运算(== 与 !=),坚决不为复数提供含糊的默认大小顺序。如果你在业务中需要对复数进行排序或取极值,必须根据实际需求显式指定比较维度(如模长、实部、虚部或字典序)。
一、复数比较报错的典型现场与表现
为了直观重现该错误,我们可以观察以下两段极简的 Python 交互代码。无论是在两个复数之间比大小,还是将复数与普通的整数、浮点数比大小,都会触发相同的类型错误:
# 场景 1:两个复数之间直接比较大小
z1 = 2 + 3j
z2 = 3 + 1j
print(z1 < z2)
# 抛出异常:
# TypeError: '<' not supported between instances of 'complex' and 'complex'

# 场景 2:复数与纯实数比较大小
z3 = 5 + 0j
print(z3 > 2)
# 抛出异常:
# TypeError: '>' not supported between instances of 'complex' and 'int'
值得特别注意的是,虽然大小比较运算符全面禁用,但 Python 却完全支持复数的相等性(Equality)判断:
# 场景 3:相等与不等比较是完全合法的
print((2 + 3j) == (2 + 3j))  # 输出: True
print((2 + 3j) != (3 + 1j))  # 输出: True
print((5 + 0j) == 5)         # 输出: True(当虚部为0且实部与数字相等时)
为什么 Python 允许判断两个复数是否“相等”,却唯独不允许判断谁“更大”或谁“更小”?这背后的逻辑必须追溯到数学公理体系与语言运行时的调度机制。
二、深层原因:数学公理与 Python 设计哲学
许多初学者会直觉地认为:“复数难道不能直接按照模长 $\sqrt{x^2 + y^2}$ 比较大小吗?”要解答这个疑问,需要从代数学基本原理谈起。
1. 一维实数轴的“有序域”与二维复平面的代数矛盾
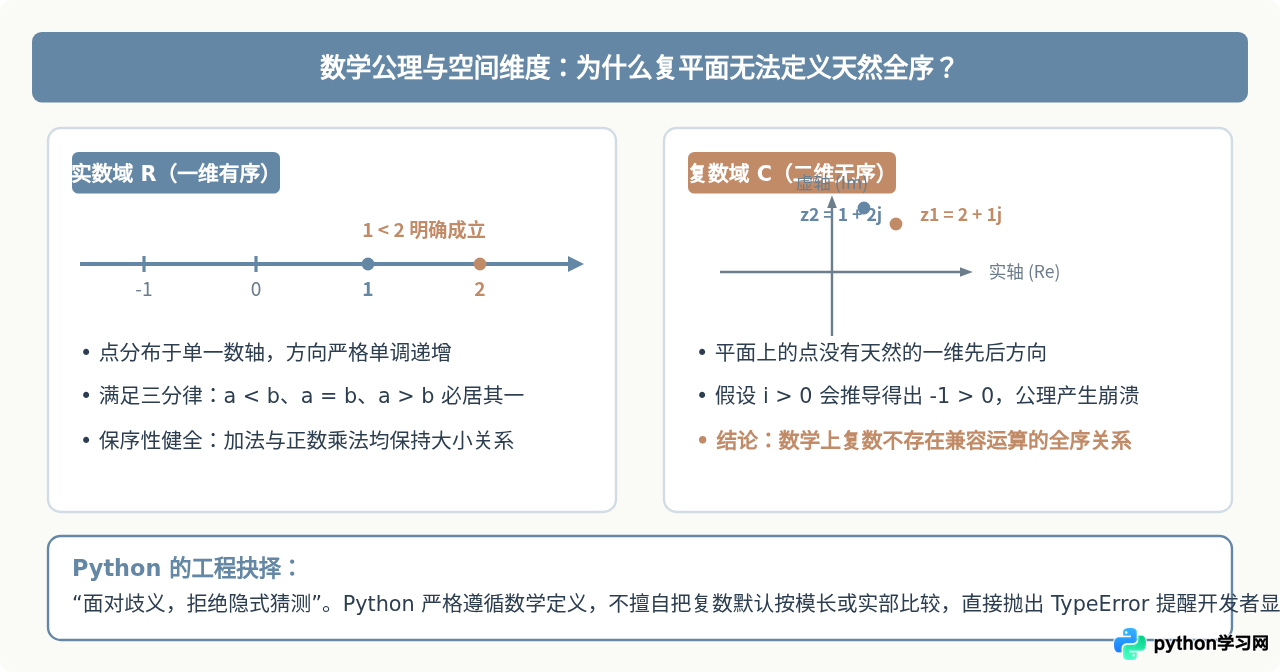
实数集合 $\mathbb{R}$ 在几何上表现为一根连续的一维数轴,数学上称之为有序域(Ordered Field)。实数的大小比较满足严格的公理约束:
- 三分律(Trichotomy):对于任意两个实数 $a$ 和 $b$,$a < b$、$a = b$、$a > b$ 三者有且仅有一个成立;
- 加法保序性:若 $a < b$,则对任意 $c$,恒有 $a + c < b + c$;
- 乘法保序性:若 $a < b$ 且 $c > 0$,则恒有 $ac < bc$。由此可知任何非零数的平方必大于零($x^2 > 0$)。
然而,复数集合 $\mathbb{C}$ 构成了二维复平面。虚数单位 $i$(Python 中写作 j)满足 $i^2 = -1$。如果我们在复数域上强行定义一个保持加法与乘法保序性的全序关系,就会立刻陷入代数矛盾:
- 若假设 $i > 0$:两边同时乘以正数 $i$,由乘法保序性可得 $i \cdot i > 0 \cdot i$,即 $-1 > 0$。这与常识 $-1 < 0$ 相悖;
- 若假设 $i < 0$:两边加上 $-i$ 得 $-i > 0$。两边同时乘以 $-i$,可得 $(-i)^2 > 0$,即 $-1 > 0$,同样得出荒谬结论。
因此在严格的近世代数中已经证明:复数域上不存在与域加法、乘法兼容的全序关系。
2. Python 为什么不默认按模长(abs)进行比较?
如果 Python 自动为复数提供 z1 < z2 等同于 abs(z1) < abs(z2) 的默认行为,会引发非常致命的逻辑漏洞。例如:对于两个不同的复数 $1 + 0j$ 与 $0 + 1j$,它们的模长均为 $1$。如果按模长比较,就会出现 not (z1 < z2) 且 not (z2 < z1),这在全序语义下意味着 z1 == z2。然而在实际数学和工程中,实数 1 和虚数 $j$ 显然是不相等的((1+0j) == (0+1j) 必定是 False)。这种“既不小于、也不大于,但又不相等”的混乱状态,会严重破坏 Python 排序算法(如 Timsort)的稳定性要求,埋下极难调试的隐患。
三、底层机制:Python 富比较方法的调用与分发
在 Python 内部,所有二元比较操作都是通过对象协议中的富比较方法(Rich Comparison Methods)来完成的。具体包括 __lt__、__le__、__gt__、__ge__、__eq__ 和 __ne__。
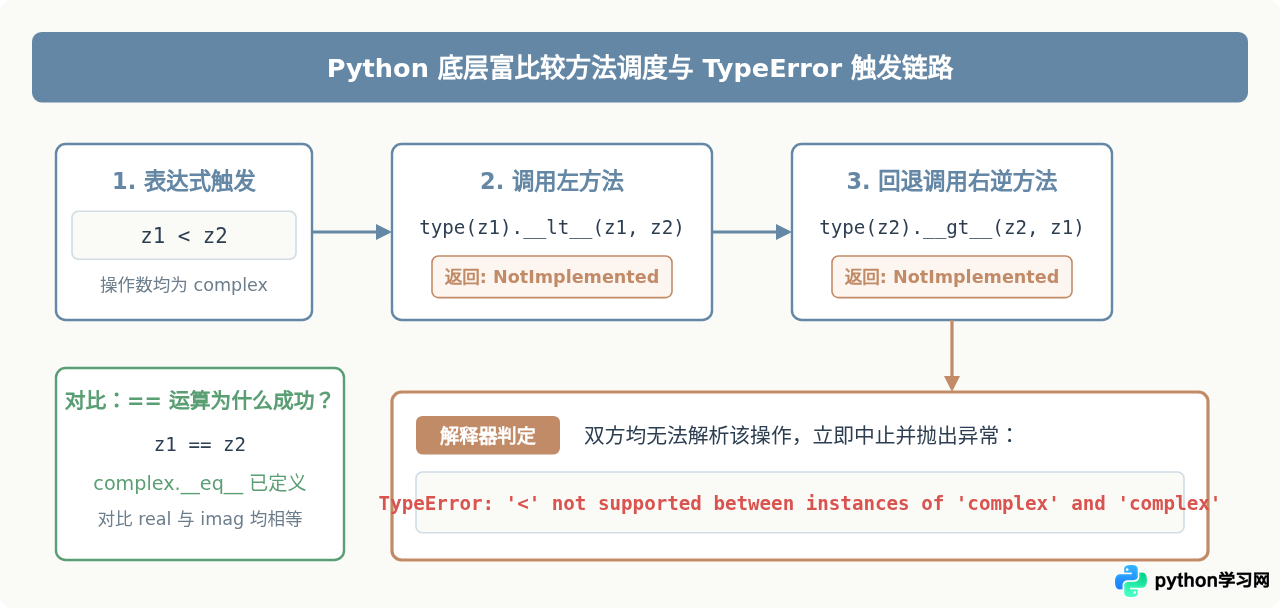
当执行 z1 < z2 时,解释器的分发执行过程如下:
- 首先调用左操作数的
type(z1).__lt__(z1, z2); - 在内置
complex类型中,由于复数未定义大小次序,该方法直接返回特殊单例对象NotImplemented; - 当左操作数返回
NotImplemented时,解释器会反向尝试调用右操作数的对应逆方法type(z2).__gt__(z2, z1); - 右操作数同样是
complex,其__gt__也返回NotImplemented; - 两端均无法处理该比较请求,解释器最终判定该操作不被支持,抛出
TypeError: '<' not supported between instances of 'complex' and 'complex'。
四、解决 TypeError 报错的具体代码方案
明确了不能直接比大小的根源之后,解决方案就非常明确了:根据具体业务目标,显式提取复数的一维特征,将其转化为可比较的实数或元组。常见的应用场景分为以下四种:
方案 1:按复数模长(幅值 / 绝对值)比较
在物理学、电磁学或信号分析中,复数通常表示交流信号或振动,其模长(绝对值)代表振幅或能量。此时可以使用内置的 abs() 函数作为比较的依据:
# 示例:根据模长比较大小与排序
signals = [1 + 2j, 3 + 0j, 0 + 1j, -2 - 2j]

# 1. 直接获取模长最大与最小的信号
max_signal = max(signals, key=abs)
min_signal = min(signals, key=abs)
print(f"最大振幅信号: {max_signal}, 模长: {abs(max_signal):.2f}")
# 输出: 最大振幅信号: (3+0j), 模长: 3.00

# 2. 按模长从小到大排序
sorted_by_abs = sorted(signals, key=abs)
print("按模长升序排列:", sorted_by_abs)
# 输出: [(0+1j), (1+2j), (-2-2j), (3+0j)]
方案 2:按实部(real)或虚部(imag)比较
当分析阻尼振荡或特定频域分量时,我们可能只关心其实数衰减率(实部)或振荡频率(虚部)。此时可以直接访问复数对象的 .real 或 .imag 属性:
nums = [2 + 8j, 5 + 1j, -1 + 4j]

# 仅按实部大小排序
sorted_by_real = sorted(nums, key=lambda z: z.real)
print("按实部排序:", sorted_by_real)
# 输出: [(-1+4j), (2+8j), (5+1j)]

# 仅按虚部大小排序
sorted_by_imag = sorted(nums, key=lambda z: z.imag)
print("按虚部排序:", sorted_by_imag)
# 输出: [(5+1j), (-1+4j), (2+8j)]
方案 3:按字典序(先看实部,再看虚部)进行稳定排序
在平面网格遍历、点阵去重或需要保证确定性输出的算法中,单一的模长无法区分模长相同但方向不同的点(如 $1$ 与 $j$)。使用 Python 的元组天然支持字典序比较的特性,可以实现完全确定的全序排序:
points = [1 + 1j, 0 + 1j, 1 - 1j, 0 - 2j]

# 构造 (实部, 虚部) 元组作为排序键
sorted_lex = sorted(points, key=lambda z: (z.real, z.imag))
print("按字典序排序:", sorted_lex)
# 输出: [(0-2j), (0+1j), (1-1j), (1+1j)]
方案 4:通过自定义包装类重写比较方法
若你的数据需要频繁存入优先队列(heapq)或进行大量二元运算,反复书写 key=... 会降低代码可读性。此时可以将复数封装在一个自定义类中,并重写富比较方法:
from functools import total_ordering

@total_ordering
class OrderedComplex:
    def __init__(self, val: complex):
        self.val = val

    def __lt__(self, other):
        if isinstance(other, OrderedComplex):
            # 业务规则:以模长作为第一排序键,模长相同按实部排序
            return (abs(self.val), self.val.real) < (abs(other.val), other.val.real)
        return NotImplemented

    def __eq__(self, other):
        if isinstance(other, OrderedComplex):
            return self.val == other.val
        return False

    def __repr__(self):
        return f"OrderedComplex({self.val})"

# 使用封装类无缝参与比较与排序
c1 = OrderedComplex(1 + 2j)
c2 = OrderedComplex(2 + 1j)
print(c1 < c2)  # 正确返回,不报 TypeError
五、排查与修复复数比较报错的四步操作流程
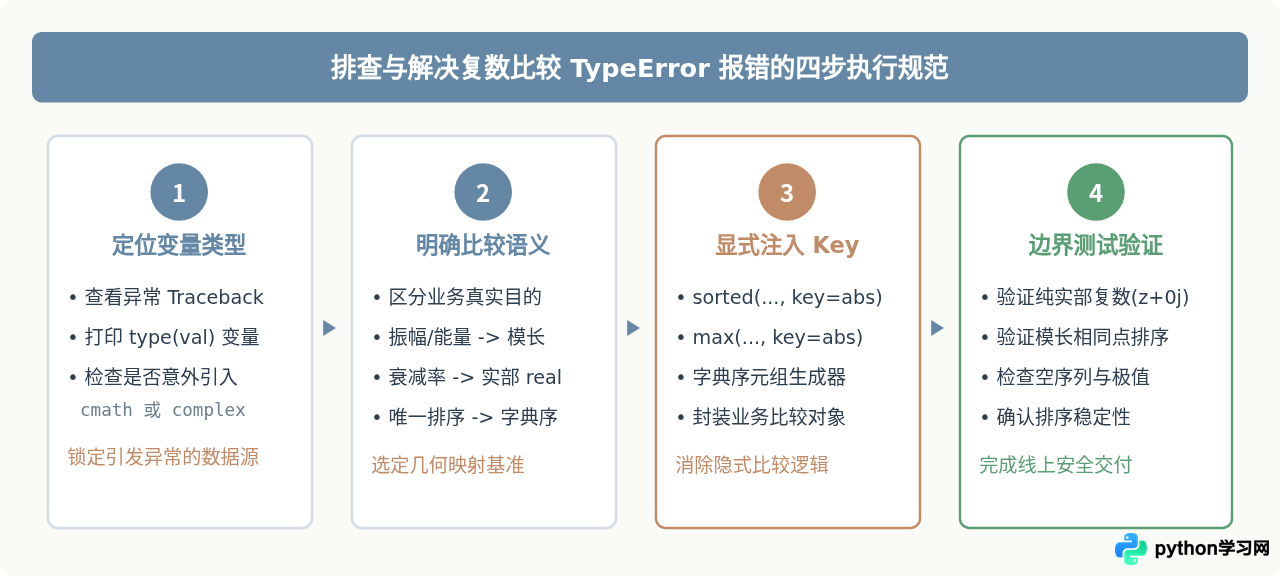
在实际开发过程中,复数可能并非由你显式声明,而是由第三方数学库(如 NumPy、SciPy、SymPy)或 cmath 计算中隐式生成的。当程序意外崩溃时,可以按照以下清晰的步骤进行排查:
在数据科学中,对 NumPy 数组执行布尔掩码操作(如
arr[arr > 0])非常普遍。但如果 arr 的 dtype 是 np.complex128,同样会直接抛出 TypeError: '>' not supported between instances of 'numpy.ndarray' and 'int'。对于 NumPy 数组,必须显式调用 np.abs(arr) > threshold 或 arr.real > 0。
六、解决方案全景决策与选型总结
为了在实际开发中快速选用恰当的修复方式,下表对各类复数处理方案的特性进行了归纳:
| 处理方案 | 转换公式 / 键函数 | 数学特性 | 典型适用场景 |
|---|---|---|---|
| 模长比较 | key=abs |
非负一维投影,不同相角可能产生重合 | 雷达信号、声学振幅、交流电功率分析 |
| 实部投影 | key=lambda z: z.real |
完全忽略虚部,仅保留实数轴分量 | 系统阻尼分析、收敛速度判断 |
| 字典序 | key=lambda z: (z.real, z.imag) |
建立严格的全序,任意不同点均不重合 | 几何点阵排序、算法去重、确定性数据输出 |
| 对象封装 | 重写 __lt__ 与 __eq__ |
高内聚封装,自定义复合判定规则 | 优先队列(heapq)、领域模型业务对象 |
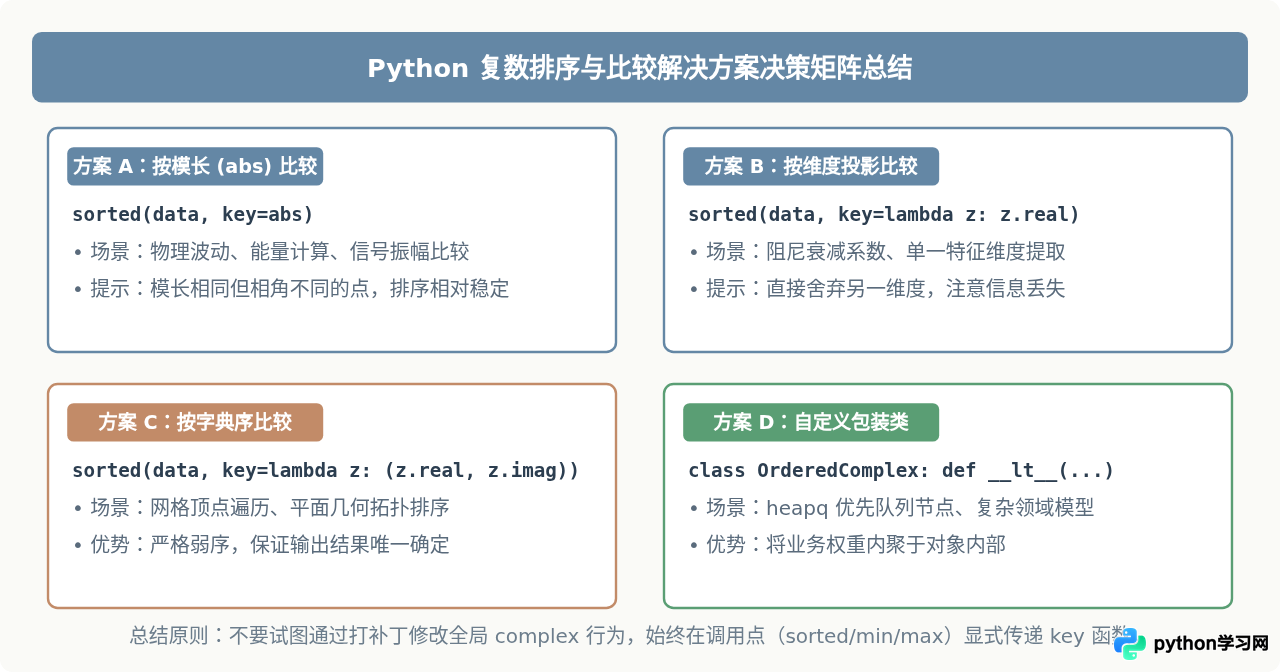
总而言之,遇到 TypeError: '<' not supported between instances of 'complex' 并不是程序遇到了无法解决的故障,而是 Python 在忠实履行数学规律并保护你的代码免受隐式歧义的伤害。只要明确业务需求究竟关注“振幅”还是“坐标”,通过 key=abs 或元组键函数即可优雅且彻底地消除该报错。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















