


Python中break、continue和pass在循环里有什么区别?
详细解析Python中break、continue与pass三个关键字在循环中的本质区别、执行流向、实际代码示例与避坑指南。
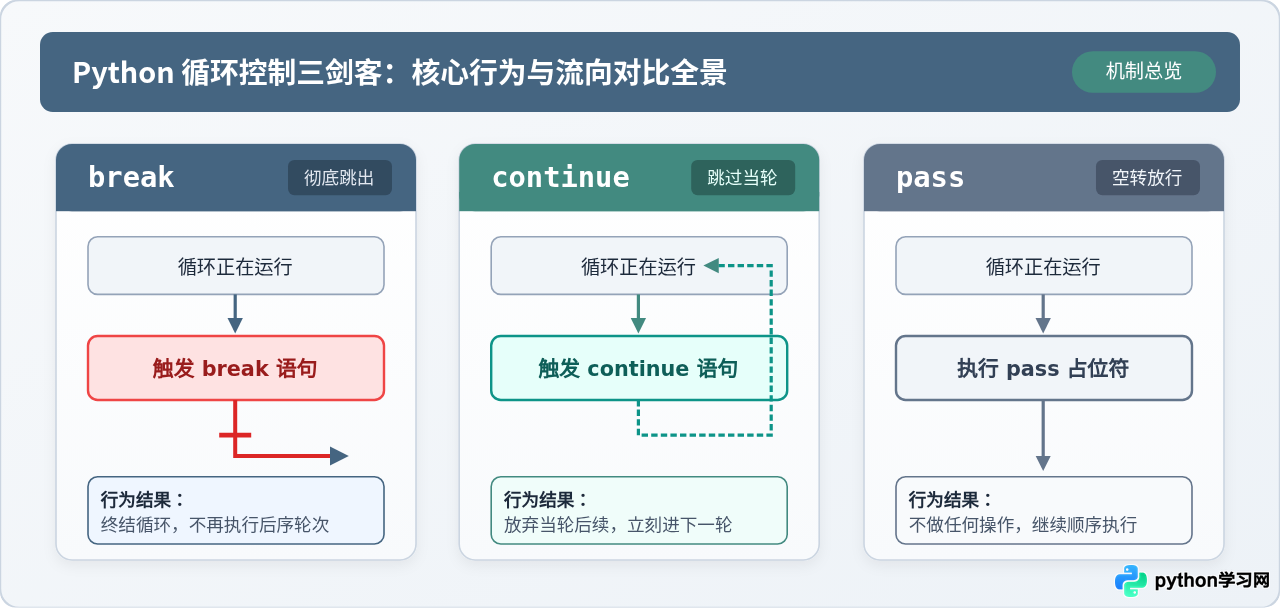
break、continue 和 pass 是三个使用频率极高但设计目的完全不同的关键字:break 用于彻底终结并跳出整个循环;continue 用于提前放弃当前这一轮迭代的后续指令,立即开启下一轮迭代;而 pass 是一个纯粹的空操作占位符,它既不跳出循环也不跳过任何代码,仅用来保证缩进语法的合法性。
一、break:立即终止并脱离整个循环
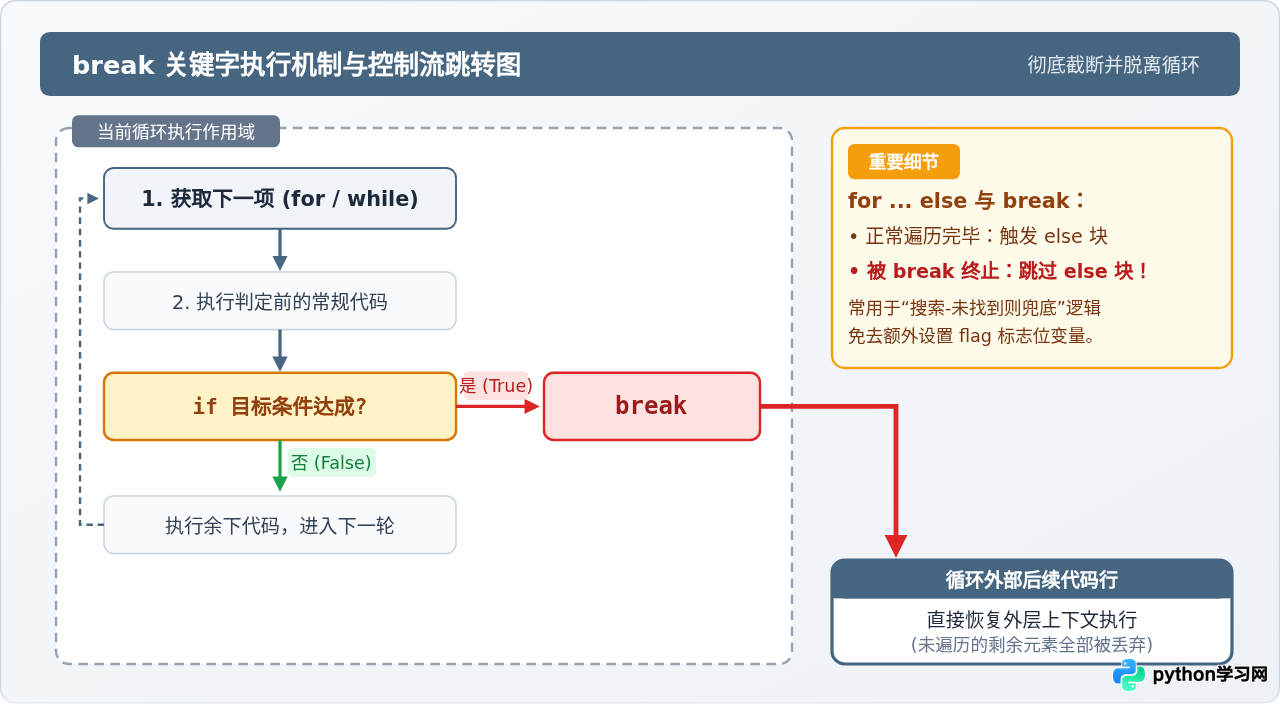
当程序在 for 或 while 循环体内遇到 break 语句时,Python 解释器会立即中断当前正在执行的循环结构。无论迭代器中是否还有未处理的元素,也无论 while 的条件表达式是否仍为 True,程序都将立即跳出循环体,从紧接着循环块之后的第一行代码继续向下执行。
1. 完整代码示例
下面的示例在遍历数字列表时,一旦遇到目标数值 3,便触发 break:
numbers = [1, 2, 3, 4, 5]

for num in numbers:
    if num == 3:
        print(f"[break 触发] 找到目标数值 {num},提前终止循环")
        break
    print(f"处理当前元素: {num}")

print("循环完全结束,恢复执行外层后续代码")处理当前元素: 2
[break 触发] 找到目标数值 3,提前终止循环
循环完全结束,恢复执行外层后续代码
从输出结果可以看出,当 num 等于 3 时触发 break,不仅当轮后方的 print(f"处理当前元素: 3") 未被执行,列表中剩余的 4 和 5 也被直接忽略,循环彻底中止。
2. break 对 for...else 结构的特殊影响
Python 为循环提供了独特的 else 子句。很多人容易将它与 if...else 混淆。在循环结构中,else 块的执行条件是:循环正常遍历完毕,未曾被 break 意外终止。
如果循环因为遇到 break 而强制退出,那么循环关联的 else 块将被完全跳过。这个特性极其适合编写“在列表中查找指定目标,如果未找到则执行保底操作”的业务逻辑,无需手动维护外部布尔标记位(flag)。
target = 9
data_list = [2, 4, 6, 8]

for item in data_list:
    if item == target:
        print(f"找到目标: {item}")
        break
else:
    # 仅当 for 循环完整走完且未触发 break 时执行
print(f"未在数据源中检索到目标元素 {target}")二、continue:跳过当前轮次,立即启动下一轮
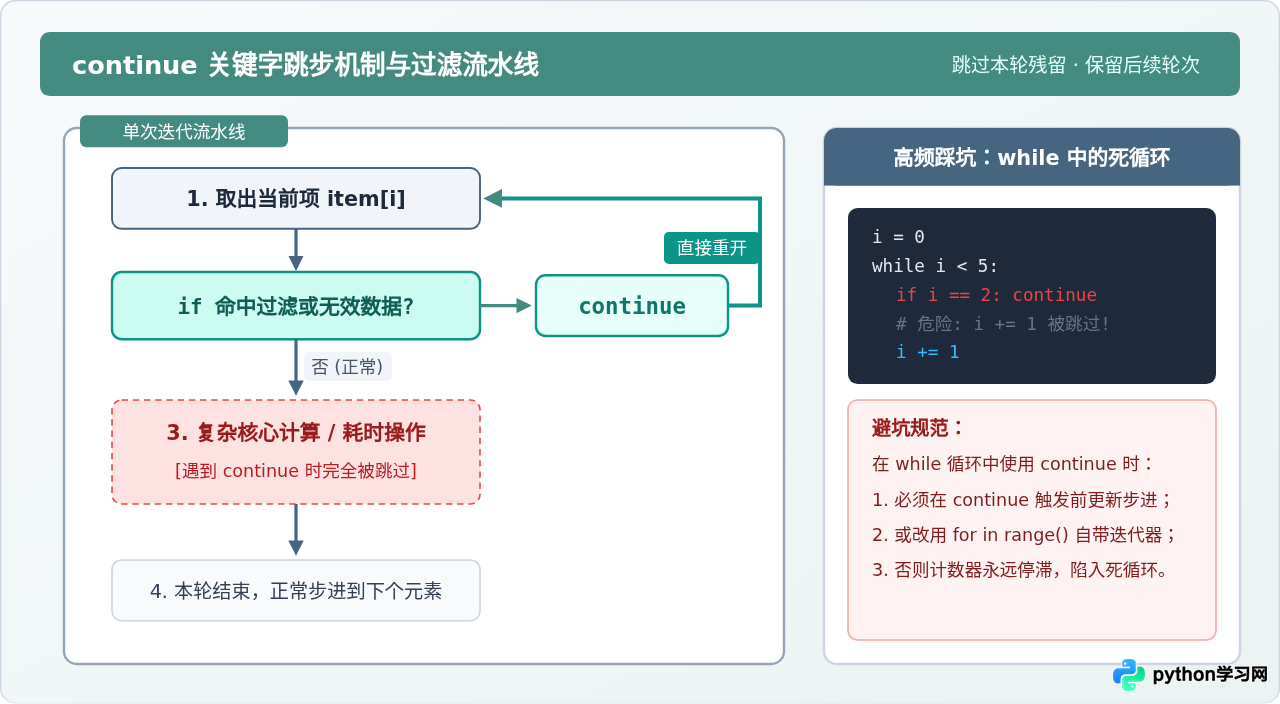
与 break 彻底摧毁整个循环不同,continue 的作用范围仅局限于当前这一次迭代。一旦触发 continue,解释器会立即丢弃当前轮次中排在它后面的所有未执行语句,直接跳回到循环头部,提取下一个元素(在 for 中)或重新评估条件(在 while 中),继续进行后续轮次的遍历。
1. 完整代码示例
下面的示例在处理数字序列时,使用 continue 过滤掉所有的偶数,只对奇数执行实际计算:
records = [1, 2, 3, 4, 5]

for item in records:
    if item % 2 == 0:
        print(f"[continue 跳步] 忽略偶数: {item}")
        continue
    # 遇到 continue 后,下方逻辑在当前轮次被跳过
    result = item * 10
    print(f"核心处理完成: 奇数 {item} -> {result}")

print("全部数据遍历完毕")[continue 跳步] 忽略偶数: 2
核心处理完成: 奇数 3 -> 30
[continue 跳步] 忽略偶数: 4
核心处理完成: 奇数 5 -> 50
全部数据遍历完毕
2. continue 在 while 循环中的高频陷阱
while 循环中使用 continue 时,务必将递增计数器(例如 index += 1)放置在 continue 之前,或者使用 try...finally 保证计数步进执行。如果步进语句写在 continue 下方,当条件命中时步进被跳过,循环变量将永远得不到更新,导致程序死循环。
# 规范写法:步进语句在 continue 判定前执行,防止卡死
count = 0
while count < 5:
    count += 1
    if count == 3:
        print(f"[跳过] 达到特殊值 {count}")
        continue
print(f"正常输出: {count}")正常输出: 2
[跳过] 达到特殊值 3
正常输出: 4
正常输出: 5
三、pass:纯粹的空操作与语法占位符
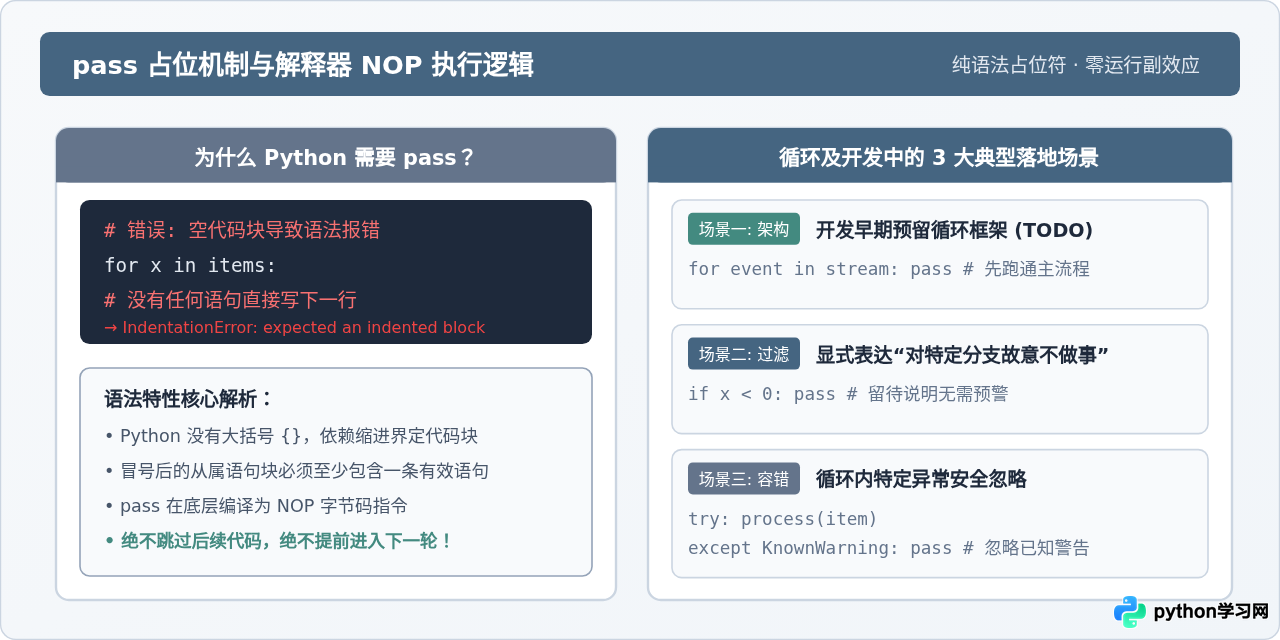
Python 使用严格的缩进规则界定代码块,而不使用大括号 {}。语法规定,任何冒号 : 之后的从属代码块(如函数定义、类定义、条件分支、循环体)必须包含至少一行有效语句。如果你在语法上需要一个代码块,但当前不需要执行任何操作,直接留空会导致解释器抛出 IndentationError: expected an indented block。
pass 就是为此而生的空操作(No Operation,NOP)语句。当 Python 解释器执行到 pass 时,什么动作也不会发生,程序直接顺畅地流向下一行代码。它不会跳出循环,也不会跳过当轮后续代码。
1. pass 与 continue 的行为对比
初学者最容易将 pass 与 continue 混淆。通过下面的对比可以直观看到它们的差别:
print("--- 执行 pass 的分支 ---")
for x in [1, 2]:
    if x == 1:
        pass  # 仅占位,下一行依然会顺序执行
    print(f"x 的当前值为: {x}")

print("\n--- 执行 continue 的分支 ---")
for y in [1, 2]:
    if y == 1:
        continue  # 跳过本轮,下一行被跳过
print(f"y 的当前值为: {y}")x 的当前值为: 1
x 的当前值为: 2
--- 执行 continue 的分支 ---
y 的当前值为: 2
2. pass 在日常开发中的三种标准用途
- 预留代码框架与接口设计(TODO):在构建系统结构时,先搭好循环与分支骨架,后续逐步填充具体业务算法。
- 安全忽略特定异常:在循环处理不稳定数据时,捕获已知的次要异常并使用
pass静默跳过,避免整个任务中断崩溃。 - 显式标记分支意图:在多分支判定中,表明某些情况已知但故意不做处理,提高代码可读性与团队协作语义清晰度。
四、核心机制横向对比与关键差异
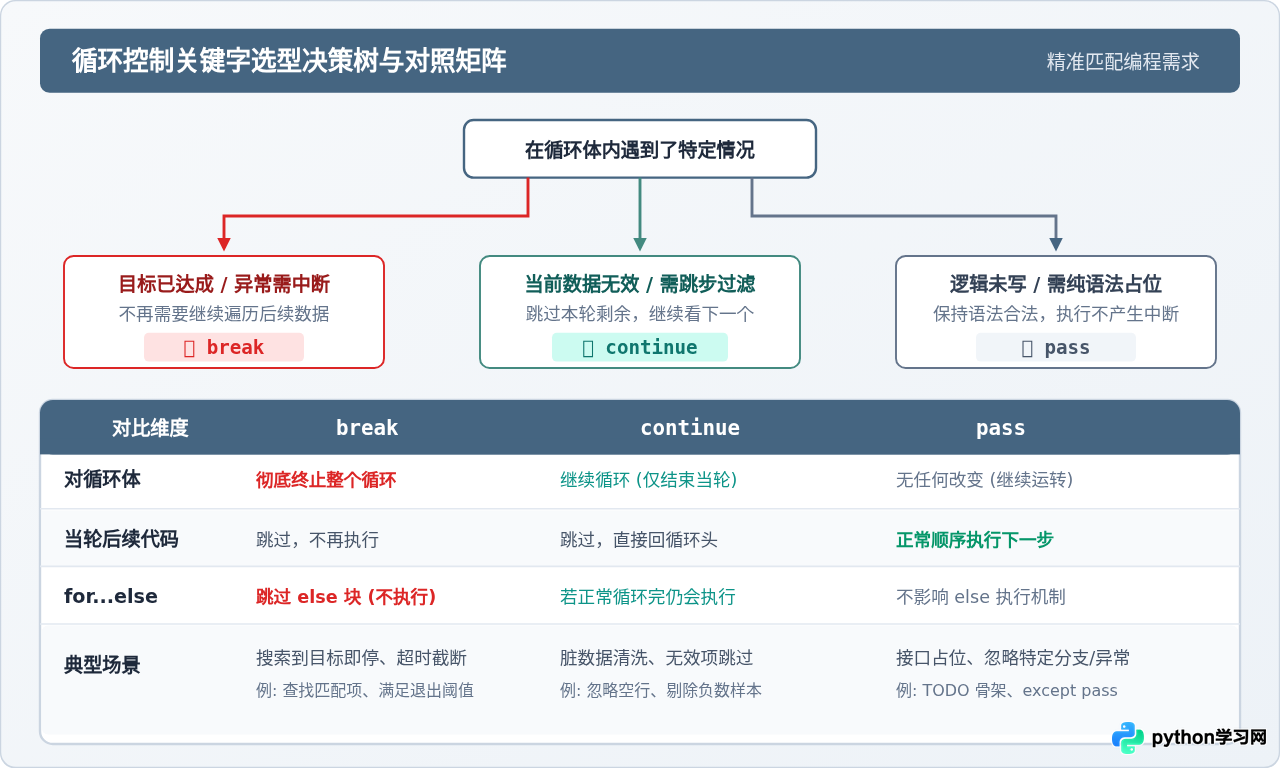
为了帮助读者建立清晰的记忆锚点,下表对 break、continue 与 pass 在循环执行时的核心特征进行了横向对比:
| 对比维度 | break | continue | pass |
|---|---|---|---|
| 核心动作 | 终结并跳出循环结构 | 终止当前轮,立即开启下一轮 | 什么都不做(空语句占位) |
| 对循环生命周期的影响 | 直接终止循环,剩余全部轮次作废 | 循环继续运行,仅单次迭代缩短 | 循环按原定节奏完整执行 |
| 本轮剩余代码是否执行 | 不执行(被跳过) | 不执行(被跳过) | 正常执行 |
| 对 for...else 块的影响 | 跳过 else 块,不执行 | 正常循环结束后依然会执行 else | 正常循环结束后依然会执行 else |
| 使用场景限制 | 只能在 for / while 循环中使用 |
只能在 for / while 循环中使用 |
可在循环、条件、函数、类等任意语法块中使用 |
五、进阶细节:嵌套循环中的作用范围
在多层嵌套循环中,break 和 continue 只对它们所在的那一层最内层循环生效,外层循环不会自动感知内层的跳出信号。
for group in ["A", "B"]:
    print(f"== 开始处理组 {group} ==")
    for item in [1, 2, 3]:
        if item == 2:
            print(f"  [内层 break] 组 {group} 在 item=2 处退出")
            break
print(f" 处理成员: {item}")处理成员: 1
[内层 break] 组 A 在 item=2 处退出
== 开始处理组 B ==
处理成员: 1
[内层 break] 组 B 在 item=2 处退出
从结果可见,虽然内层循环在处理到 2 时被 break 终止,但外层循环依然正常继续执行组 B 的处理。如果需要在多层循环中实现跨层级的彻底跳出,通常的做法是将双层循环封装为独立函数并通过 return 退出,或者在外层循环中设置标志位进行联动判断。
六、总结与选型指南
在实际编写 Python 循环逻辑时,三者的选择依据非常直观:
- 如果你已经找到了预期目标(如检索匹配项成功),或者检测到了需要立即叫停整个任务的致命条件,使用 break;
- 如果你当前读取到的数据属于脏数据、空白行或不需要计算的样本,需要将其快速掠过并紧接着处理下一条,使用 continue;
- 如果你只是因为 Python 的缩进语法要求填上一条合法语句,但逻辑上暂时不需要做任何处理,使用 pass。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















