


旧项目还在用Python 2?迁移到Python 3的必要性分析
深入分析旧项目继续停留在Python 2的潜在风险与迁移到Python 3的现实必要性,并提供清晰的评估维度与实战迁移路径。
一、认识现状:“能跑就别动”为何已经失效
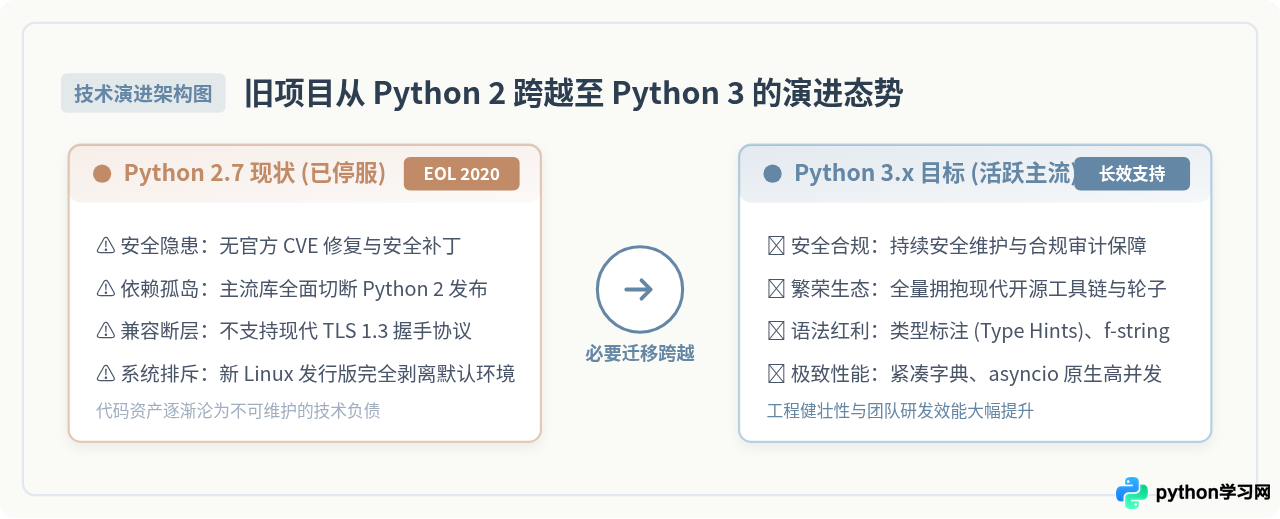
很多技术团队之所以保留 Python 2.7 旧系统,核心顾虑在于存量业务稳定、迁移周期难以预估以及可能引入未知的回归缺陷。然而,这种“被动静止”的策略正在迅速失去赖以生存的技术土壤。
Python 官方早在 2020 年 1 月 1 日正式终结了 Python 2 的生命周期(End-of-Life, EOL)。EOL 并非单纯的软件版本编号变更,它标志着官方开发团队彻底停止针对该语言分支提交任何代码修改、缺陷修复与安全补丁。
随着时间推移,现实环境发生了三项不可逆的变化:
- 底层操作系统已彻底放弃预装与兼容支持:Ubuntu 20.04 LTS 及更新版本、Debian 11+、RHEL 9 等现代 Linux 发行版,均已将
python2彻底移出默认系统包甚至官方软件源。这意味着为旧项目采购新服务器或升级节点时,甚至无法通过常规命令安装运行环境。 - 容器与基础镜像链条断裂:Docker Hub 上官方的 Python 2 基础镜像(如
python:2.7-slim)已停止维护数年,其内部捆绑的 Debian 宿主环境充斥着未修复的高危系统漏洞,安全扫描工具会直接阻断部署流水线。 - 网络通信与现代协议受阻:现代云服务、第三方开放平台与支付接口已强制升级至 TLS 1.3 及强加密套件,旧版 Python 2 底层绑定的 OpenSSL 无法完成握手通信,直接引发业务中断。
二、多维深度剖析:迁移到 Python 3 的四大必要性
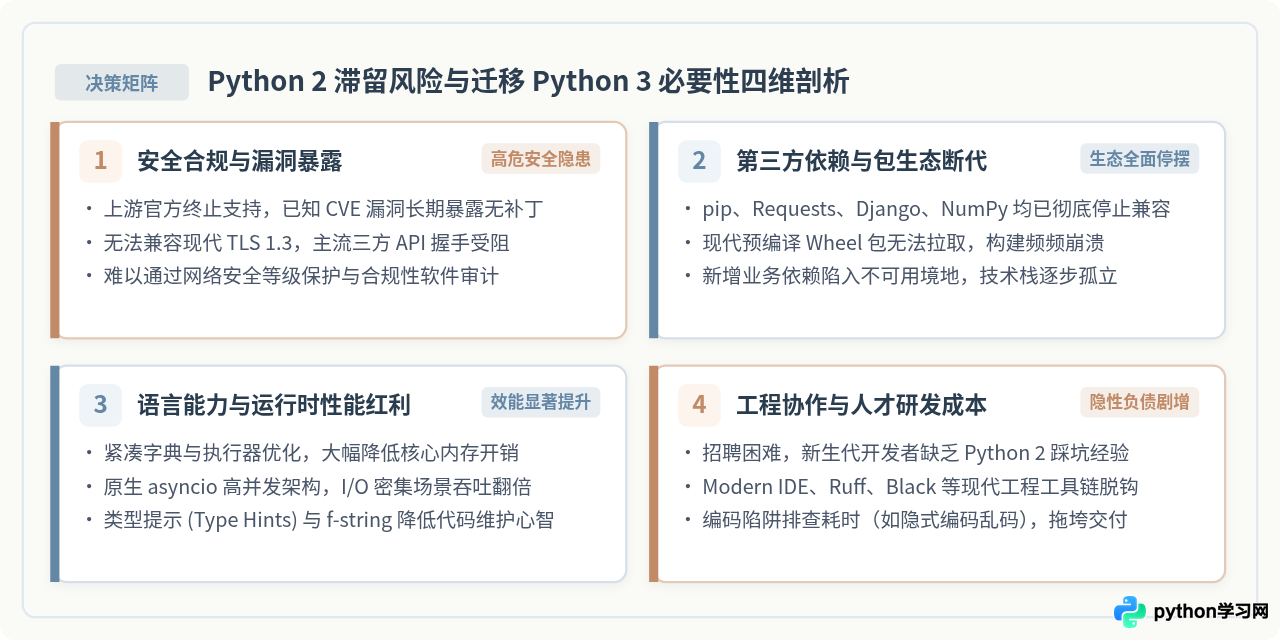
决定是否发起一项技术改造,取决于继续维持现状的风险代价与完成迁移后的综合收益对比。从工程实际出发,迁移至 Python 3 的必要性主要体现在以下四个关键维度:
1. 安全与合规红线(Security & Compliance)
安全漏洞一旦缺乏上游修复通道,系统就只能以“裸奔”状态接入生产网络。在 CPython 2.7 终结支持后,社区陆续发现了多起影响 urllib、ipaddress、hashlib 等核心库的安全缺陷(如 CVE-2021-3177 缓冲区溢出、CVE-2022-0391 等)。Python 3 均在第一时间完成了修复,而 Python 2 则永久保留了这些隐患。
对于受到网络安全等级保护(等保)、ISO 27001 或金融、医疗行业规范监管的企业,生产运行使用明确停止维护的底层组件会直接导致合规审计不达标,面临严重的合规与经营风险。
2. 第三方生态与包依赖彻底断代(Ecosystem Abandonment)
Python 最强大的优势在于极其繁荣的开源生态,但这个生态早已全面转向 Python 3:
- 包管理基础设施脱节:官方包管理器
pip从 21.0 版本起彻底移除了对 Python 2 的支持。若要在 Python 2 上构建依赖,只能锁定在老旧版本,经常遇到 index 协议不匹配、证书验证失败等问题。 - 主流核心库停止向后兼容:
requests、urllib3、cryptography、django、flask、numpy、pandas等关键基础库,其近几年的新功能、性能优化及安全修复均仅发布在 Python 3 分支。旧项目若需要对接外部新 API,往往会发现连官方 SDK 都不支持 Python 2。 - 二进制预编译包(Wheel)缺失:现代 C 扩展库使用新标准的 glibc 与编译工具链构建,无法在 Python 2.7 下找到预编译 wheel,迫使部署时触发源码编译,而源码编译又极易因编译器版本不匹配而崩溃。
3. 语言核心能力与运行时性能红利(Performance & Modern Syntax)
Python 3 绝非简单的“Python 2 语法补丁”,经过 3.6 至 3.12 多个版本的迭代,Python 3 在底层架构与开发体验上取得了质的飞跃:
- 内存与执行效率优化:自 Python 3.6 起引入的紧凑型字典实现(Compact Dict)减少了约 20%~30% 的内存占用;Python 3.11 及后续版本通过“更快的 Python”(Faster CPython)项目重构了解释器指令与自适应特化机制,执行效率相比 Python 2.7 提升了 30%~60%。
- 原生异步编程体系(asyncio):Python 3 提供了语言内置的
async/await关键字,在网络高并发与高频 I/O 交互场景下,单机处理吞吐量远超 Python 2 时代的旧式多线程或 Gevent 架构。 - 静态类型检查(Type Hints):Python 3 引入了原生的类型注解支持(PEP 484),配合
mypy等工具能够在代码运行前排查出大量隐蔽的类型错误,这对于逻辑复杂的大型旧项目是至关重要的质量保护屏障。 - 工程体验提升:清晰规范的
f-string(PEP 498)、路径处理利器pathlib、数据容器dataclasses等特性,显著减少了样板代码量。
4. 研发团队效能与协作壁垒(Engineering & Talent)
代码最终需要由工程师来维护。随着 Python 3 普及已超十年,绝大部分新生代开发者在学习与工作中均使用 Python 3,对 Python 2 的 unicode 编码陷阱、类继承老语法(经典类与新式类)缺乏直观认知,在维护旧项目时极易产生挫败感,增加排错耗时。
此外,现代研发工具链如代码格式化工具 Black、高性能 Linter Ruff、现代 IDE 插件等,已经全面抛弃对 Python 2 的语法解析,使旧项目无法享受现代代码规范与自动化审查带来的质量红利。
三、存量项目处置决策:维护隔离、平滑迁移还是彻底重写?
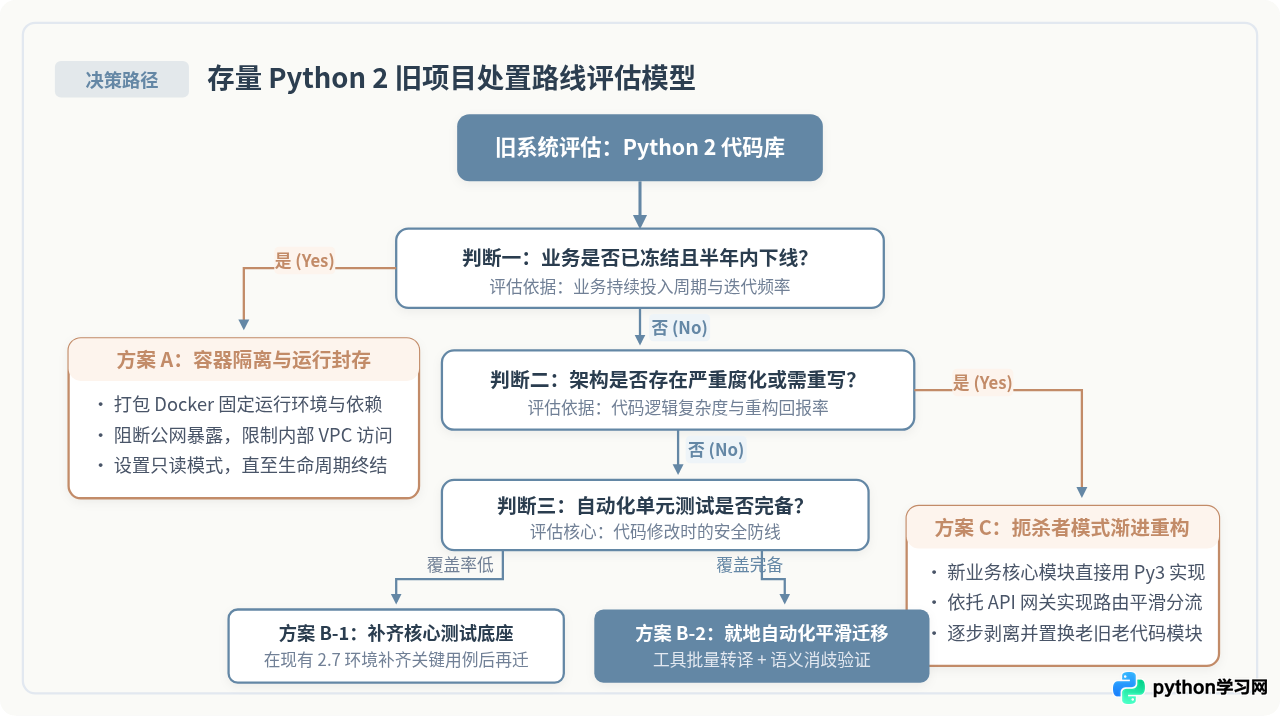
并非所有 Python 2 系统都需要立即投入巨大的人力进行逐行改写。面对遗留系统,应当根据业务生命周期、代码规模与测试覆盖度,选择针对性的处置策略:
具体评估标准与适用场景如下:
- 方案 A:容器隔离与运行封存(适用于即将退役系统)
若系统业务稳定、无任何新增迭代计划,且明确在 3~6 个月内伴随业务下线,可以采取“冷冻”处置:将现有 Python 2 环境与精确版本的依赖打包为固定 Docker 镜像,收敛至内网受控专有网络(VPC),切断外部不可信网络访问,禁止向公网暴露端口,直至生命周期自然终结。 - 方案 B:就地自动化平滑迁移(适用于绝大多数在役系统)
系统仍承担核心业务,但逻辑相对自洽、有基本的测试用例或清晰的业务验证手段。应当采用工程化工具实施平滑迁移,通过自动转译配合人工语义消歧,将运行环境升级至 Python 3。 - 方案 C:扼杀者模式渐进重构(适用于架构重度腐化系统)
如果旧项目不仅语言版本陈旧,还存在严重的高耦合、缺乏分层、核心业务变动频繁等技术债,直接逐行转译可能“继承”历史烂账。此时推荐采用“扼杀者模式”(Strangler Fig Pattern):新功能与新业务全部采用 Python 3 或全新技术栈独立开发,通过 API 网关按请求路由逐步蚕食、替换旧服务,直到旧模块全量下线。
四、实操指南:从 Python 2 到 Python 3 的五步落地流程
对于决定实施平滑迁移的项目,推荐遵循标准化的五阶段工程流水线,确保改造过程透明可控,避免陷入不可逆的代码混乱。
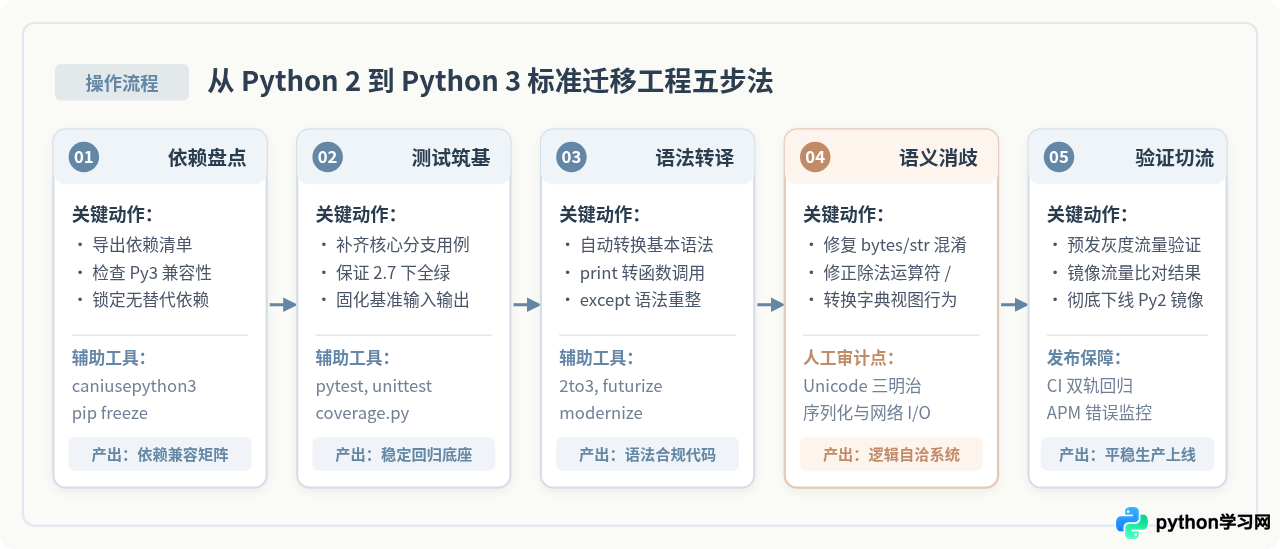
步骤 1:全量依赖与代码资产盘点
在动代码之前,首先要摸清第三方依赖的兼容性底数。在现有的 Python 2 虚拟环境中运行依赖扫描工具:
# 导出当前旧环境的精确依赖清单
pip freeze > requirements-py2.txt

# 使用 caniusepython3 工具检查哪些库阻碍了向 Python 3 的迁移
pip install caniusepython3
caniusepython3 -r requirements-py2.txt
该工具会输出阻碍迁移的包名及其依赖树。针对缺失 Python 3 版本的依赖,需在迁移启动前确定替代库(例如将旧的 MySQLdb 替换为 PyMySQL 或 mysqlclient)。
步骤 2:构筑自动化测试底座
自动化测试是语言版本迁移中最重要的“安全气囊”。如果一个系统没有单元测试就直接转译,将面临极高的生产崩溃概率。
做法是:先在 Python 2.7 现有环境下补齐核心路径的测试用例,确保测试集在 Python 2 下全部执行通过(全绿),并使用 coverage.py 记录覆盖率。这套测试用例将作为后续验证 Python 3 行为一致性的唯一基准。
步骤 3:工具辅助自动化语法升级
Python 提供了自动化语法转译工具,能够处理绝大多数机械式的语法变更(如 print 语句变函数、except Exception, e 变 except Exception as e)。
常用的转译工具为标准库自带的 2to3,或支持生成兼容代码的 futurize:
# 仅预览修改 diff,不实际改动文件
2to3 -d my_project/

# 确认无误后执行就地转换并自动备份旧文件
2to3 -w my_project/
步骤 4:核心语义差异与排错治理
自动化工具只能解决显式的语法转换,无法识别运行时的隐式语义逻辑。这一步是迁移中最核心的环节,必须由开发者重点关注以下高危陷阱:
- 字符串与字节(最为致命):在 Python 2 中,
str既可以表示文本又可以表示二进制字节,二者混用时会自动进行 ASCII 编解码。但在 Python 3 中,str严格为 Unicode 文本,bytes严格为二进制流,二者直接拼接(如b"abc" + "def")会立即抛出TypeError。
解决策略:遵循“Unicode 三明治”(Unicode Sandwich)模型:所有外部输入(文件、网络 socket、数据库、API)在进入程序边界时立即.decode('utf-8')转为纯str;业务逻辑内部全部使用str处理;在输出到外部介质前统一.encode('utf-8')。 - 除法运算符行为改变:Python 2 中
5 / 2的结果为2(向下截断整数),而 Python 3 中5 / 2的结果为2.5(浮点真除法)。如果业务代码依赖整数除法(如计算分页偏移量、像素坐标),必须显式改写为向下整除运算符5 // 2。 - 字典视图与迭代器:在 Python 2 中,
d.keys()返回真实的list列表对象;而在 Python 3 中返回的是dict_keys动态视图。如果在迭代字典的同时修改字典,或需要使用下标切片(如d.keys()[0]),在 Python 3 中会直接报错。需要写为list(d.keys())[0]。
步骤 5:环境验证、双轨回归与正式切流
完成代码调整后,在 Python 3 虚拟环境中安装更新后的依赖,运行步骤 2 中准备的测试套件。修复所有断言失败后,建议采用“流量镜像”或灰度发布的方式,在预发环境比对新旧系统的接口响应报文,确认数据完全一致后,方可完成正式生产切换。
五、迁移避坑速查表与核心总结
为了帮助工程师在转译与审查代码时快速排查问题,下表汇总了 Python 2 与 Python 3 中最容易引发隐蔽缺陷的关键特性差异与应对策略:
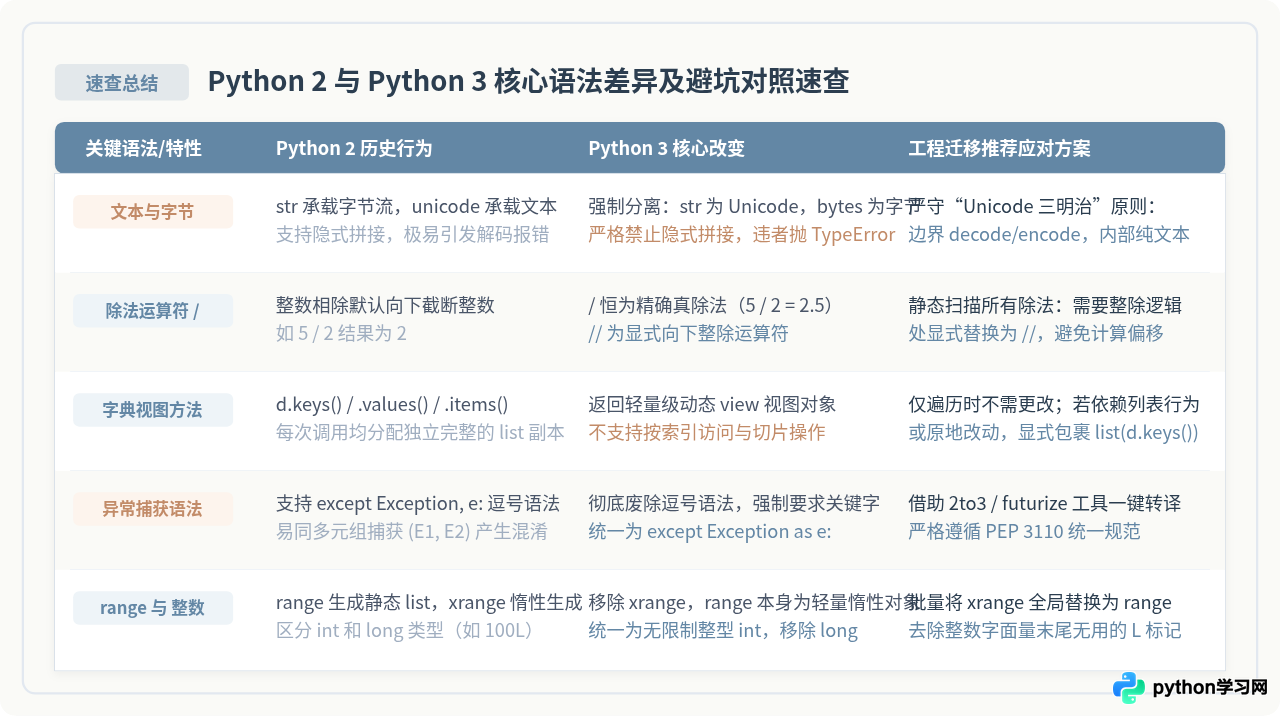
bytes 与 str 的误用。切勿使用 # -*- coding: utf-8 -*- 配合 sys.setdefaultencoding('utf-8') 这种 Python 2 时代的“黑魔法”,必须在数据流边界显式做好编码与解码。
结语:将技术负债转化为技术红利
从 Python 2 迁移到 Python 3,表面上是一次语言版本的被动升级,实质上是一次梳理历史资产、构筑测试防护网、清理过期技术债的重要契机。通过明确的处置决策(退役封存、平滑迁移或扼杀重写)和扎实的五步工程流程,旧项目不仅能彻底消除安全停服的潜在隐患,更能充分享受现代 Python 在性能、类型安全与云原生生态上的充沛红利,为业务的持续健康演进筑牢技术基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















