


Python 2和Python 3的核心语法区别有哪些
全面解析Python 2与Python 3在输出语句、字符串与编码模型、除法运算规则、迭代器与列表生成、异常捕获语法及类型比较等方面的核心语法差异与迁移实践。
一、输出语句:从关键字语句到内置函数
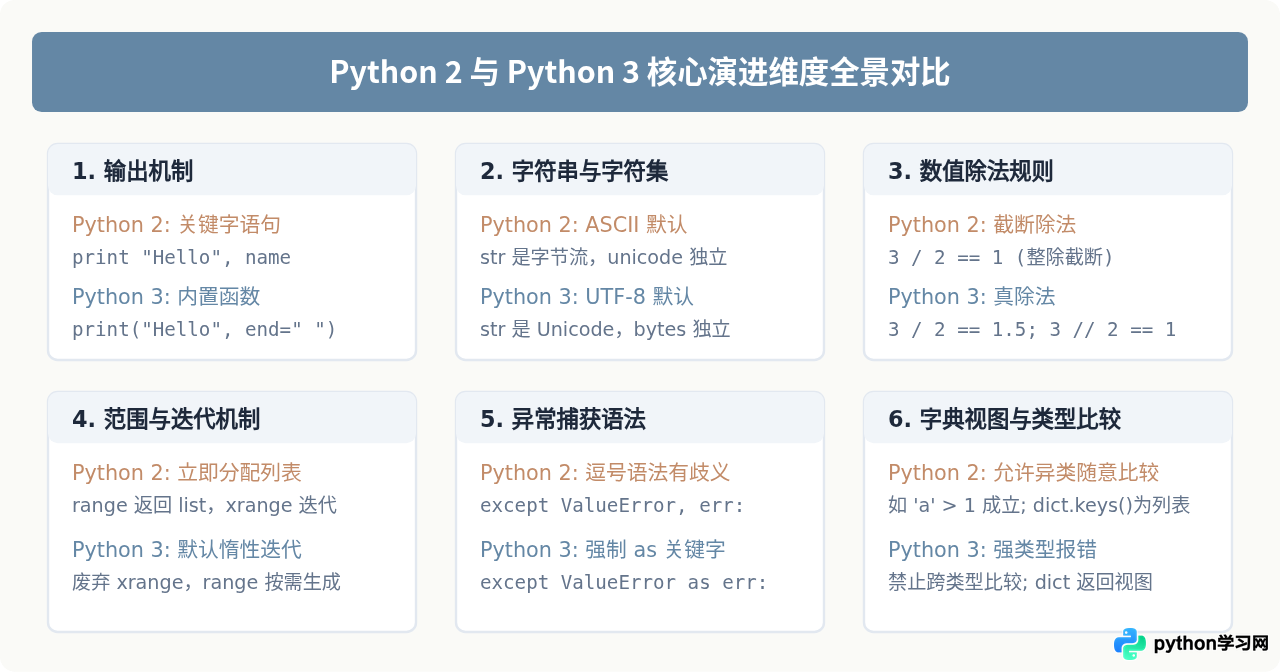
在 Python 2 中,print 是一个内置的保留关键字语句,语法结构为 print arg1, arg2。这种语法虽然在简短打印时看似便利,但存在扩展性差、重定向繁琐以及难以作为一等公民参数传递等问题。
在 Python 3 中,print 被统一设计为内置函数 print(*objects, sep=' ', end='\n', file=sys.stdout, flush=False)。若在 Python 3 中使用 Python 2 风格的不带括号写法,解析器会直接抛出 SyntaxError: Missing parentheses in call to 'print' 语法错误。
# 语句写法,以逗号结尾表示不换行
print "Item:", 42

# 重定向到文件(语法晦涩)
print >> sys.stderr, "Error occurred"

# 输出元组时易产生歧义
print ("apple", "banana") # 输出: ('apple', 'banana')# 必须使用函数括号调用
print("Item:", 42)
# 通过显式关键字参数定制行为
print("Loading", end=" ", flush=True)
print("Error occurred", file=sys.stderr)
# 解包输出元组内容
print(*("apple", "banana"), sep=" | ")二、字符编码与文本模型:str、unicode 与 bytes
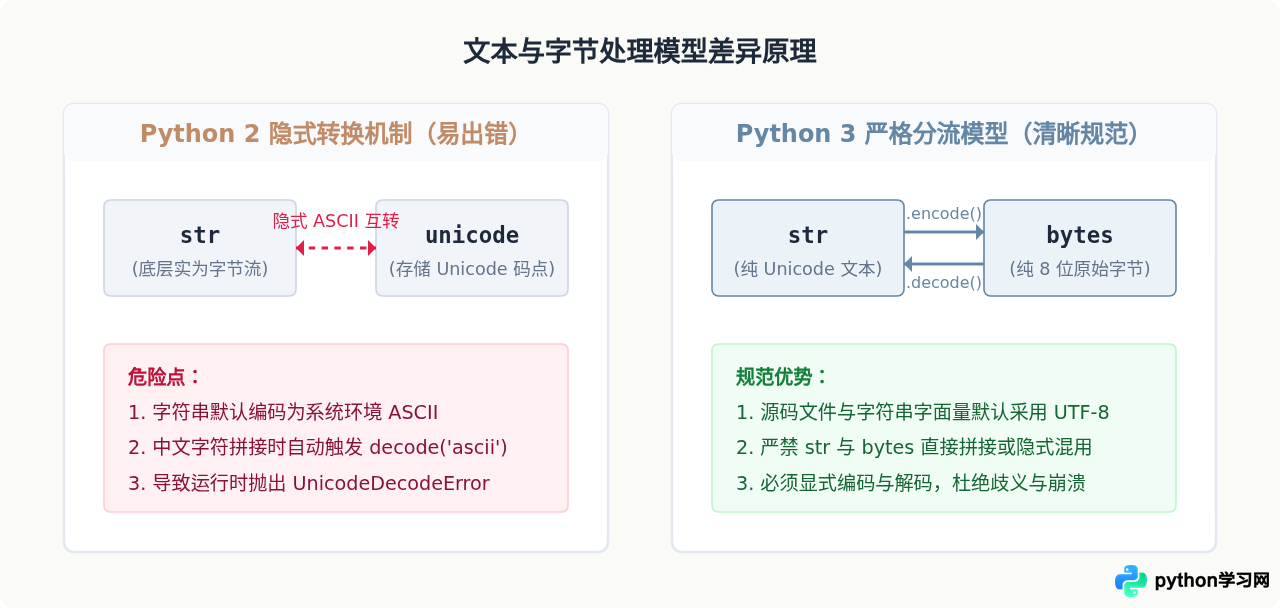
编码处理是 Python 2 中最常引发运行时崩溃的痛点之一。在 Python 2 中,默认字符串类型 str 实际上是 8 位的原始字节序列(Byte String),而专门的 Unicode 文本则需要使用 unicode 类型(字面量前加 u,如 u"中文")。当把普通 str 与 unicode 进行拼接或比较时,Python 2 会尝试使用默认的 ASCII 编码隐式解码 str,一旦内容包含非 ASCII 字符,就会抛出经典的 UnicodeDecodeError: 'ascii' codec can't decode byte... 异常。
Python 3 彻底重构了数据模型:去掉了 unicode 类型,将 str 统一为存储 Unicode 字符序列的文本类型;而所有二进制数据、字节流则由独立的 bytes 类型专门承担。文本与字节之间必须通过 str.encode() 和 bytes.decode() 显式转换,杜绝了隐式类型转换带来的隐患。
# Python 2 中类型情况
type("文本")       # 输出示例: <type 'str'> (字节序列)
type(u"文本")      # 输出示例: <type 'unicode'>

# 混合操作易报错
s = "中文"
u = u"测试"
# 在默认 ascii 编码下,下面这行会报 UnicodeDecodeError
# result = s + u# Python 3 严格分离类型
s = "文本" # 默认就是 Unicode 字符串
b = b"\xe6\x96\x87\xe6\x9c\xac" # 显式声明 bytes
type(s) # 输出示例: <class 'str'>
type(b) # 输出示例: <class 'bytes'>
# 显式转换:
b_encoded = s.encode("utf-8")
s_decoded = b.decode("utf-8")三、除法运算规则:经典截断与真正除法
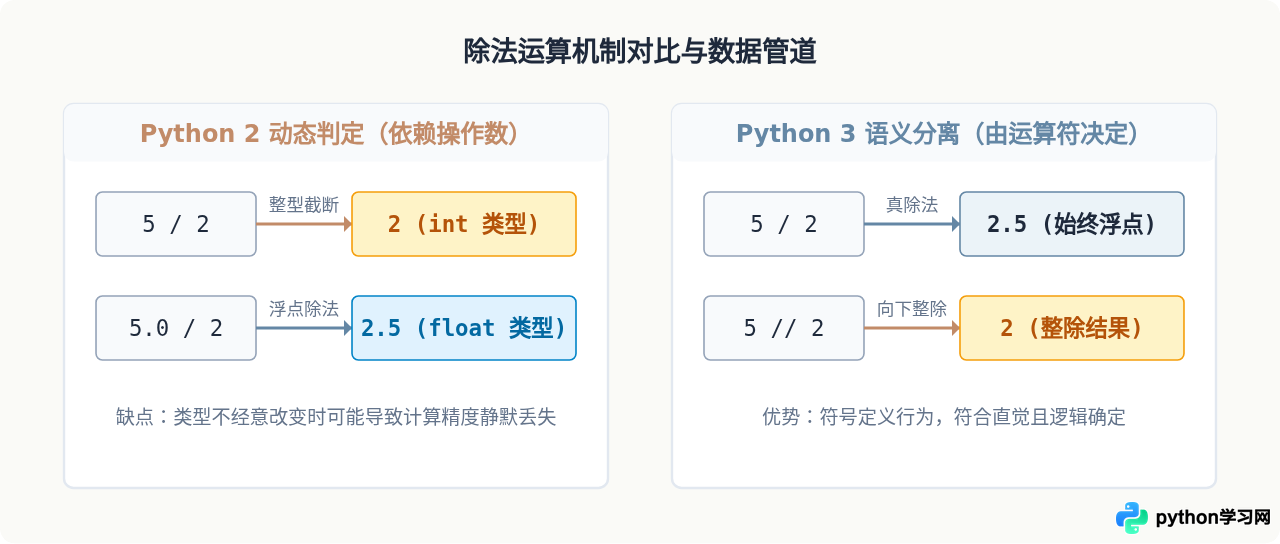
在 Python 2 中,除法运算符 / 的行为取决于操作数的类型:当两个操作数都为整数时,执行整除(Floor Division),结果直接舍弃小数部分向下取整;只有当至少一个操作数是浮点数时,才执行浮点除法。这一设计沿袭了 C 语言的习惯,但在实际业务中极易因遗漏类型强转而产生意料之外的数值截断。
Python 3 对除法运算符进行了清晰的分工:
- 真除法(True Division,
/):无论操作数是整数还是浮点数,运算结果始终为浮点数(如3 / 2结果为1.5)。 - 向下取整除法(Floor Division,
//):专门用于执行整除运算,保留向下取整的整数结果(如3 // 2结果为1)。
四、迭代生成与列表机制:range、xrange 与惰性求值
在涉及循环和范围生成时,Python 2 与 Python 3 在内存占用和返回对象形态上有本质差异:
- Python 2 的 range 与 xrange:在 Python 2 中,
range(n)会立即在内存中构建并返回一个包含从 0 到 n-1 所有元素的真实list。如果循环范围很大(例如range(100000000)),会瞬间消耗数 GB 的物理内存甚至引发内存溢出。因此 Python 2 额外提供了xrange()生成器对象,按需产生整数。 - Python 3 的统一部署:Python 3 移除了
xrange,并将原本的range改为一种不可变的、类似惰性序列的对象(返回range类型)。无论范围设置多大,它只记录起始值、终止值与步长,占用常数级别的极小内存。如果确实需要获取一个完整的列表,开发者必须显式包裹list(range(n))。
# 立即创建长度为 5 的真实列表
r = range(5)       # 结果: [0, 1, 2, 3, 4]
type(r)            # <type 'list'>

# 大范围循环必须使用 xrange
for i in xrange(1000000):
pass# 返回 range 序列对象,内存开销恒定
r = range(5) # 结果: range(0, 5)
type(r) # <class 'range'>
# 如需列表,必须显式转换
list_r = list(range(5)) # [0, 1, 2, 3, 4]
# xrange 已被移除,直接调用报错 NameError五、异常处理语法:逗号与 as 关键字
在 Python 2 中,捕获异常对象并赋值给局部变量支持两种写法:旧式的 except Exception, e 和较新引入的 except Exception as e。旧式的逗号语法极易导致歧义,例如初学者如果误写为 except TypeError, ValueError:,原本期望同时捕获两种异常,实际上却被解释器理解为“捕获 TypeError 并将其别名赋值为 ValueError”。
为了从根本上消除这种语法歧义,Python 3 完全移除了逗号绑定语法的支持,强制要求使用 as 关键字:
- 捕获单个异常并绑定变量:
except ValueError as e: - 捕获多个异常组合:
except (TypeError, ValueError) as e:(多个异常类必须显式置于元组中) - 此外,Python 3 中捕获的异常别名
e在退出except代码块后会被自动清理并删除,防止产生不必要的循环引用与内存泄漏。
六、字典视图与方法变更
在 Python 2 中,字典对象的 dict.keys()、dict.values() 和 dict.items() 均返回真实的列表副本。如果开发者希望避免生成列表副本以提升性能,必须改用 dict.iterkeys()、dict.itervalues() 和 dict.iteritems()。
在 Python 3 中:
- 移除了所有以
iter*开头的方法(如iteritems()触发AttributeError)。 - 传统的
keys()、values()、items()被改造成返回动态的字典视图对象(dict_keys,dict_values,dict_items)。视图对象直接映射字典本身的实时数据,支持动态迭代与集合运算,极大提升了内存使用效率。 - 移除了
dict.has_key(k)方法,统一使用k in dict运算符进行键存在性检查。
七、输入函数与类型比较机制
1. raw_input() 与 input()
在 Python 2 中,raw_input() 用于接收终端用户输入的原始字符串;而 input() 实际上等价于 eval(raw_input()),即直接对输入的字符串执行求值计算,这带来了严重的代码执行安全风险。Python 3 废弃了 raw_input(),并将 input() 的行为重定义为“始终返回用户输入的原始字符串”,彻底切断了输入引发的安全漏洞。
2. 异类对象的比较行为
在 Python 2 中,不同类型的数据之间允许使用 <、>、<=、>= 运算符进行直接比较。Python 2 会根据类型的内部名称等规则提供一个非确定的排序规则(例如表达式 'abc' > 123 在 Python 2 中返回 True)。这种设计掩盖了数据类型不匹配的逻辑 Bug。Python 3 严格禁止了无意义的跨类型大小比较,执行 'abc' > 123 会直接引发 TypeError: '>' not supported between instances of 'str' and 'int'。
| 特性 / 语法维度 | Python 2 | Python 3 | 迁移或适配建议 |
|---|---|---|---|
| 输出函数 print | 关键字语句:print "hi" |
内置函数:print("hi") |
全局替换为带括号函数调用 |
| 字符与编码类型 | str (字节流) 与 unicode |
str (Unicode) 与 bytes |
区分文本与二进制,显式 encode/decode |
| 真除法与整除 | 5 / 2 == 2 (整除截断) |
5 / 2 == 2.5,5 // 2 == 2 |
需整除时显式使用 // 运算符 |
| 整数循环序列 | range() (列表), xrange() (迭代) |
range() (惰性对象),无 xrange |
统一使用 range(),需列表时用 list() |
| 异常捕获语法 | except Error, e: 或 as e |
必须使用 except Error as e: |
移除逗号,多异常必须用元组包含 |
| 字典键值遍历 | items() 返回列表,有 iteritems() |
items() 返回视图,无 iteritems |
直接遍历 dict.items() |
| 用户终端输入 | raw_input() (字符), input() (eval) |
input() (统一返回字符) |
替换所有 raw_input() 为 input() |
| 异类数值比较 | 允许(如 '1' > 0 为 True) |
严格抛出 TypeError |
在比较前必须保证类型一致或显式转换 |
八、代码迁移与兼容改造步骤
如果手头存在需要从 Python 2 升级到 Python 3 的存量系统,建议按照以下四个标准化步骤逐步推进改造:
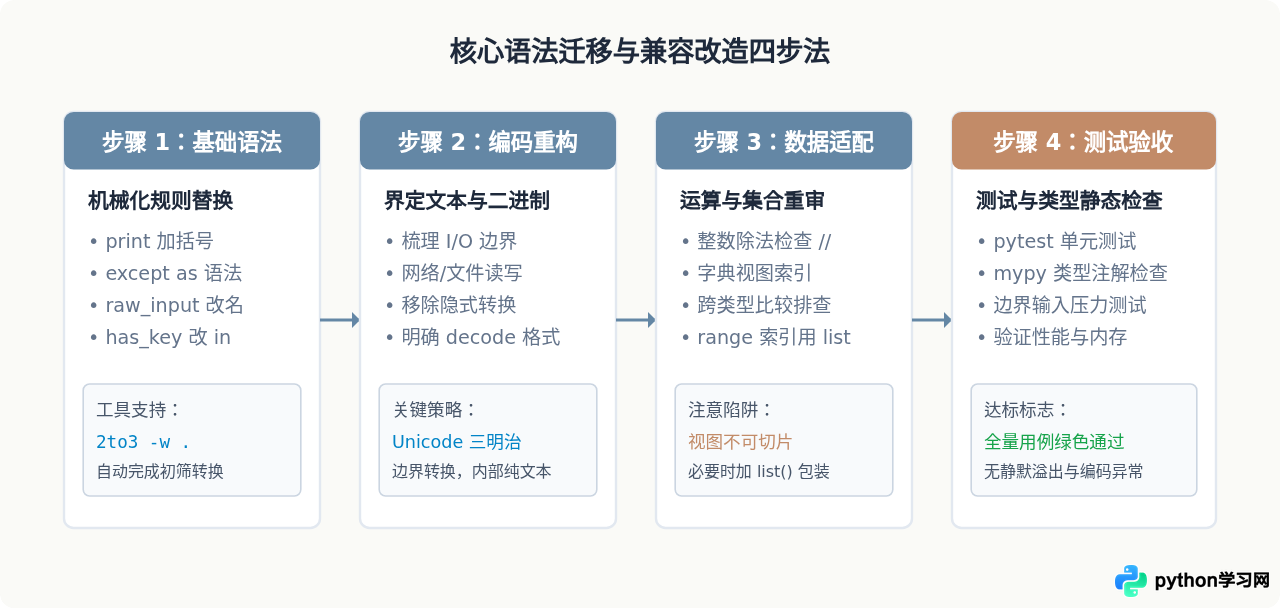
SyntaxError 的语法错误(因为它们在解析阶段就会暴露),而是运算语义层面的变化(如 5 / 2 变成浮点数破坏了数组下标索引或字典键计算,以及 dict.keys() 返回视图后被当作切片访问导致 TypeError)。务必在步骤 3 与步骤 4 中进行针对性的单元测试覆盖。
总结
综上所述,Python 3 的语法与设计演变围绕着明确性、一致性与安全性展开。通过将 print 规范为函数、将文本与二进制强行解耦、规范除法和比较规则、推行惰性求值等一系列改进,Python 语言从底层彻底清除了早期历史积累的隐式类型转换陷阱。理解这些核心语法区别,不仅是读懂老旧项目源码的必备技能,也是写出符合现代标准的高质量 Python 代码的坚实基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















