


除了标准库,Python还有哪些增强型第三方库值得安装?
深入解析 Python 核心增强型第三方库:HTTPX、Pydantic、Loguru、Rich、Pendulum 与 more-itertools。对比标准库短板,提供完整代码示例、迁移考量与选型决策指南。
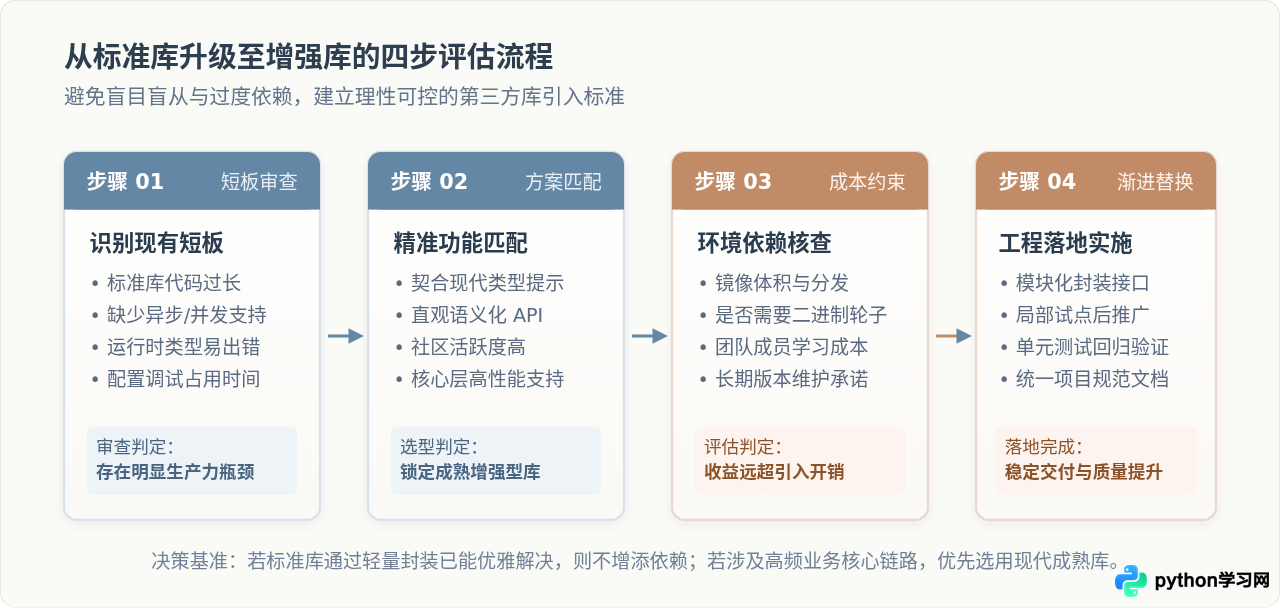
Python 标准库以“开箱即用、自带电池”(Batteries Included)著称,覆盖了文件处理、网络通信、并发、数学运算与常用数据结构等基础场景。然而在工程实践中,部分标准库模块因长期承诺向下兼容,其 API 逐渐显露出设计偏向底层、样板代码繁多以及缺少现代类型支持等局限。所谓“增强型第三方库”,并非颠覆标准库,而是在保留原有心智模型的前提下,针对高频工程短板进行现代化重构与体验升级。本文聚焦 5 个最核心的标准库短板领域,盘点直接对应且经过大规模生产验证的增强库,分析其相比标准库的核心优势与具体使用方案。
一、引入增强型第三方库的判断标准
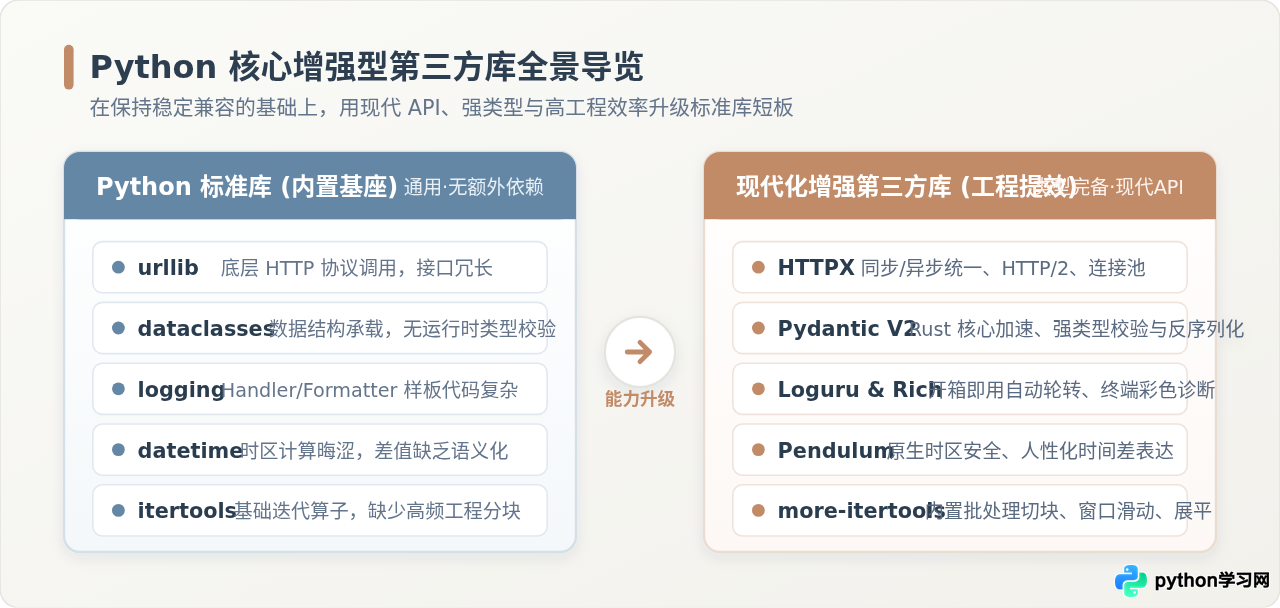
在决定为项目引入外部依赖之前,首要原则是衡量“引入成本”与“工程收益”。标准库的最大优势在于零分发成本与终身向后兼容;但在现代异步并发、数据边界校验、跨系统时间转换与高可观测性日志需求下,仅靠标准库往往需要开发者手写大量底层样板代码,不仅拖慢交付速度,还极易引入隐蔽缺陷。
通常情况下,当项目满足以下三个条件之一时,优先考虑引入增强库:一是标准库缺少现代语法支持(如无法原生适配 async/await);二是数据交换边界缺乏运行时强校验;三是基础组件配置流程过于冗长,严重侵占业务逻辑开发时间。
二、网络请求增强:从 urllib 到 HTTPX
在标准库中,网络请求由 urllib.request 与 http.client 提供。虽然能够完成最基础的 GET 或 POST 请求,但其 API 偏向协议底层,若要实现连接池复用、SSL 定制、Cookie 保持或自动超时控制,需要编写数十行包装代码。
过去很多开发者习惯使用 requests 替代 urllib。然而随着 Python 异步生态的普及,requests 不支持 asyncio 且无 HTTP/2 支持的短板日益凸显。HTTPX 正是当前最理想的增强方案:它不仅提供了与 requests 几乎完全一致的直观同步 API,还内建了原生的异步客户端 AsyncClient 和 HTTP/2 协议支持。
代码对比:urllib 与 HTTPX 的调用体验
以下展示使用标准库 urllib 发起带超时与 JSON 解析请求,与使用 httpx 的写法差异:
# 标准库 urllib 方式
import json
import urllib.request
import urllib.error

url = "https://httpbin.org/post"
payload = json.dumps({"module": "urllib"}).encode("utf-8")
headers = {"Content-Type": "application/json; charset=utf-8"}

req = urllib.request.Request(url, data=payload, headers=headers, method="POST")
try:
    with urllib.request.urlopen(req, timeout=5.0) as response:
        status_code = response.status
        raw_body = response.read().decode("utf-8")
        data = json.loads(raw_body)
        print("urllib 响应状态:", status_code)
except urllib.error.URLError as exc:
    print("请求失败:", exc)
换用 httpx 后,无论是连接池管理还是 JSON 编解码均封装为一行调用:
# 增强库 httpx 同步请求方式
import httpx

with httpx.Client(timeout=5.0) as client:
    response = client.post("https://httpbin.org/post", json={"module": "httpx"})
    print("httpx 响应状态:", response.status_code)
    data = response.json()
在异步并发场景中,HTTPX 更是展现出标准库所不具备的原生优势:
# 增强库 httpx 异步并发请求
import asyncio
import httpx

async def fetch_item(client: httpx.AsyncClient, item_id: int):
    url = f"https://httpbin.org/get?id={item_id}"
    resp = await client.get(url)
    return resp.json()["args"]

async def main():
    async with httpx.AsyncClient(timeout=10.0, http2=True) as client:
        tasks = [fetch_item(client, i) for i in range(3)]
        results = await asyncio.gather(*tasks)
        print("并发抓取结果:", results)

asyncio.run(main())
# 示例输出(标准终端执行输出):
# httpx 响应状态: 200
# 并发抓取结果: [{'id': '0'}, {'id': '1'}, {'id': '2'}]httpx.get() 顶级函数,这会导致频繁创建和销毁底层 TCP 连接。应当始终通过 with httpx.Client() 或长生命周期的 AsyncClient 维持连接池以复用连接。
三、数据模型与校验增强:从 dataclasses 到 Pydantic
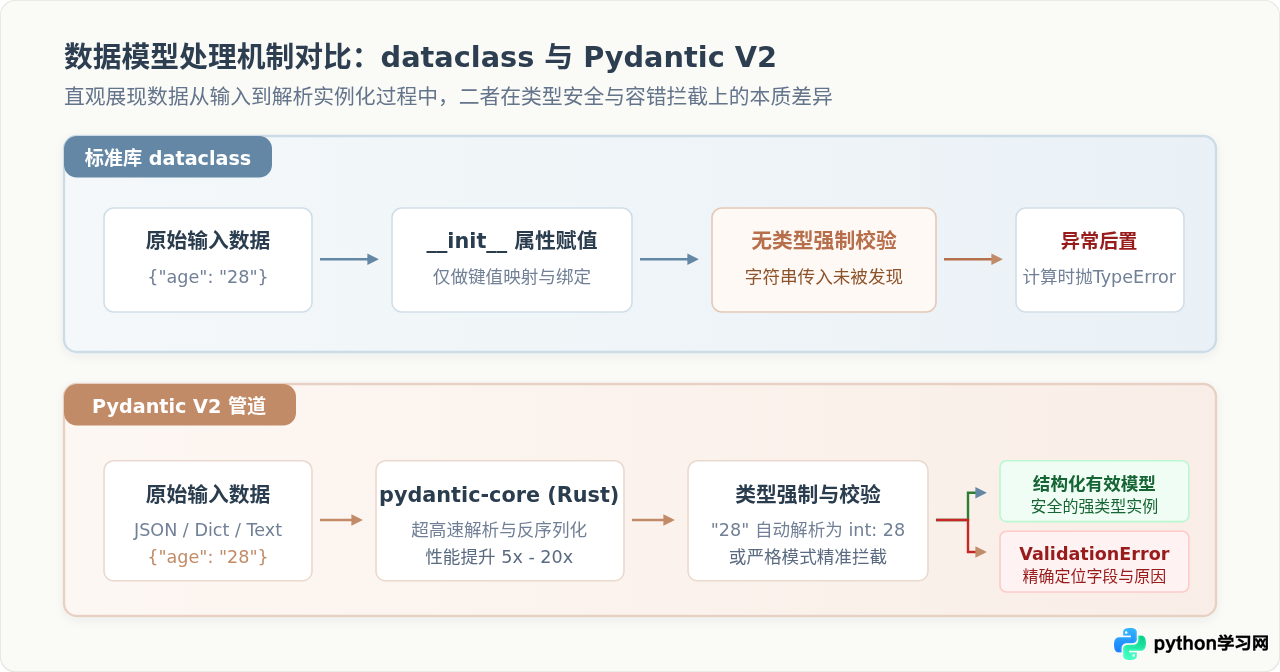
Python 3.7 引入的标准库 dataclasses 大大简化了纯数据类的 __init__、__repr__ 和 __eq__ 的编写。但在与外部接口、数据库、配置文件交互时,dataclasses 仅承担属性容器角色,并不提供任何运行时类型检查。如果将字符串赋值给声明为 int 的字段,dataclasses 会静默接受,将类型错误遗留到深层运算逻辑中。
Pydantic(特别是以 Rust 重写底层核心引擎的 V2 版本)为数据模型提供了强大的运行时保障。它不仅能进行严格的类型断言,还能根据类型提示自动执行合理的数据转换(Coercion),并在数据格式异常时提供清晰明了的错误追踪定位。
代码对比:运行时类型容错与校验
通过以下代码可以清晰观察到二者的行为边界:
# 1. 标准库 dataclass 的行为:静默放行错误类型
from dataclasses import dataclass

@dataclass
class UserData:
    user_id: int
    name: str

# 传入错误类型的字符串 "1001",dataclass 不做任何校验
u1 = UserData(user_id="1001", name="Alice")
print("dataclass 实例属性类型:", type(u1.user_id))  # 此时仍然是
# 2. Pydantic V2 的行为:自动类型转换与强类型边界保护
from pydantic import BaseModel, Field, ValidationError
class UserModel(BaseModel):
user_id: int = Field(gt=0, description="必须为正整数用户ID")
name: str
email: str | None = None
# 合法输入测试(自动将安全字符串转为整型)
u2 = UserModel(user_id="1001", name="Bob")
print("Pydantic 解析后属性类型:", type(u2.user_id), "值:", u2.user_id)
# 脏数据输入测试
try:
UserModel(user_id=-5, name="Charlie")
except ValidationError as exc:
print("捕获校验错误:
", exc)# 示例输出:
# dataclass 实例属性类型: <class 'str'>
# Pydantic 解析后属性类型: <class 'int'> 值: 1001
# 捕获校验错误:
# 1 validation error for UserModel
# user_id
# Input should be greater than 0 [type=greater_than, input_value=-5, input_type=int]此外,Pydantic 派生的 pydantic-settings 更是替代标准库 os.environ 手动读取配置的利器,能够自动从 .env 文件和系统环境变量中映射并强校验配置项。
四、日志与终端可观测性增强:从 logging/print 到 Loguru 与 Rich
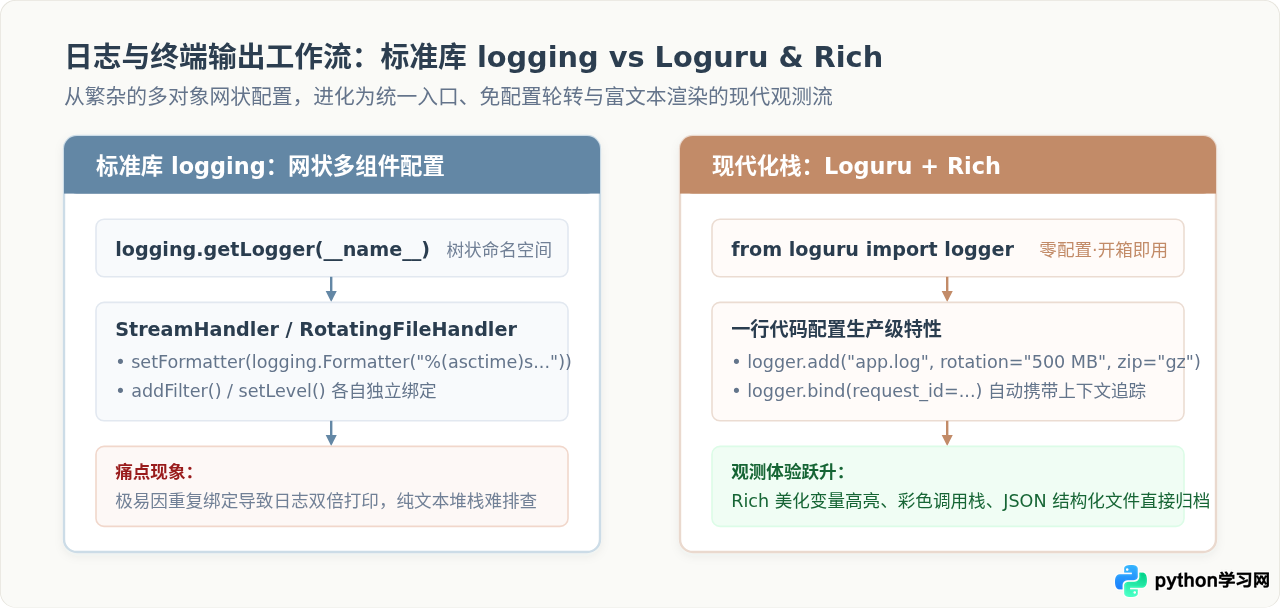
Python 标准库的 logging 模块设计极其经典,但其采用的 Java 风格多组件模型(Logger、Handler、Filter、Formatter 相互组合)让新手极易踩坑。例如在多个模块中重复调用 addHandler 导致日志内容双倍输出,或者因为 Root Logger 配置覆盖导致三方库日志淹没终端。
Loguru 与 Rich 是重塑 Python 观测体验的黄金搭档:
- Loguru:推崇“单一入口”哲学,直接
from loguru import logger即可开始记录。无需复杂的 Handler 继承,一行logger.add()即可搞定日志文件按大小轮转、过期自动清理、压缩打包以及结构化 JSON 导出。 - Rich:不仅让普通的终端输出拥有丰富的色彩、表格排版与进度条显示,还能接管 Python 的未捕获异常 Traceback,以语法高亮和局部变量视窗替代原本枯燥难读的纯文本堆栈。
代码示例:Loguru 的生产级日志配置与 Rich 美化
import sys
from loguru import logger
from rich.console import Console
from rich.table import Table

# 移除默认的输出处理器,配置格式与轮转规则
logger.remove()
logger.add(
    sys.stderr,
    format="<green>{time:YYYY-MM-DD HH:mm:ss}</green> | <level>{level: <8}</level> | <cyan>{name}</cyan>:<cyan>{line}</cyan> - <level>{message}</level>",
    level="INFO"
)
# 一行代码配置生产文件归档:单文件达 100MB 轮转,保留 10 天,自动 zip 压缩
logger.add("logs/service.log", rotation="100 MB", retention="10 days", compression="zip", level="DEBUG")

# 携带上下文的绑定日志
trace_logger = logger.bind(request_id="REQ-98214")
trace_logger.info("用户下单请求开始处理")

# 使用 Rich 打印结构化美观报表
console = Console()
table = Table(title="系统运行状态概览")
table.add_column("服务模块", style="cyan", no_wrap=True)
table.add_column("健康状态", style="magenta")
table.add_column("响应延迟", justify="right", style="green")

table.add_row("Auth Service", "HEALTHY", "12ms")
table.add_row("Payment Gateway", "HEALTHY", "45ms")
table.add_row("Search Index", "HEALTHY", "18ms")

console.print(table)logging.getLogger(__name__) 规范输出,避免在库内部直接对 Loguru 进行强制全局配置,以免影响最终宿主应用的日志体系。
五、日期与时区处理增强:从 datetime 到 Pendulum
虽然 Python 3.9 之后引入了 zoneinfo 模块,改善了以往对 pytz 的依赖,但标准库 datetime 对于日期计算的处理仍旧繁杂。例如,计算“两个日期相隔几个月几天”、格式化为“3小时前”这类的相对时间,或者在无时区(naive)与有时区(aware)对象混用时,极易引发难以排查的隐蔽异常。
Pendulum 是 datetime 的直接继承与超级增强库:它完全向下兼容内置 datetime.datetime 对象,同时默认强制时区安全,提供极其人性化的流式链式调用与语义化差值计算。
代码示例:时区计算与语义化时间差
import pendulum

# 声明带明确时区的时间对象(默认即有时区感知)
shanghai_time = pendulum.now("Asia/Shanghai")
tokyo_time = shanghai_time.in_timezone("Asia/Tokyo")

print("上海时间:", shanghai_time.to_datetime_string())
print("东京时间:", tokyo_time.to_datetime_string())

# 直观易懂的时间算术(自动处理跨月、闰年细节)
future_date = shanghai_time.add(months=1, days=5)
print("下月对应时间:", future_date.to_date_string())

# 人类友好的语义化时间差(支持中文语言包)
pendulum.set_locale("zh")
past_event = pendulum.now().subtract(minutes=45)
print("相对时间展示:", past_event.diff_for_humans())  # 输出: 45分钟前
# 示例输出:
# 上海时间: 2026-10-31 13:40:00
# 东京时间: 2026-10-31 14:40:00
# 下月对应时间: 2026-12-05
# 相对时间展示: 45分钟前六、迭代器与命令行高频辅助:more-itertools 与 Typer
除了上述重量级领域外,还有两个小巧却能显著消除重复劳动的增强库:
- more-itertools:标准库
itertools提供了chain、cycle、islice等基础算子,但在工程中,我们更频繁需要的是“按固定大小分批(chunked)”、“滑动窗口(windowed)”或者“深层嵌套展平(flatten)”。more-itertools补齐了这些高频工具,避免开发者每个项目重写一遍生成器逻辑。 - Typer:标准库的
argparse语法冗长繁琐,新增一个参数需要写多次parser.add_argument。Typer(FastAPI 的姊妹项目)利用 Python 现代类型注解(Type Hints),让编写 CLI 命令就像写普通函数一样自然,自动生成美观的帮助文档与参数类型校验。
代码示例:批处理切块与命令行声明
# more-itertools 批处理示例
from more_itertools import chunked, windowed

data = [1, 2, 3, 4, 5, 6, 7, 8, 9]

# 快速切块(常用于数据库批量插入或接口分页批请求)
for batch in chunked(data, 3):
    print("批次处理:", batch)

# 滑动窗口计算
for win in windowed(data, 3):
    print("窗口数据:", win)
# Typer 声明式 CLI 示例
import typer
app = typer.Typer()
@app.command()
def deploy(
service: str = typer.Argument(..., help="待部署的服务名称"),
replicas: int = typer.Option(3, "--replicas", "-r", help="副本实例数量"),
dry_run: bool = typer.Option(False, "--dry-run", help="演练模式,不实际生效")
):
typer.echo(f"正在发布服务 [{service}],副本数: {replicas},演练模式: {dry_run}")
if __name__ == "__main__":
app()七、核心增强库总结与全景矩阵
为了便于在项目技术选型时快速查阅,下表与总结图汇总了本文介绍的 5 个关键领域中,标准库与现代增强型第三方库的对应关系与选型决策维度:
| 能力领域 | 对应标准库 | 推荐增强库 | 核心升级亮点 | 适用场景 |
|---|---|---|---|---|
| 网络请求 | urllib |
HTTPX | 同步与异步统一、HTTP/2 支持、连接池安全管理 | 爬虫、微服务通信、FastAPI 并发 |
| 数据校验 | dataclasses |
Pydantic V2 | Rust 底层加速、运行时强校验、自动类型转换、配置管理 | Web API 参数解析、外部数据反序列化 |
| 日志观测 | logging / print |
Loguru + Rich | 零配置快速上手、自动轮转压缩、富文本美化与彩色堆栈 | 独立脚本、服务运维追踪、诊断排错 |
| 日期时区 | datetime |
Pendulum | 默认时区安全、语义化时间差、简明的流式时间运算 | 跨国业务时间换算、账期周期处理 |
| 迭代与CLI | itertools / argparse |
more-itertools / Typer | 高频分块与滑动窗口算子、基于类型提示的声明式命令行 | 批量入库流水线、自动化运维脚本工具 |
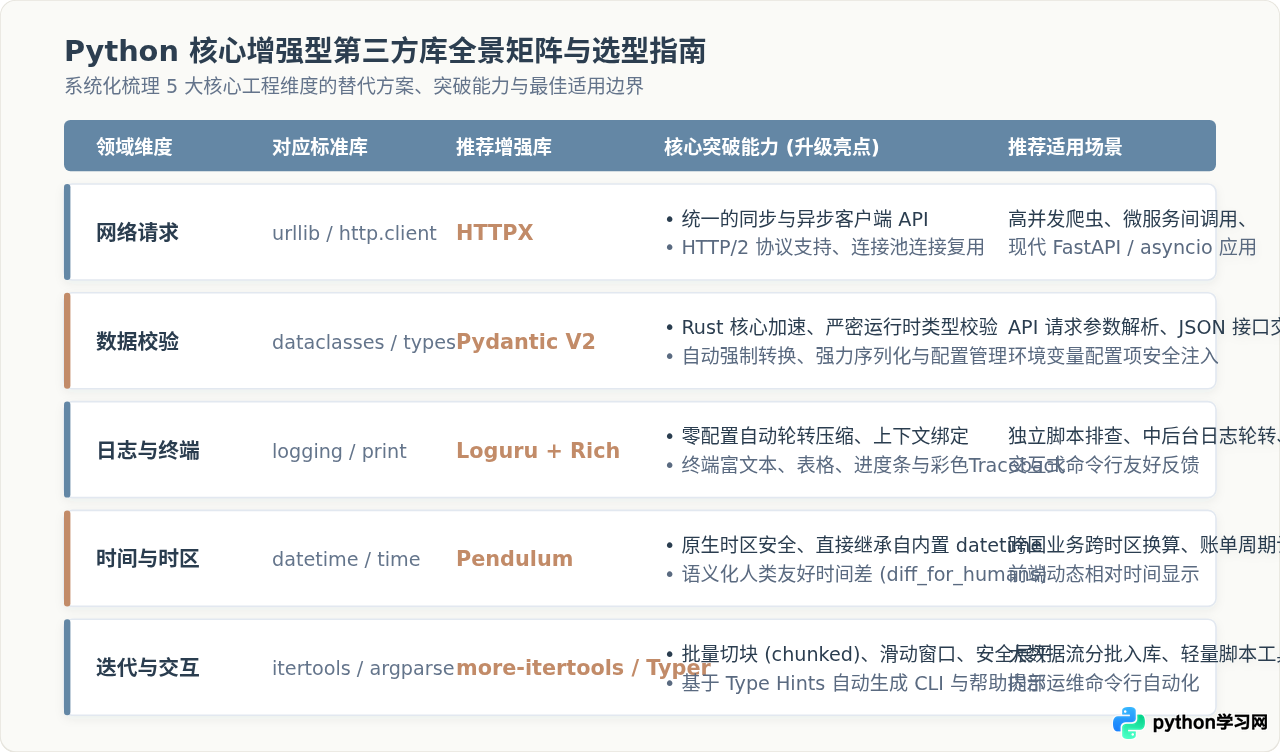
总结:Python 标准库为语言生态奠定了坚实的通用底座,但在具体的工程化生产环境中,合理且克制地引入经过社区检验的“增强型”第三方库,能够有效消除重复的底层样板代码,把类型错误拦截在开发与构建阶段,从而在保持代码优雅简洁的同时,大幅提升系统的可维护性与交付效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















