


为什么生产环境不建议使用Python中文变量名
深入解析Python 3支持非ASCII标识符背后的工程考量,从Unicode规范化、工具链兼容、序列化传输与可观测性等多个维度,剖析生产环境禁用中文变量名的核心原因与排查治理方案。
虽然自 Python 3.0 引入 PEP 3131 起,解释器已经在语法层面上全面支持以 Unicode 字符定义变量名、函数名与类名,但在工业级生产代码中,工程规范始终严厉禁止使用中文变量名。核心原因不在于 Python 解释器本身的执行能力,而在于现代软件工程所依赖的多平台协同、Unicode 规范化等价性处理、静态检查与重构工具链、以及底层跨语言通信和可观测性基础设施在处理非 ASCII 标识符时存在不可控的断层隐患。本文将从底层机制、工具生态、运行时风险及团队协作四个方面剖析其潜在代价,并给出规范的排查与迁移治理方案。
一、Unicode 规范化与等价性陷阱
中文变量名在 Python 内部并非单纯的不可变字节串,而是遵循 Unicode 字符标准处理。Unicode 标准定义了字符的不同表示形式,这直接引入了“视觉相同但底层编码不同”的等价性难题。
在不同操作系统与输入子系统中,字符串可能以不同的标准化形式存储。常见的两种标准是 NFC(Canonical Decomposition, followed by Canonical Composition,正规化聚合形式)与 NFD(Canonical Decomposition,正规化分解形式)。例如,在 macOS 文件系统或部分终端输入法中,带有组合注音或特定重音的字符常被处理为 NFD 形式;而在 Linux 生产服务器环境下,常规文本流普遍采用 NFC 形式。
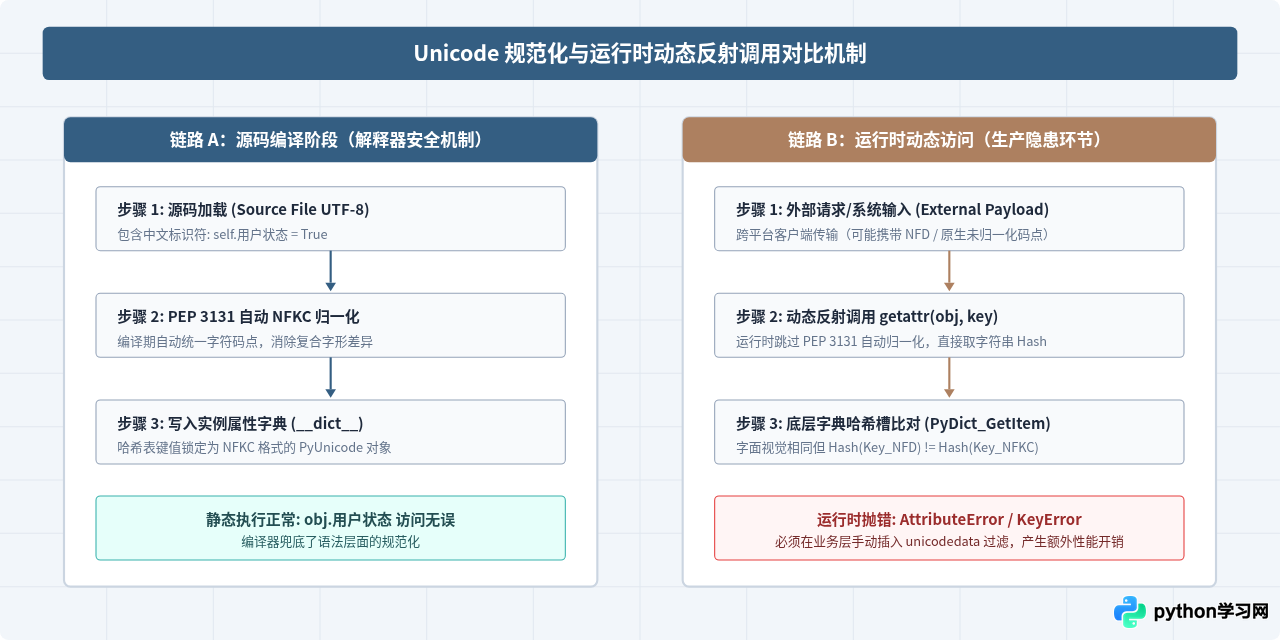
根据 PEP 3131 规定,Python 解析器在解析源码时会自动将标识符通过 unicodedata.normalize('NFKC', ...) 进行归一化。然而,当程序进入动态交互、反射调用或跨进程通信环节时,隐患便会暴露:
import unicodedata

# 模拟不同客户端传入的动态属性名
param_linux = "数据指标"
param_macos = unicodedata.normalize('NFD', param_linux)

class Model:
    def __init__(self):
        self.数据指标 = 100

obj = Model()

# 直接访问正常
print(getattr(obj, param_linux))  # 输出: 100

# 若外部输入为分解形式且未在运行时显式归一化
# 视觉上完全一致的字符串可能导致反射失败
if param_macos != param_linux:
    # 抛出 AttributeError: 'Model' object has no attribute ...
    print(getattr(obj, param_macos))
当通过 getattr()、setattr()、字典映射或元编程动态调度变量时,运行时的字符串哈希直接基于底层 code point 计算,不会触发编译期才有的 NFKC 自动转换。这会导致在线上线下不同环境下产生极其隐蔽且难以复现的 AttributeError。
二、开发工具链与静态检查生态兼容性
现代工程质量高度依赖自动化开发工具链(包括静态分析、语法检查、类型推导、格式化与自动重构)。工具链通常假设源代码由纯 ASCII 标识符构成,非 ASCII 字符的大量使用会带来一系列边界问题:
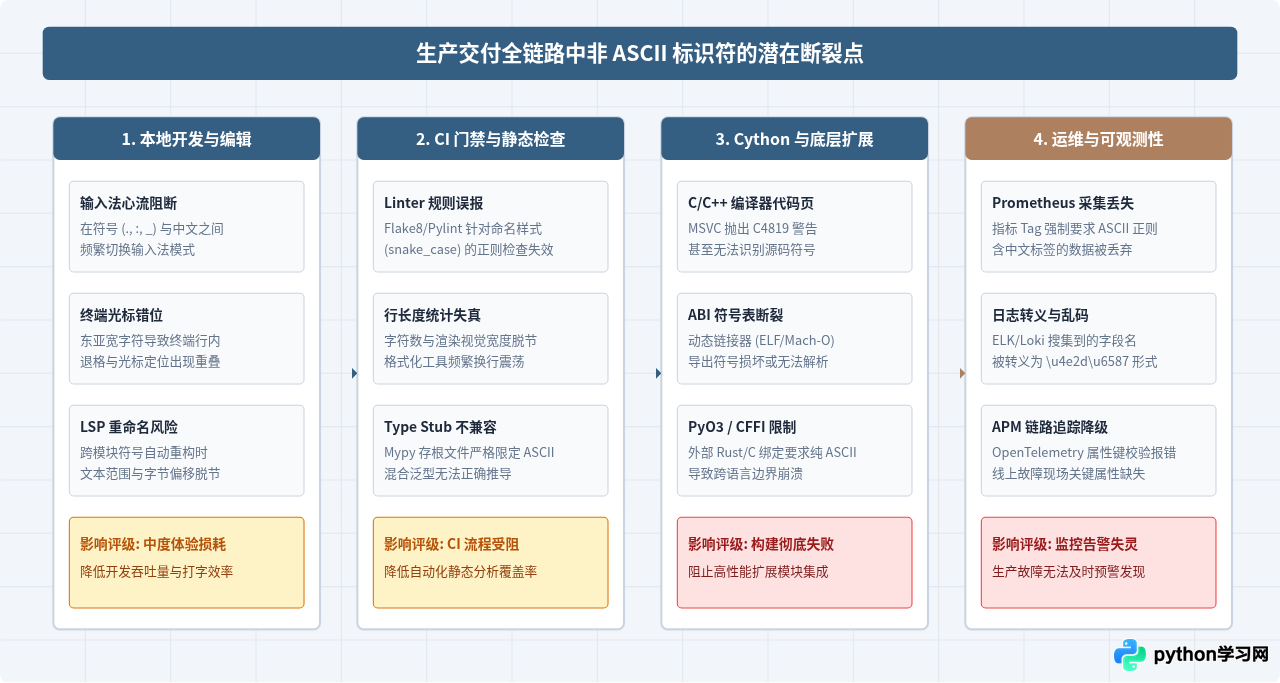
- 列宽与行位置计算偏差:大部分 Linter(如旧版 Flake8 插件、自定义正则检查脚本)在统计代码行长(如 PEP 8 规定的 79/88 字符限制)时,将中文字符按照单个字符计算,而在终端展示或对齐报告时,中文字符占用 2 个终端列宽(East Asian Width: W/F)。这会导致自动报错指引线(Carets)错位,给快速定位故障制造干扰。
- 类型系统支持与存根文件:使用
mypy或pyright时,第三方库通常提供.pyi存根(Stub)文件。Python 官方存根库(typeshed)全面采用 ASCII 命名约定。当混合使用中文变量与泛型协议(Protocols/TypedDict)时,经常触发工具解析器的边界缺陷。 - 自动重构与符号索引代价:在大型单体项目(Monorepo)中,语言服务器协议(LSP)如 Pyright/Pylance 需要对全局符号建立倒排索引。非 ASCII 字符的索引开销和模糊搜索算法匹配效率远低于纯 ASCII 字符,且易在代码自动重命名(Rename Symbol)时因编码转换损坏关联文件。
三、跨服务序列化、协议契约与运维断层
在分布式微服务与现代云原生架构中,Python 应用绝非孤立运行,而是与 Kafka、gRPC、Redis、Prometheus 以及各色日志系统深度交织。
1. 结构化日志与 APM 检索成本
生产环境普遍采用结构化日志(如 JSON 格式)输出至 ELK 或 Loki。默认情况下,Python 标准库 json.dumps() 的 ensure_ascii=True 开关是开启的。当变量名作为键自动导出到日志上下文时,会被转义为类似 \u7528\u6237\u72b6\u6001 的十六进制形式:
import json

# 生产环境中将对象属性转换为日志字段
context = {"用户状态": "在线", "重试计数": 3}

# 默认序列化行为
log_line = json.dumps(context)
# 实际输出: {"\u7528\u6237\u72b6\u6001": "\u5728\u7ebf", "\u91cd\u8bd5\u8ba1\u6570": 3}
在线上紧急排障时,运维工程师无法在 Kibana 或 Grafana 中直接搜索 context.用户状态,必须依赖特殊解析规则或执行繁重的客户端反转义,极大拖慢故障定位速度。
2. Prometheus 指标与 OpenTelemetry 限制
Prometheus 规范对 Metric 名称与 Label 名称有严格的 ASCII 字符集要求(通常匹配正则 [a-zA-Z_][a-zA-Z0-9_]*)。若将含有中文变量的字典自动转换为指标导出,Prometheus 客户端会直接抛出 ValueError,导致整个采集端点中断响应:
from prometheus_client import Counter

# 尝试使用中文作为 Label 名称
try:
    c = Counter('api_requests_total', '请求统计', ['接口名称'])
except ValueError as e:
    # 抛出异常: Invalid label metric name '接口名称'
    print(f"指标注册失败: {e}")
四、非 ASCII 变量治理与排查操作流程
对于存量历史代码或由交互式原型(Jupyter Notebook)直接移植到工程库的代码,必须通过自动化手段完成扫描、清理并引入 CI 门禁。推荐按照以下四个标准步骤执行:
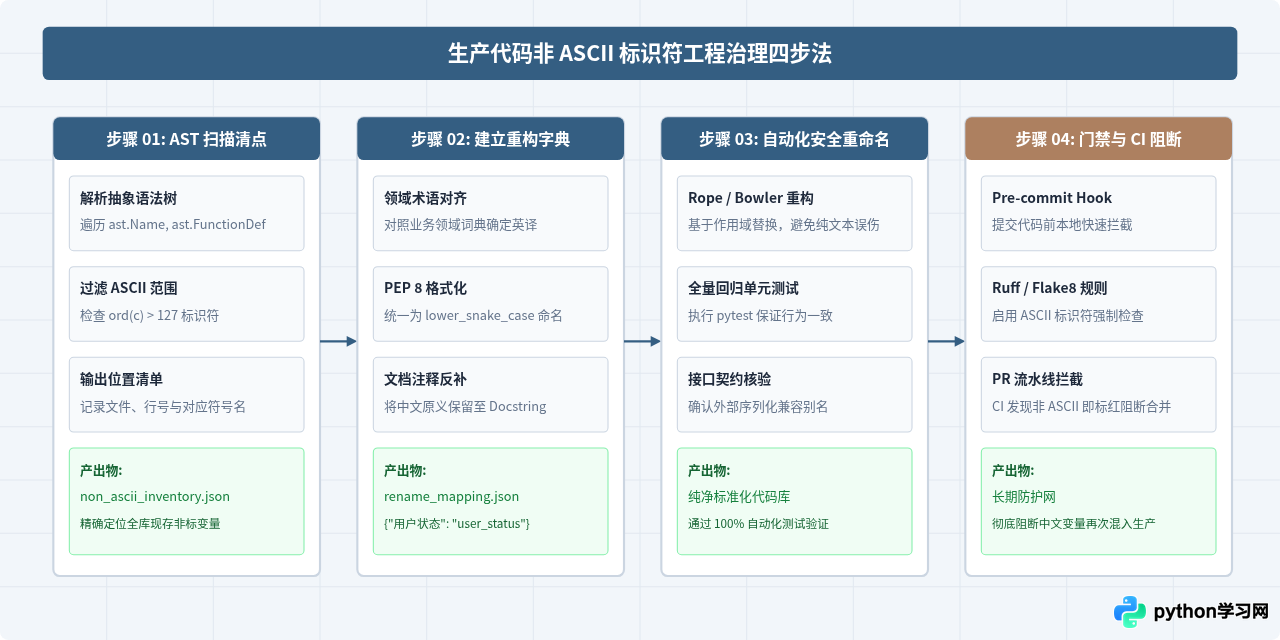
1. 编写排查脚本:基于 AST 精准定位
可以使用标准库 ast 模块编写静态扫描脚本,它比简单的正则表达式更准确,能够排除掉合法存在于注释与字符串字面量中的中文:
import ast
import os
import sys

def is_ascii_str(s: str) -> bool:
    try:
        s.encode('ascii')
        return True
    except UnicodeEncodeError:
        return False

def scan_file(file_path: str):
    with open(file_path, "r", encoding="utf-8") as f:
        try:
            tree = ast.parse(f.read(), filename=file_path)
        except SyntaxError as e:
            print(f"[语法错误] {file_path}: {e}")
            return

    for node in ast.walk(tree):
        # 检查普通变量与形参
        if isinstance(node, ast.Name) and not is_ascii_str(node.id):
            print(f"{file_path}:{node.lineno} 非ASCII变量: {node.id}")
        # 检查函数定义名
        elif isinstance(node, ast.FunctionDef) and not is_ascii_str(node.name):
            print(f"{file_path}:{node.lineno} 非ASCII函数: {node.name}")
        # 检查类定义名
        elif isinstance(node, ast.ClassDef) and not is_ascii_str(node.name):
            print(f"{file_path}:{node.lineno} 非ASCII类名: {node.name}")

if __name__ == "__main__":
    scan_file("example.py")
2. 配置 Pre-commit 门禁
在工程根目录的 .pre-commit-config.yaml 中引入自定义规则,阻断包含非 ASCII 标识符的提交:
repos:
  - repo: local
    hooks:
      - id: check-ascii-identifiers
        name: 强制标识符纯 ASCII 规范
        entry: python -m tools.scan_identifiers
        language: system
        types: [python]
        stages: [commit]
五、规范建议与场景决策矩阵
虽然生产环境不建议使用中文变量名,但这并不意味着中文在 Python 项目中毫无价值。应当明确划分标识符、注释、文档字符串与业务数据的边界:
- 变量名、类名、方法名:必须严格限制在 ASCII 范围内(遵循 PEP 8 命名规范,使用标准的英文单词或行业通用缩写)。
- 注释与 Docstrings:鼓励使用清晰严谨的中文详细阐明算法原理、复杂业务背景、边界前提与异常处理预期。
- 字典数据与运行时字段:若涉及跨系统传递,键名(Keys)应采用英文命名;若需要向终端用户展示,建议采用国际化(i18n)机制或映射表进行呈现层解耦。
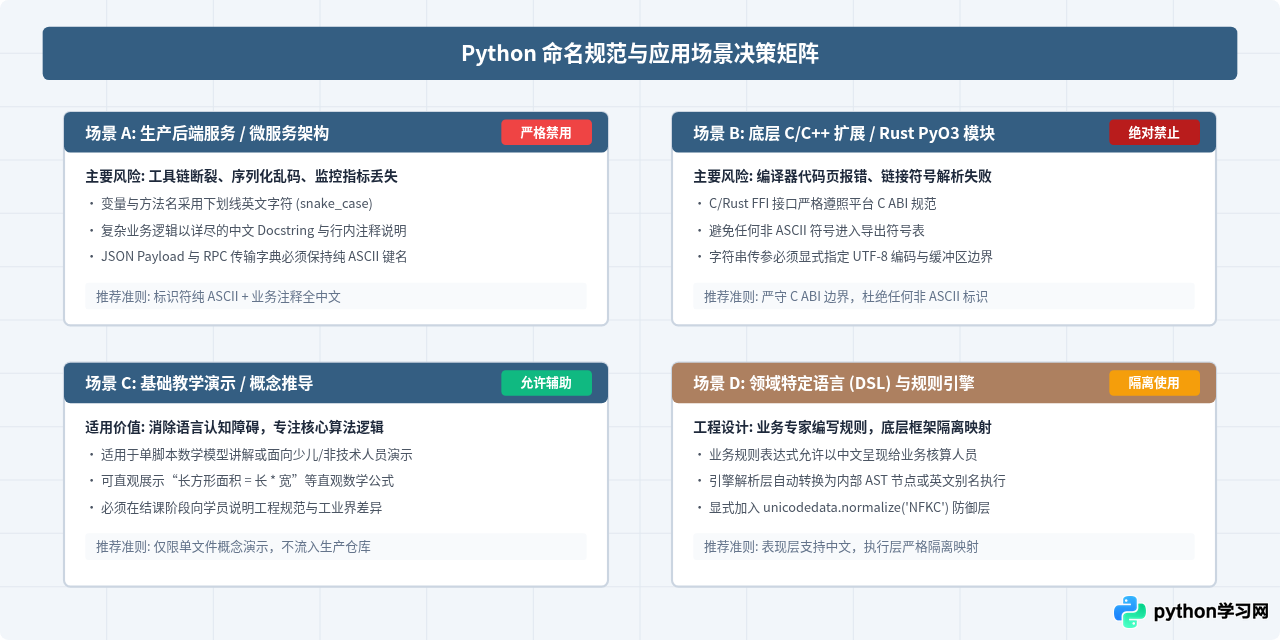
Python 解释器支持中文变量名是语言通用性(Internationalization)的重要体现,证明了其完备的 Unicode 支持。但在复杂的工业生产协作中,代码是写给人看、同时交给一整套工程流水线去运行与验证的。坚持使用标准的 ASCII 变量命名,并将中文表达保留在注释、文档和日志内容中,是保障生产环境高可用、降低系统维护成本的最稳健选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















