


Python内置sqlite3模块详解:轻量级数据库的管理与维护
深入详解 Python 内置 sqlite3 模块的核心用法与运维实践,涵盖嵌入式架构原理、标准开发范式、参数化防注入、WAL 并发模式优化、在线热备份与 VACUUM 碎片整理。
sqlite3 模块的标准开发链路、参数化防注入、事务控制机制,并重点阐述生产环境中关键的并发冲突规避、在线热备份与碎片维护方案。
一、SQLite 的嵌入式架构与适用边界
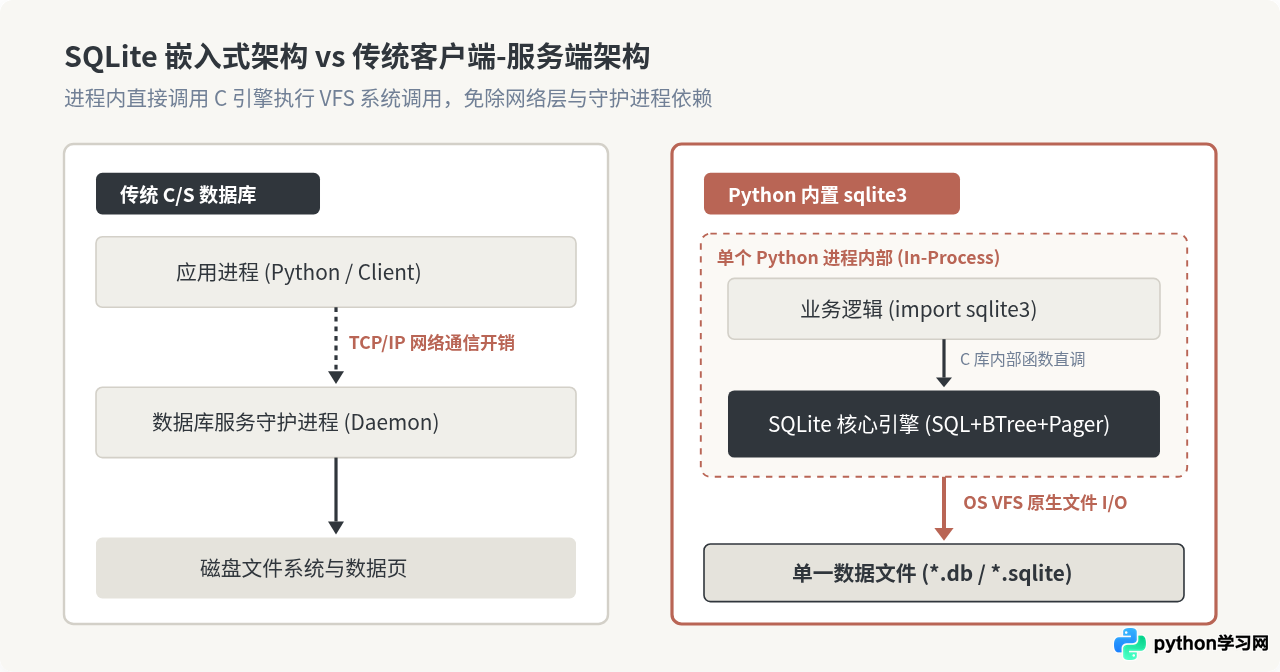
与 MySQL、PostgreSQL 等典型客户端/服务端(Client/Server)架构不同,SQLite 属于“进程内”(In-Process)数据库引擎。Python 运行环境中导入的 sqlite3 模块实质上是 SQLite C 语言动态链接库的原生封装。
当调用 sqlite3.connect() 时,程序并没有发起任何 TCP/IP 握手或命名管道连接,而是直接由当前 Python 进程通过操作系统虚拟文件系统(VFS)直接读写目标文件。这一底层特质带来了两大直接优势与一个物理限制:
- 零配置与极低开销:没有独立的常驻守护进程,避免了套接字通信、上下文切换与序列化协议损耗,执行简单点查(Point Lookup)时延迟通常在微秒级别。
- 单文件高移植性:整个数据库(表定义、索引、触发器、数据页)统一存储于单个二进制文件中,备份或迁移仅涉及标准文件读写。
- 写入并发瓶颈:由于缺乏中心化的服务端调度,SQLite 依靠操作系统文件锁实现隔离。在默认模式下,同一个时刻全库只允许一个写事务操作,高并发写入场景下极易产生锁竞争。
二、标准开发范式:连接、上下文与参数化防注入
编写健壮的 SQLite 代码需要遵循明确的模式。初学者常犯的两个错误是:拼接 SQL 语句导致安全注入漏洞,以及未正确管理事务与连接生命周期导致文件被长期锁定。
1. 连接与行对象配置
默认情况下,cursor.fetchall() 返回的是标准元组(tuple),字段只能通过索引访问,这会降低业务代码的可读性与维护性。通过设置 conn.row_factory = sqlite3.Row,可以使查询结果既支持整数索引,又支持按列名字典式访问:
import sqlite3

# 建立连接,设置 busy timeout(单位秒),在遇到锁争用时自动等待
conn = sqlite3.connect("app_data.db", timeout=10.0)

# 配置 row_factory 实现键值列名映射
conn.row_factory = sqlite3.Row

cursor = conn.cursor()
cursor.execute("CREATE TABLE IF NOT EXISTS users (id INTEGER PRIMARY KEY, name TEXT, balance REAL)")
conn.commit()
2. 严禁字符串拼接:参数化查询的标准写法
无论输入来自内部函数还是外部请求,绝不能使用 Python 的 f-string 或 % 操作符拼接 SQL。sqlite3 支持问号 ?(位置占位符)与冒号 :name(命名占位符)两种安全模式:
# 模式 A:位置参数(元组传参)
user_input_name = "Alice"
cursor.execute("SELECT * FROM users WHERE name = ?", (user_input_name,))
row = cursor.fetchone()
if row:
    print(f"用户ID: {row['id']}, 余额: {row['balance']}")

# 模式 B:命名参数(字典传参,适合字段较多的批量操作)
new_records = [
    {"name": "Bob", "balance": 150.0},
    {"name": "Charlie", "balance": 320.5}
]
cursor.executemany("INSERT INTO users (name, balance) VALUES (:name, :balance)", new_records)
conn.commit()
3. 利用上下文管理器规范事务与连接释放
Python 的 sqlite3.Connection 对象本身可以作为事务上下文管理器使用。在 with conn: 代码块内,如果语句正常执行结束,会自动调用 conn.commit();若块内抛出任何未捕获异常,将自动执行 conn.rollback() 并向外冒泡异常:
import sqlite3
from contextlib import closing

# 使用 closing 保证即使发生致命故障也确保连接被正常 close
with closing(sqlite3.connect("app_data.db", timeout=5.0)) as conn:
    conn.row_factory = sqlite3.Row
    try:
        # with conn 自动开启事务管理
        with conn:
            cursor = conn.cursor()
            cursor.execute("UPDATE users SET balance = balance - 50 WHERE name = ?", ("Bob",))
            cursor.execute("UPDATE users SET balance = balance + 50 WHERE name = ?", ("Charlie",))
            # 若第二句失败,Bob 扣款将被自动回滚
    except sqlite3.Error as e:
        print(f"事务执行失败,已自动回滚: {e}")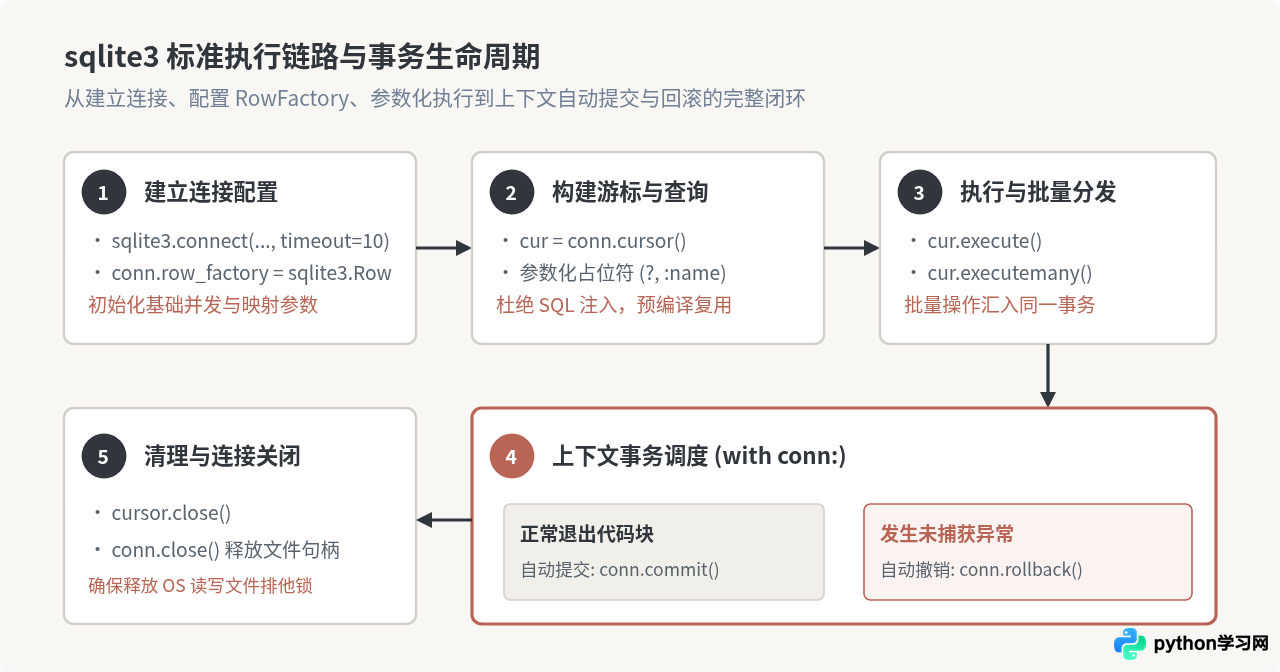
三、类型系统与高级自定义适配
SQLite 采用的是动态类型系统(Dynamic Type System),列的数据类型更像是一种建议(类型亲和性 Type Affinity),而非强制约束。例如向声明为 INTEGER 的列中插入字符串 "abc" 并不会直接报错。在与 Python 交互时,内置模块会自动完成常见基础类型的双向映射:
| Python 数据类型 | SQLite 存储类型 | 底层类型说明 |
|---|---|---|
None |
NULL |
空值标识 |
int |
INTEGER |
1、2、3、4、6 或 8 字节有符号整数(根据数值范围动态存储) |
float |
REAL |
8 字节 IEEE 浮点数 |
str |
TEXT |
UTF-8 或 UTF-16 文本编码格式存储 |
bytes |
BLOB |
原始二进制数据块,原样保存字节流 |
自定义对象适配器与转换器
当遇到 Python 的 datetime、UUID 或复杂的字典/列表结构时,可以通过 sqlite3.register_adapter(Python 对象到 SQLite 存储类型)与 sqlite3.register_converter(SQLite 数据反序列化回 Python 对象)实现自动透明读写:
import json
import sqlite3

# 1. 注册适配器:将 dict 对象转换为 JSON 字符串存储在 TEXT 列中
sqlite3.register_adapter(dict, lambda d: json.dumps(d, ensure_ascii=False))

# 2. 注册转换器:将读取到的 JSON 字节还原为 dict
sqlite3.register_converter("json_data", lambda b: json.loads(b.decode("utf-8")))

# 建立连接时需启用 PARSE_DECLTYPES,以便依据表结构中的声明类型自动调用转换器
conn = sqlite3.connect(":memory:", detect_types=sqlite3.PARSE_DECLTYPES)
cursor = conn.cursor()

# 创建表时,列类型声明为注册的名字 json_data
cursor.execute("CREATE TABLE configs (id INTEGER PRIMARY KEY, payload json_data)")

payload = {"theme": "dark", "notifications": True, "retry_count": 3}
cursor.execute("INSERT INTO configs (payload) VALUES (?)", (payload,))

cursor.execute("SELECT payload FROM configs WHERE id = 1")
row = cursor.fetchone()
print(type(row[0]), row[0]["theme"])  # 输出: <class 'dict'> dark
四、事务控制与并发模式:WAL 预写式日志优化
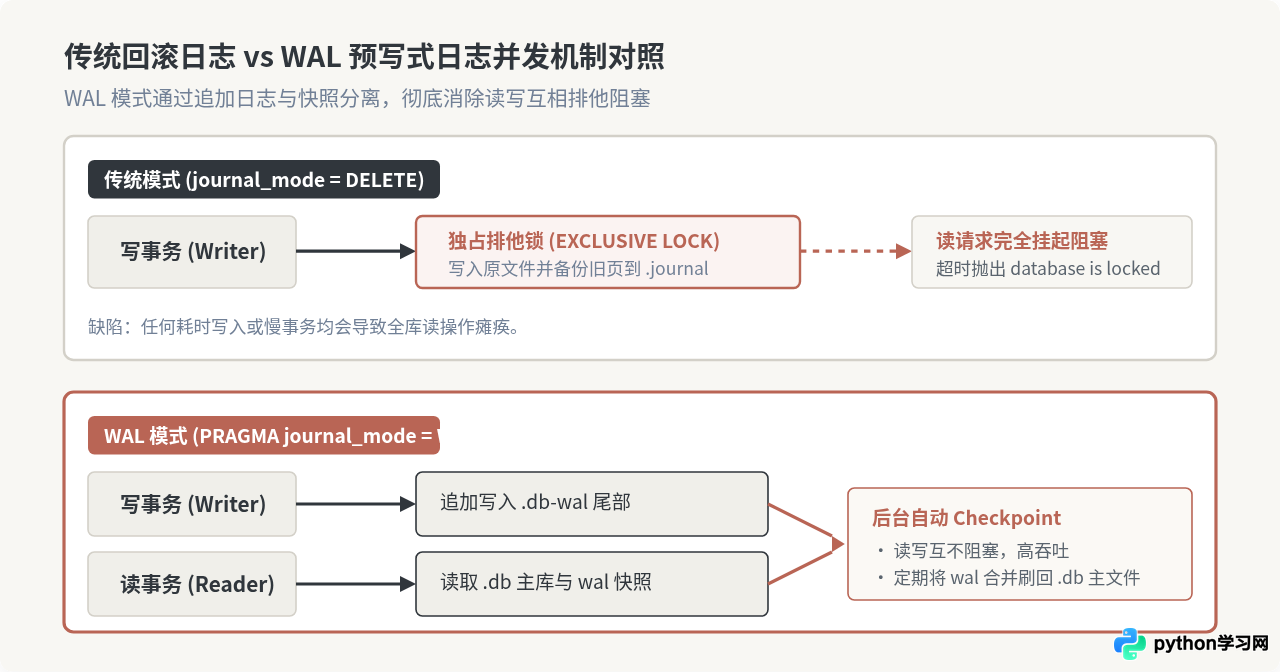
在多线程或多进程读写 SQLite 时,开发者经常遭遇 sqlite3.OperationalError: database is locked 报错。该报错的根源在于 SQLite 传统的回滚日志模式(Rollback Journal)采用了粗粒度的全库排他锁。
1. 传统 Rollback 模式的局限
在默认配置(PRAGMA journal_mode=DELETE)下,每当发起写入事务,引擎必须先在同目录下创建 .db-journal 回滚文件,将即将修改的数据页原始内容备份下来。此时:
- 写入过程必须获取
EXCLUSIVE锁; - 所有后续读请求(SELECT)会被完全阻塞;
- 一旦写入事务未及时 commit,整个应用的所有并发读取都会陷入超时等待。
2. 切换至 WAL 模式解除读写互斥
对于绝大多数生产场景,推荐在建立连接后立即执行以下 PRAGMA 指令,将日志模式切换为预写式日志(Write-Ahead Logging, 简称 WAL):
conn = sqlite3.connect("production.db", timeout=15.0)
cursor = conn.cursor()

# 开启 WAL 模式(仅需在库创建时执行一次,配置会永久写入数据库元信息头中)
cursor.execute("PRAGMA journal_mode = WAL;")
mode = cursor.fetchone()[0]
print(f"当前 Journal 模式: {mode}")  # 输出: wal

# 调整同步模式,在兼顾持久性与 I/O 效率间取得良好平衡
cursor.execute("PRAGMA synchronous = NORMAL;")
启用 WAL 模式后,数据库目录下会伴随生成两个辅助文件:.db-wal(预写日志文件)与 .db-shm(共享内存索引文件)。其工作机制产生了质的飞跃:
- 读写互不阻塞:读操作直接访问
.db原始数据页和.db-wal中的有效快照,写操作直接追加到.db-wal尾部。读操作永远不会阻塞写操作,写操作也绝不会阻塞读操作。 - 顺序写入性能:追加写相比于原位随机更新磁盘页,极大地降低了机械硬盘与 SSD 的碎片损耗。
- 检查点(Checkpoint)机制:当
.db-wal累积到一定阈值(默认 1000 个页)或连接关闭时,SQLite 会在后台自动触发 Checkpoint,将 WAL 中的最新数据页刷回.db主库并截断日志。
五、生产环境的数据库日常维护与管理
随着软件长期运行与数据的频繁增删改查,SQLite 数据库文件可能出现存储碎片化、磁盘占用虚高以及意外宕机导致的物理页损坏。建立系统化的日常维护流程是保障系统稳定的重中之重。
1. 数据库完整性检查(Integrity Check)
在服务器意外断电、进程被 SIGKILL 强制杀灭或存储介质出现坏道后,SQLite 数据文件可能会产生静默损坏。在关键应用启动前或定时任务中,应执行完整性检查:
def check_db_health(db_path: str) -> bool:
    with sqlite3.connect(db_path) as conn:
        cursor = conn.cursor()
        # quick_check 速度快,检查 B-Tree 索引结构与页分配基本一致性
        cursor.execute("PRAGMA quick_check;")
        res = cursor.fetchall()
        if res and res[0][0] == "ok":
            return True

        # 若 quick_check 异常,执行深度校验获取详细错误报告
        cursor.execute("PRAGMA integrity_check;")
        details = cursor.fetchall()
        print(f"数据库完整性异常: {details}")
        return False
2. 在线热备份(Online Backup API)
切勿在程序运行期间直接调用操作系统的 shutil.copy() 或 cp 命令备份数据库!因为在复制过程中如果有写事务正在执行,复制得到的很可能是一个数据不一致甚至损坏的文件副本。
Python 的 sqlite3.Connection 提供了原生的 backup() 方法,能够在不中断业务读写的情况下分批复制数据页:
import time
import sqlite3

def perform_online_backup(src_db_path: str, backup_dest_path: str):
    # 源连接通常已在业务中打开
    with sqlite3.connect(src_db_path) as src_conn:
        with sqlite3.connect(backup_dest_path) as dest_conn:
            print("正在启动在线热备份...")
            # pages 参数指定单次拷贝的数据页数,sleep 指定让出锁的间隔时间(秒)
            # 这种步进式备份对业务线程的性能影响极微
            src_conn.backup(dest_conn, pages=100, sleep=0.05)
            print(f"备份完成,目标文件: {backup_dest_path}")

# 执行备份示例
perform_online_backup("app_data.db", f"backup_{int(time.time())}.db")
3. 碎片整理与磁盘空间回收(VACUUM)
在 SQLite 中执行 DELETE FROM users WHERE ... 语句后,被删除记录所占用的磁盘空间不会立即归还给操作系统。SQLite 仅将这些数据页标记为空闲页(Free List),留给后续的 INSERT 使用。如果业务执行了大规模数据清理,数据库文件体积不会自动缩小。
此时需要显式执行 VACUUM 命令。该命令会在内部创建一个全新的临时数据库,将当前所有活跃数据重新紧凑写入,然后替换旧文件:
def reclaim_space(db_path: str):
    # 注意:VACUUM 不能在活动的显式事务中执行
    conn = sqlite3.connect(db_path, isolation_level=None)
    cursor = conn.cursor()

    # 查看当前空闲页数量
    cursor.execute("PRAGMA freelist_count;")
    free_pages = cursor.fetchone()[0]
    cursor.execute("PRAGMA page_size;")
    page_size = cursor.fetchone()[0]
    wasted_mb = (free_pages * page_size) / (1024 * 1024)
    print(f"整理前空闲占用: {wasted_mb:.2f} MB")

    # 执行碎片重组与磁盘回收
    cursor.execute("VACUUM;")
    print("VACUUM 执行完成,空间已归还操作系统。")
conn.close()VACUUM 在重建数据库时需要额外的磁盘空间(通常需预留与当前数据库文件等大的空闲空间)。如果磁盘剩余空间不足,命令将执行失败。对于持续产生大量删除的场景,可在建库时开启 PRAGMA auto_vacuum = INCREMENTAL;,并通过定时 PRAGMA incremental_vacuum(N); 分批微量释放空间。
4. 查询分析与索引优化(EXPLAIN QUERY PLAN)
当查询响应变慢时,无需猜测是否命中了索引。在 SQL 前添加 EXPLAIN QUERY PLAN 即可查看 SQLite 的执行计划:
cursor.execute("EXPLAIN QUERY PLAN SELECT * FROM users WHERE name = ?", ("Alice",))
for row in cursor.fetchall():
    # 若输出中出现 SCAN TABLE,说明进行了全表扫描;
    # 若出现 SEARCH TABLE users USING INDEX ...,说明正确命中了索引
    print(row)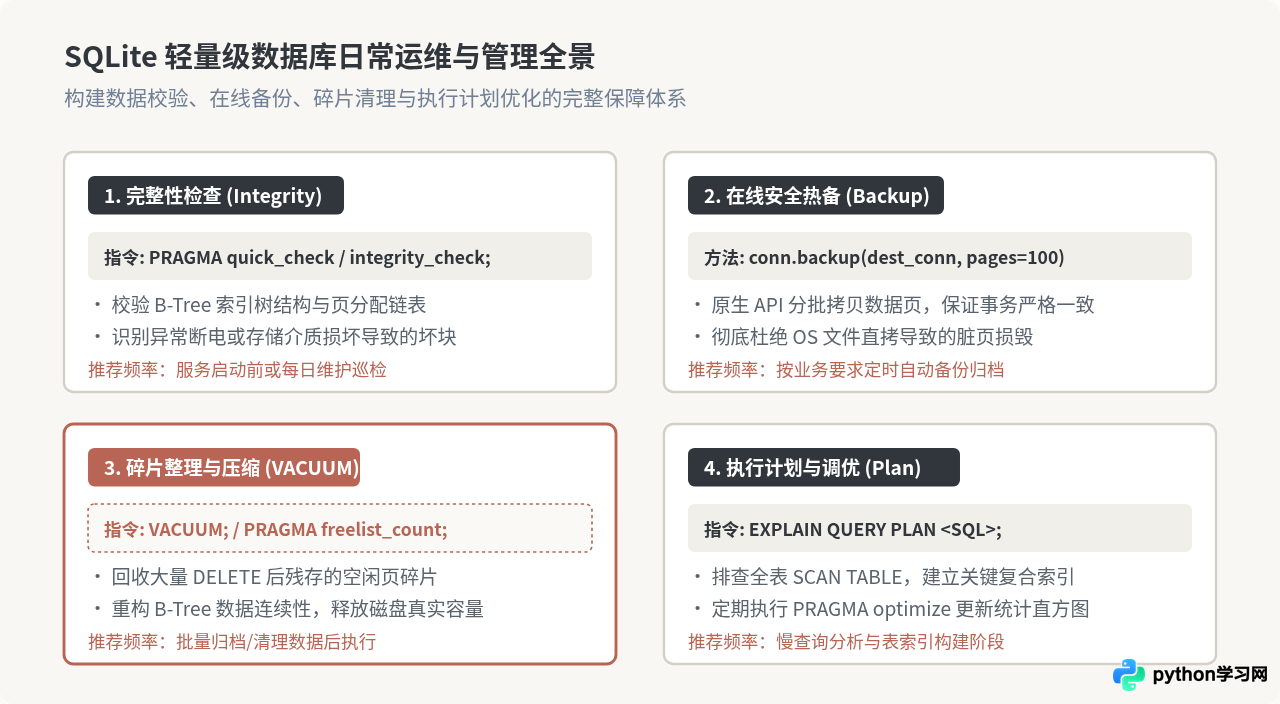
六、多线程并发约束与典型灾备恢复
1. 多线程与 check_same_thread
默认情况下,sqlite3.connect() 会开启 check_same_thread=True 保护。如果在一个线程中建立的连接对象被传递给另一个线程直接调用,Python 会直接抛出:
sqlite3.ProgrammingError: SQLite objects created in a thread can only be used in that same thread.
虽然可以通过设置 check_same_thread=False 禁用此检查,但这要求外部代码使用互斥锁(threading.Lock)严格同步所有游标操作,否则容易造成底层 C 指针冲突。更加稳健的工程实践是:
- 使用线程局部存储(
threading.local())或每个线程按需建立独立连接; - 所有写操作统一交由单个专职工作线程通过
queue.Queue消费,避免多线程同时争用写入排他锁; - 配合
timeout=10.0给予充分的等待重试窗口。
2. 数据灾难恢复:通过 .dump 脚本修复受损库
当数据库文件因不可逆异常无法正常读取时,直接通过 Python 查询可能会频频报错。此时可以利用 SQLite 提供的导出逻辑,将未损坏的数据页以 SQL 脚本形式尽可能提取出来:
import sqlite3

def salvage_corrupted_database(corrupt_db_path: str, recovered_db_path: str):
    """
    尝试从受损的 SQLite 文件中抢救数据并重建新库
    """
    try:
        with sqlite3.connect(corrupt_db_path) as src_conn:
            with sqlite3.connect(recovered_db_path) as dest_conn:
                dest_cursor = dest_conn.cursor()
                # iterdump() 会遍历所有能够被正确读取的 DDL 与 DML 语句
                for line in src_conn.iterdump():
                    try:
                        dest_cursor.execute(line)
                    except sqlite3.Error:
                        # 跳过损坏导致语法异常的个别数据行
                        continue
                dest_conn.commit()
        print("数据提取重建流程结束。")
    except Exception as e:
        print(f"不可恢复的严重物理损坏: {e}")
七、总结
Python 内置的 sqlite3 模块绝非仅仅用于本地练习或小型脚本。通过理解其进程内嵌入式的架构特质,遵守参数化查询与 with conn: 上下文事务规范,并在生产配置中主动切换至 WAL 预写日志模式,它完全能够支撑百万级数据量、高频只读与平稳并发写入的工业级桌面应用与中小服务后端。在此基础上,将 integrity_check、conn.backup() 与 VACUUM 纳入日常自动化运维管线,即可在零外部运维依赖的前提下,确保本地数据的极高可靠性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















