


Python 3不兼容Python 2的关键技术变更有哪些
全面解析 Python 3 相比 Python 2 的核心不兼容技术变更,深入剖析文本与字节分离、数值真除法、迭代器惰性求值、语法与异常机制升级的底层原理与迁移避坑指南。
一、字符串与二进制字节序列的严格分离
在所有断代变更中,对工程系统影响最深远、修改成本最高的,当属文本与字节序列处理机制的彻底重构。
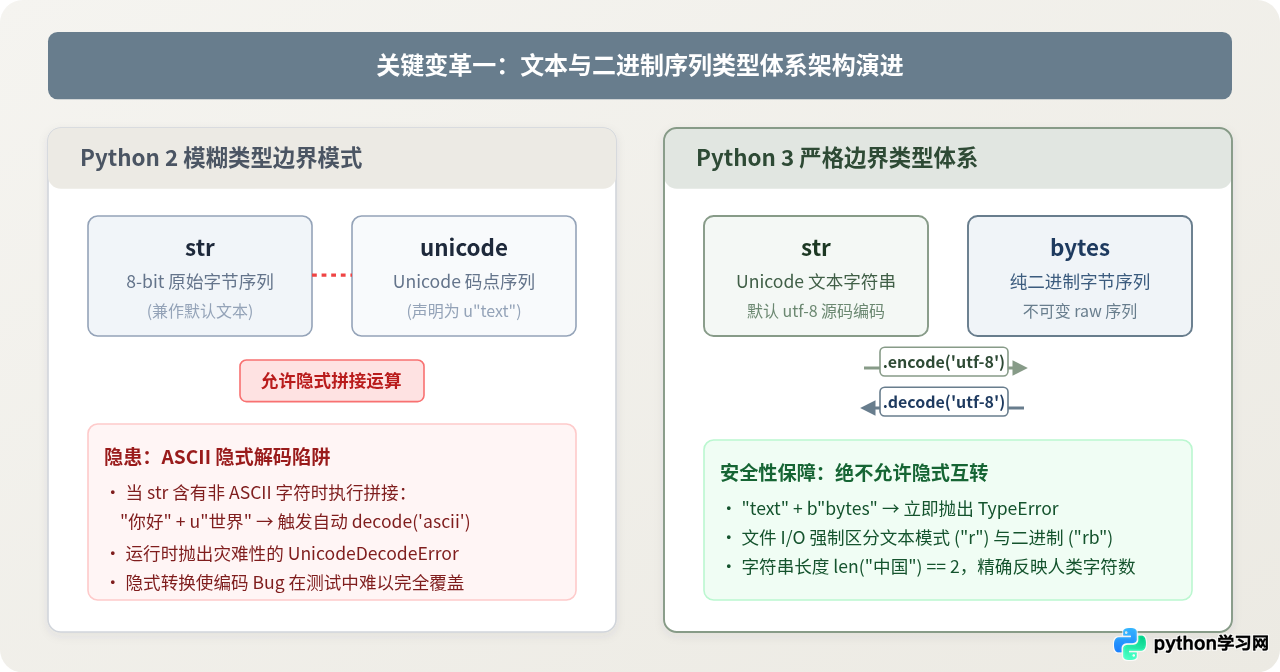
1.1 核心机制差异:隐式互转 vs 显式边界
在 Python 2 中,str 类型本质上是 8-bit 的原始字节数组(兼作默认字符串类型),而真正的 Unicode 文本则由单独的 unicode 类型承载。由于 Python 2 允许二者进行隐式自动转换与直接拼接,当执行类似 "你好" + u"世界" 的操作时,解释器会悄悄尝试使用 ASCII 编码对 str 执行解码。在 ASCII 范围内的英文字符下测试时一切正常,一旦遇到超出 127 的中文或特殊字节,程序便会在生产环境中毫无预警地抛出 UnicodeDecodeError。
Python 3 彻底打破了这种混淆设计:原有的 unicode 类型更名并晋升为唯一的 str(严格表示人类可读的 Unicode 字符序列,源码文件默认采用 UTF-8 编码);处理原始二进制数据时,必须显式使用 bytes 类型。二者之间没有隐式类型提升或自动转换,必须通过 .encode('utf-8') 与 .decode('utf-8') 进行清晰确定的边界转换。
# --- Python 2 行为 ---
>>> s = "中"         # 类型为 str,底层为当前终端编码的字节(如 UTF-8 的 3 字节)
>>> u = u"国"        # 类型为 unicode
>>> len(s)          # 输出 3(计算的是底层字节数量)
>>> s + u           # 隐式解码失败!抛出 UnicodeDecodeError: 'ascii' codec can't decode byte...

# --- Python 3 行为 ---
>>> s = "中"         # 类型为 str(Unicode 文本)
>>> b = b"abc"       # 显式使用 bytes 字面量
>>> len(s)          # 输出 1(字符计数,符合直觉)
>>> s + b           # 拦截无意义拼接!直接抛出 TypeError: can only concatenate str (not "bytes") to str
>>> b.decode("utf-8") # 必须显式解码转换
'abc'open() 默认以文本模式("r")打开文件并返回 str,其编码默认绑定系统环境。若处理图像、套接字网络流或二进制打包文件,必须显式指定 "rb" / "wb" 模式,否则读写 bytes 时会立即引发 TypeError。
二、数值计算系统演进:真实除法与整型合并
数值计算规则的变更修正了长久以来违背初学者直觉和工程安全的数学行为。
2.1 经典除法规则重构(/ 与 // 的分工)
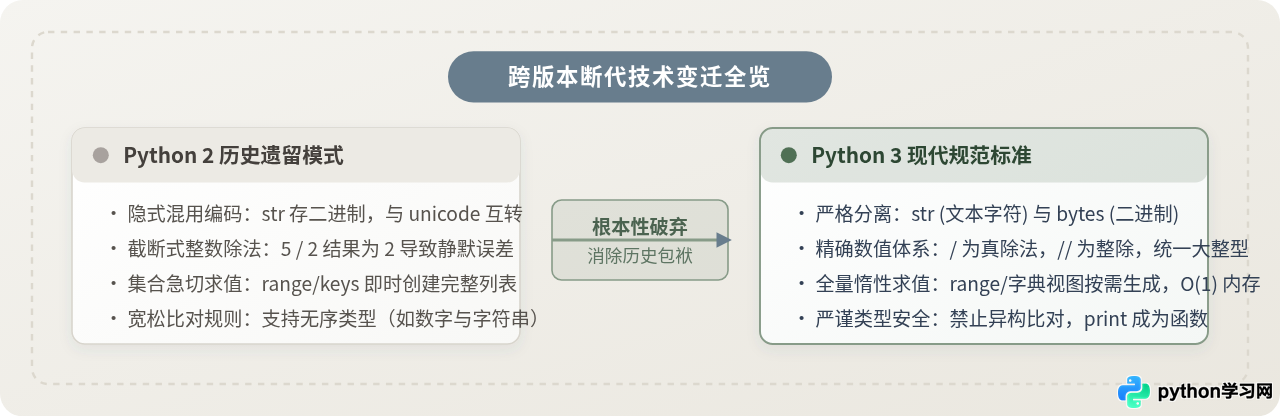
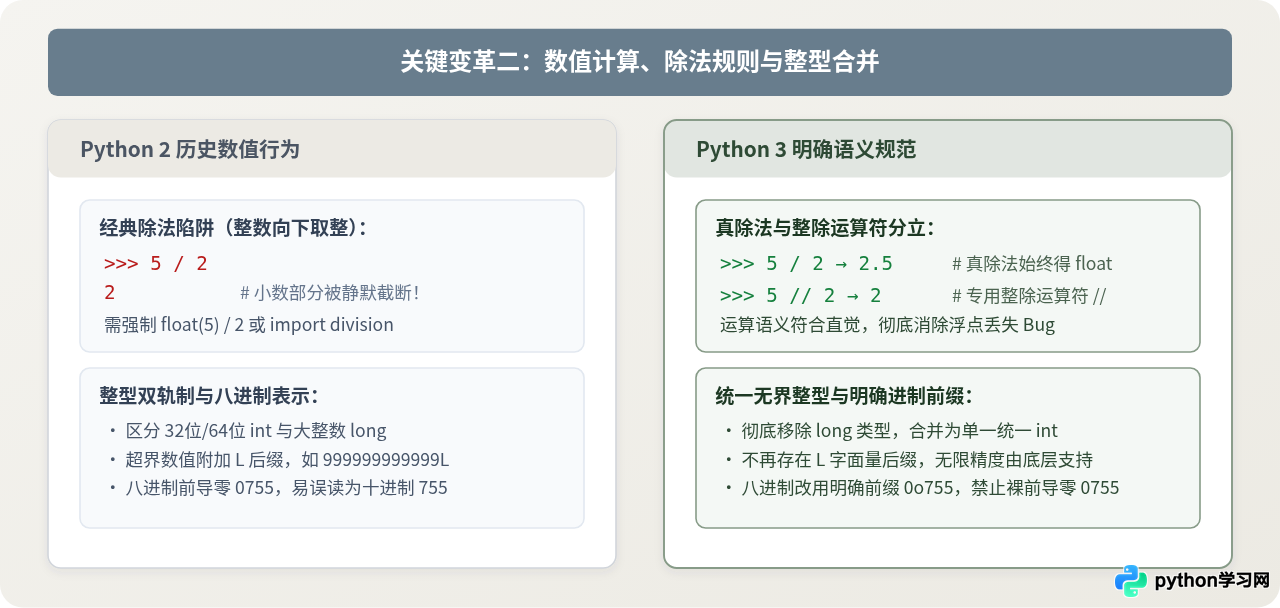
在 Python 2 中,除法运算符 / 沿袭了 C 语言的“向下截断除法”逻辑:当参与运算的两个操作数均为整数时,运算结果截断所有小数位,返回向下取整的整数。例如 5 / 2 的结果为 2。这导致了大量因未主动将除数或被除数强转为 float 而产生的静默计算偏差。
在 Python 3 中,除法运算符的行为被彻底正规化:
- 真实除法(True Division,
/):无论操作数是否为整数,始终返回浮点数,如5 / 2 == 2.5、4 / 2 == 2.0。 - 向下整除(Floor Division,
//):作为独立的整除运算符,专门用于获取向下取整的整数商,如5 // 2 == 2。
2.2 移除 long 类型与八进制字面量规范化
Python 2 维护着两套整型实现:受限于 CPU 机器字长的固定精度 int,以及当数值溢出时自动转换的无限精度 long(字面量带有 L 后缀)。在 Python 3 中,long 类型被彻底消除,语言内仅保留单一的 int 类型,底层原生支持无边界任意精度整数计算,诸如 sys.maxint 等属性也被同步移除。
此外,Python 2 允许使用前导零声明八进制数值(例如 0755 等价于十进制的 493),这在配置 UNIX 文件权限时极易引起代码审查疏忽。Python 3 废除了裸前导零语法,强制使用标准的 0o755 前缀,直接消除由语法混淆导致的逻辑漏洞。
三、集合与迭代器惰性求值:内存模型的根本重构
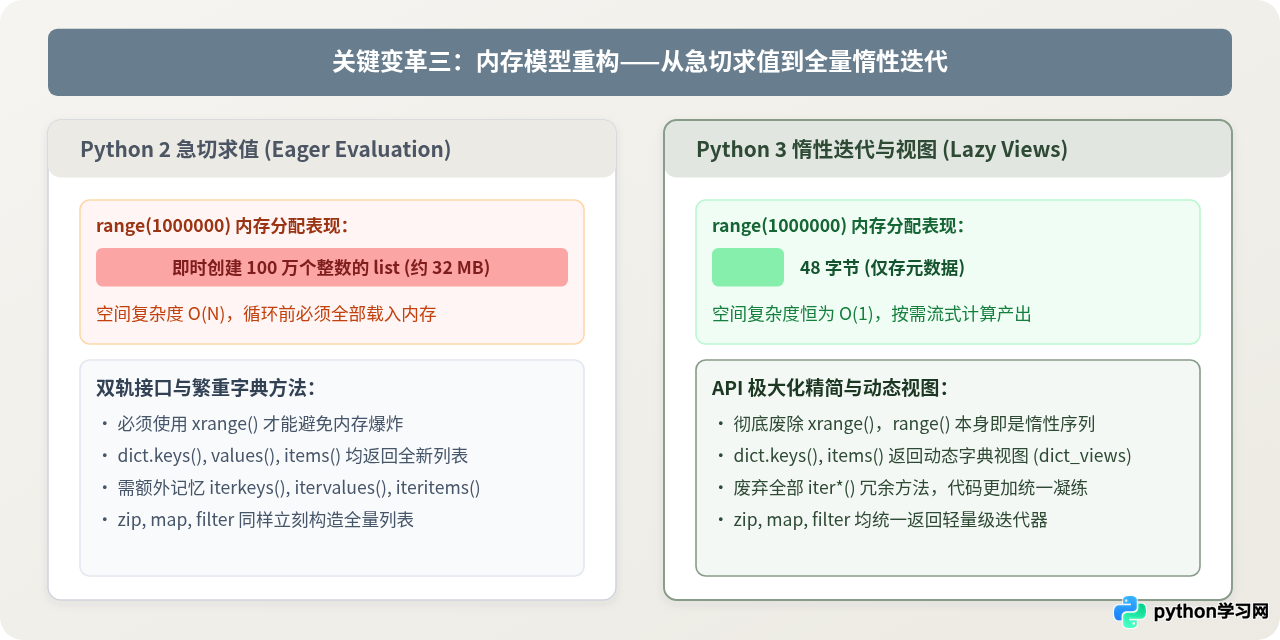
Python 2 到 Python 3 的另一个重大架构变更是全量向“惰性求值(Lazy Evaluation)”转型,从而大幅削减大型数据集合处理时的常驻内存消耗。
3.1 range 统一与 xrange 废除
在 Python 2 中,range(n) 会在调用的瞬间直接在内存中分配包含全部 n 个连续整数的物理 list。当遍历范围扩大到数千万时,会直接耗尽服务器物理内存。为此 Python 2 提供了返回生成器的补丁函数 xrange()。这种“同一逻辑功能并存两套接口”的割裂在 Python 3 中被终结:xrange() 被直接移除,而 range() 则被重写为一个不可变惰性序列对象,无论指定多大的区间,其内存占用始终固定在极其轻量的几十个字节(O(1) 空间复杂度)。
3.2 字典视图对象(dict_views)替代全量列表
在字典操作方面,Python 2 的 dict.keys()、dict.values() 和 dict.items() 均会实时克隆出独立的键/值全量列表,且为了节省内存还额外衍生了 iterkeys()、itervalues()、iteritems() 三组迭代器方法。
Python 3 完全废除了所有 iter*() 方法,并将 keys()、values()、items() 的返回值直接重构为轻量级“动态字典视图”(dict_keys、dict_values、dict_items)。视图不会预分配新列表,而是直接保持与原字典内存的动态同步:当字典发生就地增删时,视图反映的内容会即时更新。
# --- Python 2 ---
keys = d.keys()
keys.sort()       # 正确:d.keys() 返回真正的 list 对象

# --- Python 3 ---
keys = d.keys()
keys.sort()       # 报错!AttributeError: 'dict_keys' object has no attribute 'sort'
sorted_keys = sorted(d.keys()) # 正确:使用通用内置函数 sorted() 或 list(d.keys())
四、语法细节收紧与异常机制规范化
为了让语法更加规范严谨,Python 3 对多项历史陈旧语法进行了系统性清理。
4.1 print 语句转型为 print() 内置函数
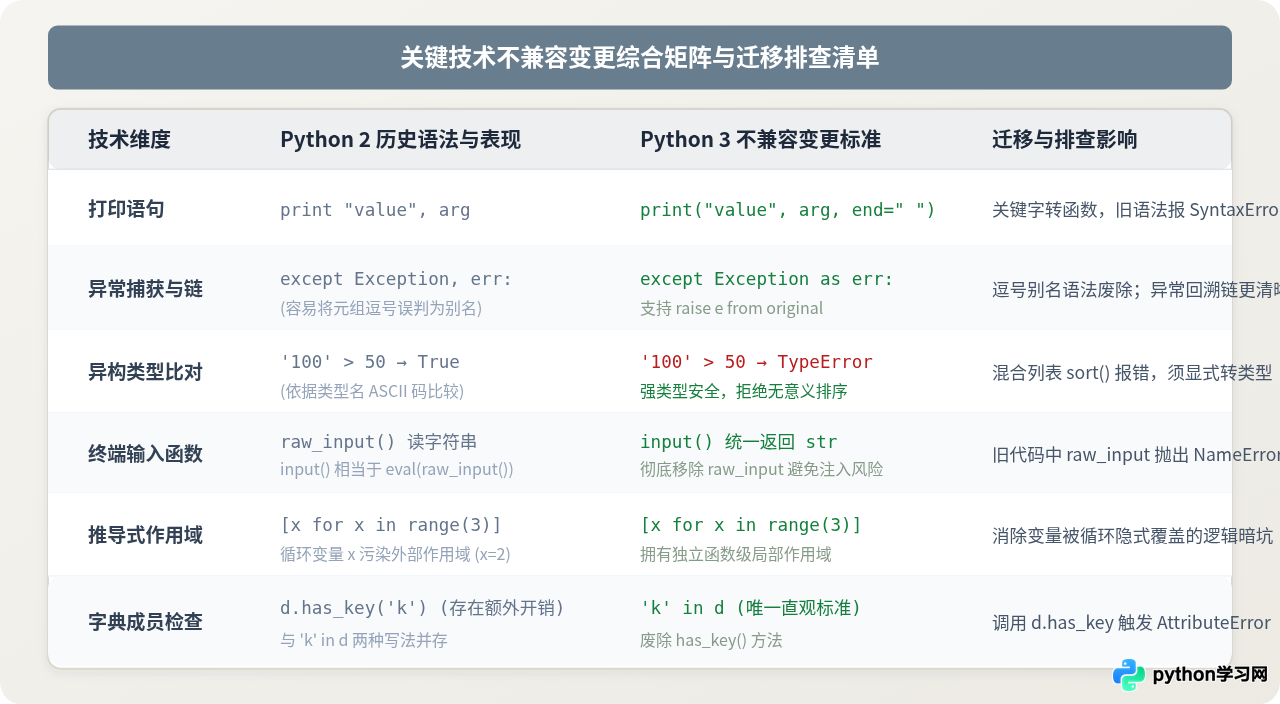
在 Python 2 中,print 属于关键字语句(如 print "hello", "world")。由于它是语句而非函数,无法灵活地重定向输出目标流、定制结尾分隔符,也无法通过高阶函数对其进行传递引用。
在 Python 3 中,print 成为标准的内置函数,原有的重定向与格式控制被封装为关键字参数:
sep:指定多个输出参数之间的分隔符(默认为空格)。end:指定行尾追加内容(默认为换行符file:重定向输出到任意支持write()的流对象(取代print >> sys.stderr, "msg"语法)。flush:强制刷新缓冲区。
4.2 异常捕获语法与异常回溯链(Exception Chaining)
Python 2 允许使用逗号分隔异常类与实例对象,例如 except ValueError, e:。当捕获多个异常时,开发者容易误写为 except TypeError, ValueError:,导致 ValueError 被误解为别名而引发重大排查灾难。Python 3 强制要求使用 as 关键字(except Exception as e:),彻底消除歧义。
更重要的是,Python 3 原生引入了异常链机制,支持 raise NewException from original_exception。当在异常处理分支中引发新的异常时,解释器能够完整串联并打印所有根本原因上下文,杜绝了底层调用链信息丢失的问题。
4.3 异构类型比较规则的彻底禁止
Python 2 允许对完全无关的数据类型进行大小比较,其内部规则竟然依赖类型名称的 ASCII 码排列。例如在 Python 2 中,"100" > 50 的求值结果为 True(因为 'str' > 'int')。这种无意义的比对导致很多由于拼写或数据反序列化不一致引入的 Bug 得以长时间潜伏。
Python 3 全面收紧了比较协议:非数值类型之间禁止进行不可比较的顺序运算(如 <、<=、>、>=)。若对不同类别的实例进行顺序比较,直接抛出 TypeError。
五、代码迁移与跨版本验证方法
面对依然存留在特定工业软件或老旧环境中的 Python 2 代码,将其升级到 Python 3 应遵循标准化迁移步骤:
- 语法与模块扫描:使用自动化工具(如
2to3、modernize或futurize)对源码进行静态扫描,自动修复基础语法差异(如print、except ... as、模块重命名如ConfigParser改为configparser)。 - 显式重构 I/O 与编码边界:审查所有网络通信、文件读写及加密哈希逻辑,严格在程序入口将
bytes解码为str,在核心业务层全量使用str,在出口处统一编码为bytes,建立清晰的“Unicode 三明治”架构。 - 替换全量集合依赖:检查依赖
dict.keys()返回列表就地修改或切片索引的代码,显式包裹list(),并将d.has_key(k)全量替换为标准k in d。 - 单元测试双向验证:启用 Python 3.x 解释器执行回归测试套件,重点关注除法是否遗留精度偏差、混合类型列表排序是否触发
TypeError。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















