


为什么数据分析新人现在该直接学pandas3.0而不是2.x?
深入解析为什么数据分析新人应当直接跨入pandas 3.0时代。从Copy-on-Write机制、PyArrow原生支持、心智模型简化与代码现代化的角度,提供系统对比、实操验证与学习路径规划。
SettingWithCopyWarning 警告以及高内存低效率的 object 字符串对象等历史包袱;而 pandas 3.0 通过默认启用 Copy-on-Write(写入时复制)、全面扶正 PyArrow 原生数据引擎并彻底剔除淘汰废弃 API,为初学者提供了清晰直观的心智模型。现在直接起步 3.0,既能避免“先学坏习惯再推倒重练”的沉没成本,也能直接对齐现代 Python 数据工程的标准范式。
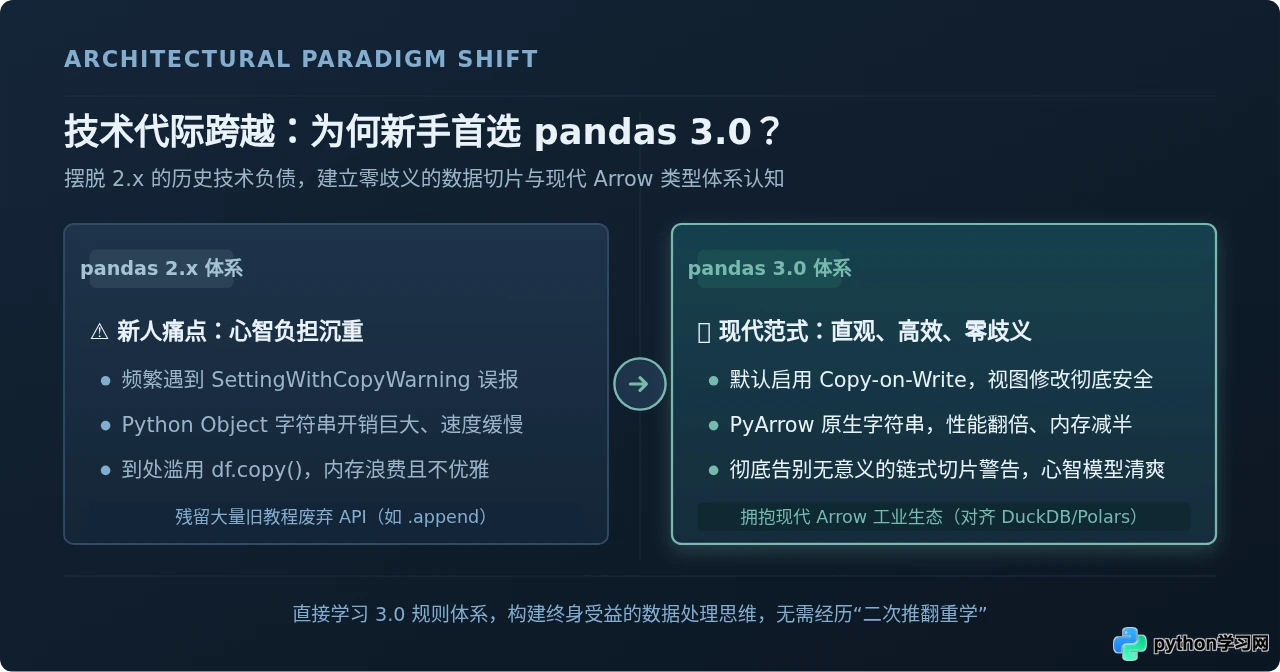
假设你今天刚刚决定入局 Python 数据分析。在网上一搜,你找到的大多是几年前基于 pandas 1.x 或 2.x 编写的入门教程。你照着教程打下第一段数据筛选代码,修改了某一列,控制台立刻弹出一长串令人心慌的红色警告:SettingWithCopyWarning: A value is trying to be set on a copy of a slice from a DataFrame。去网上查,有人教你写 df.copy(),有人让你用 .loc,但谁也讲不清为什么有时候能改动原数据、有时候改动的却是临时副本。
这并非你的理解能力有问题,而是旧版 pandas 历史架构在“浅拷贝、深拷贝与内存视图”问题上长期存在设计妥协。好消息是,随着 pandas 3.0 的发布与全面普及,这些困扰了整个 Python 社区十余年的底层顽疾被彻底根治。对于没有任何历史项目负担的新人而言,直接从 pandas 3.0 起步,不仅能省去大量无意义的调试折磨,还能直接建立起现代数据分析的规范逻辑。
一、底层架构演进:从脆弱的 NumPy Object 到稳固的 PyArrow
在 pandas 2.x 及更早时期,pandas 默认依赖 NumPy 作为底层存储引擎。NumPy 在处理纯整型、浮点型数值计算时表现极其优异,但在面对现代业务分析中最常见的文本字符串与包含缺失值(NaN)的列时,暴露出极为严重的架构缺陷。
在旧版体系中,任何文本列都会被标记为 object 类型。这个 object 本质上存储的是一个个指向 Python 原生字符串对象的内存指针,分散在系统的各个角落。这导致两个直接后果:其一,内存占用经常膨胀至实际文本体积的 4 到 8 倍;其二,由于无法利用 CPU 缓存与 SIMD 向量化指令,字符串匹配、切片和清洗操作奇慢无比。更为尴尬的是,旧版数值列一旦混入缺失值 np.nan,整型列就会被静默强转为 float64,令许多刚刚接触类型系统的新手困惑不已。
pandas 3.0 则完成了向现代高性能列式内存标准——Apache Arrow 的大步迁徙。Arrow 提供了原生的字符串格式和统一的位图空值机制(Null Bitmap)。
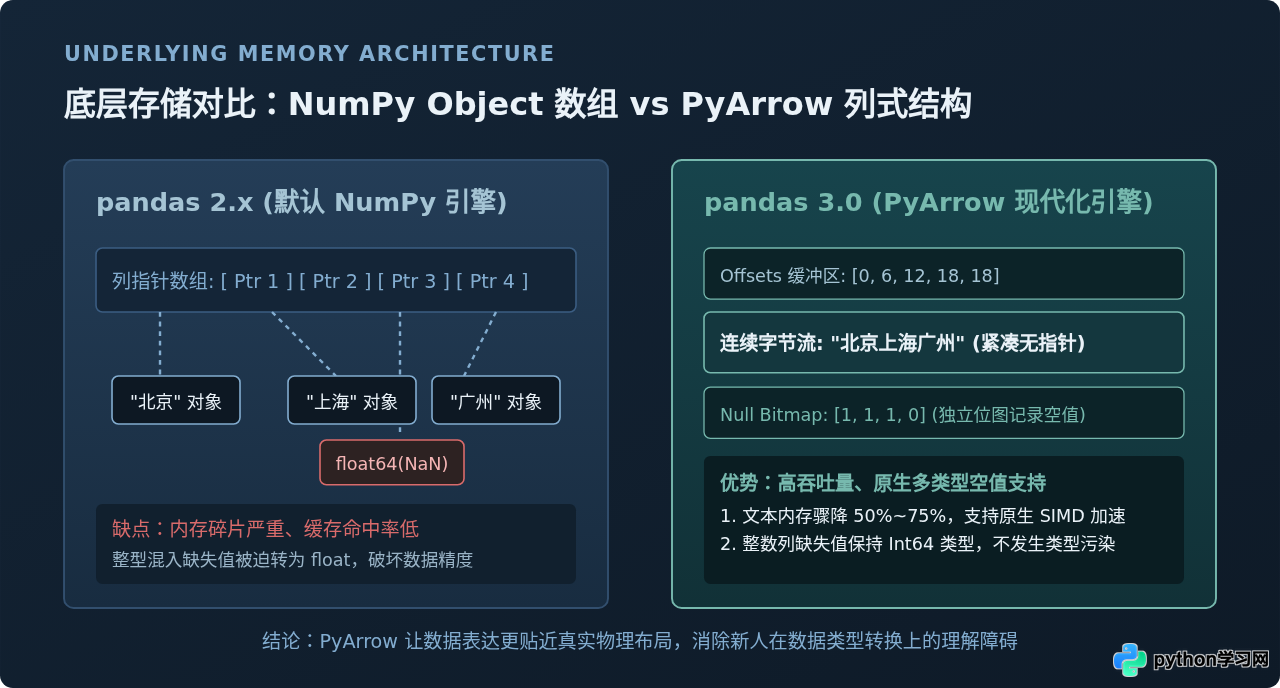
对新手而言,这意味着你从第一天起处理文本数据,就不再需要纠结“为什么 df['城市'].str.contains(...) 经常卡死几十秒”,也不用再为了保留整数列的空值而死记硬背 Int64 与 int64 的细微大小写区别。pandas 3.0 让“数据是什么,存下来就是什么”变得水到渠成。
二、告别歧义:Copy-on-Write 带来清晰的心智模型
如果说底层存储解决的是运行效率,那么 Copy-on-Write(CoW,写入时复制) 解决的则是初学者最头疼的代码行为不可预测性。
2.1 旧版 2.x 的困局:视图与副本的“薛定谔状态”
在 2.x 中,当你执行 sub_df = df[df['age'] > 18] 时,返回的 sub_df 到底是原 DataFrame 的一段内存视图(View),还是开辟了一块新内存的独立副本(Copy)?答案往往取决于底层内存是否连续、数据类型是否统一。连许多经验丰富的工程师都无法凭借直觉断定。当你试图为 sub_df['status'] = 'Adult' 赋值时:
- 如果是视图,原
df被悄悄修改,导致严重的副作用 bug; - 如果是副本,原
df没有任何改变,但 pandas 无法确定你的初衷,于是抛出臭名昭著的SettingWithCopyWarning。
新手往往被教导“无论何时只要切片,后面一定要加 .copy() 防御”。这不仅代码臃肿难看,而且每调用一次 .copy() 就全量复制一次内存,直接造成严重的算力与内存浪费。
2.2 3.0 的核心解法:延迟复制,完全安全
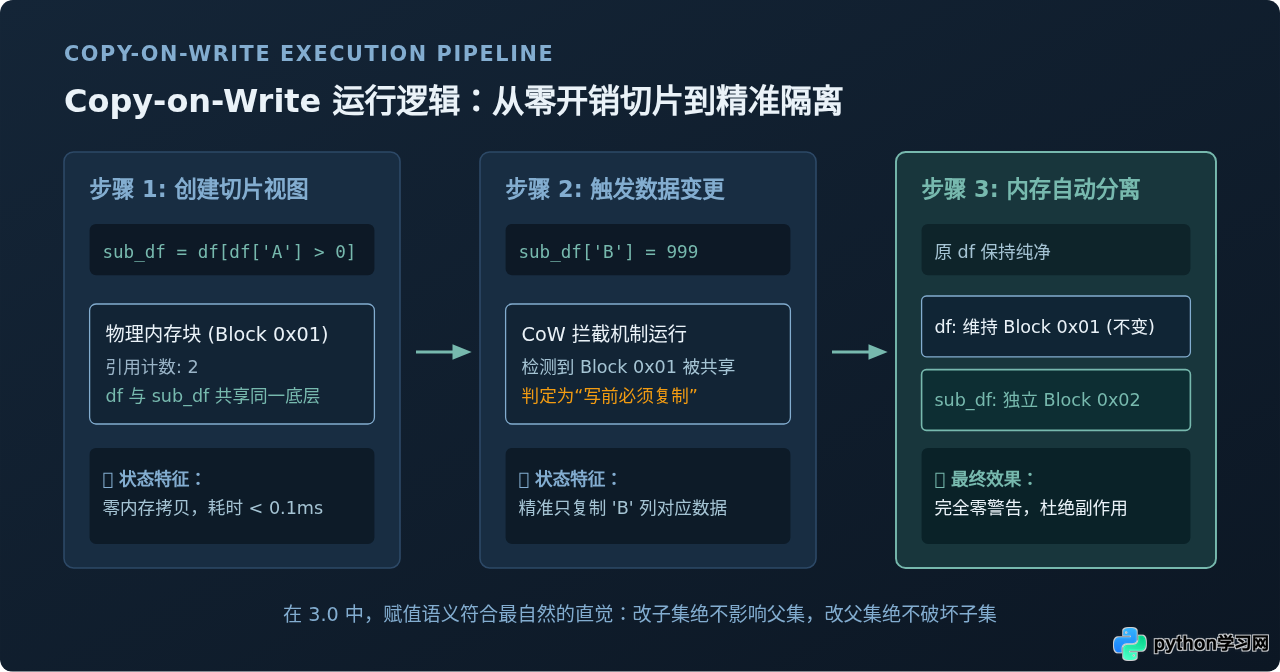
在 pandas 3.0 中,Copy-on-Write 成为全局强制默认行为。它的运行哲学非常简单而优雅:
- 读取与切片绝对安全: 无论你怎么切片、过滤,只要你只是读取,pandas 一律不分配新内存,而是直接复用原数组,速度极快;
- 写入时自动隔离: 一旦你尝试对切片后的子集做修改,pandas 会在修改发生的那一瞬间,仅仅为被修改的那一列制作副本,并将引用切断。原 DataFrame 受到绝对保护,绝不会被意外破坏;
- 警告彻底退场: 既然行为百分之百确定,
SettingWithCopyWarning失去了存在的必要,在 3.0 中被完全淘汰。
让我们通过一段直观的代码对比,看看 2.x 与 3.0 的行为差异:
import pandas as pd

# 初始化样本数据
df = pd.DataFrame({"category": ["A", "B", "A", "C"], "sales": [100, 200, 150, 300]})

# 筛选子集
subset = df[df["category"] == "A"]

# 修改子集中的数值
subset["sales"] = 999

# 【pandas 2.x 旧行为】:
# 1. 终端弹出红色 SettingWithCopyWarning
# 2. 初学者无法断定 df 的 sales 是否被同步改成 999

# 【pandas 3.0 新行为】:
# 1. 没有任何警告,控制台干脆利落执行
# 2. df['sales'].tolist() 依然是 [100, 200, 150, 300],原数据安全无虞
# 3. subset['sales'].tolist() 为 [999, 999],修改精确生效
三、语法减负:彻底丢弃淘汰 API 与不良历史习惯
编程学习中最痛苦的并不是“学新东西”,而是“先学会了错误的东西,过半年再痛苦地纠正”。如果你现在跟着基于 2.x 或 1.x 录制的旧视频学习,你会学到大量早已被弃用甚至在 3.0 中直接抛出 AttributeError 的过时写法。
| 功能场景 | 旧版 1.x/2.x 常见淘汰写法(切勿再学) | pandas 3.0 推荐现代化标准写法 |
|---|---|---|
| 追加单行或多行数据 | df.append(new_row)(在 3.0 中已被彻底移除) |
pd.concat([df, new_df], ignore_index=True) |
| 缺失值填充与类型替换 | df.fillna(..., inplace=True)(就地修改容易破坏链式调用与 CoW) |
df = df.fillna(...) 或方法链式处理 |
| 复杂多步数据清洗 | 反复创建临时变量:df1 = df[...] |
使用 .pipe()、.assign() 构成流畅的方法链(Method Chaining) |
| 字符串处理与正则匹配 | 隐式依赖 Python 解释器慢速循环循环处理文本 | 结合 dtype="string[pyarrow]" 执行原生向量化文本清洗 |
| 时间序列频率别名 | 使用过时的非标准字符(如 'M'、'H' 别名混乱) |
统一符合 ISO 规范的标准化频率别名(如 'ME' 表示月末) |
在旧体系里,为了做所谓“性能优化”,很多人养成了滥用 inplace=True 的习惯。然而在底层,绝大多数 inplace=True 根本没有在原内存就地修改,反而暗中复制了一份再重新赋值,不仅破坏了函数式编程的连贯性,还常常诱发隐蔽的数据覆盖 bug。在 3.0 中,inplace=True 在大量核心方法中被正式废弃。新人直接学习基于“赋值返回”或“链式流水线”的现代书写风格,代码质量从一开始就能达到生产级标准。
四、新人上手实操:配置现代化运行环境(操作步骤)
现在,我们通过清晰的四步流程,带你从零搭建并验证一个纯粹的 pandas 3.0 现代化分析环境。
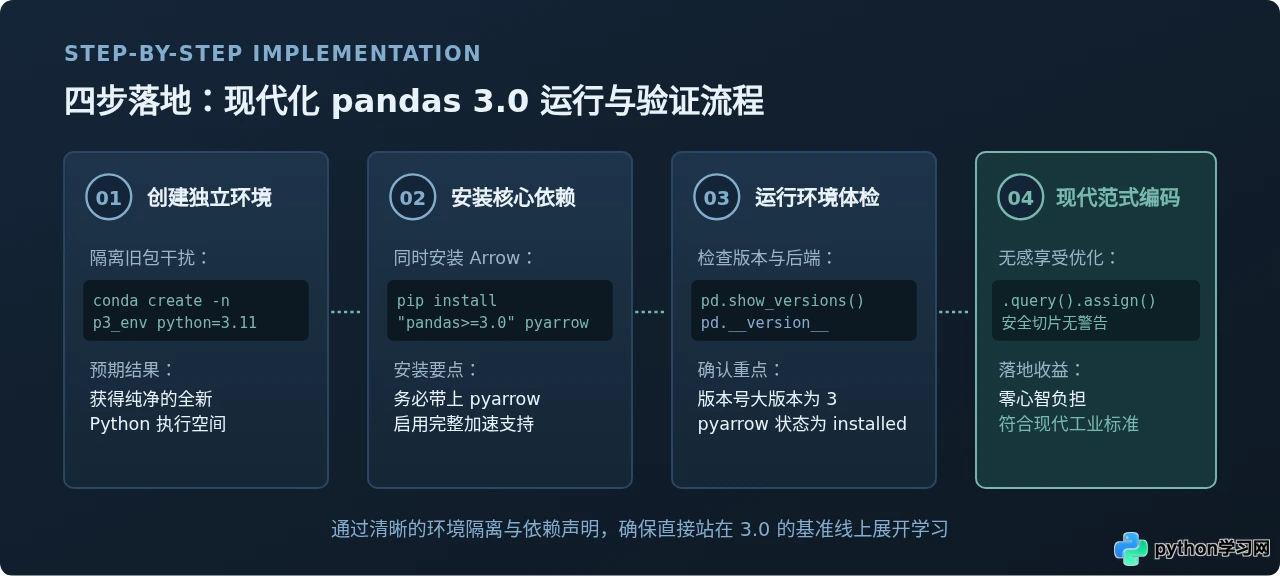
步骤一:创建隔离的 Python 运行环境
在你的终端(Terminal)或 Anaconda Prompt 中,执行以下命令,避免全局环境中的旧版包版本冲突:
# 创建一个名为 p3_analysis 的专用环境,推荐指定 Python 3.11 或更高版本
conda create -n p3_analysis python=3.11 -y

# 激活该环境
conda activate p3_analysis
步骤二:安装 pandas 3.0 与 PyArrow 依赖
在激活的环境中,直接安装 pandas 3.0。注意,一定要同步将 pyarrow 纳入安装列表,它是 3.0 高效运转的必要基石:
pip install "pandas>=3.0" pyarrow步骤三:编写自检脚本验证底层特性
创建一个名为 verify_p3.py 的测试脚本,写入以下代码并运行:
import pandas as pd

print("1. pandas 运行版本:", pd.__version__)
assert int(pd.__version__.split(".")[0]) >= 3, "当前运行的不是 pandas 3.0 及以上版本!"

# 验证 CoW 行为特性
parent_df = pd.DataFrame({"score": [85, 92, 78]})
slice_df = parent_df[parent_df["score"] > 80]
slice_df["score"] = 100  # 执行切片赋值

# 验证原父级 DataFrame 是否受到保护
if parent_df["score"].tolist() == [85, 92, 78]:
    print("2. Copy-on-Write 机制验证通过:父级数据保持完整,无警告抛出!")

# 验证原生 Arrow 字符串存储
s = pd.Series(["北京", "上海", None], dtype="string[pyarrow]")
print("3. PyArrow 字符串类型就绪:", s.dtype)
print("\n=== 环境体检合格,可以开始编写现代 pandas 代码 ===")
执行 python verify_p3.py,当你看到控制台打印出合格字样且没有弹出任何红色警告时,说明你的现代化学习环境已经完全就绪。
五、现代工业生态互通:对齐 DuckDB 与 Polars
学习数据分析从来不是只学一个孤立的库。在当下的数据工程实践中,Arrow 已经成为现代数据栈的通用语言(Lingua Franca)。
在以前,如果你想把 pandas 2.x 的 DataFrame 传给高性能本地分析数据库 DuckDB,或者与 Polars 进行跨框架调用,系统必须在内存中把数据“序列化—反序列化”重新转换一遍,不仅慢,而且耗费双倍内存。而在 pandas 3.0 中,由于大家底层都遵循相同的 Apache Arrow 内存格式,DataFrame 可以在 DuckDB、Polars、PySpark 之间实现零拷贝互通(Zero-Copy Sharing)。
新人今天直接学 pandas 3.0 的 Arrow 机制,未来如果遇到几十 GB、需要迁移到 DuckDB 或 Polars 的更重型分析场景,你所积累的列式过滤、类型感知等思维可以直接无缝平移,无需从零重构心智模型。
六、总结与新人学习路径规划
掌握一门技术工具,最重要的不是死记硬背每个参数,而是建立起符合底层设计原则的思考方式。下方的路径图为你梳理了初学 pandas 3.0 应当重点投入的技能领域与坚决规避的误区。
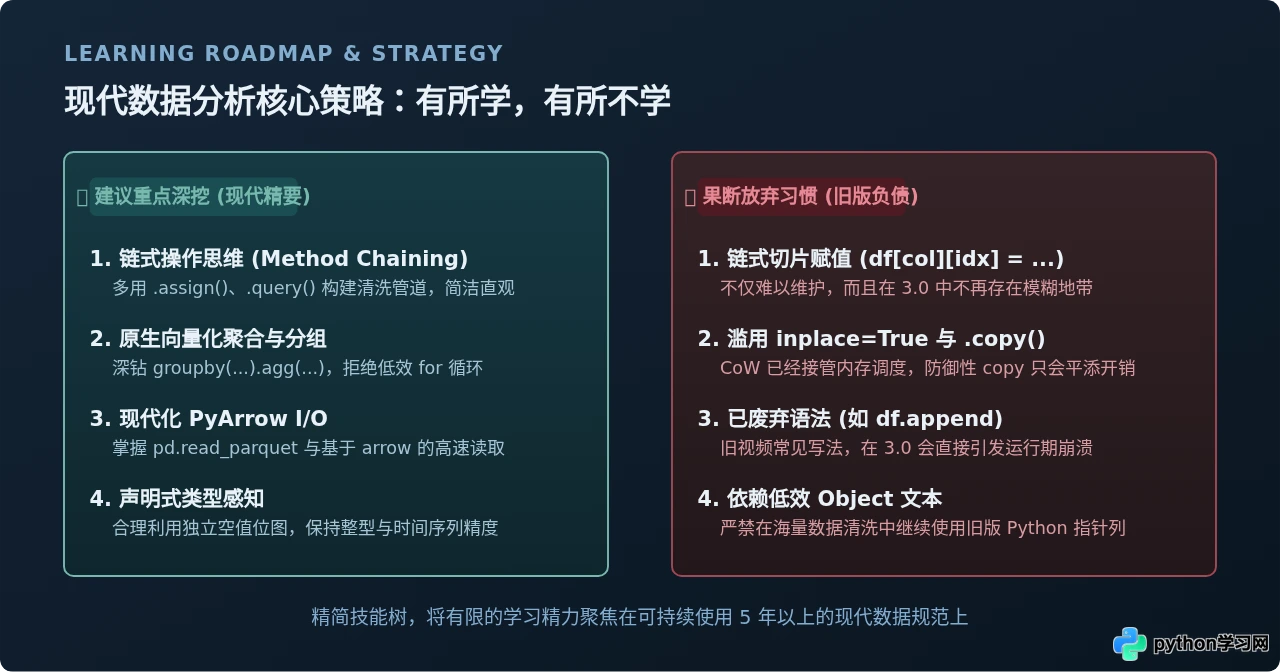
对任何刚刚接触编程工具的学习者来说,时间都是最宝贵的资产。pandas 3.0 绝非一个可有可无的常规迭代,而是一次对自身十年技术债务的系统清算。跳过 2.x 的历史弯路,直接踏入 3.0 的世界,你得到的不仅是更快的运行速度,更是清晰、稳定且对现代数据工业真正有用的专业技能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















