


Python非参数检验前怎么做正态性判断:Shapiro-Wilk检验与决策流程
在Python中进行两组或多组均值比较前,如何使用Shapiro-Wilk检验与Q-Q图对连续变量进行正态性判断,并根据样本量和分布特征在参数检验和非参数检验之间做出科学决策。
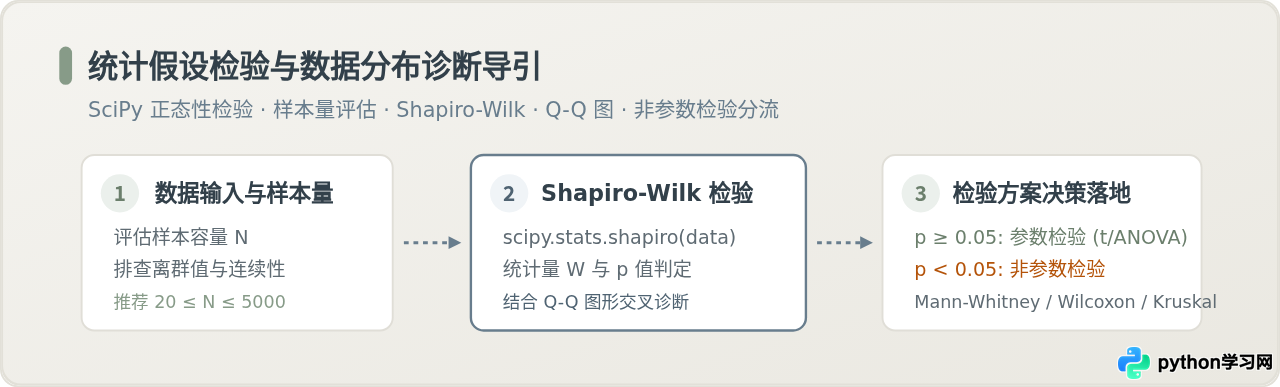
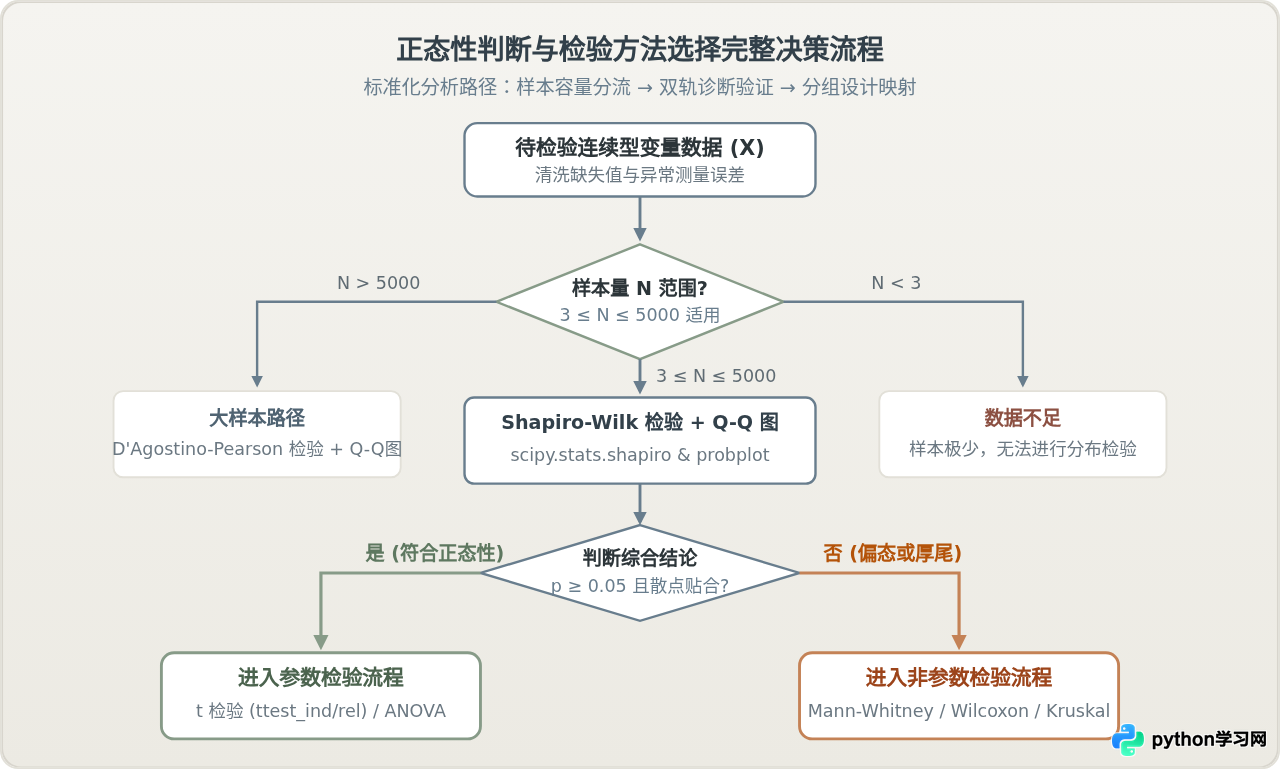
在 Python 数据分析与推断统计中,选择参数检验(如独立样本 t 检验、单因素方差分析)还是非参数检验(如 Mann-Whitney U 检验、Kruskal-Wallis 检验),关键前提在于判断数据是否满足正态分布假设。直接使用 scipy.stats.shapiro 执行 Shapiro-Wilk 检验是中小样本下功效极高的方法,但仅看单一数值容易因小样本欠灵敏或大样本过灵敏而误判。规范的做法是以样本量判定为起点,以 Shapiro-Wilk 检验的统计量 W 与 p 值为基准,协同 Q-Q 图的分位数形态进行综合裁定,再根据比较分组设计匹配对应的检验函数。
一、为什么进入非参数检验前必须做正态性判断
统计推断中的假设检验主要分为参数检验与非参数检验两大类。参数检验对总体分布形态有严格假定,最典型的假定就是数据服从正态分布。当数据符合正态分布时,基于均值和标准差的参数检验拥有更高的统计功效(Statistical Power),能够以更高的概率检测出真实存在的效应;但当数据严重偏态或存在明显厚尾时,参数检验的 I 类错误率可能会膨胀,导致不真实的显著性结论。
非参数检验(又称分布无关检验)直接基于数据的秩次(Rank)进行计算,对分布形态不作严格正态假定。然而,如果数据原本符合正态分布却直接滥用非参数检验,会损失约 5% 到 15% 的检验功效,可能遗漏微小但有意义的实际差异。因此,在分析管线中建立标准化、可复现的正态性判断流程,是统计建模前的必要步骤。
二、Shapiro-Wilk 检验的统计原理与判定逻辑
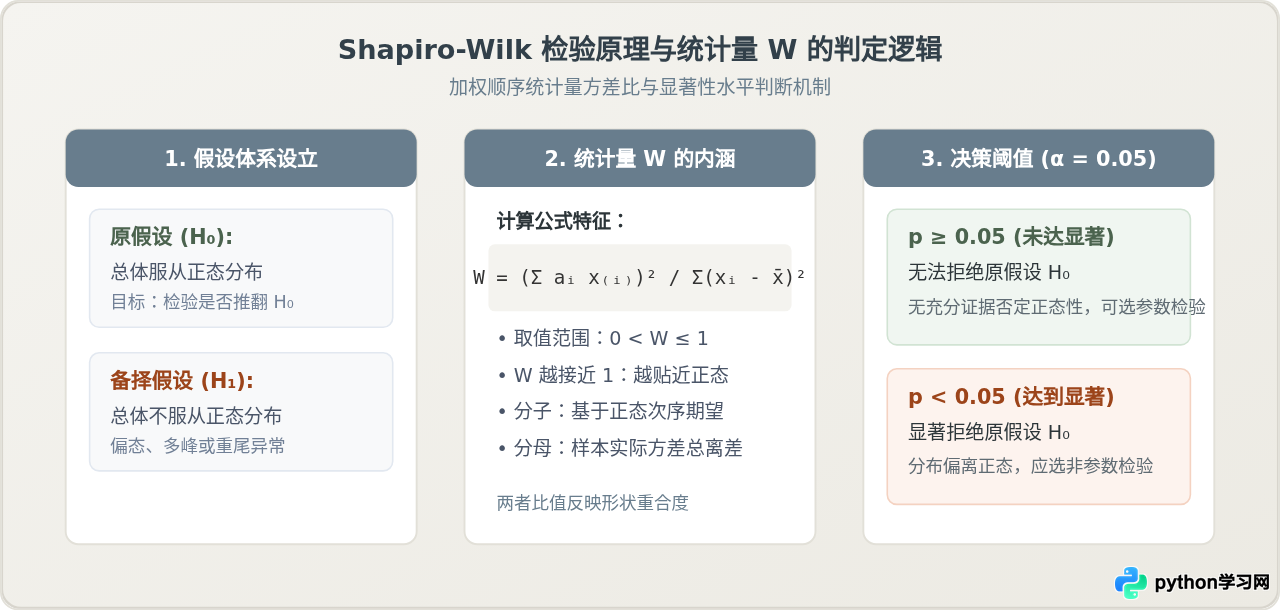
Shapiro-Wilk 检验由 Samuel Sanford Shapiro 和 Martin Wilk 于 1965 年提出。它的统计原假设与备择假设定义如下:
- 原假设 H₀:样本所来自的总体服从正态分布。
- 备择假设 H₁:样本所来自的总体不服从正态分布。
该检验通过计算统计量 W 来衡量数据与正态分布的吻合程度。具体来说,它将样本观测值按升序排列得到顺序统计量 x₍₁₎ ≤ x₍₂₎ ≤ ... ≤ x₍ₙ₎,然后计算顺序统计量的加权线性组合与样本离均差平方和的比值:
其中系数向量 a = (a₁, ..., aₙ)ᵀ 由标准正态分布顺序统计量的期望值和协方差矩阵精确推导得出。统计量 W 的取值范围严格在 0 到 1 之间。若数据高度吻合正态分布,分子与分母高度同步,W 极度逼近 1;若分布偏斜或有异常厚尾,W 将显著变小。
三、Python 中使用 scipy.stats.shapiro 的具体实践
在 Python 科学计算生态中,SciPy 提供了现成的 scipy.stats.shapiro 函数。该函数接收一个一维数组或类似序列的对象,返回一个命名元组(包含 statistic 和 pvalue 两个属性)。
以下示例在一致的实验框架下分别生成正态分布样本与偏态分布样本,演示具体的代码调用与输出解读。
1. 正态样本与对数正态样本的检验对比代码
# 运行环境:Python 3.8+,依赖库:scipy >= 1.7.0, numpy >= 1.20.0
import numpy as np
from scipy import stats

# 设置随机种子保证结果可复现
np.random.seed(42)

# 场景 A:生成来自正态分布的样本 (N = 60)
normal_data = np.random.normal(loc=10.0, scale=2.5, size=60)

# 场景 B:生成来自右偏对数正态分布的样本 (N = 60)
skewed_data = np.random.lognormal(mean=1.5, sigma=0.75, size=60)

# 执行 Shapiro-Wilk 正态性检验
res_normal = stats.shapiro(normal_data)
res_skewed = stats.shapiro(skewed_data)

print(f"[场景 A 正态样本]   统计量 W = {res_normal.statistic:.4f}, p 值 = {res_normal.pvalue:.4f}")
print(f"[场景 B 偏态样本]   统计量 W = {res_skewed.statistic:.4f}, p 值 = {res_skewed.pvalue:.4e}")
在场景 A 中,统计量 W = 0.9852 极为接近 1,对应 p = 0.6781 > 0.05。在 α = 0.05 水平下无法拒绝原假设,表明样本没有显示出偏离正态的统计学证据。在场景 B 中,统计量 W = 0.7712,p 值远小于 0.001,直接推翻原假设,明确指示不能采用标准参数检验。
scipy.stats.shapiro 仅接收单组一维数据。如果你正在准备双样本 t 检验或方差分析,切勿将两组或多组数据拼合成一个整体去检验正态性。各组样本必须分别独立进行正态性检验,或者检验整体拟合后的残差(Residuals)正态性。
四、关键差异分析:假设检验与图形诊断的互补机制
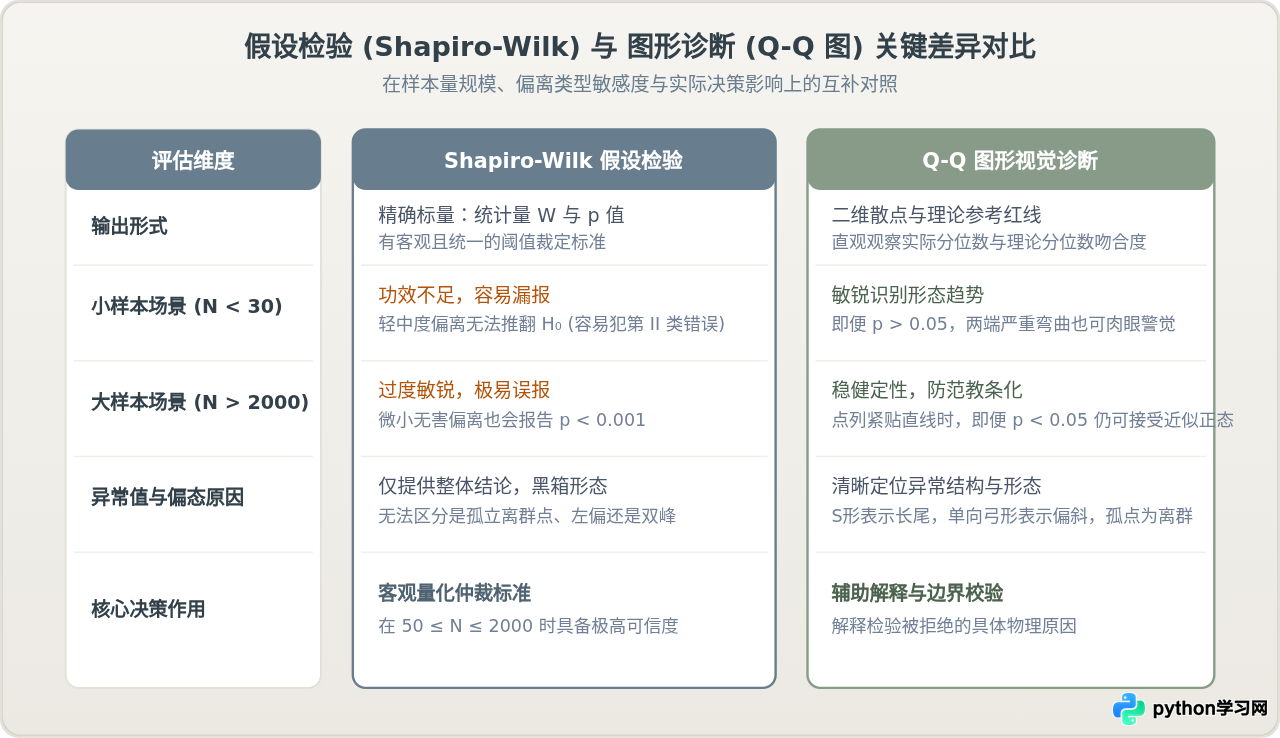
统计学界普遍反对“仅凭 p > 0.05 或 p < 0.05 就孤立下结论”的做法。在正态性诊断中,单一的 Shapiro-Wilk 数值检验与直观的 Q-Q 图(Quantile-Quantile Plot)具有截然不同的灵敏度特性。理解两者在小样本与大样本条件下的行为差异,是避免错误决策的关键。
2. 绘制 Q-Q 图与直方图的完整诊断脚本
通过 scipy.stats.probplot 结合 matplotlib,可以清晰展现分位数在理论直线上的分布状态:
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

def inspect_normality(data: np.ndarray, title_prefix: str = "样本分布"):
    """综合输出 Shapiro-Wilk 检验结果并绘制诊断图"""
    # 计算 Shapiro-Wilk 统计量
    w_stat, p_val = stats.shapiro(data)

    fig, axes = plt.subplots(1, 2, figsize=(10, 4.2), dpi=100)

    # 子图 1:直方图与核密度/拟合曲线
    axes[0].hist(data, bins="auto", density=True, alpha=0.6, color="#687D8D", edgecolor="#FFFFFF")
    mu, std = np.mean(data), np.std(data, ddof=1)
    x_range = np.linspace(min(data), max(data), 100)
    axes[0].plot(x_range, stats.norm.pdf(x_range, mu, std), color="#879B88", lw=2, label="理论正态曲线")
    axes[0].set_title(f"{title_prefix} - 直方图", fontsize=11)
    axes[0].legend(frameon=True, fontsize=9)

    # 子图 2:Q-Q 分位数对比图
    stats.probplot(data, dist="norm", plot=axes[1])
    axes[1].get_lines()[0].set_color("#687D8D")      # 样本散点颜色
    axes[1].get_lines()[0].set_markersize(5)
    axes[1].get_lines()[1].set_color("#C48256")      # 理论参考红线
    axes[1].get_lines()[1].set_linewidth(1.8)
    axes[1].set_title(f"Q-Q 图 (W={w_stat:.4f}, p={p_val:.4f})", fontsize=11)

    plt.tight_layout()
    plt.show()

# 示例调用
sample = np.random.normal(loc=50, scale=8, size=45)
inspect_normality(sample, title_prefix="组别A试验数据")
五、检验完成后的决策矩阵:参数与非参数方法匹配
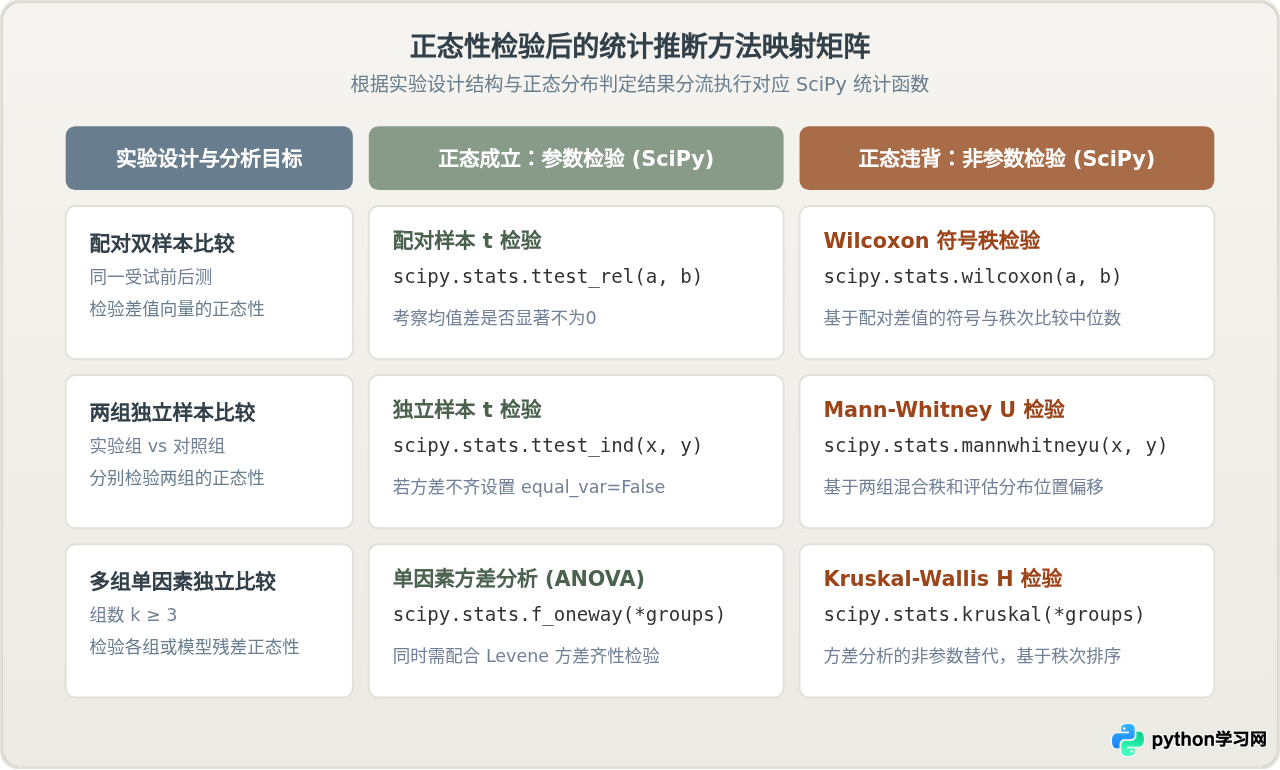
完成正态性诊断后,分析者需要根据实验设计类型(单组设计、独立双组、配对双组或多组),准确选择对应的 SciPy 统计函数。
自动化决策管道代码示例
为了让整个判断与分流流程自动化执行,可以将样本量校验、Shapiro-Wilk 检验与后续建议整合成一个 Python 工具函数:
import numpy as np
from scipy import stats

def choose_two_sample_test(group_a: np.ndarray, group_b: np.ndarray, alpha: float = 0.05):
    """
    执行正态性与方差齐性联合诊断,自动给出检验决策建议。
    """
    na, nb = len(group_a), len(group_b)

    # 步骤 1:样本容量判断
    if na < 3 or nb < 3:
        raise ValueError("单组样本量必须大于等于 3 方可计算正态性检验。")

    # 步骤 2:对两组分别执行 Shapiro-Wilk 正态性检验
    res_a = stats.shapiro(group_a)
    res_b = stats.shapiro(group_b)

    is_normal_a = res_a.pvalue >= alpha
    is_normal_b = res_b.pvalue >= alpha
    both_normal = is_normal_a and is_normal_b

    print("=" * 55)
    print("【分布与假设检验诊断报告】")
    print(f"组 A (N={na}): W={res_a.statistic:.4f}, p={res_a.pvalue:.4f} -> {'正态' if is_normal_a else '偏态/非正态'}")
    print(f"组 B (N={nb}): W={res_b.statistic:.4f}, p={res_b.pvalue:.4f} -> {'正态' if is_normal_b else '偏态/非正态'}")

    # 步骤 3:根据正态性与方差齐性给出推荐
    if both_normal:
        # 检验方差齐性
        _, p_levene = stats.levene(group_a, group_b)
        equal_var = p_levene >= alpha
        print(f"方差齐性 (Levene): p={p_levene:.4f} -> {'方差齐' if equal_var else '方差不齐'}")

        stat, p = stats.ttest_ind(group_a, group_b, equal_var=equal_var)
        test_name = "Student's t-test" if equal_var else "Welch's t-test"
        print(f"推荐方案: 参数检验 [{test_name}] (statistic={stat:.4f}, p={p:.4f})")
    else:
        stat, p = stats.mannwhitneyu(group_a, group_b, alternative='two-sided')
        print(f"推荐方案: 非参数检验 [Mann-Whitney U 检验] (U={stat:.1f}, p={p:.4f})")
    print("=" * 55)

# 示例验证:两组服从卡方偏态分布的数据比较
sample_1 = np.random.chisquare(df=3, size=35)
sample_2 = np.random.chisquare(df=4, size=35)
choose_two_sample_test(sample_1, sample_2)
六、实践中的三个核心注意事项
- 样本量超过 5000 时的处理:SciPy 早期版本对超过 5000 样本的输入会抛出警告。虽然现代版本优化了算法实现,但在大样本(N > 5000)下,Shapiro-Wilk 检验的统计功效极高,即使数据与正态分布仅有极细微、在实际业务中完全可以忽略的偏离,p 值也会小于 0.05。此时应优先使用
scipy.stats.normaltest(D'Agostino-Pearson 偏度与峰度联合检验),并结合 Q-Q 图的实际贴合度做定性判断。 - 不能把全部组别合并做单次检验:若对比组间原本就存在显著均值差,将两组数据直接拼接后求正态检验,往往会呈现人工造成的双峰(Bimodal)分布,导致 Shapiro-Wilk 错判为非正态。必须分别检验各组的正态性,或者使用回归模型拟合后的残差进行检验。
- 警惕孤立异常值对 W 统计量的破坏:单极大的离群值会剧烈拉大分母中的离均差平方和,导致 W 骤降并报告显著非正态。遇到该情况时,应首先通过箱线图核对该数值是否为录入错误或仪器故障;若为真实极端值,选择非参数检验是保持统计推断稳健性的标准策略。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















