


Python map函数实现多列表并行映射的方法
详细讲解 Python 中使用 map() 函数实现多列表并行映射的方法、底层原理、参数对齐规则、短板截断机制以及与列表推导式和 zip 的选型对比。
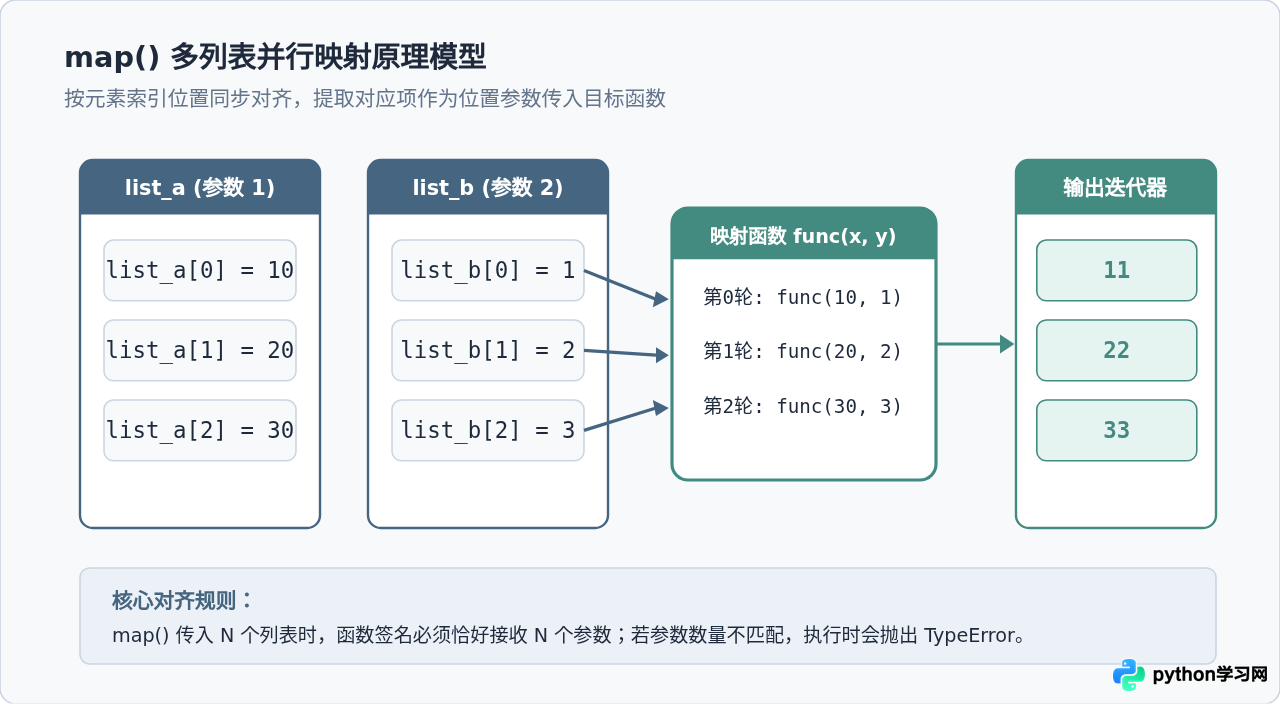
在 Python 中使用 map() 函数实现多列表并行映射,核心方法是直接在 map() 中传入多个列表作为参数:map(func, list1, list2, ...)。此时作为第一个实参的映射函数 func 必须接收与传入列表数量完全相等的形参。执行时,map() 会按索引位置同步提取每个列表的对应元素,组合后传入函数中进行并行计算,直到最短的列表遍历结束为止。返回结果为一个惰性迭代器,可通过 list() 直接获取映射后的完整列表。
一、多列表并行映射的核心机制与调用形式
很多初学者以为 map() 只能接收一个序列参数(例如对单一列表批量转整型),但在 Python 官方规范中,map() 的完整定义为 map(function, iterable, *iterables)。星号语法意味着它可以接收任意数量的可迭代对象。
当传入多个可迭代对象时,map() 的迭代逻辑与内置的 zip() 类似:在第 i 轮迭代中,它会依次取出 iterable1[i]、iterable2[i] 直至第 N 个列表的第 i 项,然后以位置参数的形式执行 function(iterable1[i], iterable2[i], ...)。
二、标准操作实施流程与基础代码示例
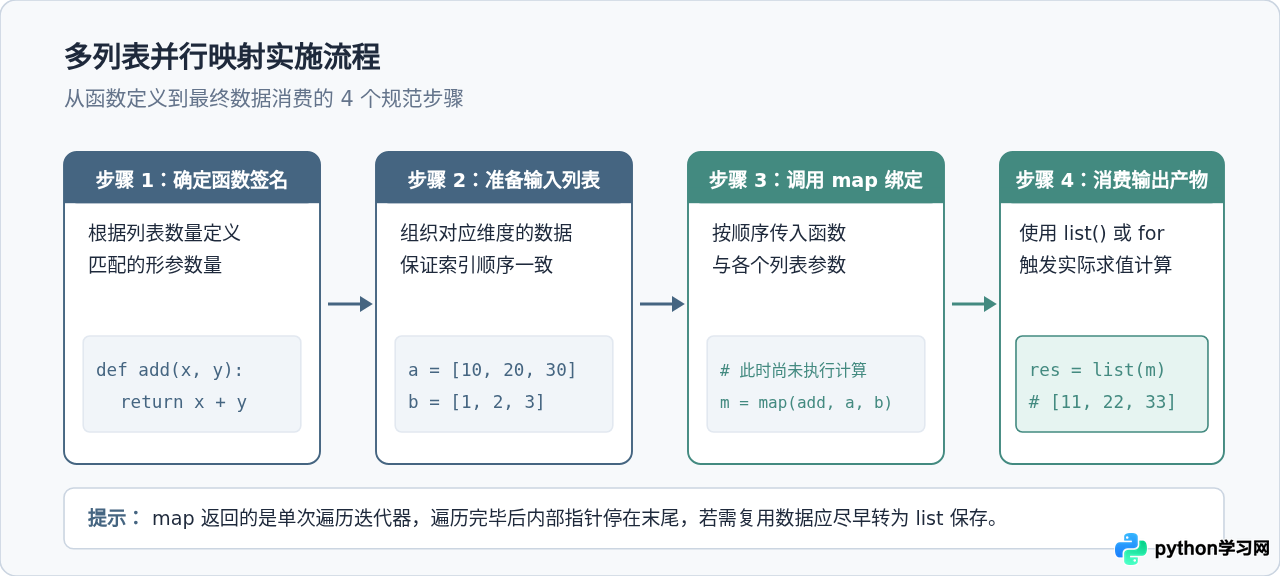
实现多列表并行映射,通常遵循四个标准步骤:定义对应参数签名的目标函数、准备并行列表、调用 map() 建立映射关系、消费迭代器获取最终结果。
1. 使用命名函数(def)
当映射逻辑较为复杂、包含分支判断或需要详细类型提示时,推荐使用 def 独立定义函数:
# 示例代码:计算坐标点的欧几里得距离
import math

def calculate_distance(x, y):
    return round(math.sqrt(x**2 + y**2), 2)

x_coords = [3, 5, 8]
y_coords = [4, 12, 15]

# 传入函数名以及两个列表
distances = map(calculate_distance, x_coords, y_coords)
result = list(distances)
print(result)[5.0, 13.0, 17.0]
2. 使用匿名函数(lambda)
对于简短的行内计算,可以使用 lambda 表达式。需要特别注意的是,lambda 的参数声明列表必须使用逗号隔开多个参数:
# 示例代码:两个列表按位置做加权求和
weights = [0.2, 0.3, 0.5]
scores = [80, 90, 95]

# lambda 声明两个形参 w 和 s,与传入的两个列表一一对应
weighted_scores = list(map(lambda w, s: round(w * s, 1), weights, scores))
print(weighted_scores)[16.0, 27.0, 47.5]
3. 使用内置操作符(operator 模块)
如果计算只是标准的四则运算、比较或属性提取,推荐直接使用 Python 内置的 operator 模块。由于其函数完全由 C 语言底层实现,运行速度明显优于自定义 Python 函数或 lambda:
# 示例代码:使用 operator.add 快速合并三个列表中的数值
import operator

list_a = [1, 2, 3]
list_b = [10, 20, 30]

# operator.add 原生接收两个参数 (a, b)
sums = list(map(operator.add, list_a, list_b))
print(sums)[11, 22, 33]
三、列表长度不一致与短板截断原则
在实际生产环境中,待处理的多个数据源往往可能存在长度不完全一致的情况。理解 map() 在长度不均时的停止机制至关重要。
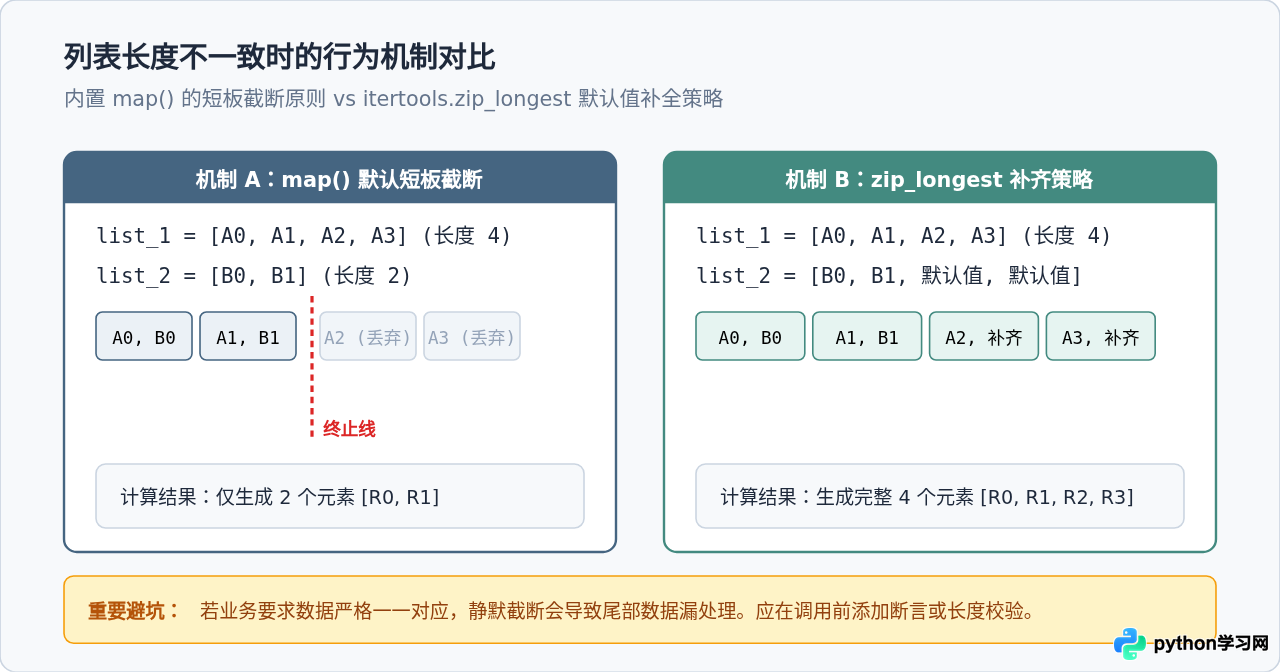
Python 3 的核心规则是“短板截断原则”:当传入的多个列表中存在长度差异时,map() 会在最短的可迭代对象被完全遍历后立即停止。较长列表中超出的多余元素会被完全忽略,不会产生任何越界警告或异常。
1. 观察默认截断行为
# 示例代码:观察长度不一致时的截断结果
keys = ['A', 'B', 'C', 'D', 'E']  # 长度为 5
values = [100, 200]               # 长度为 2

# 格式化拼接为字符串
combined = list(map(lambda k, v: f"{k}:{v}", keys, values))
print(f"结果列表: {combined}")
print(f"结果长度: {len(combined)}")结果列表: ['A:100', 'B:200']
结果长度: 2
2. 需要保留全部数据时的解决方案
若业务逻辑要求必须保留长列表的所有元素,缺失项以固定值(例如 0 或空字符串)补充,可以使用标准库 itertools.zip_longest 先进行填充对齐,再配合生成器或 starmap 进行计算:
# 示例代码:使用 itertools.zip_longest 填充缺失项
from itertools import zip_longest

keys = ['A', 'B', 'C', 'D', 'E']
values = [100, 200]

# 使用 fillvalue 指定缺失项填充内容
paired = zip_longest(keys, values, fillvalue=0)
result = [f"{k}:{v}" for k, v in paired]
print(result)['A:100', 'B:200', 'C:0', 'D:0', 'E:0']
四、三列表及更多列表的高阶实战场景
map() 不仅限于处理两个列表,在三列表或更多维度的矩阵计算、日志多列解构等场景中同样表现出色。
场景:多维度电商订单明细结算
假设我们有三个对应的列表,分别记录了商品单价、购买数量以及折扣率,需要批量计算每个订单项的折后实付总额:
# 示例代码:三个列表并行计算订单实付金额
prices = [129.0, 49.9, 88.0, 199.0]
quantities = [2, 3, 1, 4]
discounts = [0.9, 0.85, 1.0, 0.7]  # 折扣比例

def calculate_item_total(price, qty, discount):
    subtotal = price * qty * discount
    return round(subtotal, 2)

# 同时传入 3 个列表,映射函数接收 3 个实参
order_totals = list(map(calculate_item_total, prices, quantities, discounts))
print("各订单项实付金额:", order_totals)各订单项实付金额: [232.2, 127.25, 88.0, 557.2]
五、技术选型决策:map 与列表推导式、zip 的对比
在 Python 社区中,处理多个列表的并行遍历与计算通常有三种主流写法:map()、列表推导式配合 zip(),以及 itertools.starmap()。掌握它们各自的适用场景有助于写出兼顾性能与可维护性的代码。
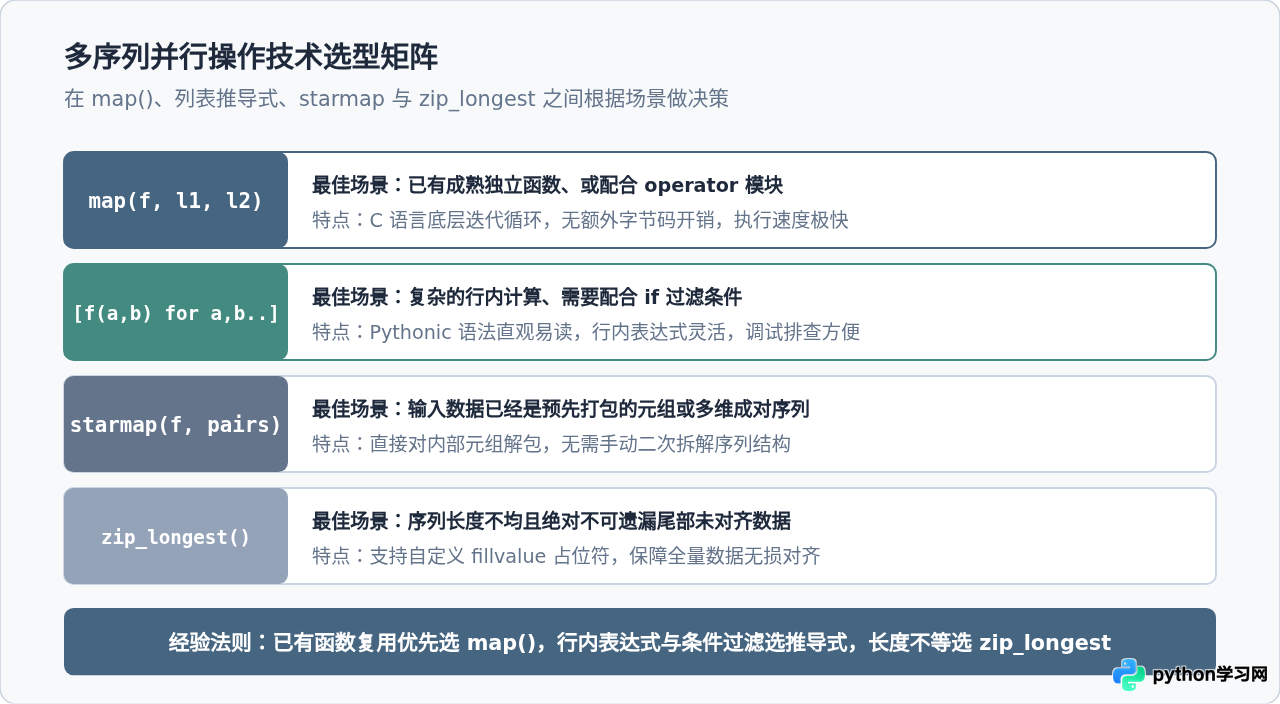
| 实现方案 | 语法形式 | 性能与开销 | 主要优势与适用边界 |
|---|---|---|---|
| map() | map(f, l1, l2) |
C 语言底层循环,内存为 O(1) 惰性迭代 | 调用命名函数时极其整洁;但内部包含复杂行内表达式时 lambda 可读性较差。 |
| 列表推导式 + zip | [f(a, b) for a, b in zip(l1, l2)] |
Python 字节码循环,直接生成完整列表 | 语法最为直观,支持添加 if 过滤;数据量极大时需改用生成器表达式。 |
| itertools.starmap | starmap(f, zip(l1, l2)) |
与 map() 相当的 C 级性能,惰性求值 | 适合数据源本身就是成对元组 [(1, 2), (3, 4)] 的场景。 |
六、常见错误与避坑清单
- 形参个数不匹配(TypeError):例如执行
map(lambda x: x * 2, list_a, list_b)。传入了 2 个列表,但lambda只定义了 1 个形参x,运行时会立即报错TypeError: <lambda>() takes 1 positional argument but 2 were given。 - 误把迭代器当成列表打印:直接
print(map(...))只会输出<map object at 0x...>。必须显式使用list()、tuple()包装,或者在for循环中遍历取值。 - 迭代器一次性消费陷阱:
map返回的是迭代器。如果已经通过list(m)或for item in m消费了一次,再次对m迭代时将得到空结果。若后续需要多次读取,务必在首次求值时保存为新变量。 - 忽视短板效应导致数据静默丢失:在数据清洗场景中,如果两列输入因缺失值导致长度不一,直接使用
map()会静默截断多余行,而不会报错。如果业务要求数据对齐,务必在执行前加入assert len(a) == len(b)校验。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















