


Python深度学习框架在数据分析中的应用:TensorFlow与PyTorch模型简介
系统解析Python两大深度学习框架TensorFlow与PyTorch在数据分析中的实际应用场景、数据管道构建、核心模型代码实现以及业务落地选型策略。
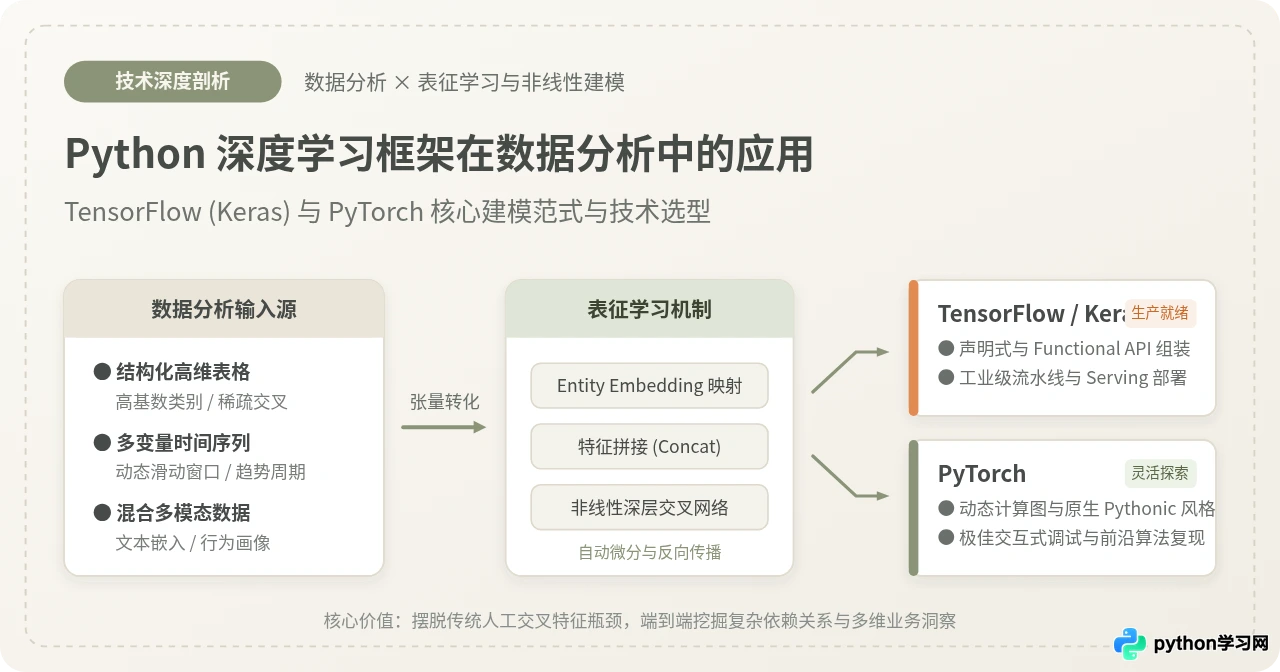
一、深度学习在数据分析中的真实定位与适用边界
在切入具体代码之前,必须先厘清一个在数据分析领域广泛存在的观念:“在预测与分类任务中,深度学习是否全面超越了 XGBoost、LightGBM 等传统机器学习模型?”
这种说法看似合理,因为在计算机视觉与自然语言处理领域,深度神经网络凭借强大的表征能力彻底取代了传统特征工程;并且依据通用近似定理(Universal Approximation Theorem),多层神经网络理论上能逼近任意复杂函数。
然而在真实数据分析场景中,该结论只有在“特征维度极高、稀疏性强、序列关联显著或存在多模态混合”的条件下才成立。对于业务中最常见的中小样本结构化表格数据,树模型的归纳偏置(Inductive Bias)是沿坐标轴做矩形空间切割,对特征缩放不敏感,且超参数容错率高。相反,神经网络若直接应用于原始密集表格,往往需要大量的特征无量纲化、精细的正则化手段与极长的超参搜索时间,其综合性价比甚至低于调优良好的 LightGBM。
因此,深度学习在数据分析中的核心价值,不是盲目替代成熟的统计学工具,而是在以下三类传统方法难以奏效的场景中发挥不可替代的优势:
- 高基数离散特征的低维表征(Entity Embedding): 当分析任务涉及城市编码、商户 ID、细分商品类目等类别数量达到几千甚至数百万的变量时,传统 One-Hot 编码会导致矩阵极度稀疏与内存爆炸,而目标编码(Target Encoding)容易引发数据泄露。深度学习的嵌入层能将高维正交类别映射为低维稠密向量,在连续几何空间中自动捕捉类别之间的内在亲疏关系。
- 多变量动态时间序列挖掘: 传感器流式数据、金融时序信号或服务器指标包含复杂的长短期依赖与非线性波动。利用循环神经网络(LSTM/GRU)或轻量级时序注意力机制(Temporal Attention),可以直接在滑动时间窗口上学习趋势与周期,无需手工构建滞后阶数特征。
- 非结构化与结构化数据的端到端融合: 例如在电商流失率分析中,既需要用户的行为频次、客单价等数值特征,又需要融合用户的售后评价文本向量。深度学习框架可以在同一个计算图内,将文本表征张量与数值特征拼接,实现真正的多源异构端到端联合建模。
二、深度学习数据分析全流程:从数据清洗到张量管道
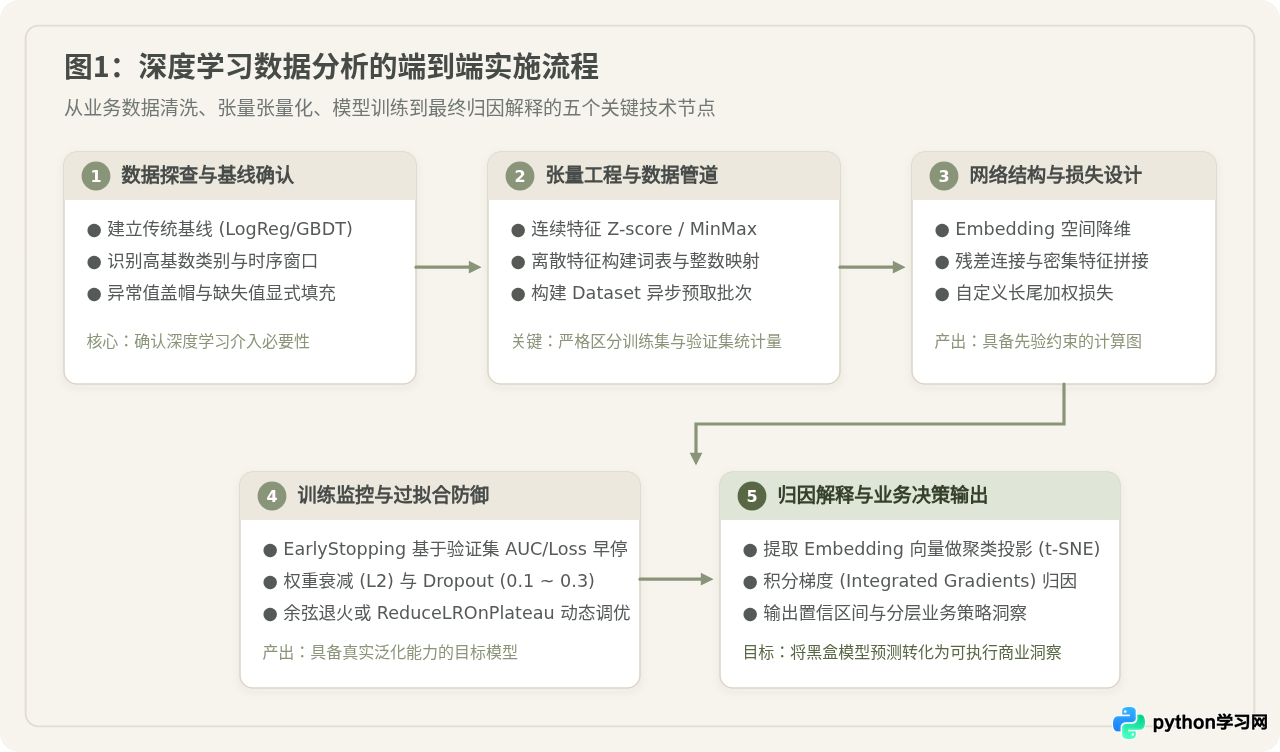
深度学习模型对输入数据有着严格的张量结构与数值分布要求。数据分析师不能像使用决策树那样直接将原始 DataFrame 传入模型,而必须遵循规范的五步工程流水线。
1. 步骤详解与实操规范
-
步骤一:特征清洗与基线确立
在设计神经网络之前,必须先用逻辑回归或轻量级树模型建立可解释的基准指标(Baseline)。对数值特征进行极值盖帽(Winsorization),显式处理缺失值;对离散特征建立连续的整数索引词表,并将未见过的测试集类别统一映射至专用的<UNK>索引。 -
步骤二:构建张量管道与无量纲化
神经网络对数值尺度高度敏感,未标准化的特征容易导致梯度弥散或优化震荡。必须在训练集上计算均值与方差(采用 Z-score 标准化)或分位数(采用 RobustScaler),并将变换参数持久化应用至验证集与测试集,严禁在全量数据上执行统一标准化以避免数据泄露。 -
步骤三:网络拓扑与针对性损失函数设计
根据业务预测目标的分布特征选择损失函数。若面对业务中常见的正负样本极端不平衡(如欺诈交易仅占 0.1%),不可简单采用标准二元交叉熵,应采用加权损失(Weighted Cross-Entropy)或 Focal Loss;若预测值具有显著的长尾偏态,可采用平滑 L1 损失(Huber Loss)或分位数损失。 -
步骤四:验证集监控与早停防御
过拟合是深度学习分析的核心风险。必须设置严格的EarlyStopping策略,监控指标应直接对应业务评价度量(如验证集 PR-AUC、ROC-AUC 或加权 F1),并结合 Dropout(失活率建议在 0.1 至 0.3 之间)与 L2 权重衰减。 -
步骤五:特征归因与业务决策输出
数据分析的终点是输出可指导业务的洞察。通过提取可学习的 Embedding 矩阵做降维聚类(如 t-SNE / UMAP 投影),分析师可以直接观察到品类间的内在关联;借助积分梯度(Integrated Gradients)或深度 SHAP,能够精确测算出各个特征对单次预测的边际贡献。
三、TensorFlow 与 PyTorch:核心建模范式与实操对比
在 Python 深度学习生态中,TensorFlow(以 Keras 为核心接口)与 PyTorch 呈现出截然不同的设计哲学。理解这种范式差异,是数据分析师根据工作流进行高效选择的前提。
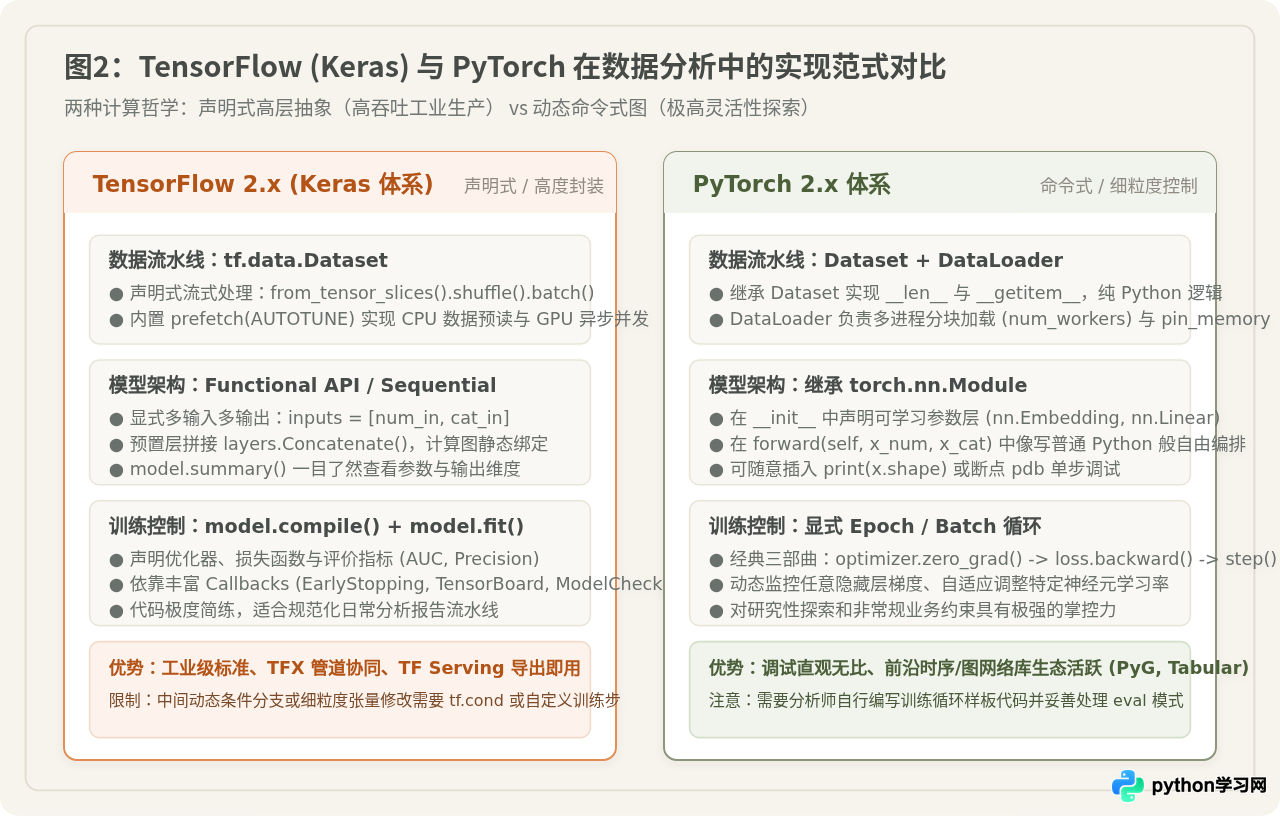
下面以电商用户购买转化预测为例:输入包含连续行为特征(如浏览时长、历史客单价)与一个高基数分类特征(如商品细分类目 ID),分别展示两个框架的完整规范实现。
1. TensorFlow (Keras Functional API) 建模实战
Keras 的函数式 API 极其适合处理多输入、特征拼接的高维分析模型。其结构声明清晰,开箱即用的训练循环高度紧凑。
import tensorflow as tf
from tensorflow.keras import layers, Model, metrics

# 1. 定义多通道输入张量:连续特征与离散类目特征
num_features_dim = 5     # 连续数值特征数量
num_categories = 1000    # 类目总数(高基数离散)
embedding_dim = 16       # 嵌入向量维度

input_num = layers.Input(shape=(num_features_dim,), name='input_num')
input_cat = layers.Input(shape=(1,), name='input_cat')

# 2. 特征表征层:类目 ID 映射为稠密向量,并展平
cat_embedding = layers.Embedding(
    input_dim=num_categories,
    output_dim=embedding_dim,
    name='category_embedding'
)(input_cat)
cat_vec = layers.Flatten(name='flatten_embedding')(cat_embedding)

# 3. 特征聚合:将数值特征与嵌入向量端到端拼接
merged = layers.Concatenate(name='feature_concat')([input_num, cat_vec])

# 4. 非线性特征交叉全连接层 (MLP)
x = layers.Dense(64, activation='relu')(merged)
x = layers.BatchNormalization()(x)
x = layers.Dropout(0.2)(x)
x = layers.Dense(32, activation='relu')(x)

# 5. 转化率预测输出层 (Sigmoid 概率)
output_pred = layers.Dense(1, activation='sigmoid', name='conversion_prob')(x)

model = Model(inputs=[input_num, input_cat], outputs=output_pred)

# 6. 编译模型:声明损失函数与业务评价指标
model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=1e-3),
    loss='binary_crossentropy',
    metrics=[metrics.AUC(name='auc'), metrics.Precision(name='precision')]
)

model.summary()
Layer (type) Output Shape Param # Connected to
==================================================================================================
input_cat (InputLayer) [(None, 1)] 0 []
category_embedding (Embedding) (None, 1, 16) 16000 ['input_cat[0][0]']
input_num (InputLayer) [(None, 5)] 0 []
flatten_embedding (Flatten) (None, 16) 0 ['category_embedding[0][0]']
feature_concat (Concatenate) (None, 21) 0 ['input_num[0][0]',
'flatten_embedding[0][0]']
dense (Dense) (None, 64) 1408 ['feature_concat[0][0]']
batch_normalization (None, 64) 256 ['dense[0][0]']
dropout (Dropout) (None, 64) 0 ['batch_normalization[0][0]']
dense_1 (Dense) (None, 32) 2080 ['dropout[0][0]']
conversion_prob (Dense) (None, 1) 33 ['dense_1[0][0]']
==================================================================================================
Total params: 19,777 (77.25 KB) | Trainable params: 19,649 | Non-trainable params: 128
2. PyTorch (面向对象与显式训练循环) 建模实战
PyTorch 要求显式定义继承自 nn.Module 的类,并在训练循环中清晰控制梯度重置、反向传播与优化器更新。这种透明性在需要自定义训练细节或探索复杂时序结构时极为实用。
import torch
import torch.nn as nn
import torch.optim as optim

class TabularNet(nn.Module):
    def __init__(self, num_features_dim=5, num_categories=1000, embedding_dim=16):
        super(TabularNet, self).__init__()
        # 离散特征嵌入层
        self.cat_embed = nn.Embedding(num_embeddings=num_categories, embedding_dim=embedding_dim)

        # 特征合并后的总维度 = 连续特征维度 + 嵌入维度
        total_dim = num_features_dim + embedding_dim

        # 多层全连接与正则化模块
        self.fc_block = nn.Sequential(
            nn.Linear(total_dim, 64),
            nn.BatchNorm1d(64),
            nn.ReLU(),
            nn.Dropout(0.2),
            nn.Linear(64, 32),
            nn.ReLU(),
            nn.Linear(32, 1)
        )

    def forward(self, x_num, x_cat):
        # 1. 查表获取嵌入张量: [batch_size, 1, embedding_dim] -> [batch_size, embedding_dim]
        cat_vec = self.cat_embed(x_cat).squeeze(1)

        # 2. 沿特征维度拼接: [batch_size, total_dim]
        x = torch.cat([x_num, cat_vec], dim=1)

        # 3. 前向传播计算 logits
        logits = self.fc_block(x)
        return logits

# 实例化网络与优化配置
model = TabularNet()
criterion = nn.BCEWithLogitsLoss() # 内置数值稳定的 Sigmoid 计算
optimizer = optim.AdamW(model.parameters(), lr=1e-3, weight_decay=1e-4)

# 模拟一个训练批次 (batch_size=64)
batch_num = torch.randn(64, 5)                       # 标准化连续变量
batch_cat = torch.randint(0, 1000, (64, 1))         # 离散索引变量
batch_y = torch.randint(0, 2, (64, 1)).float()      # 真实二分类标签

# 标准训练步执行
model.train()
optimizer.zero_grad()
preds = model(batch_num, batch_cat)
loss = criterion(preds, batch_y)
loss.backward()
optimizer.step()

print(f"批次前向传播正常,Loss: {loss.item():.4f}")
四、典型数据分析模型原理与关键结构:高维表征与序列挖掘
为了在数据分析任务中充分发挥深度学习的能力,需要理解支撑这些模型运作的核心数学逻辑与结构设计。
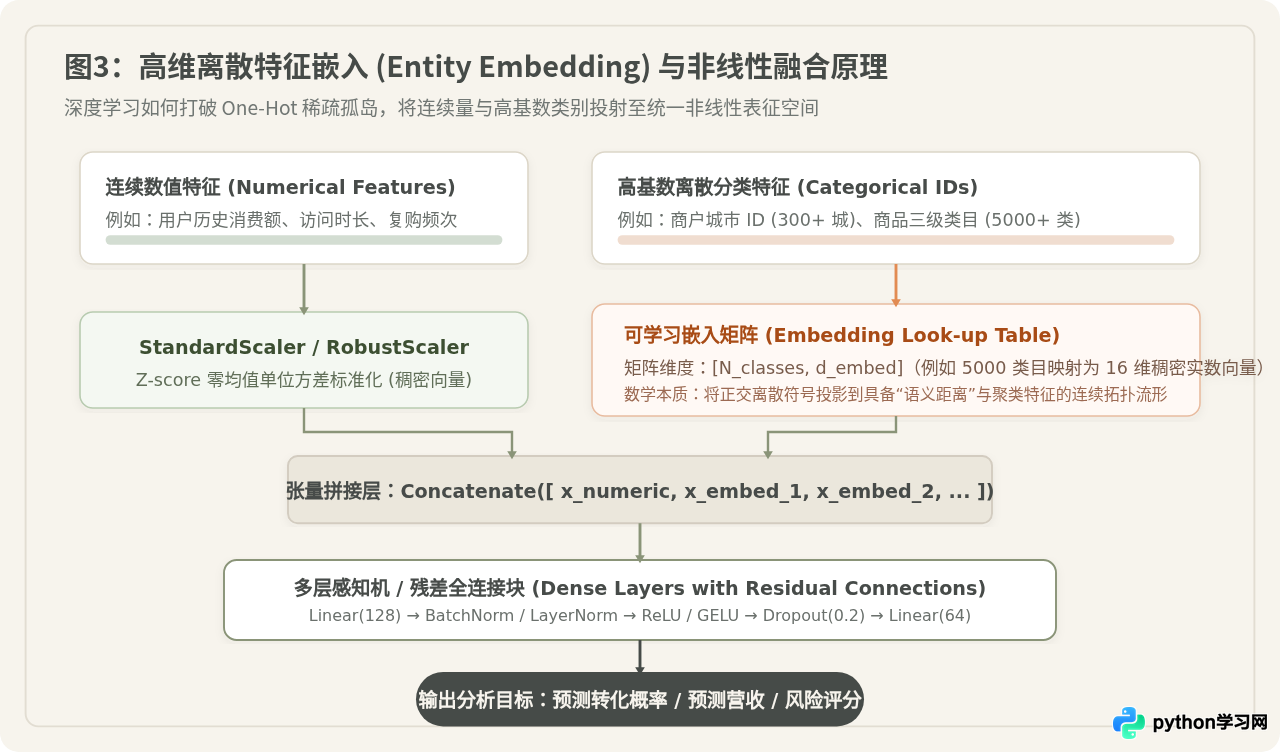
1. Entity Embedding 的数学原理与维度设定法则
假定某一离散特征具有 N 个不同类别。在传统分析中,One-Hot 编码将其映射为 N 维正交向量。然而正交性意味着任何两个类别之间的欧氏距离恒为根号 2,模型无法感知“杭州市”与“宁波市”在消费行为上要比“杭州市”与“拉萨市”更为接近。
在深度学习框架中,嵌入层实际上是一个可学习参数查找表。输入一个类别索引,模型直接提取对应的连续稠密向量。在反向传播过程中,根据下游业务指标的损失梯度,具有相似转化率或消费特征的类别向量会在嵌入空间中自发聚拢。
嵌入维度的经验设定公式:维度的选择需要在信息保真度与过拟合之间权衡。业界广泛使用的经验法则为:d = min(50, int(num_classes ** 0.25 * 2)) 或 d = min(50, num_classes // 2)。例如,对于拥有 500 个不同品类的电商特征,设置 16 到 32 维的 Embedding 通常能在保留足够信息的同时大幅抑制过拟合。
2. 时间序列建模中的循环与注意力机制
在预测用户未来 7 天用电负荷、商品周度销售趋势等序列任务中,传统的 ARIMA 模型依赖平稳性假设且难以容纳外生变量。
-
LSTM / GRU(门控循环单元):
通过遗忘门、输入门与输出门的配合,在隐藏状态中维持长期记忆。在输入形态为
(batch_size, sequence_length, num_features)时,能够同时吸收历史滑动窗口的数值特征与节假日等静态属性。 - 时序 Transformer(如 PatchTST / Informer): 通过自注意力机制(Self-Attention)直接计算时间轴上任意两个时间步的关联系数,解决了极长序列(例如回溯 90 天分钟级指标)下的梯度弥散问题。但必须注意:在样本规模小于数万条的中小型时序分析中,Transformer 极易发生过拟合,其效果通常不及调优良好的 LSTM 或轻量级 MLP。
五、业务落地与框架选型决策指南
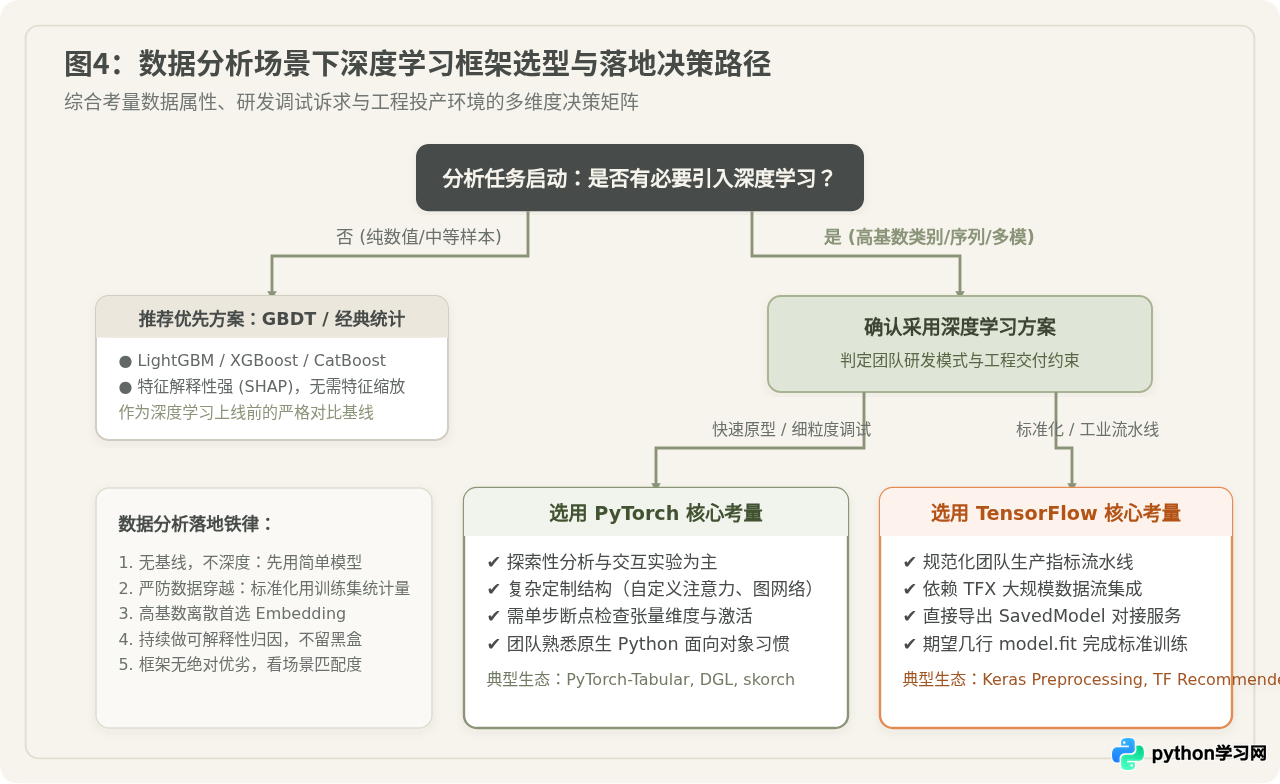
数据分析团队在引入深度学习时,往往纠结于到底选择 TensorFlow 还是 PyTorch。脱离业务场景与工程基础设施谈选型毫无意义。图 4 给出了清晰的选型决策树与落地准则。
1. 核心选型考量矩阵
| 决策考量维度 | TensorFlow 2.x (Keras) | PyTorch 2.x |
|---|---|---|
| 核心代码风格 | 声明式(Functional/Sequential),极高封装 | 命令式(面向对象/显式控制循环),纯 Pythonic |
| 数据管道工具 | tf.data.Dataset(高度优化但语法约束多) |
DataLoader(原生多进程,Python 逻辑即写即用) |
| 调试与分析体验 | 静态图机制对断点单步检查不够直接 | 像调试普通 NumPy 代码一样方便,中间变量随意打印 |
| 分析生态库支持 | TensorFlow Recommenders, TF-Ranking | PyTorch-Tabular, PyTorch Geometric, skorch |
| 生产部署与服务化 | TF Serving, TFLite, TFX 工业流水线高度成熟 | TorchScript, ONNX Runtime, 结合 FastAPI 部署 |
| 最适宜分析场景 | 指标固定、长期运行的大规模日常报表预测管道 | 探索性科研、快速原型验证、定制复杂注意力网络 |
2. 数据分析师高频踩坑清单与避险指南
-
陷阱一:忽视数据泄漏(Data Leakage)
在时间序列分析中,使用传统的train_test_split(shuffle=True)会导致“利用未来数据预测过去”,使验证集指标虚高。时序数据必须严格按照时间截断划分训练集、验证集与测试集。 -
陷阱二:缺失值直接填补 0 导致 Embedding 语义偏移
若类别索引 0 已分配给某一真实类目(如“数码产品”),而分析师又将缺失值填为 0,会导致模型把缺失当成特定商品训练。正确做法是为缺失值与未登录词单独预留一个专用的索引(如vocab_size - 1)。 -
陷阱三:盲目追求大网络而放弃基线检验
在数据分析汇报中,如果不能证明深度学习网络相较于简单的回归或 LightGBM 带来具有业务价值的收益提升(如 AUC 提升 2% 以上或显著改善高价值客户召回),那么引入深度学习所带来的推理延迟、训练算力开销与维护黑盒成本将得不偿失。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















