


Python主要能做什么开发:Web后端、数据分析与AI应用详解
全面解析Python在现代软件工程中的核心开发方向:深入探讨Web后端服务、数据分析与处理、人工智能与机器学习应用的技术选型、运行机制与实践要点。
许多初学编程或面临技术选型的开发者,常会好奇这门解释型语言到底在工业界承担着怎样的开发职责。Python 并非一门适合所有场景的语言——在操作系统内核开发、移动端原生应用或强实时图形渲染中,它几乎从不作为首选;但在 Web 后端系统、数据分析与挖掘 以及 人工智能与机器学习应用 这三大领域,Python 凭借成熟的底层生态支持与高效的表达能力,构建了极其稳固的技术壁垒。本文将针对这三大核心开发方向展开剖析,详解其技术架构、常用工具链、真实开发流程及关键注意事项。
一、Web 后端开发:业务 API 与服务端架构构建
在 Web 软件工程中,后端的核心任务是处理来自客户端的 HTTP/HTTPS 请求、执行业务逻辑、同数据库交互并输出标准数据(如 JSON)或渲染页面。Python 在后端领域的主要优势在于开发速度快、框架成熟度极高,能够让开发团队以极短的迭代周期上线功能稳定的网络服务。
1. 主流后端框架定位与选型
Python 后端生态经过多年沉淀,形成了轻重分明的代表性框架:
- Django(全功能型架构):遵循“开箱即用(Batteries-Included)”理念,内置强类型的 ORM、用户权限管理系统、后台管理面板(Admin)与表单校验模块。适合业务实体较多、管理后台需求重、要求快速交付的大中型单体系统。
- FastAPI(现代高性能 API 框架):基于 Starlette 与 Pydantic 构建,全面支持 Python 3.7+ 的异步协程(
async/await)。它不仅能提供接近 Node.js 和 Go 吞吐水平的高性能接口,还能基于类型注解自动生成 OpenAPI/Swagger 接口文档,是当前微服务和前后端分离架构的首选之一。 - Flask(轻量微框架):核心极为精简,仅提供路由与请求分发机制。数据库访问、用户认证等能力均依赖第三方扩展自由组装,适合轻量级微服务或原型服务验证。
2. 典型后端请求流转与代码实现
在生产环境中,Python Web 应用通常并不直接对外开放原生监听端口,而是接入多层服务分发模型:前端由 Nginx 承接高并发连接与静态资源,通过反向代理将请求转发至 WSGI/ASGI 应用服务器(如 Gunicorn、Uvicorn),最后进入 Python 业务逻辑与数据库进行交互。
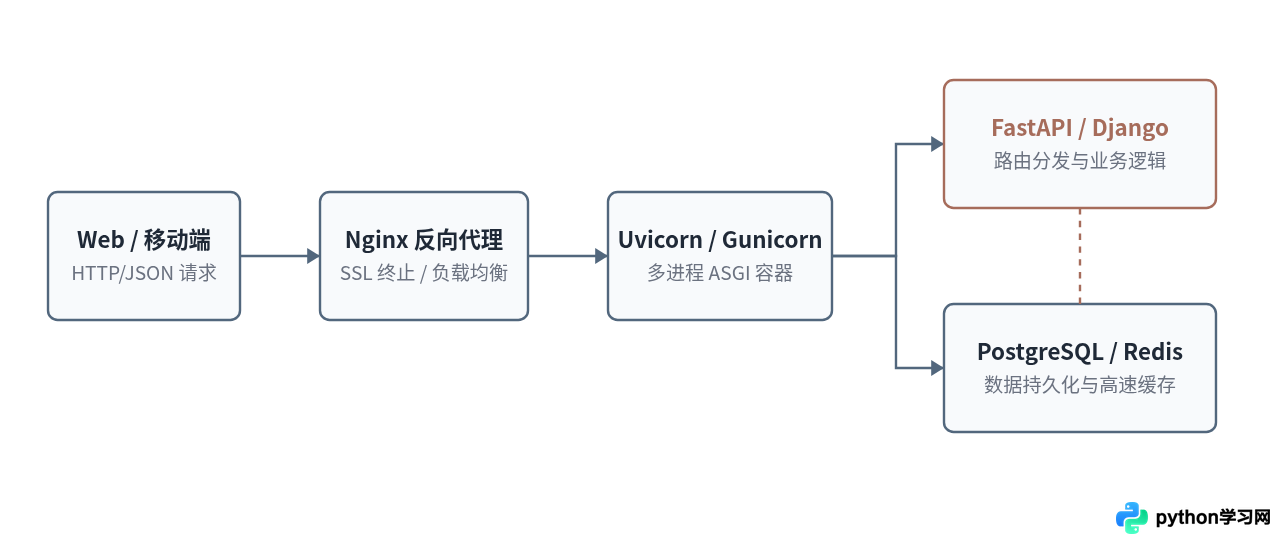
下面是一个使用 FastAPI 实现的 RESTful 接口代码片段,包含了模型校验与异步处理机制:
# main.py
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field
from typing import Optional

app = FastAPI(title="用户任务服务")

class TaskCreate(BaseModel):
    title: str = Field(..., min_length=2, max_length=50, description="任务标题")
    priority: int = Field(default=1, ge=1, le=5, description="优先级1-5")
    description: Optional[str] = None

@app.post("/api/v1/tasks", status_code=201)
async def create_task(task: TaskCreate):
    # 模拟数据持久化操作
    task_id = 101
    return {
        "status": "success",
        "data": {
            "task_id": task_id,
            "title": task.title,
            "priority": task.priority
        }
}后端开发注意事项:Python 存在 GIL(全局解释器锁),对于单个进程而言无法利用多核 CPU 处理纯计算任务。因此,在部署生产环境时,必须使用 Gunicorn 启动多个 Worker 进程配合 Uvicorn 事件循环来提升并发吞吐能力。
二、数据分析与处理:数据资产清洗、转换与洞察提取
数据分析是 Python 最具统治力的传统强项。无论是互联网用户行为分析、金融量化回测,还是工业传感数据统计,Python 提供了一套从底层向量运算到高层图表绘制的完整工具链体系。
1. 核心数据工具链职责划分
高质量的数据分析工作通常依赖以下三层基础库:
- NumPy(底层计算基础):提供了高性能的多维数组对象
ndarray。其底层使用 C/Fortran 编写,绕过了 Python 原生列表的内存指针开销,支持批量向量化运算。 - Pandas(结构化表格数据分析):基于 NumPy 构建,核心数据结构为二维表格
DataFrame。它提供了强大的索引对齐、缺失值填充、时间序列切片以及类似 SQL 的关联聚合操作。 - Matplotlib & Seaborn(数据可视化):提供从基础折线图、直方图到多变量联合分布图的渲染能力,便于将分析结论输出为直观的业务图表。
2. 数据分析的标准处理流程
规范的数据分析并非杂乱地调用函数,而是遵循固定的步骤流:
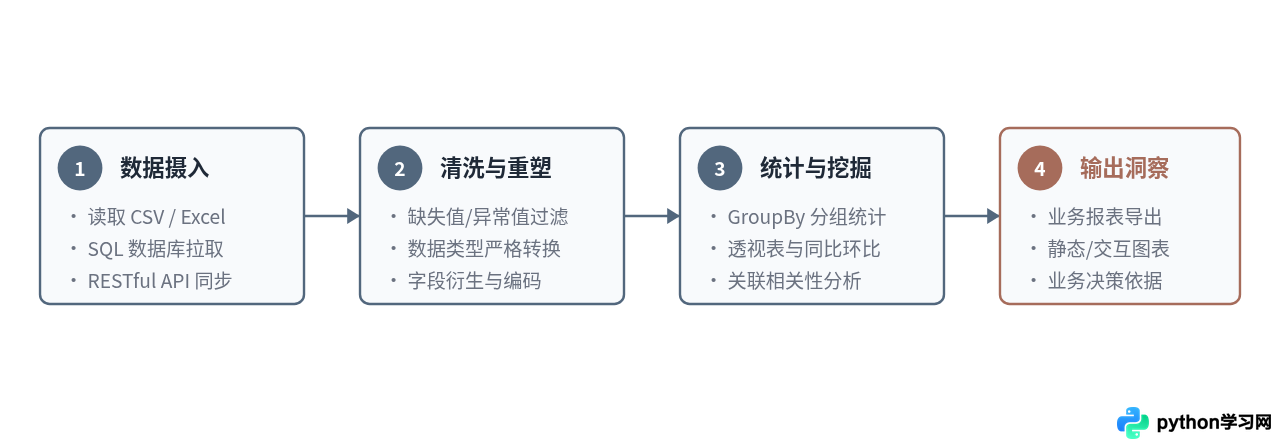
以下示例演示了使用 Pandas 读取订单记录、过滤脏数据并进行区域销售额统计的核心操作:
# data_analysis_example.py
import pandas as pd
import numpy as np

# 1. 模拟数据载入
raw_data = {
    "order_id": [1001, 1002, 1003, 1004, 1005],
    "region": ["华东", "华北", "华东", np.nan, "华南"],
    "amount": [250.0, -10.0, 480.5, 310.0, 150.0],
    "status": ["paid", "refunded", "paid", "paid", "paid"]
}
df = pd.DataFrame(raw_data)

# 2. 清洗过滤:剔除缺失区域与异常非正金额
cleaned_df = df.dropna(subset=["region"]).copy()
cleaned_df = cleaned_df[cleaned_df["amount"] > 0]

# 3. 统计计算:按区域汇总有效订单总金额与订单数
summary = cleaned_df.groupby("region").agg(
    total_sales=("amount", "sum"),
    order_count=("order_id", "count")
).reset_index()

# 示例输出结果格式
#   region  total_sales  order_count
# 0   华东        730.5            2
# 1 华南 150.0 1数据分析注意事项:Pandas 采用全内存加载模式。当数据量逼近或超过服务器物理内存的 30% 时,很容易触发 OOM(内存溢出)奔溃。在处理超大规模数据时,应合理使用 chunksize 分块读取,或考虑切换至轻量高性能的 Polars 框架。
三、AI 与机器学习应用:从算法建模到工程化落地
如果说在 Web 后端领域 Python 拥有众多强劲对手(如 Go、Java),那么在人工智能领域,Python 则是无可撼动的行业标准通用语言。从学术论文的实验复现到工业级商业大模型的微调与智能体落地,Python 几乎承载了所有前沿生态的核心接口。
1. AI 应用层级与技术栈分布
在实际开发中,AI 相关任务并非全部是“研发模型算法”,通常清晰地分为两类工程角色:
- 模型训练与算法研发(Model-Centric):侧重于特征工程、深度网络构建、损失函数设计与超参数优化。主要工具包括
Scikit-learn(传统机器学习如随机森林、SVM)、PyTorch(学术与产业界最主流的深度学习框架)以及TensorFlow / JAX。 - AI 工程化与大模型应用落地(Application-Centric):侧重于将预训练大语言模型(LLM)与企业知识库、业务系统结合。核心技术包括
LangChain、LlamaIndex(构建智能体与 RAG 检索增强生成)、向量数据库交互(Chroma、Milvus)以及推理加速框架(vLLM、Ollama)。
2. AI 应用工程化分层架构
现代 AI 应用从底层算力到终端业务,呈现出清晰的纵向技术分层:
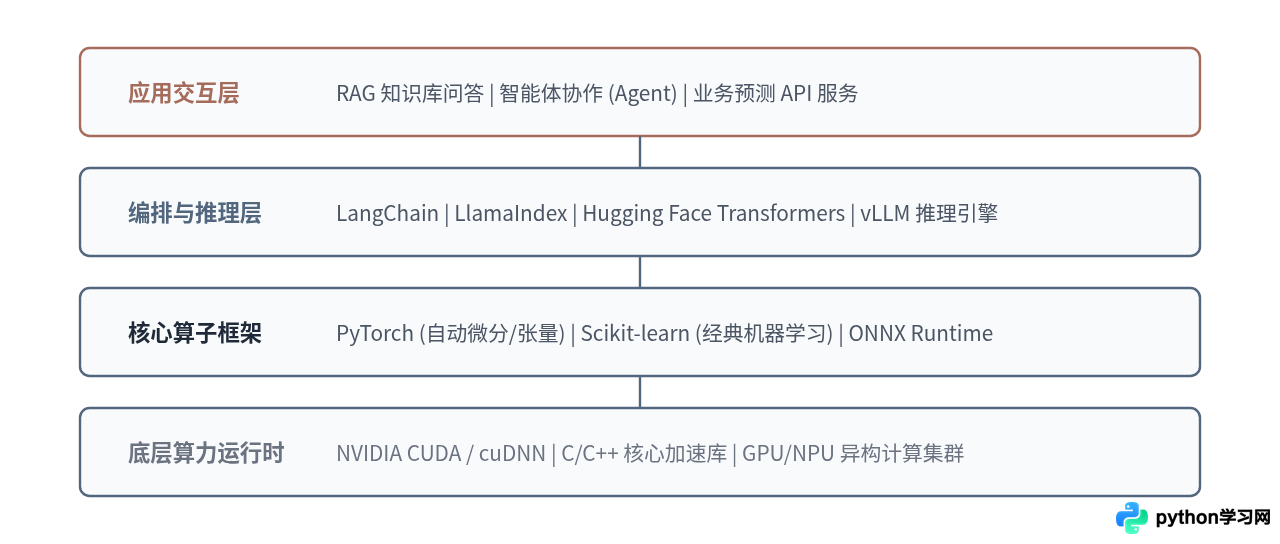
在工程落地中,开发者更多是借助现有的预训练模型完成分类或推理。以下展示一段使用 PyTorch 进行张量推理与输出概率分布的典型代码:
# inference_example.py
import torch
import torch.nn as nn

# 定义一个轻量级二分类判别层
class SimpleClassifier(nn.Module):
    def __init__(self, input_dim: int):
        super(SimpleClassifier, self).__init__()
        self.linear = nn.Linear(input_dim, 2)
        self.softmax = nn.Softmax(dim=1)

    def forward(self, x):
        return self.softmax(self.linear(x))

# 模拟输入特征向量 (batch_size=2, features=4)
features = torch.tensor([[1.2, 0.5, -0.3, 2.1],
                         [-0.8, 1.4, 0.2, 0.1]], dtype=torch.float32)

model = SimpleClassifier(input_dim=4)
model.eval()  # 切换至推理模式

with torch.no_grad():
    probabilities = model(features)

# 输出属于各类别的预测概率分布
print("预测概率:", probabilities)
AI 工程注意事项:Python 在深度学习中充当的是“胶水层”和“调度者”,底层密集矩阵乘法均由 C++/CUDA 完成。由于 CUDA 驱动版本、PyTorch 版本与 Python 解释器之间存在极为严格的二进制兼容关系,开发 AI 应用必须始终借助 conda 或 Docker 建立严格隔离的运行环境,避免依赖冲突。
四、三大开发方向技术特征与选型总结
为了帮助开发者根据自身业务目标做出准确的技术选型,下表将 Web 后端、数据分析与 AI 应用三大方向的关键维度进行了系统对比:
| 开发方向 | 核心技术栈 | 主要优势 | 核心技术挑战 | 典型业务产物 |
|---|---|---|---|---|
| Web 后端开发 | FastAPI, Django, SQLAlchemy, Celery | 开发效率高、ORM 生态成熟、API 文档自动化 | GIL 限制多核利用,高并发长连接需要 ASGI 支持 | SaaS 业务后台、微服务 REST/gRPC 接口、内容管理系统 |
| 数据分析与挖掘 | Pandas, NumPy, Matplotlib, Polars | 事实上的行业通用标准、探索性分析极度灵活 | 单机内存限制容易溢出,海量数据需结合分布式框架 | 自动化运营日报、用户漏斗分析、指标监控看板 |
| AI 与大模型应用 | PyTorch, LangChain, Transformers, vLLM | 垄断性的学术与工业界支持,模型生态极度丰富 | 对 GPU 硬件与 CUDA 依赖极重,生产推理延迟需精细优化 | 智能客服智能体、企业内部知识库 RAG、图像识别模型服务 |
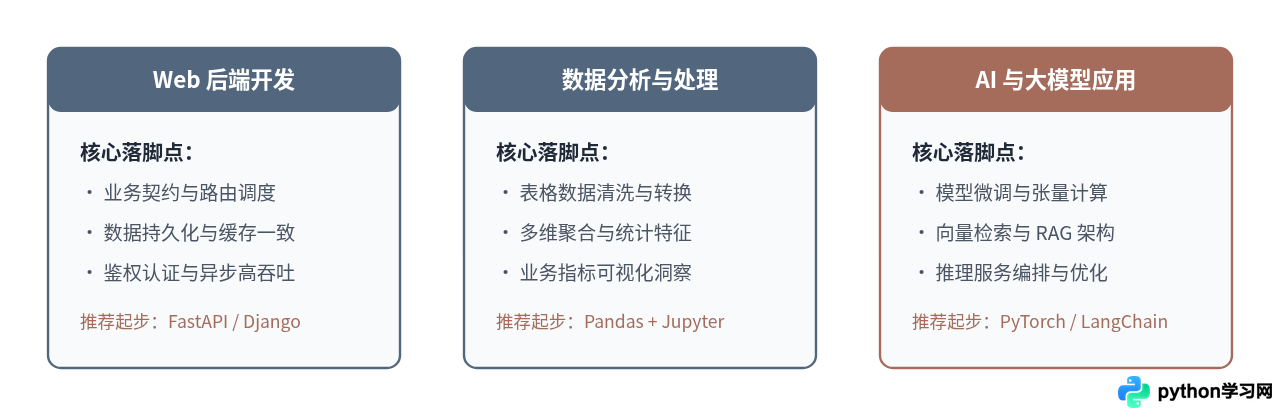
综上所述,Python 之所以在现代工程中长盛不衰,核心在于其通过高效的高级语法包容了底层 C/C++/CUDA 编写的高性能运行时。开发者在进入实际项目时,应基于实际业务需求选择合适方向:若注重业务逻辑落地,可深耕 Web 后端;若注重指标分析与业务赋能,数据分析工具链是核心抓手;若致力于前沿智能化改造,则应紧跟现代 AI 与大模型工程化体系。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















