


Python for循环基础语法:遍历列表、字符串与元组
本文系统讲解Python中for循环的基础语法与执行原理,深入演示如何高效遍历列表、字符串与元组,并解析常见避坑点与结构解包技巧。
假设你正在处理一份学生提交的实验记录,需要逐个向名单中的成员发送完成提醒,逐字排查用户输入的字符串中是否包含非法符号,或者按顺序读取一系列坐标点来绘制运动路径。如果针对每个元素都手动写一行操作代码,程序不仅极其冗长,而且一旦数据项数改变就需要反复重构。在 Python 中,for 循环正是专门用于自动化解决此类序列数据逐项提取与处理的核心语法。
本文围绕“遍历列表、字符串与元组”这一核心任务,系统剖析 for 循环的基本语法规则、底层运行机制,并通过具体可运行的代码示例与结构图示,演示如何针对这三种最基础的内置序列类型展开遍历与解包,同时指出遍历过程中的典型陷阱与规避方法。
一、Python for 循环的核心执行逻辑
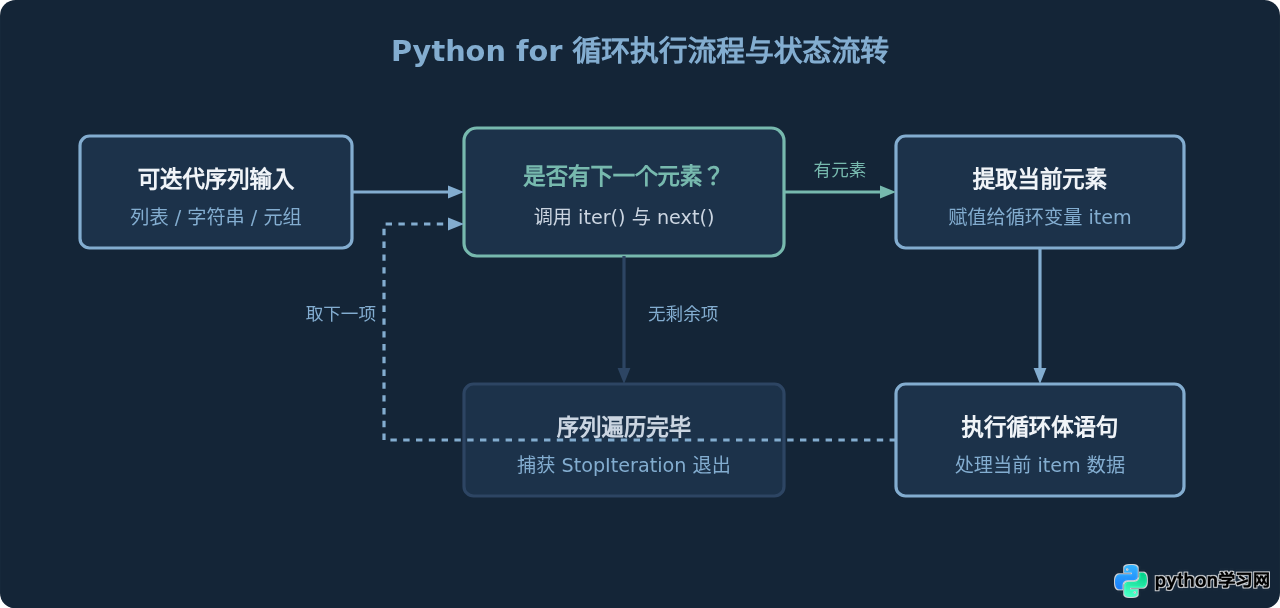
与其他编程语言(如 C 或传统 Java)中基于计数器和索引递增的 for (int i=0; i<n; i++) 不同,Python 的 for 循环本质上是一个“迭代器遍历循环”(for-in 语句)。它不依赖显式的下标索引控制,而是直接向目标对象逐个请求获取元素,直到对象中的所有内容被完全提取完毕。
其基础代码结构非常紧凑:
for 临时变量 in 可迭代对象:
    # 循环体:针对提取出的临时变量执行具体逻辑
    执行代码块
当 Python 解释器执行到 for 语句时,首先会调用目标对象的底层迭代机制。每进入一轮循环,就自动取出序列中的下一个元素并赋值给指定的循环变量,然后执行一次缩进块内的代码;当序列中再无剩余元素时,循环自动平稳终止,程序继续向下执行后续代码。
二、遍历列表(List):顺序提取与避坑指南
列表是 Python 中最常用的有序、可变序列容器。在实际业务中,我们经常使用列表存储批量同质数据(例如主机列表、用户记录、测试结果)。
1. 基础单值遍历
直接将列表对象放在 in 关键字之后,即可按从左到右(从下标 0 到最大下标)的次序访问其中存储的每一个元素:
# 示例代码:遍历服务器节点列表并打印检测状态
servers = ["node-01.local", "node-02.local", "node-03.local"]

for server in servers:
print(f"正在向节点 {server} 发送健康检测心跳包...")正在向节点 node-02.local 发送健康检测心跳包...
正在向节点 node-03.local 发送健康检测心跳包...
2. 同时获取元素下标与内容:enumerate()
如果需要在循环中同时显示“当前是第几个元素”或依据索引进行运算,不要通过手动维护计数器变量,推荐使用内置的 enumerate() 函数:
# 示例代码:使用 enumerate 获取序号和内容
task_queue = ["数据备份", "日志轮转", "证书续期"]

for index, task in enumerate(task_queue, start=1):
print(f"步骤 {index}: 开始执行【{task}】")步骤 2: 开始执行【日志轮转】
步骤 3: 开始执行【证书续期】
3. 核心避坑:不可在遍历过程中原地修改列表尺寸
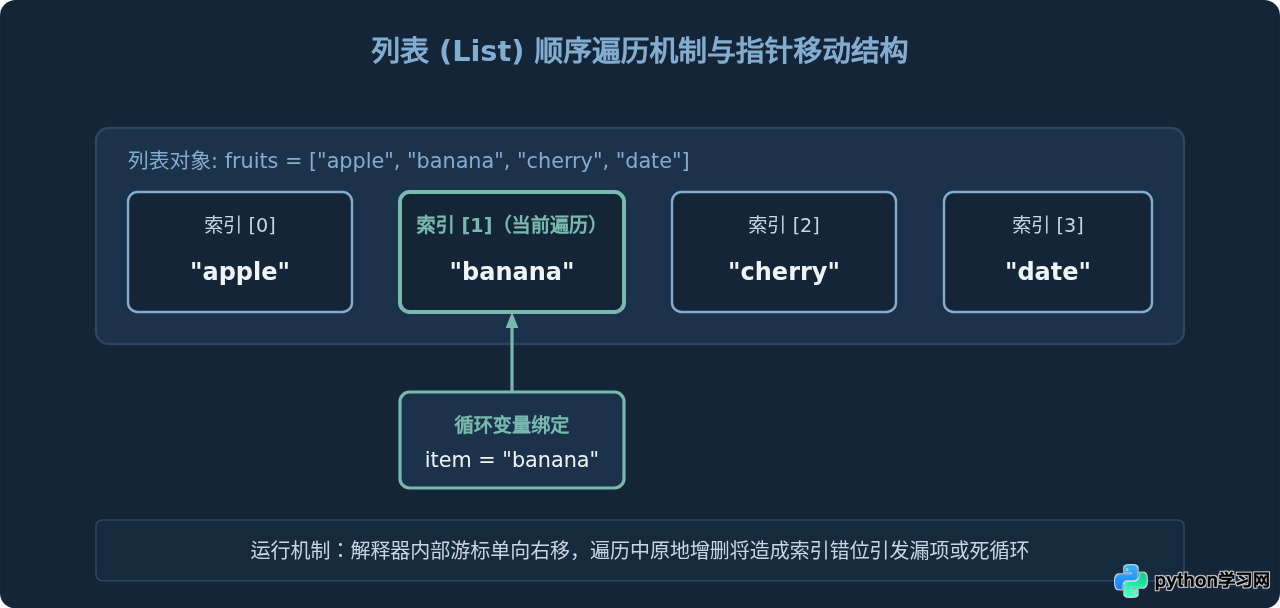
初学者容易犯的一个严重错误是:在 for 循环体内部直接调用 remove() 或 pop() 删除列表元素。由于 Python 遍历底层是依赖指针索引向前移动的,当原列表长度缩水后,后续元素的物理下标会瞬时前移,导致紧随其后的元素被直接跳过,产生静默漏处理问题。
for item in my_list[:]: 遍历副本,从而保证原列表在修改时不影响当前遍历的游标。
三、遍历字符串(String):逐字符解构与文本分析
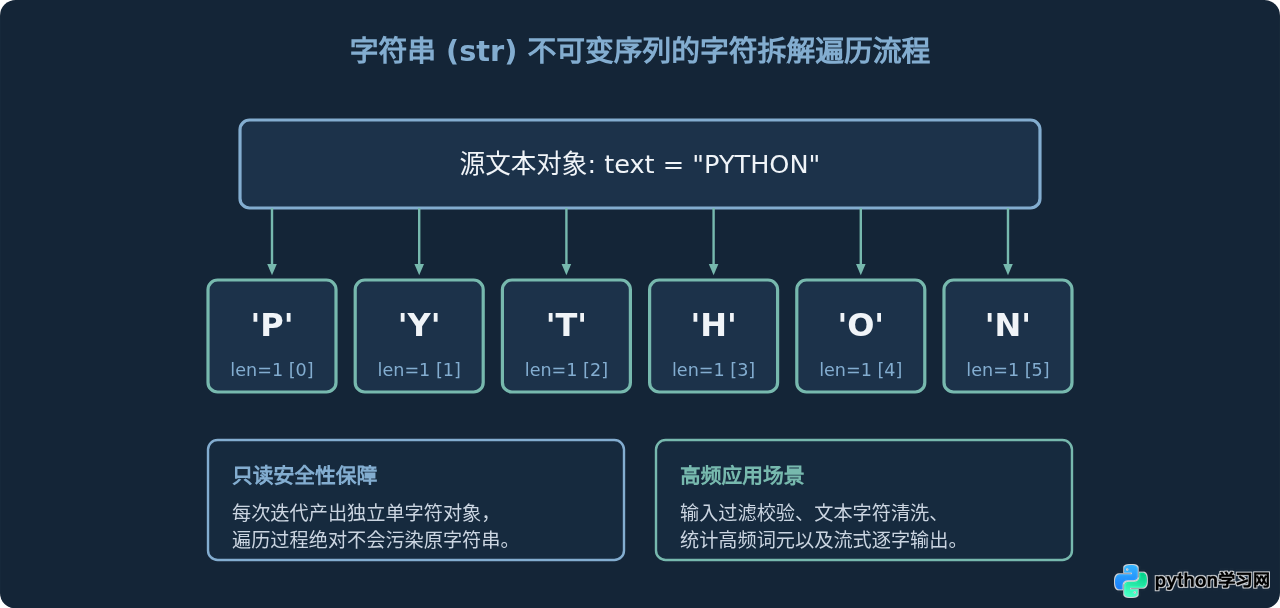
在 Python 中,字符串(str)是典型的不可变字符序列。对字符串进行 for 循环遍历时,解释器不会拆分词组,而是严格按照字符编码顺序,逐个提取出长度为 1 的单字符子字符串。
1. 逐字符提取与计数
无论是英文字符、中文汉字、数字、空格还是转义换行符(如 \n),在遍历时都会被当成一个独立的字符串元素交付给循环变量:
# 示例代码:统计文本中的字母、数字与特殊符号
source_text = "Python 3.12!"
alpha_count = 0
digit_count = 0

for char in source_text:
    if char.isalpha():
        alpha_count += 1
    elif char.isdigit():
        digit_count += 1

print(f"源字符串: '{source_text}'")
print(f"统计结果: 字母 {alpha_count} 个,数字 {digit_count} 个")统计结果: 字母 6 个,数字 3 个
2. 字符串不可变性在循环中的体现
由于字符串在内存中具有不可变性(Immutable),在循环体内执行类似于 char = char.upper() 的操作,仅会改变局部循环变量 char 指向的新对象,绝对不可能反向修改原字符串中的内容。如果需要生成修改后的新文本,应当在循环外初始化一个空列表,逐项收集新字符后使用 "".join() 进行组合。
四、遍历元组(Tuple):不可变结构与多变量解包
元组(tuple)是有序且不可变的序列。在工程项目中,元组常用于承载具有固定语义的多字段实体(例如二维坐标点 (x, y)、RGB 颜色值 (r, g, b) 或数据库查询结果的一行记录)。
1. 基础单变量遍历
当直接使用单一变量遍历元组集合时,每次取出的就是完整的单个元组:
# 示例代码:遍历静态系统配置项元组
system_envs = ("Production", "Staging", "Development")

for env in system_envs:
print(f"载入环境策略: {env}")载入环境策略: Staging
载入环境策略: Development
2. 多变量序列解包遍历(Tuple Unpacking)
当容器中的每一个元素本身是一个固定长度的元组时,Python 支持在 for 语句后直接声明多个接收变量。这一特性称为“结构解包”(Unpacking)。解包可以在循环声明阶段一步完成字段拆分,彻底省去 item[0]、item[1] 这类魔法下标:
# 示例代码:解包遍历包含坐标与权重的元组列表
route_checkpoints = [
    (116.40, 39.90, "北京站"),
    (121.47, 31.23, "上海站"),
    (113.26, 23.13, "广州站")
]

for lon, lat, name in route_checkpoints:
print(f"坐标点【{name}】 -> 经度: {lon:.2f}, 纬度: {lat:.2f}")坐标点【上海站】 -> 经度: 121.47, 纬度: 31.23
坐标点【广州站】 -> 经度: 113.26, 纬度: 23.13
ValueError: not enough values to unpack 或 too many values to unpack 异常。
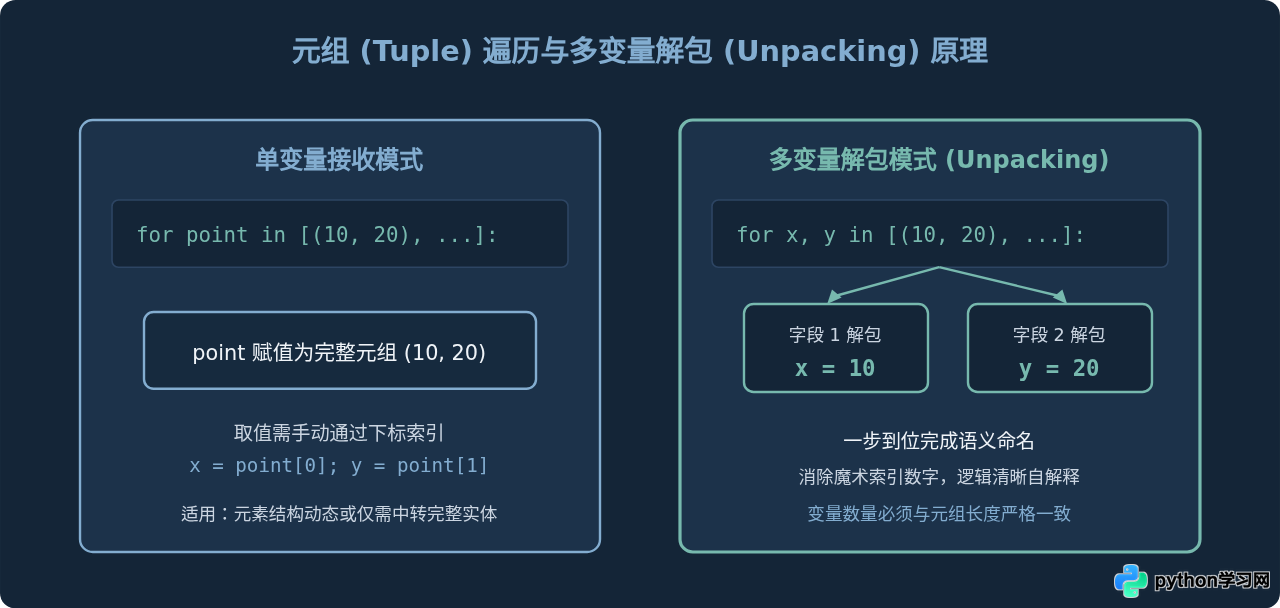
五、三大序列遍历对比与避坑指南
为了在实际编码时快速选择适宜的序列类型与遍历策略,下表整理了列表、字符串和元组在 for 循环中的关键属性与使用建议:
| 序列类型 | 可变性 | 每次遍历提取的值 | 是否支持原地修改 | 核心注意事项与高频场景 |
|---|---|---|---|---|
| 列表 (list) | 可变 (Mutable) | 任意类型的对应元素 | 允许(但不可直接在遍历中增删) | 遍历修改须使用切片备份 list[:] 或推导式;配合 enumerate() 获取索引。 |
| 字符串 (str) | 不可变 (Immutable) | 长度为 1 的单字符 str |
不支持 | 字符修改需创建新串;遍历时转义符、空格与汉字均视为独立元素。 |
| 元组 (tuple) | 不可变 (Immutable) | 元组内单个元素或整体 | 不支持 | 只读安全性高;结合多变量解包(如 for x, y in points)提升结构化代码可读性。 |
日常编码常见易错点清单
- 缩进错误(IndentationError):Python 依靠缩进来界定循环体作用域。如果
for语句下一行没有缩进或缩进空格数不一致,解释器将在编译阶段直接报错。 - 循环变量作用域“泄露”:在 Python 中,
for循环中声明的临时变量在循环执行完成后并不会被立即销毁,依然存在于当前函数或模块局部作用域中。建议避免在循环结束后继续依赖该变量的值,也不要使用同名变量覆盖外层的核心变量。 - 解包数量失配(ValueError):当使用
for a, b in items进行多变量解包时,如果数据源中存在某一元组长度不等于 2(例如有的元组只包含 1 个值或包含 3 个值),程序将在该轮迭代抛出异常。在数据来源不可信时,应先校验结构长度。
熟练掌握 for 循环对列表、字符串与元组的遍历方法,是编写优雅、地道 Python 代码的基石。在实际开发中,根据数据是否需要被变更选择列表或元组,结合 enumerate() 与多变量解包语法,可以写出兼具可读性、执行性能与安全性的高质量工程代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















