


Python怎么用with语句安全读取文件?上下文管理器最佳实践
深入解析Python使用with语句安全读取文件的核心原理与最佳实践,从try-finally到上下文管理器生命周期,涵盖大文件按行读取、编码规范与多文件管理技巧。
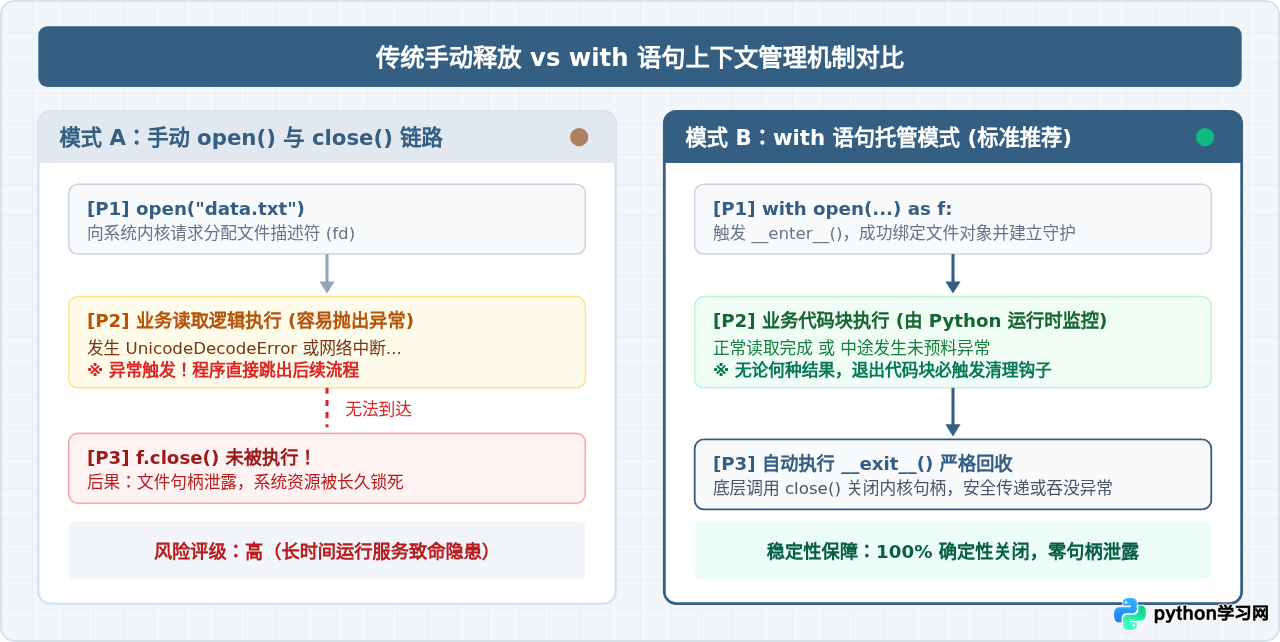
在 Python 中安全读取文件,最直接且推荐的标准做法是使用 with open('文件名', 'r', encoding='utf-8') as f: 语法。操作系统为每个进程分配的文件句柄(文件描述符)是有限的系统资源,常规的 open() 必须手动调用 f.close(),一旦在读取过程中遇到语法解析错误、编码异常或未捕获的运行时错误,执行流会直接中断,导致 close() 被跳过,从而引发句柄泄漏。with 语句通过 Python 的“上下文管理器协议”,自动托管资源申请与清理过程,无论代码块正常执行结束还是抛出异常,都会在底层确定性地触发文件关闭动作。
一、为什么必须用 with 语句读取文件?
在早期 Python 代码或 C/C++ 风格的代码中,开发者习惯先创建文件对象,读取内容后再关闭。这种方式在理想执行路径下看似工作正常,但在工业级生产环境中存在不可忽视的稳定性隐患。
当一个长期运行的后端服务或批处理脚本频繁打开文件却未彻底释放句柄时,系统会迅速逼近单个进程的文件句柄上限(Linux 默认常为 1024)。一旦耗尽,随后的任何文件操作、网络 Socket 连接甚至模块加载都会抛出 OSError: [Errno 24] Too many open files,导致程序彻底瘫痪。
为了解决这个问题,传统写法使用 try...finally 结构:
# 传统 try...finally 写法(冗长且易漏掉初始化边界)
file_obj = open("server.log", "r", encoding="utf-8")
try:
    content = file_obj.read()
finally:
    file_obj.close()
这种写法虽然能够保证 file_obj.close() 被执行,但代码结构冗长。如果打开多个文件,嵌套层级将呈阶梯状激增。而 with 语句将这一过程提炼为语法级支持,用更清晰、自解释的代码彻底杜绝了遗忘 close() 的可能性。
二、with 语句底层运行机制:上下文管理器协议
with 并不是单纯的代码折叠语法糖,它的背后是 Python 语言核心的上下文管理器协议(Context Manager Protocol)。任何支持该协议的 Python 对象,都必须在类中实现两个特定方法:__enter__() 和 __exit__()。
1. __enter__() 与 __exit__() 的协同工作流
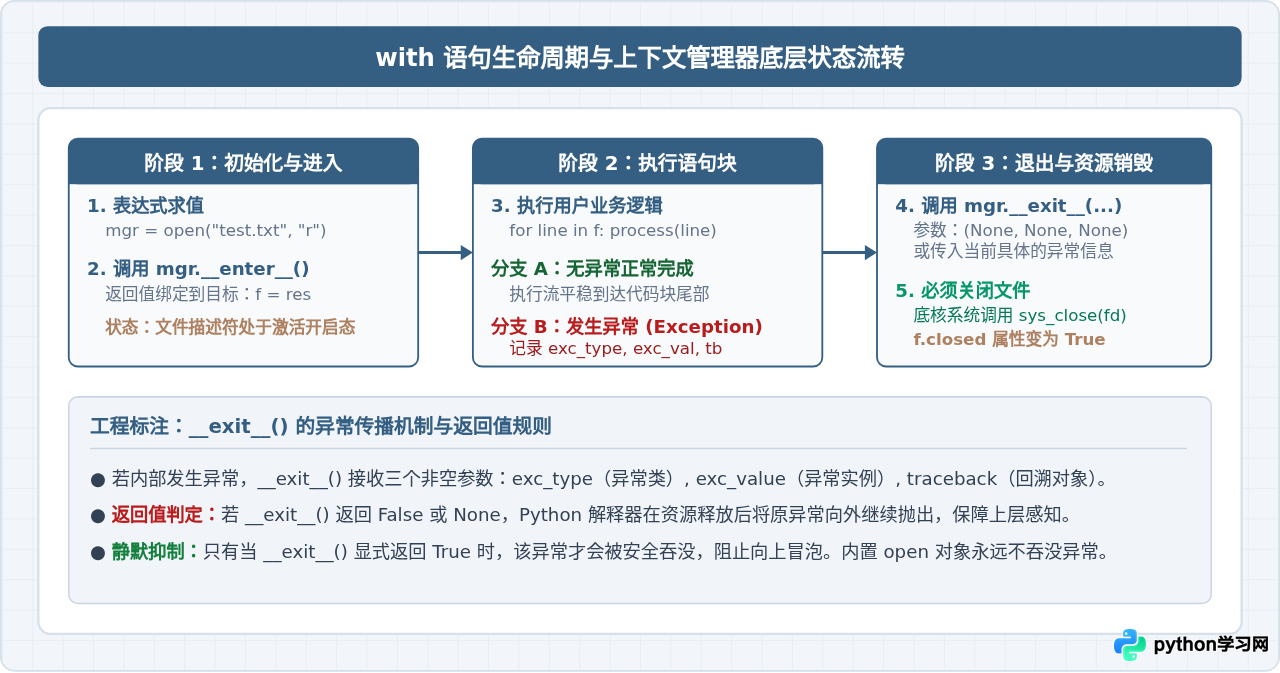
当我们执行 with open("config.json", "r") as f: 时,Python 解释器在内部严格遵循以下步骤:
- 求值上下文表达式:调用内置函数
open(),生成一个文件流上下文管理器对象。 - 进入上下文:调用该对象的
__enter__()方法。在内置文件对象中,__enter__()返回文件对象自身。如果语句中包含as f,则该返回值被赋值给变量f。 - 执行代码块:执行
with缩进内部的语句体。 - 退出并善后:离开缩进块(无论是自然结束、通过
return/break离开,还是发生异常中断),解释器必定调用__exit__(exc_type, exc_val, exc_tb)。
三、安全读取文件的核心操作步骤与编码规范
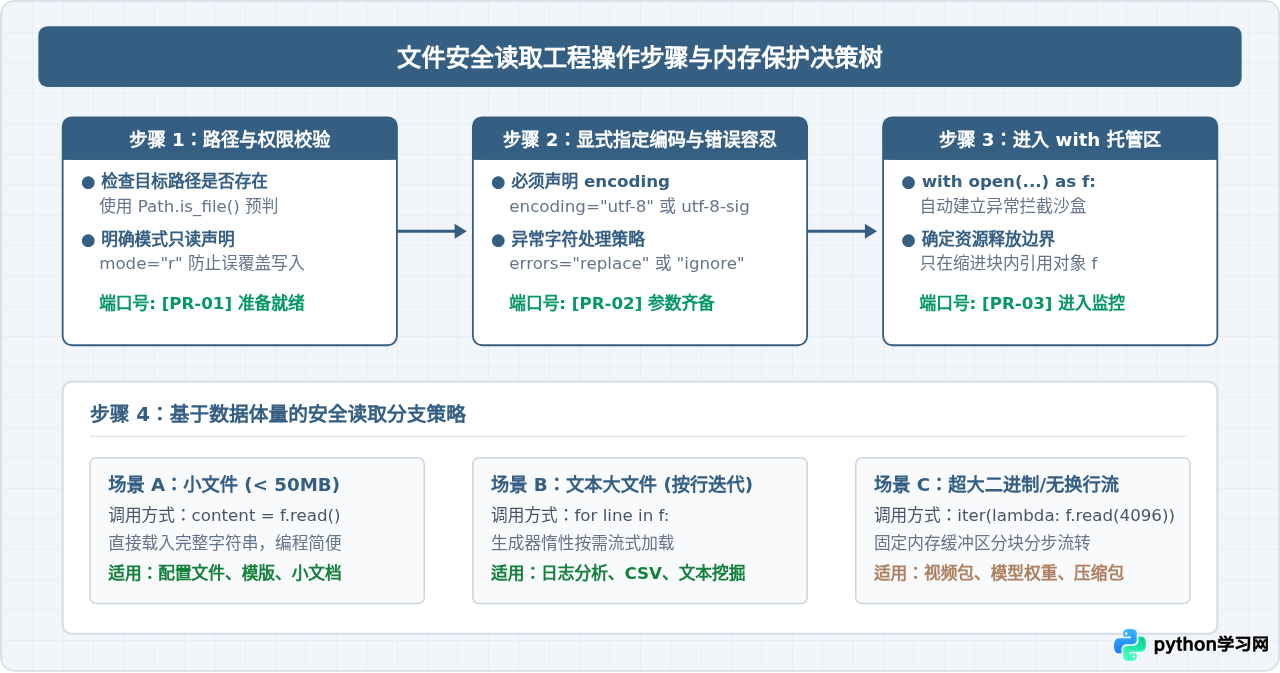
虽然 with 能够确保文件描述符的关闭,但在实际工程落地中,完整的“安全读取”还必须满足另外两个关键维度:编码一致性防御以及大文件内存防击穿。
1. 关键第一步:显式指定编码(encoding="utf-8")
很多开发者在调用 open() 时只传文件名,忽略了 encoding 参数。在不指定编码时,Python 会依赖操作系统的默认环境设置:在 macOS 和大多数 Linux 发行版上通常为 UTF-8,但在 Windows 简体中文版上很可能是 GBK。若程序在跨平台迁移或读取含特殊字符的文件时,会直接抛出致命的 UnicodeDecodeError。
# 规范推荐:始终显式声明编码与读取模式
with open("data_report.csv", mode="r", encoding="utf-8") as f:
    header = f.readline()
    print("表头字段:", header.strip())
2. 关键第二步:根据文件体积选择读取策略
f.read() 会将整个文件内容一次性读入内存生成字符串。如果要读取的文件只有几 KB 或几十 KB,这种做法十分直观;但如果是 2GB 的日志或数据转储文件,一次性 read() 会直接触发操作系统的 OOM(Out of Memory)导致进程被强行杀死。
3. 典型代码实现对比
# 模式 1:逐行安全流式迭代(内存占用极低,哪怕 100GB 日志也不会 OOM)
with open("system_access.log", "r", encoding="utf-8") as f:
    for line_num, line in enumerate(f, start=1):
        if "ERROR" in line:
            # strip() 去除首尾空白与换行符
            print(f"行 {line_num}: {line.strip()}")

# 模式 2:固定 Chunk 块读取二进制文件(如图像、压缩包)
CHUNK_SIZE = 64 * 1024  # 每次读取 64 KiB
with open("dataset.tar.gz", "rb") as bin_file:
    while True:
        chunk = bin_file.read(CHUNK_SIZE)
        if not chunk:
            break
        # 处理当前数据块
        compute_hash(chunk)
四、进阶模式:多文件协同与自定义上下文管理器
在清洗数据或转存内容时,常常需要同时读取源文件并写入目标文件。如果按照嵌套方式编写代码,可读性会迅速变差。Python 提供了更规范且优雅的多资源托管方案。
1. Python 3.10+ 括号多上下文语法
在 Python 3.10 及更高版本中,with 语句原生支持用小括号将多个上下文管理器组织在一起,清晰对齐:
# 规范的多文件安全读取与写入(Python 3.10+)
with (
    open("raw_data.txt", "r", encoding="utf-8") as src,
    open("cleaned_data.txt", "w", encoding="utf-8") as dst
):
    for line in src:
        cleaned = line.strip().upper()
        dst.write(cleaned + "\n")
如果打开第二个文件时因权限不足抛出 PermissionError,with 机制会自动执行第一个已打开文件的 __exit__(),确保已经打开的资源立即释放,不留下悬挂句柄。
2. 使用 contextlib.ExitStack 动态管理可变数量文件
如果要同时读取的文件列表是动态决定的(例如根据传入的列表读取 5 个日志文件进行归并),静态的 with 语法无法提前写死。此时应当使用标准库提供的 contextlib.ExitStack:
from contextlib import ExitStack

log_files = ["node1.log", "node2.log", "node3.log"]

with ExitStack() as stack:
    # 动态将多个文件句柄压入同一个退出栈
    file_handles = [
        stack.enter_context(open(path, "r", encoding="utf-8"))
        for path in log_files
    ]
    # 无论处理过程中发生什么异常,ExitStack 会以后进先出 (LIFO) 顺序全部关闭
    for handle in file_handles:
        first_line = handle.readline()
        print(first_line.strip())
五、避坑指南与最佳实践全景总结
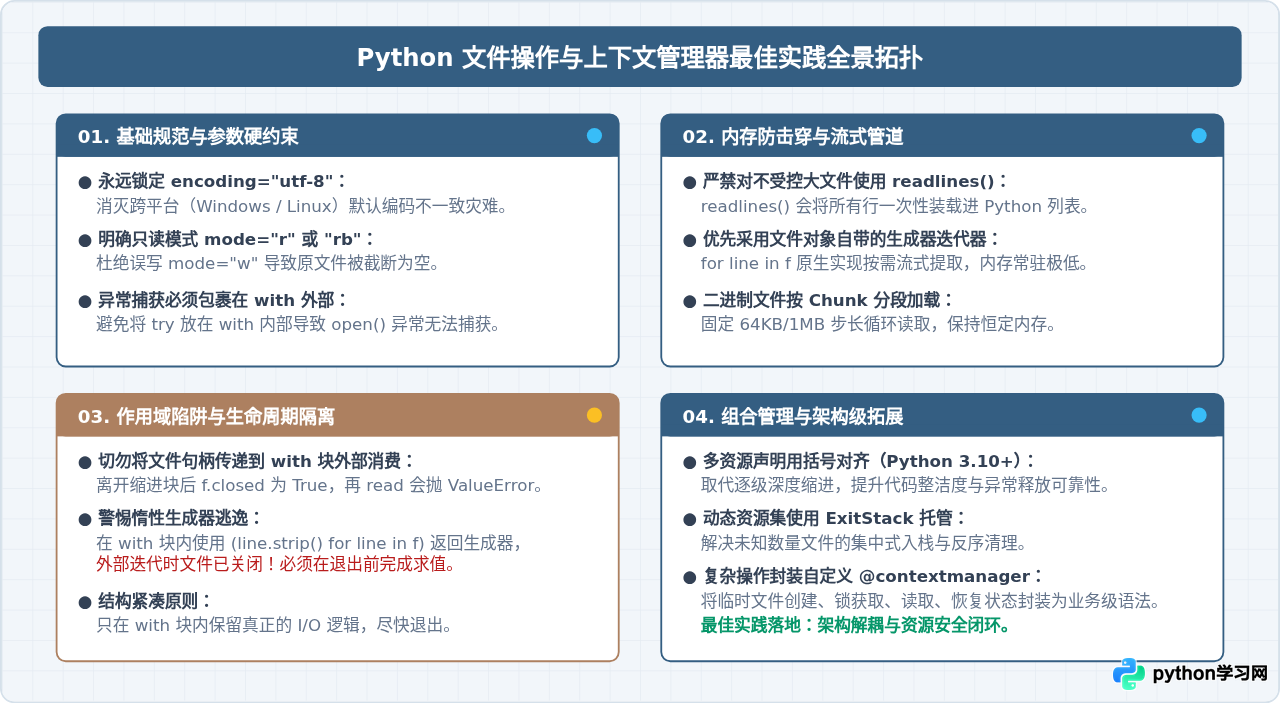
初学者容易写出类似 def get_lines(path): with open(path) as f: return (line for line in f) 的代码。因为生成器推导式是惰性求值的,当外部代码尝试通过 for item in get_lines(...) 读取数据时,with 块早已经执行完毕,底层的 f.close() 已经触发,程序会立即报错 ValueError: I/O operation on closed file.。对于这种情况,必须在 with 内部完成数据收集(如 return f.read().splitlines())或者直接在外部开启 with 语句管理生命周期。
掌握 with 语句与上下文管理器的核心要义在于:把物理资源的生命周期明确限制在一个紧凑的作用域之内。在实际开发中,保持显式指定编码(encoding="utf-8")、根据数据规模选择流式迭代、并在发生未知异常时借助上下文协议实现 100% 的底层句柄闭环,是编写高质量、高韧性 Python 工程代码的基本功。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















