


怎么将Python 2项目迁移到Python 3:2to3工具使用与手动修改指南
详细讲解如何使用2to3工具将Python 2项目迁移到Python 3,包括自动转换操作步骤、常见手动修改项目及迁移后验证方法。
你接手了一个几年前写的Python项目,运行时发现满屏的SyntaxError——print语句不被识别、unicode类型找不到、dict.has_key()报错。原因很简单:项目是Python 2写的,而当前环境已经是Python 3。Python 2在2020年1月停止官方维护,迁移到Python 3是迟早要面对的事。本文从实际操作出发,先讲怎样用Python自带的2to3工具完成大部分自动转换,再整理需要手动处理的典型问题,最后说明迁移后如何验证代码是否正确运行。
一、迁移前的准备工作
在动手修改代码之前,有几件事情先做好会让整个过程更顺利。
1. 确认当前Python 2的版本和依赖
在项目根目录运行以下命令,记录Python版本和已安装的第三方包:
python --version
pip freeze > requirements_py2.txt
输出示例:
Python 2.7.18保留这份requirements_py2.txt,后面需要逐个确认这些第三方库是否支持Python 3。大部分活跃维护的库早已兼容,但少数老旧的库可能需要寻找替代品。可以在PyPI页面查看每个包的"Programming Language"分类,或者直接用pip install在Python 3环境中尝试安装。
2. 确保有完整的版本控制
迁移会大量修改源文件。开始之前,把代码提交到Git(或其他版本管理工具),并创建一个独立的分支:
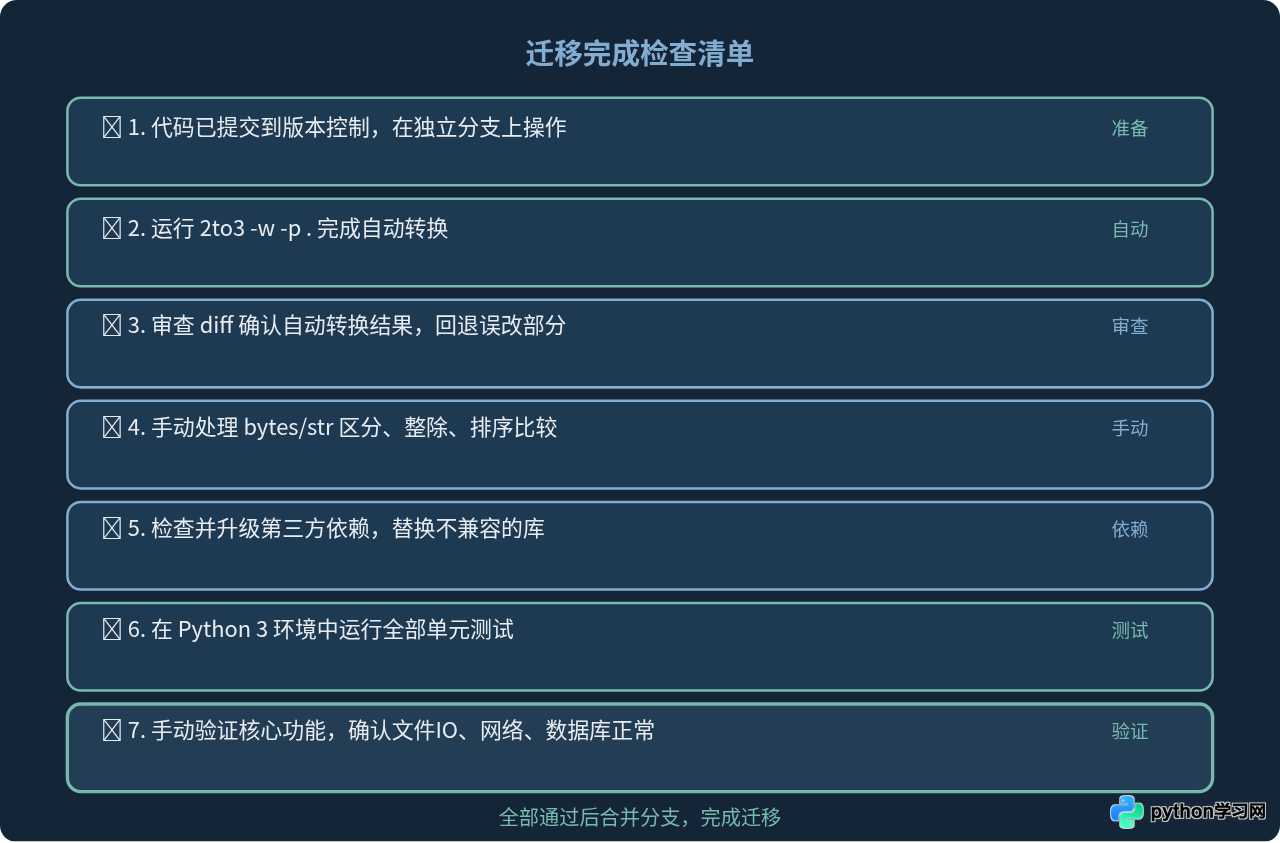
git checkout -b migrate-to-py3这样即使转换出了问题,也可以随时回退。
3. 准备Python 3环境
安装Python 3.8或更高版本。建议用venv创建一个独立的虚拟环境,避免影响系统中其他项目:
python3 -m venv py3env
source py3env/bin/activate
Windows系统下激活方式不同:
py3env\Scripts\activate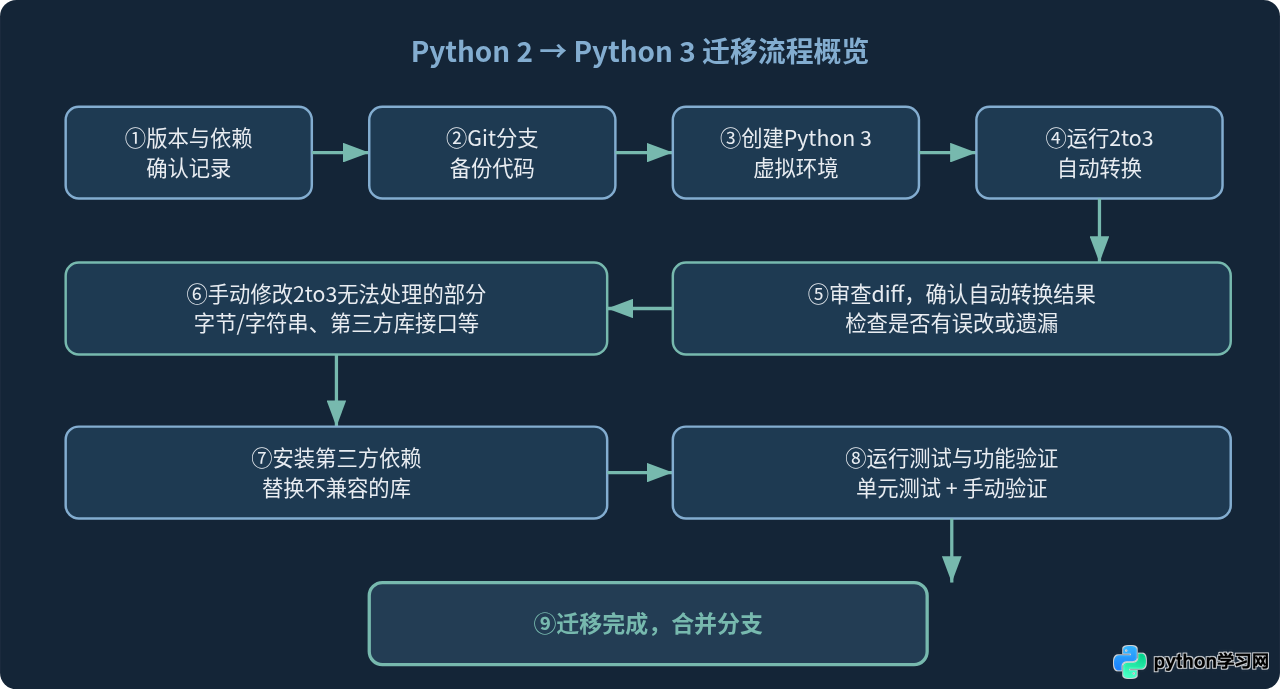
二、使用2to3工具自动转换
2to3是Python标准库自带的命令行工具,专门用来把Python 2源码转换为Python 3语法。它通过一组"修复器"(fixer)逐项处理已知的语法和API差异,覆盖了大约40种常见的不兼容写法。
1. 先预览不实际修改
在项目根目录运行以下命令,2to3会扫描所有.py文件并输出差异,但不会真的改动文件:
2to3 -p .参数说明:-p表示把当前目录当作一个包来处理,能正确解析相对导入。末尾的.代表当前目录。
输出类似于diff格式,显示每个文件将被修改的具体行。仔细阅读这些差异,确认没有明显的误转换。
2. 执行实际写入
确认预览结果可以接受后,加上-w参数让工具直接修改源文件:
2to3 -w -p .工具会自动为每个被修改的文件保留.bak备份。如果不需要备份文件(已有Git管理),可以加-n:
2to3 -w -n -p .3. 只运行指定修复器
有时候你只想处理某一类问题,比如只转换print语句。可以用-f参数指定修复器名称:
2to3 -w -f print -f has_key .查看全部可用修复器列表:
2to3 -l常用的修复器包括:
| 修复器名称 | 转换内容 | 示例 |
|---|---|---|
print | print语句 → print()函数 | print "hi" → print("hi") |
has_key | dict.has_key(k) → k in dict | d.has_key("a") → "a" in d |
except | 异常捕获语法 | except E, e: → except E as e: |
raise | raise语法 | raise E, msg → raise E(msg) |
imports | 标准库模块重命名 | import ConfigParser → import configparser |
xrange | xrange() → range() | 直接替换 |
unicode | unicode() → str() | 直接替换 |
itertools | 迭代器方法变更 | dict.iteritems() → dict.items() |
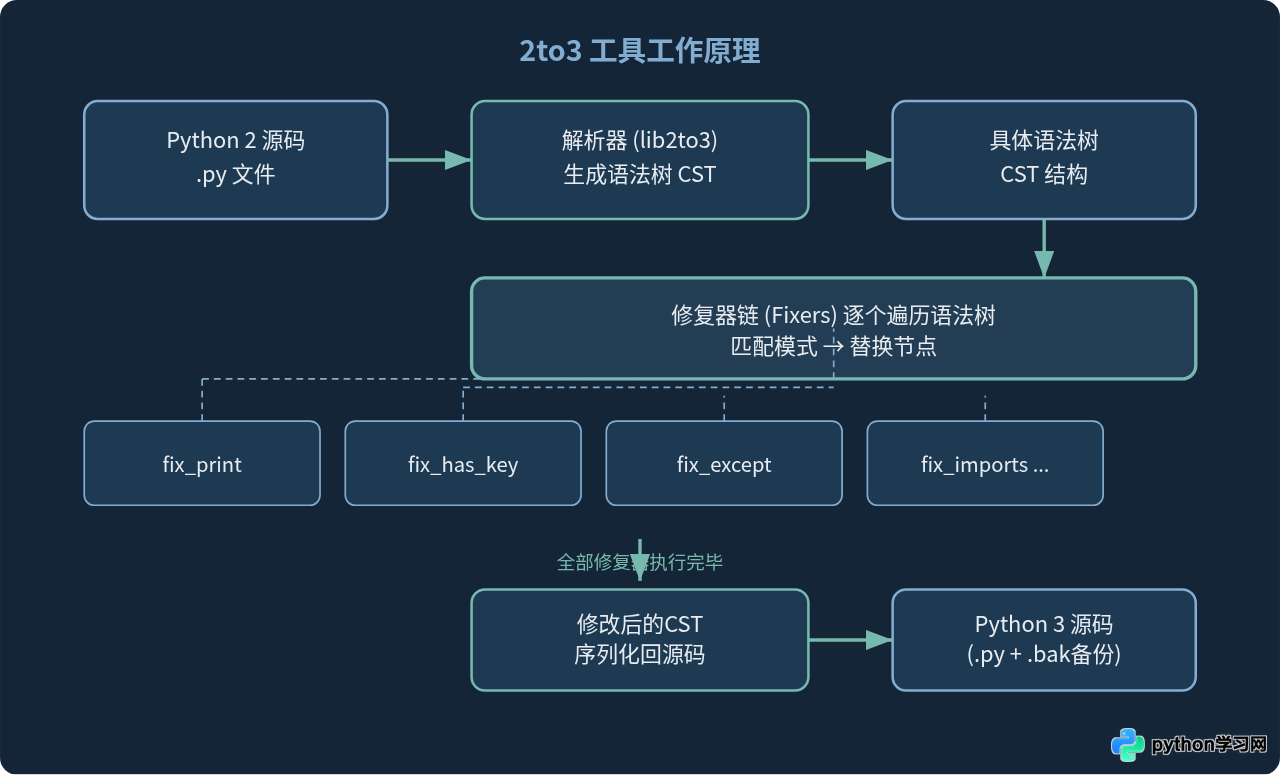
三、2to3无法自动处理的部分:手动修改指南
2to3能处理语法层面的差异,但有些改动涉及运行时语义,工具无法准确判断。以下是最常见的几类需要手动处理的问题。
1. 字节串与文本字符串的区分
Python 2中,str实际上是字节串,unicode才是文本。Python 3中,str变成了文本(Unicode),字节串用bytes表示。2to3会把unicode()替换成str(),但不会帮你判断代码中每个str到底该保留为文本还是改成bytes。
重点检查这些场景:
- 文件操作:Python 2中
open()默认以字节模式读写,Python 3默认以文本模式读写。处理二进制文件(图片、PDF等)时必须显式使用"rb"/"wb"模式。 - 网络传输:socket发送和接收的都是
bytes,需要.encode()和.decode()来转换。 - 数据库交互:部分驱动返回的字段类型可能变化,需要逐个确认。
修改示例:
# Python 2 写法
data = open("config.dat").read()   # 返回 str(字节串)

# Python 3 —— 如果文件是文本
data = open("config.dat", encoding="utf-8").read()   # 返回 str(文本)

# Python 3 —— 如果文件是二进制
data = open("config.dat", "rb").read()   # 返回 bytes
2. 整数除法
Python 2中,两个整数相除默认做整除:5/2得到2。Python 3中,/总是返回浮点数:5/2得到2.5。如果代码依赖整除行为,需要改成//:
# Python 2
result = total / count    # 整除

# Python 3 如果需要整除
result = total // count2to3默认不处理除法,因为它无法判断你是否需要浮点结果。可以用-f division修复器尝试,但仍需人工审查每一处。
3. 字典方法返回值变化
2to3会把dict.keys()、dict.values()、dict.items()保持原样或做简单替换,但这些方法在Python 3中返回的是视图(view)而不是列表。如果代码中对返回值做索引操作或多次迭代并且中途修改字典,需要显式转换:
# 如果需要列表
keys_list = list(my_dict.keys())

# 如果只是遍历,view 也可以直接用
for k, v in my_dict.items():
    pass
4. 标准库模块变更
2to3能处理大部分模块重命名(如ConfigParser → configparser),但有些模块的内部结构也发生了变化:
urllib、urllib2、urlparse被合并为urllib.request、urllib.parse、urllib.error。2to3能做基本替换,但如果你从这些模块导入了不常见的函数,需要手动确认导入路径。Queue模块改名为queue。cPickle不再存在,直接用pickle(Python 3会自动选用C实现)。
5. 比较运算与排序
Python 3移除了cmp()函数,sort()和sorted()不再接受cmp参数,需要改用key参数。如果有自定义的__cmp__方法,需要替换为__lt__、__eq__等富比较方法:
# Python 2
class Item:
    def __cmp__(self, other):
        return cmp(self.value, other.value)

# Python 3
from functools import total_ordering

@total_ordering
class Item:
    def __eq__(self, other):
        return self.value == other.value
    def __lt__(self, other):
return self.value < other.valuefunctools.cmp_to_key()把旧的cmp函数包装成key函数,减少一次性改动量。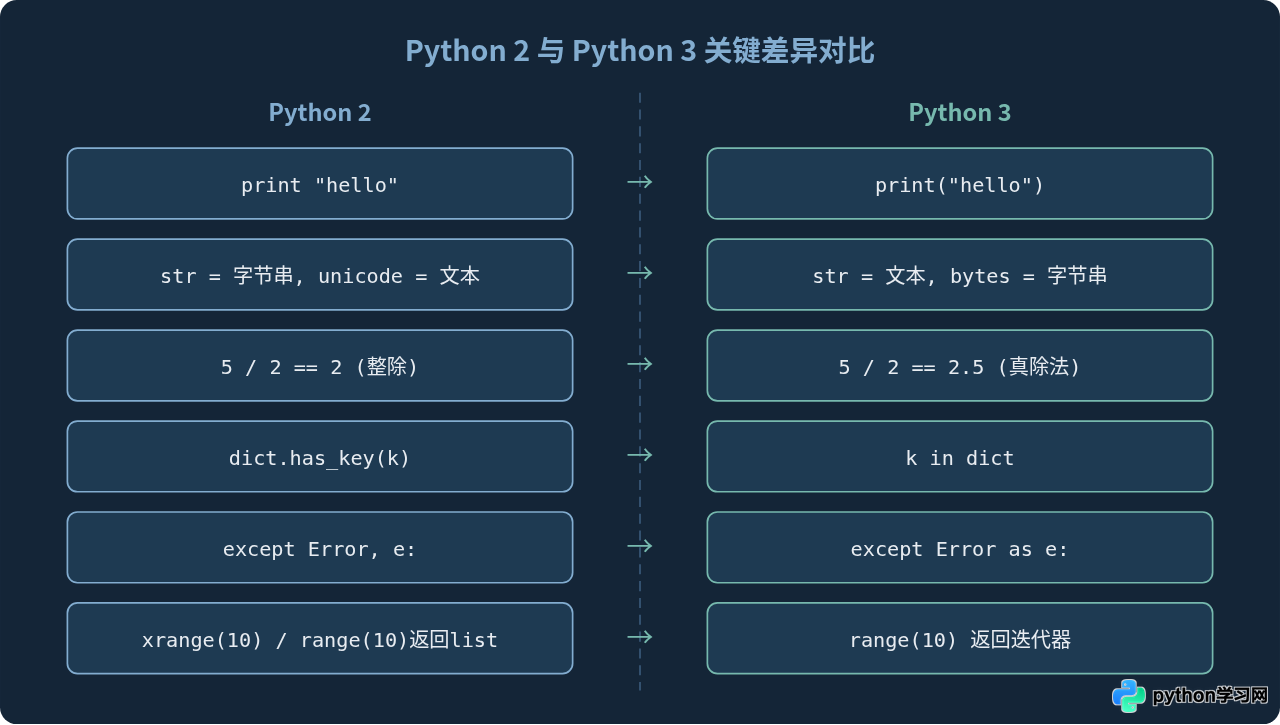
四、第三方库的处理
自动和手动修改完项目代码后,还需要处理第三方依赖。步骤如下:
打开之前保存的requirements_py2.txt,逐个包检查:
- 在PyPI上搜索该包,查看是否有Python 3兼容的版本。大多数情况下只需升级到最新版本即可。
- 如果包已经停止维护且不支持Python 3,寻找社区推荐的替代品。例如
MySQL-python可以用mysqlclient或PyMySQL替换。 - 部分包的API在Python 3版本中有所变化,需要查阅更新日志并相应修改调用方式。
在Python 3虚拟环境中重新安装依赖:
pip install -r requirements_py2.txt安装失败的包需要逐个排查,确定是版本问题还是不再支持。
五、迁移后的验证
1. 运行现有测试
如果项目有单元测试,直接在Python 3环境中运行:
python -m pytest或者使用项目原来的测试方式(unittest、nose等)。关注以下几类失败:
TypeError:通常与字节串/字符串混用有关ImportError:模块路径变了或第三方库不兼容AssertionError:计算结果变了,很可能是整除变真除法导致
2. 手动功能验证
对核心功能做一次手动测试。特别关注:
- 文件读写是否正常,尤其是中文和二进制文件
- 网络请求和数据库操作是否返回预期类型
- 排序结果是否和之前一致
3. 使用pylint或pyflakes检查
静态分析工具可以帮助发现遗漏的问题:
pip install pylint
pylint your_package/
关注与Python 3不兼容相关的警告。
六、一些实用的迁移技巧
处理编码声明
Python 2文件顶部常见的# -*- coding: utf-8 -*-声明,在Python 3中不是必须的(默认就是UTF-8),但保留也不会报错。如果项目文件很多,不用特意去删除。
使用__future__做渐进迁移
如果项目暂时还需要同时兼容Python 2和3,可以在Python 2代码顶部添加:
from __future__ import print_function
from __future__ import division
from __future__ import unicode_literals
from __future__ import absolute_import
这些导入让Python 2的行为更接近Python 3,可以提前暴露兼容性问题,分阶段完成迁移。
使用six或python-future库
对于需要长期同时支持两个版本的库项目,six提供了一套兼容层:
import six

if six.PY3:
    string_types = str
else:
    string_types = basestring
不过对大多数应用项目来说,直接迁移到Python 3更简单,不建议为了兼容性引入额外的复杂度。
七、常见问题
2to3运行报错"No module named lib2to3"怎么办?
某些精简版Python安装(如部分Linux发行版的python3-minimal)可能没有包含lib2to3。安装完整版Python或对应的python3-lib2to3包即可解决。
迁移后中文显示为乱码
通常是文件打开时没有指定编码。在所有open()调用中添加encoding="utf-8"(或文件实际使用的编码),这是Python 2到3迁移中最常见的遗漏。
能不能直接用Python 3运行Python 2代码?
少数简单脚本可以直接运行,但稍微复杂的项目几乎都会遇到问题。print语句、except语法、标准库模块位置这些基础差异就足以让代码无法启动。建议走完整的迁移流程,不要抱有侥幸心理。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















