


Python列表推导式与生成器代码示例:简化循环逻辑
深入解析Python列表推导式与生成器的语法结构、内存机制与性能差异,通过丰富的代码示例展示如何简化冗长的循环逻辑,助你写出兼具可读性与高执行效率的代码。
编写 Python 代码时,许多初学者和进阶开发者都会经历从“繁琐循环堆叠”到“简洁优雅表达”的转变。最常见的场景莫过于:先在外部声明一个空列表,接着编写 for 循环遍历序列,随后在内部嵌套 if 条件,最后调用 append() 把结果装入列表。这种多行模板代码虽然结构清晰,但在数据过滤和映射转换频繁的工程中,极易让关键业务逻辑被淹没在机械式的语法框架中。本文将通过直观的代码演进示例,深入讲解 Python 的列表推导式(List Comprehension)与生成器(Generator),剖析它们如何将复杂的循环压缩为精炼的声明式表达,并厘清两者在内存机制与计算时序上的核心分界。
一、从样板代码到列表推导式:语法的精简与重构
日常开发中,对现有序列进行数据清洗与计算是高频任务。例如,我们需要从一批整数中筛选出所有偶数,并计算它们的平方值。按照常规面向过程的写法,代码通常如下展开:
# 传统 for 循环写法
raw_numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
squared_evens = []

for num in raw_numbers:
    if num % 2 == 0:
        squared_evens.append(num ** 2)

# 示例输出: [4, 16, 36, 64, 100]
print(squared_evens)这段代码占据了整整五行。它的核心计算意图其实非常纯粹:取平方(num ** 2)、来源范围(raw_numbers)以及满足条件(num % 2 == 0)。而列表初始化与显式的 append 调用只是语言机制层面的胶水代码。利用 Python 的列表推导式,我们可以将这套操作重构为一行具有极高可读性的语句:
# 使用列表推导式简化循环
raw_numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
squared_evens = [num ** 2 for num in raw_numbers if num % 2 == 0]

# 示例输出: [4, 16, 36, 64, 100]
print(squared_evens)
这种语法的直观之处在于,它把开发者的思考焦点从“如何一步步把数据推进容器”转移为“目标数据长什么样”。在推导式中,最左侧是转换表达式,中间是数据源迭代,右侧是可选的过滤条件。整个语法结构与传统循环有着精确的一一映射关系。
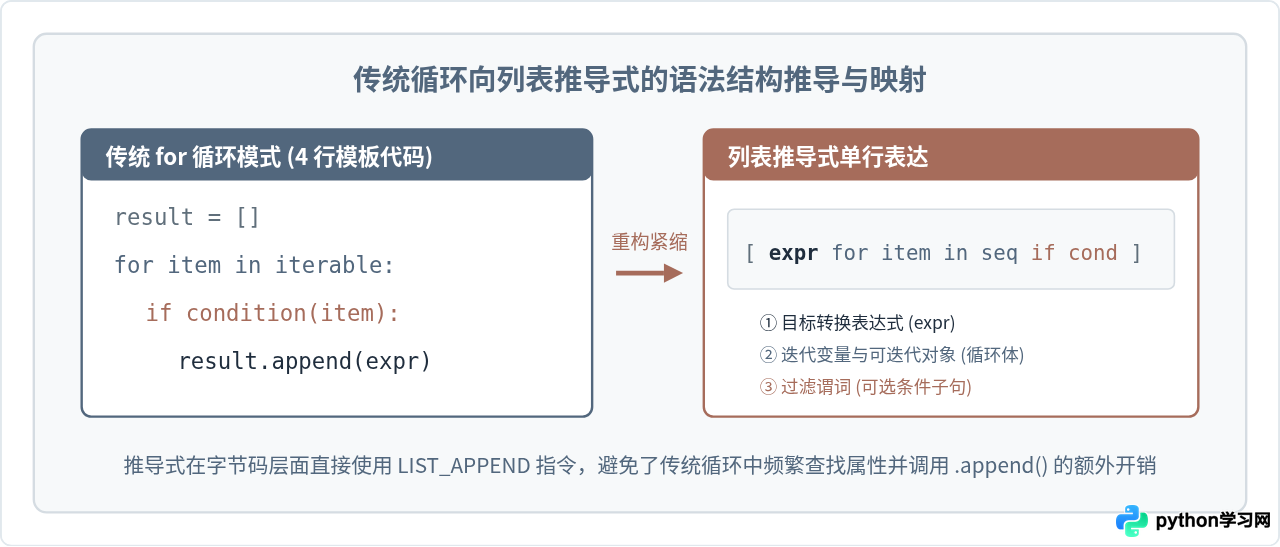
值得注意的是,列表推导式不仅是语法糖。在 Python 底层,由于推导式被编译为专门的字节码指令(如 LIST_APPEND),省去了在 Python 虚拟机层面每次查找对象方法属性并进行函数调用的额外耗时,因此在大多数情况下,列表推导式的执行速度比标准的 for + append 还要快 20% 到 30%。
多层嵌套与扁平化矩阵处理
除了简单的单层过滤,列表推导式同样支持嵌套循环。一个经典的场景是将二维矩阵扁平化为一维列表:
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]

# 扁平化二维矩阵: 外层循环在前,内层循环在后
flattened = [item for row in matrix for item in row]

# 示例输出: [1, 2, 3, 4, 5, 6, 7, 8, 9]
print(flattened)理解多层推导式的顺序原则非常简单:子句的书写顺序与传统多层 for 循环的缩进顺序完全一致。最外层的 for row in matrix 写在前面,内层的 for item in row 紧随其后。但一般建议最多使用两层嵌套;若嵌套层级达到三层以上,推导式的可读性会急剧恶化,此时应果断改回普通嵌套循环或封装辅助函数。
二、内存的隐形分水岭:列表推导式 vs 生成器表达式
列表推导式虽然精炼快捷,但它有一个根本机制:即时全量求值(Eager Evaluation)。这意味着一旦推导式执行完毕,所有计算结果都会立即在内存中实例化为一个完整的 list 对象。
如果数据只有几百或几千条,内存开销微不足道。但如果面对的是千万级日志、海量数据库拉取或大型传感器数据流,列表推导式会瞬间占用数吉字节(GB)的物理内存,甚至直接触发系统级 OOM(Out of Memory)崩溃。请看下面这组简单的内存占用对比实验:
import sys

# 假设我们需要处理一千万个整数的平方
n = 10_000_000

# 1. 列表推导式: 方括号 []
list_comp = [x * 2 for x in range(n)]
print(f"列表推导式内存占用: {sys.getsizeof(list_comp) / (1024 * 1024):.2f} MB")
# 示例环境输出约: 81.49 MB (仅列表自身指针数组,若包含独立对象占用更高)

# 2. 生成器表达式: 圆括号 ()
gen_exp = (x * 2 for x in range(n))
print(f"生成器表达式内存占用: {sys.getsizeof(gen_exp)} 字节")
# 示例环境输出: 112 字节 (仅占用固定的状态机容器)在语法形式上,生成器表达式与列表推导式几乎完全一样,唯一的区别是将方括号 [] 替换为圆括号 ()。然而,两者在系统底层有着截然不同的求值时序与生命周期模型:
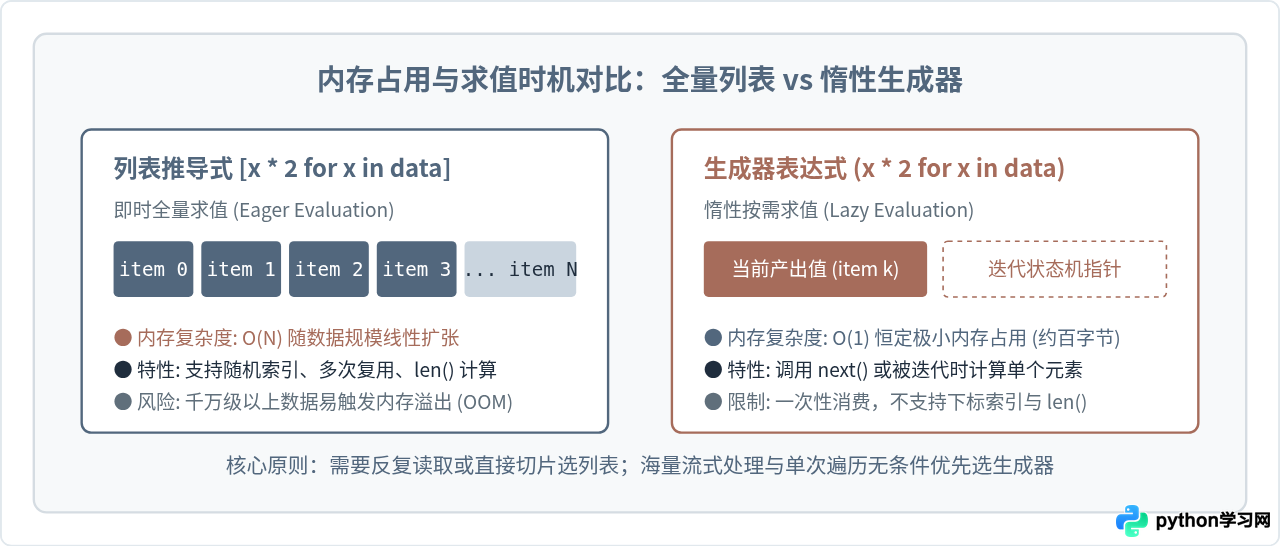
生成器之所以能够保持恒定的极小内存,是因为它应用了惰性求值(Lazy Evaluation)。定义生成器时,Python 根本没有计算任何具体元素,它仅仅创建了一个记住了代码逻辑与游标位置的迭代器对象。只有当下游通过 for 循环或 next() 函数主动向它索取时,它才会计算出下一个值,传递出去后立即释放上一个中间变量。
三、生成器函数与 yield:构建流式数据处理管道
当循环内部逻辑较为简单时,生成器表达式 (expr for x in seq) 是最佳选择。但当循环中包含复杂的清洗规则、多重异常捕获或多步数据拆分时,表达式便无法容纳。此时我们需要使用包含 yield 关键字的生成器函数(Generator Function)。
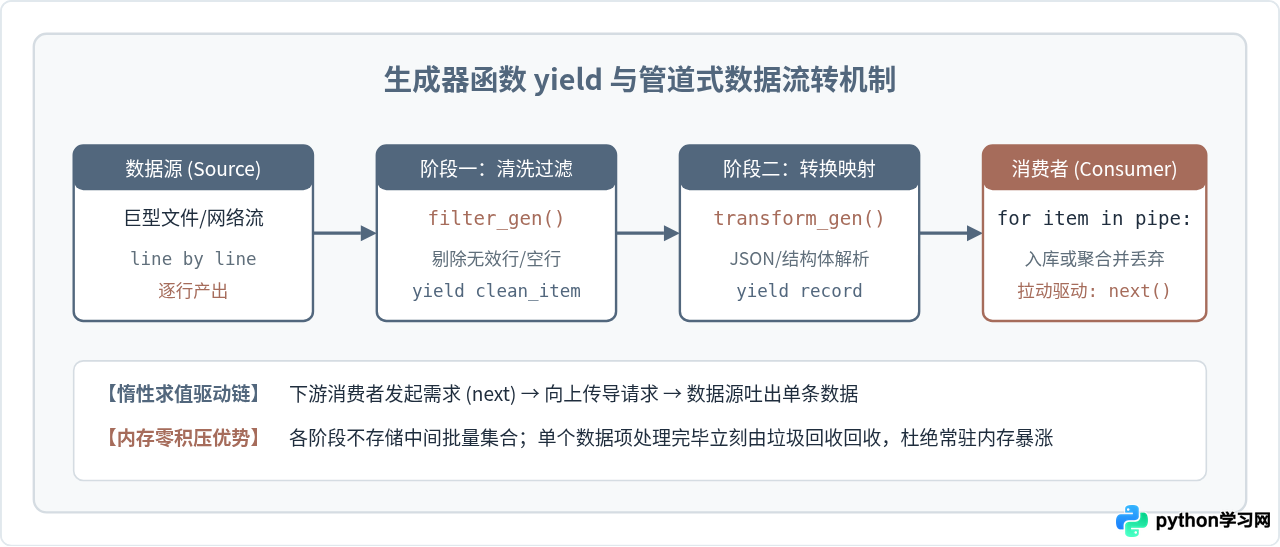
与使用 return 彻底结束函数执行不同,当 Python 执行到 yield 时,会像打书签一样冻结函数的当前堆栈(包括局部变量状态、指令指针),并将计算结果送出;当下一次调用 next() 时,函数会从 yield 的下一行精准苏醒继续运行。
# 示例:模拟流式日志读取与过滤
def stream_large_log(log_records):
    """逐行模拟生成日志,不一次性加载所有文本"""
    for record in log_records:
        # yield 将当前记录交出,并在此处挂起函数
        yield record

def filter_error_events(log_stream):
    """中间过滤器:清洗并仅保留包含 ERROR 级别的记录"""
    for entry in log_stream:
        if "ERROR" in entry:
            yield entry.strip().upper()

# 模拟原始数据流
sample_logs = [
    "2026-10-23 10:00:01 INFO Server started",
    "2026-10-23 10:00:05 ERROR Database connection failed",
    "2026-10-23 10:00:08 DEBUG Keep-alive ping",
    "2026-10-23 10:00:12 ERROR Redis timeout"
]

# 组装数据管道: 数据源 -> 过滤器 -> 消费者
raw_stream = stream_large_log(sample_logs)
error_stream = filter_error_events(raw_stream)

# 消费者拉取数据
for alert in error_stream:
    # 示例输出:
    # 2026-10-23 10:00:05 ERROR DATABASE CONNECTION FAILED
    # 2026-10-23 10:00:12 ERROR REDIS TIMEOUT
print(f"触发告警: {alert}")这种模式被称为生成器管道(Generator Pipeline)。在整个流转过程中,数据像流水一样逐个通过每个加工阶段。哪怕数据源包含上亿行日志,系统中也只有当前正在处理的那一行记录常驻在内存中,彻底消除了内存瓶颈。
四、三大典型反模式与避坑指南
很多开发者在掌握了推导式与生成器后容易产生“所有循环都必须被压缩”的执念。过度使用或错误使用它们往往会带来比冗长代码更严重的逻辑缺陷。以下是生产环境中必须规避的三大常见陷阱:
1. 陷阱一:生成器的一次性消费(耗尽陷阱)
生成器是一个一次性的迭代游标。一旦它被完整遍历过一遍,其内部指针便停留在末尾。如果试图对它进行二次循环,将直接得到空结果,且不会抛出任何异常:
# 危险示例: 重复遍历生成器
gen = (x * 2 for x in [1, 2, 3])

# 第一次求和: 正常工作
total = sum(gen)
print(f"首次求和: {total}")  # 输出: 12

# 第二次统计长度或再次遍历: 生成器已耗尽!
count = len(list(gen))      # 此时 gen 已经是空的
print(f"再次读取长度: {count}") # 输出: 0 (而非预期的 3)避坑指南:如果你需要多次遍历数据、计算其长度 len() 或通过切片随机访问下标(如 gen[0]),必须使用列表推导式或通过 list(gen) 将其固定为持久化列表。
2. 陷阱二:为副作用(Side Effects)滥用推导式
推导式的核心使命是构建并返回一个新集合。如果在循环过程中你并不关心返回值,而只是为了触发“向数据库写一条记录”、“发送网络请求”或“控制台打印”,请务必使用传统的 for 循环:
# 反模式 (严重不推荐): 纯粹为了简短而产生副作用
[print(user.name) for user in user_list]  # 白白创建了一个装满 None 的无用临时列表

# 正确做法: 坦率使用常规 for 循环
for user in user_list:
    print(user.name)
3. 陷阱三:可读性恶化的复杂多条件推导式
不要在单个推导式中编写多个嵌套三元表达式或深层过滤。例如 [f(x) if c1(x) else g(x) if c2(x) else h(x) for x in data if c3(x) and not c4(x)] 这种代码被称为“推导式天书”,不仅极难调试,后续维护团队也完全无法直观理解分支边界。一旦逻辑超过两层分支,果断拆解为普通循环或具名过滤函数。
五、循环逻辑简化选型总结
在 Python 日常编码中,如何在普通 for 循环、列表推导式与生成器之间做出明智的技术选择?我们可以通过下表和决策树梳理出清晰的权衡边界:
| 特性维度 | 标准 for 循环 | 列表推导式 | 生成器 (表达式 / yield) |
|---|---|---|---|
| 语法形式 | 多行块级语句 | [expr for x in seq if cond] |
(expr for x in seq) / yield |
| 求值时机 | 即时按行执行 | 即时全量求值 (Eager) | 按需惰性求值 (Lazy) |
| 内存复杂度 | 取决于容器维护方式 | O(N) 与数据量成正比 |
O(1) 恒定极小开销 |
| 多次复用 | 取决于存储载体 | 支持多次反复访问与索引切片 | 不支持,一次性迭代耗尽 |
| 最佳适用场景 | 具有副作用、复杂分支或深层异常捕获 | 中小规模数据的快速转换与过滤 | 超大规模数据处理、流式计算、管道过滤 |
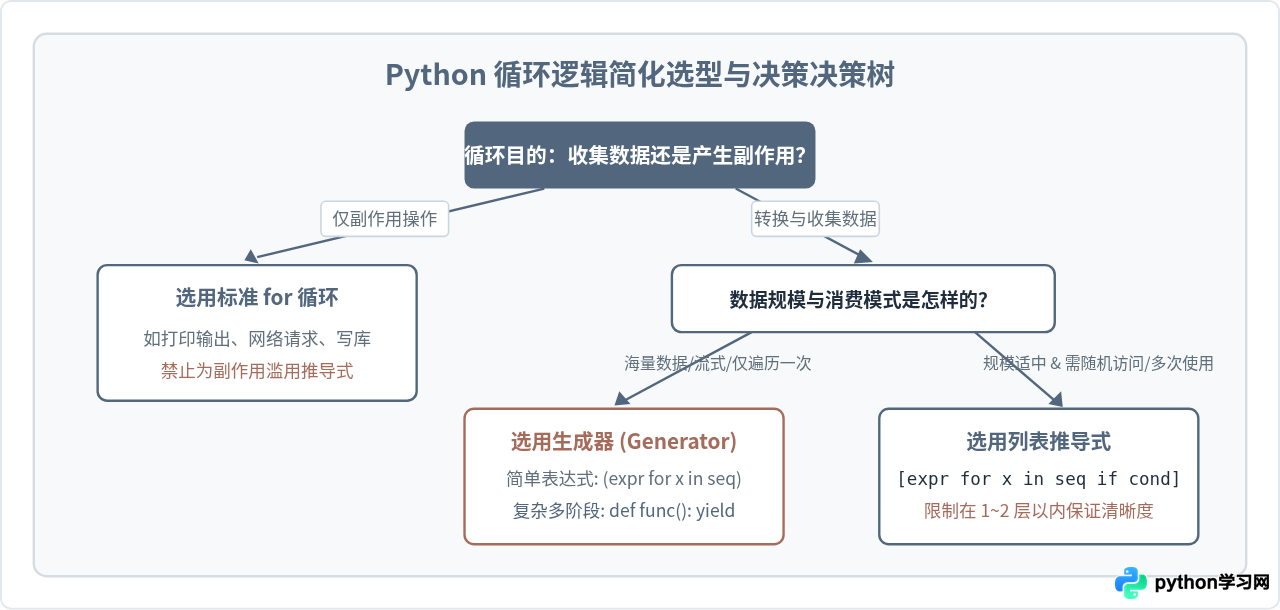
总结而言,Python 提供的推导式与生成器工具不仅能大幅消除低信噪比的胶水代码,更能从架构层面引导我们写出轻量、高效、内聚的程序逻辑。掌握“小规模数据用推导式提升意图表达、大规模流水线用生成器保障内存安全、执行纯副作用时坚守常规循环”的原则,便能在日常代码重构中游刃有余。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















