


Python数组去重怎么保持原始顺序?
在Python中对列表进行去重并保持原始顺序,最直接高效的标准方案是使用 list(dict.fromkeys(seq))。本文详细解析哈希集合乱序原因、保序去重经典方法、处理不可哈希对象的策略及性能对比。
list(dict.fromkeys(raw_list))。该写法在 Python 3.7 及以上版本中具有官方语言规范保证的保序特性,时间复杂度为 O(N)。
一、为什么最常用的 set() 去重会打乱顺序?
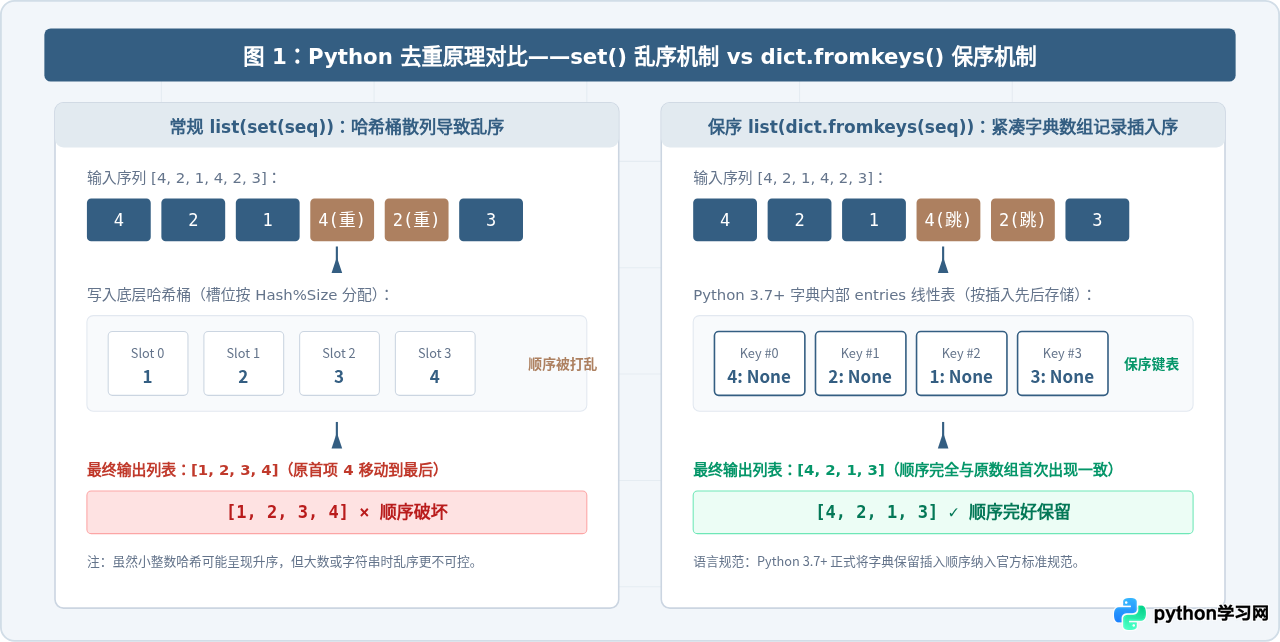
很多初学者接触 Python 去重时,首先想到的代码是 list(set(raw_list))。这种写法利用集合(Set)元素互异的特性确实可以去除重复项,但它完全无法保证顺序。
Python 中的 set 底层是基于开地址法哈希表实现的。元素在内存哈希桶中的分布取决于哈希值与掩码运算后的槽位位置,而非它们在源列表中的插入先后。当我们将集合重新转回列表时,遍历顺序是由哈希桶中的散列分布决定的,因此原先的列表顺序会被彻底打乱。
二、核心解决方案与代码实现
方法 1:利用 dict.fromkeys()(推荐,Python 3.7+)
这是现代 Python 中最地道(Pythonic)、执行速度最快的写法。dict.fromkeys(iterable) 会以传入序列中的元素作为字典的键创建一个新字典。因为字典的键具备天然的唯一性,重复出现的元素只会更新已有键对应的值,而不会增加新键。在 Python 3.7 之后,字典插入顺序成为语言保证的标准行为,因此再用 list() 取出所有键时,顺序与原序列初次出现的顺序完全一致。
# 示例代码:使用 dict.fromkeys 进行保序去重
raw_list = [4, 2, 1, 4, 2, 3, "apple", "banana", "apple"]
unique_list = list(dict.fromkeys(raw_list))

print("原列表:", raw_list)
print("去重后:", unique_list)
# 输出结果:
# 原列表: [4, 2, 1, 4, 2, 3, 'apple', 'banana', 'apple']
# 去重后: [4, 2, 1, 3, 'apple', 'banana']适用条件与限制:该方法要求列表中的元素必须是可哈希(Hashable)的对象(如数值、字符串、元组)。如果列表中包含字典、列表等不可哈希元素,会抛出 TypeError: unhashable type。
方法 2:结合辅助集合 seen 的遍历过滤
如果需要适配旧版本环境,或者在去重的同时需要执行复杂的额外过滤逻辑,可以使用一个辅助集合 seen = set() 来追踪已处理元素。集合的 in 查找操作平均时间复杂度为 O(1),能够确保整体去重算法依然保持 O(N) 的线性时间。
# 方式 2.1:标准循环写法(最直观、可读性最好)
def remove_duplicates_with_seen(seq):
    seen = set()
    result = []
    for item in seq:
        if item not in seen:
            seen.add(item)
            result.append(item)
    return result

data = [10, 20, 10, 30, 20, 40]
print(remove_duplicates_with_seen(data))  # [10, 20, 30, 40]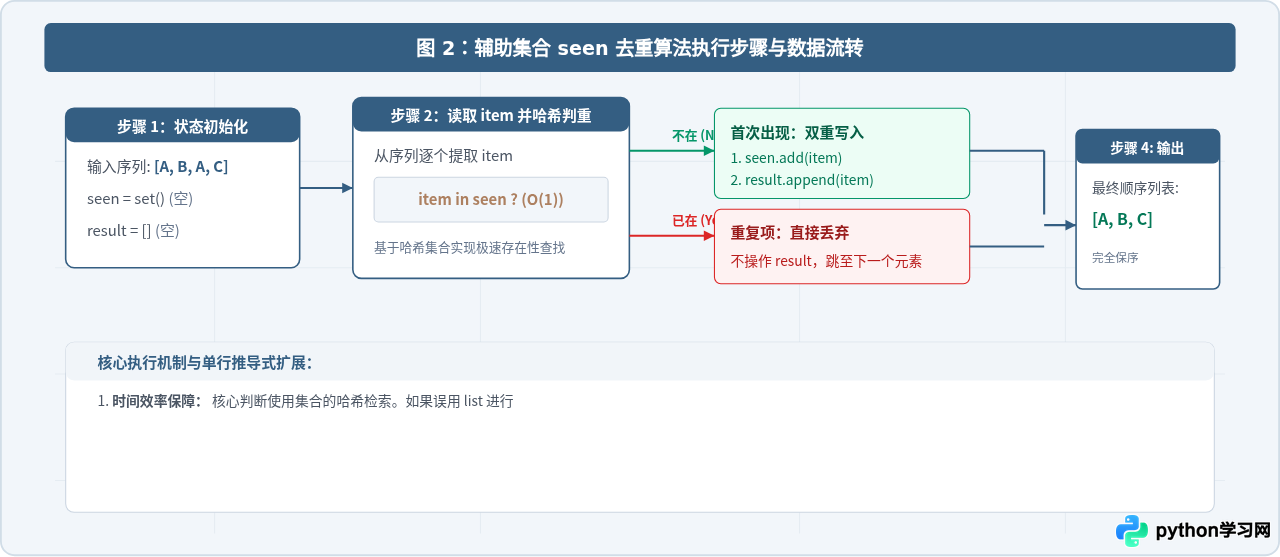
三、遇到不可哈希(Unhashable)对象怎么处理?
当数组中的元素本身不可哈希时(例如元素为字典 {"id": 1, "name": "Alice"},或者列表 [1, 2]),直接调用 dict.fromkeys() 或 set() 均会报错。针对这种业务场景,我们需要根据需求采取专门的策略:
1. 针对字典列表按特定字段去重
日常业务中最常见的是字典列表去重(如按照用户 ID 或编码)。此时可以把提取出来的键放入 seen 中:
users = [
    {"id": 101, "name": "张三"},
    {"id": 102, "name": "李四"},
    {"id": 101, "name": "张三(重复)"},
    {"id": 103, "name": "王五"}
]

seen_ids = set()
unique_users = []
for u in users:
    if u["id"] not in seen_ids:
        seen_ids.add(u["id"])
        unique_users.append(u)

# unique_users 结果中保留了 101、102、103 的首次出现,且顺序完全一致
2. 针对全量字典内容完全一致的保序去重
如果两个字典的所有键值对相同即视为重复,可以将字典转为已排序的元组元组 tuple(sorted(d.items())),转为可哈希对象后再去重:
def deduplicate_dict_list(dict_seq):
    seen = set()
    result = []
    for d in dict_seq:
        # 将不可哈希的 dict 序列化为可哈希的规范化元组
        marker = tuple(sorted(d.items()))
        if marker not in seen:
            seen.add(marker)
            result.append(d)
    return result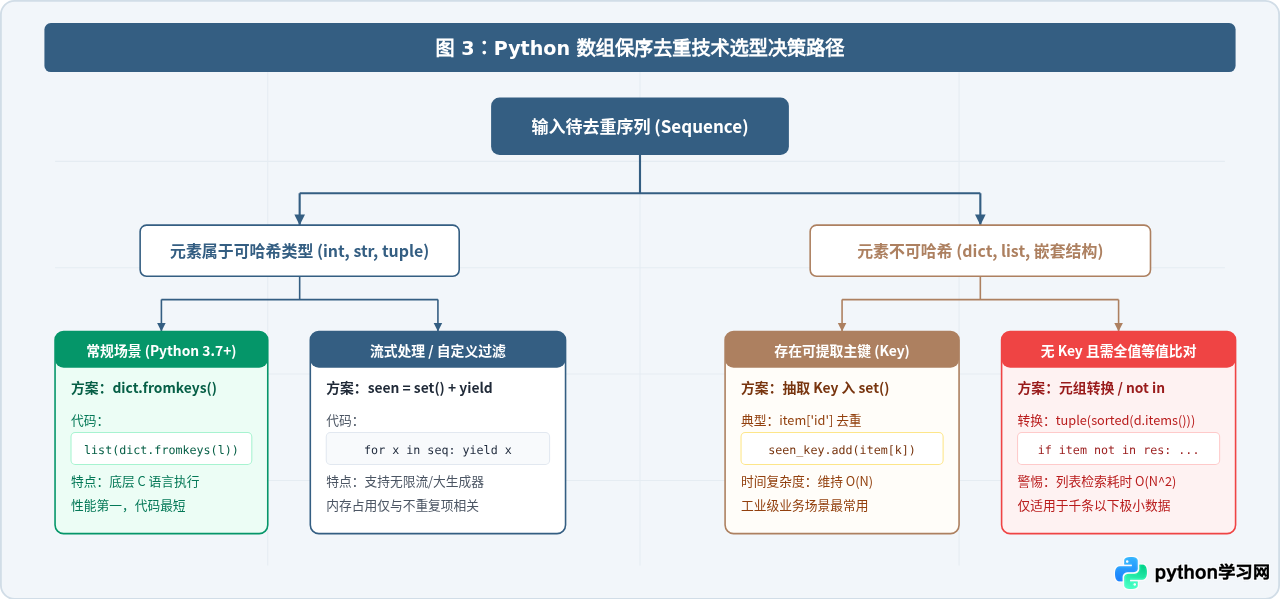
四、主流方案对比与性能实测分析
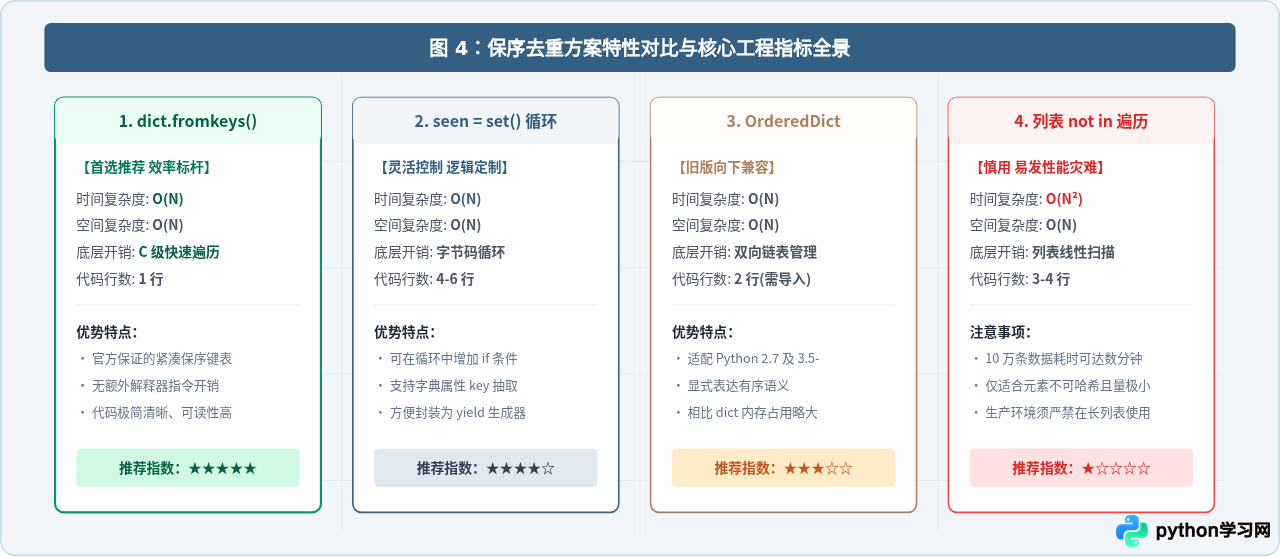
为了直观评估不同去重方式在时间与空间上的表现,我们梳理了以下几种常见实现方式的指标对比:
| 实现方案 | 典型代码 | 时间复杂度 | 空间复杂度 | 是否保持原序 | 适用版本与场景 |
|---|---|---|---|---|---|
| dict.fromkeys | list(dict.fromkeys(l)) |
O(N) | O(N) | 是 (3.7+) | 绝大多数现代 Python 环境首选(速度最快) |
| seen = set() 循环 | for x in l: if x not in seen... |
O(N) | O(N) | 是 | 逻辑灵活,可结合复杂过滤条件或生成器 |
| OrderedDict | list(OrderedDict.fromkeys(l)) |
O(N) | O(N) | 是 | 需要向下兼容 Python 2.7 / 3.5 及更早版本 |
| 列表 not in 遍历 | [res.append(x) for x in l if x not in res] |
O(N²) | O(N) | 是 | 极不推荐,数据量大于 1 万时会显著卡死 |
| set() 快速去重 | list(set(l)) |
O(N) | O(N) | 否 | 完全不在乎顺序时的极速选择 |
dict.fromkeys() 是在 C 层面直接执行循环与插入,省去了 Python 解释器在字节码层面的循环跳转开销,因此其实际运行耗时通常比手写的 seen = set() 循环快 1.5 到 2.5 倍左右。
五、工程实践常见陷阱与注意事项
-
布尔值与整型数值的重合:
在 Python 中,
bool是int的子类,True == 1且hash(True) == hash(1),同理False == 0。如果原始列表中同时包含1和True,去重时它们会被视为同一个键:
若业务上需要严格区分数据类型,可以采用data = [1, True, "hello"] print(list(dict.fromkeys(data))) # 输出 [1, 'hello'],True 被当作重复键过滤掉(type(x), x)作为判重标识。 -
浮点数与 NaN 的处理:
浮点数
float('nan')具有不等于自身的特性(float('nan') != float('nan'))。在早期 Python 版本中,向集合或字典插入多个 NaN 可能无法去重;但在现代 Python 的字典与集合实现中,首先会做同一性(x is y)比对,因此同一对象引用的 NaN 能够正常去重,而通过不同计算产生的独立 NaN 对象可能被多次保留。 -
不可变容器内嵌套可变类型:
元组本身属于可哈希类型,但若元组内部包含列表(如
(1, [2, 3])),则整个元组依然不可哈希,无法直接传入dict.fromkeys()。
六、总结与落地建议
回到最初的问题“Python数组去重怎么保持原始顺序”,在日常开发中的落地建议如下:
- 对于常规的可哈希元素(数值、字符串、普通元组等),直接使用
list(dict.fromkeys(seq))。这行代码性能最优、表意清晰,是现代 Python 的标准写法。 - 如果需要复杂的过滤条件、需要抽取对象字段(如对模型实例或字典去重),或者处理海量数据流,使用
seen = set()维护状态的循环或生成器。 - 牢记避免在任何生产环境的长列表中使用
if x not in result_list这一 O(N²) 的做法,以防在数据量增长时引发严重的系统响应阻塞。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















