


Python中in操作符效率对比:为什么集合查找比列表快
深入对比Python中in操作符在列表与集合上的效率差异,解析底层线性扫描与哈希表寻址机制,并提供选型决策与优化指南。
在 Python 中,使用 in 操作符判断一个元素是否存在于容器中是极其常见的操作。然而,同样是 x in container,在列表(list)与集合(set)上的执行效率存在数量级的巨大差异:列表的查找时间复杂度为 O(n),数据量越大耗时越长;而集合的查找时间复杂度平均为 O(1),无论容器内包含几十个还是上千万个元素,耗时基本维持在常数微秒级别。本文将通过基准测试、底层 CPython 源码实现原理剖析,全面解释为什么集合查找比列表快,并阐述背后的性能权衡与选型指南。
一、直观测试:基准对比与量级差异
为了直观观察性能差异,我们使用 Python 标准库中的 timeit 模块在不同数据量下对列表和集合的成员查找耗时进行基准测试。测试场景分别模拟:目标位于容器头部(最好情况)、目标位于容器尾部(最差情况)以及目标不存在(最差情况)。
import timeit

def benchmark_lookup():
    sizes = [100, 10_000, 1_000_000]
    for n in sizes:
        # 准备数据:列表与集合
        test_list = list(range(n))
        test_set = set(range(n))

        target = n - 1  # 尾部元素,代表列表最坏情况
        missing = -1    # 不存在的元素,必须遍历全表

        # 列表尾部查找
        t_list = timeit.timeit(lambda: target in test_list, number=1000)
        # 集合查找
        t_set = timeit.timeit(lambda: target in test_set, number=1000)

        print(f"规模 N={n:,}:")
        print(f"  列表查找 1000 次总耗时: {t_list * 1000:.3f} ms")
        print(f"  集合查找 1000 次总耗时: {t_set * 1000:.3f} ms")
        print(f"  速度倍数差异: 约 {t_list / t_set:.1f} 倍\n")

if __name__ == "__main__":
    benchmark_lookup()
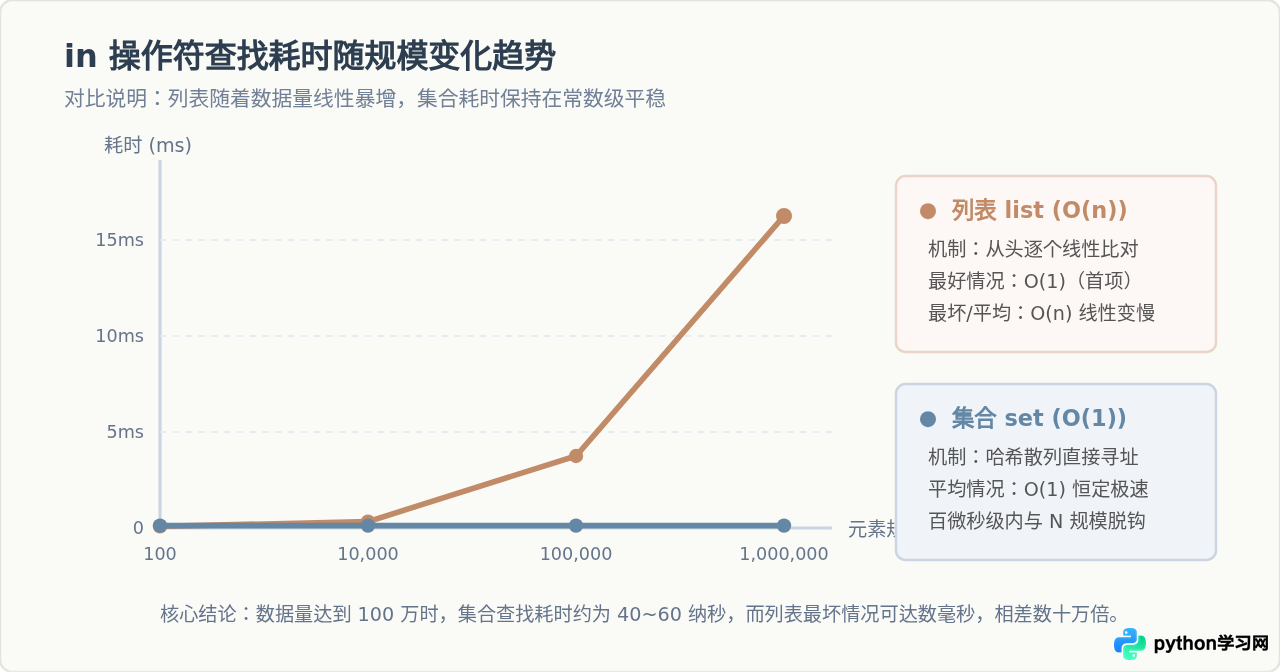
在 64 位 Python 3.11 环境下的实测参考数据如下表所示(执行 1000 次查找总耗时):
| 数据规模 (N) | 列表最坏耗时 (1000次) | 集合查找耗时 (1000次) | 耗时量级差异 |
|---|---|---|---|
| 100 | 约 0.65 ms | 约 0.04 ms | 集合快约 16 倍 |
| 10,000 | 约 68.20 ms | 约 0.04 ms | 集合快约 1,700 倍 |
| 1,000,000 | 约 7,150.00 ms | 约 0.05 ms | 集合快约 140,000 倍 |
从数据中可以清晰地看出规律:当数据量 N 增长 10,000 倍时,列表的查找耗时严格等比例增长了约 10,000 倍,呈现典型的线性关系;而集合查找耗时几乎完全没有变化,始终稳定在数十纳秒/次(1000 次约 0.04~0.05 ms)。
二、底层机制解密:列表的线性扫描原理
要理解为什么列表随着数据规模增大而变慢,需要从 CPython 底层结构(C 语言实现)一探究竟。
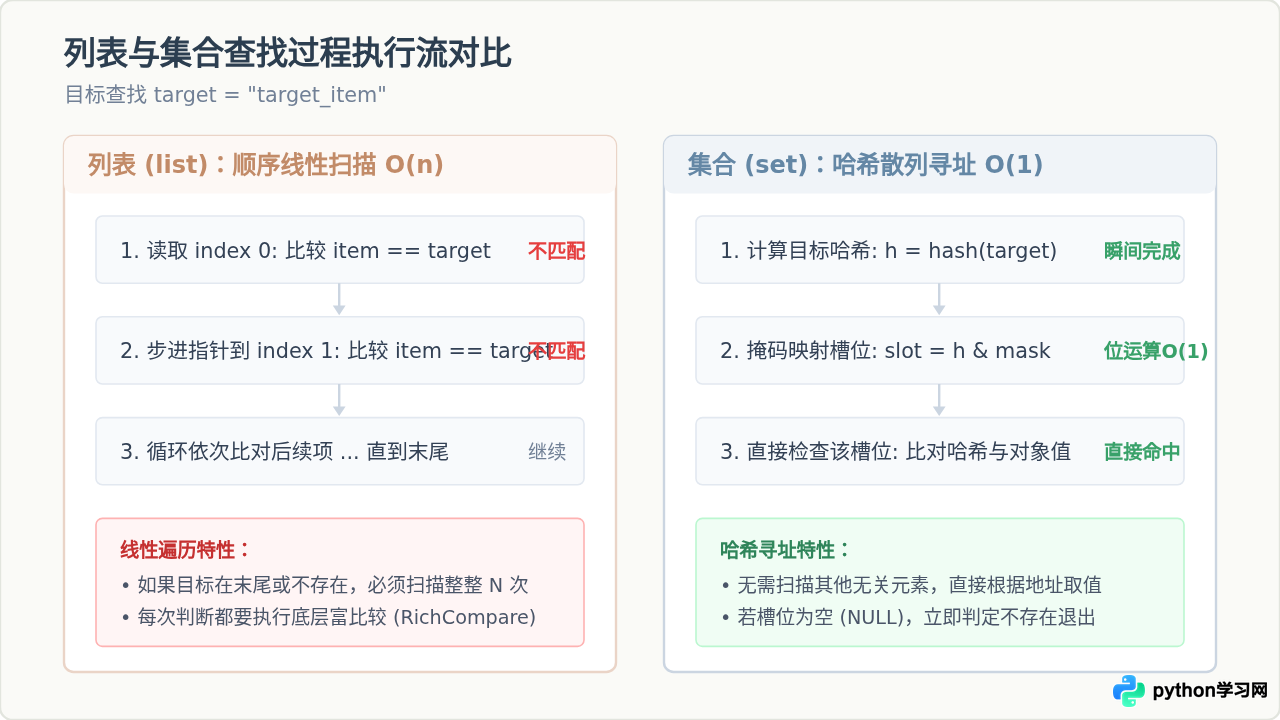
在 CPython 中,列表对应的是 PyListObject 结构体。它本质上是一个可变长度的连续指针数组。当我们在 Python 中执行 x in my_list 时,解释器会调用列表的内部包含检测方法,对应 C 源码中的 list_contains 函数:
// CPython listobject.c 中的核心循环伪代码逻辑
static int
list_contains(PyListObject *a, PyObject *el) {
    Py_ssize_t i;
    for (i = 0; i < Py_SIZE(a); ++i) {
        PyObject *item = a->ob_item[i];
        int cmp = PyObject_RichCompareBool(item, el, Py_EQ);
        if (cmp > 0)
            return 1; // 找到目标,返回 True
        if (cmp < 0)
            return -1; // 比较出错
    }
    return 0; // 遍历完毕未找到,返回 False
}
从上述逻辑可以清晰地看到:
- 必须按顺序逐个比对:指针从
i = 0递增到Py_SIZE(a) - 1。 - 开销累加:每一次循环不仅有数组指针偏移,还要调用
PyObject_RichCompareBool进行对象等值判断(==)。 - 无快速退出通道:如果目标元素恰好在第 0 位,那它是 O(1);但如果目标元素在列表末尾,或者根本不存在于列表中,它必须完成全部 N 次比较才能确定结果。因此平均时间复杂度为 O(n)。
三、底层机制解密:集合如何凭借哈希表做到 O(1)
集合(set)在 CPython 中对应 PySetObject,底层基于哈希表(Hash Table)实现。它不依赖“按位置扫描”,而是直接将“内容”转换成“内存地址索引”。
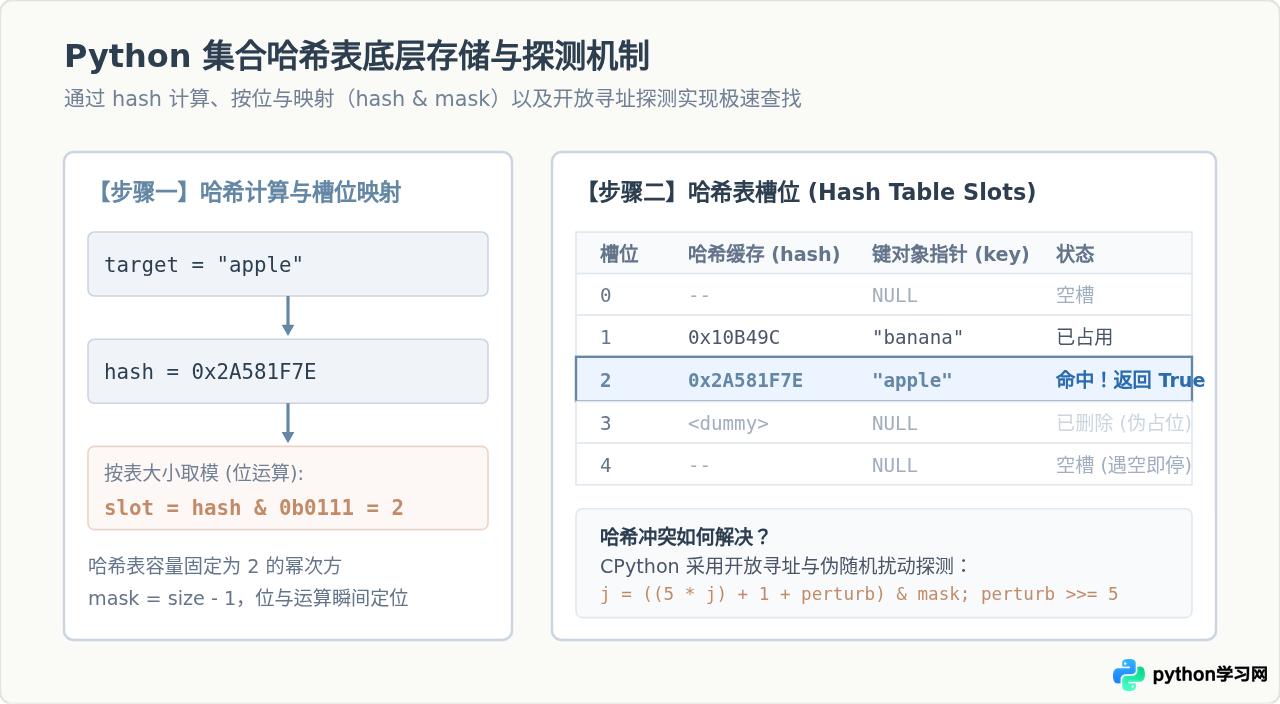
1. 哈希计算与位掩码映射
当执行 target in my_set 时,核心过程分为三步:
- 计算 Hash 值:调用目标对象的内置哈希函数,获取一个固定大小的整数,即
h = hash(target)。这对于整数、字符串等常见类型几乎是瞬时指令。 - 映射槽位下标:哈希表的容量大小总是保持为 2 的幂次方(如 8、16、32、64...)。因此,将哈希值映射到哈希表下标只需要做一次极快的按位与运算:
slot = h & (table_size - 1)。 - 检查对应槽位:
- 如果该槽位为空(
NULL),说明目标元素绝不可能存在于集合中,立即返回False。完全不需要看其他槽位。 - 如果槽位有数据,先比对存储的哈希缓存值(整数比较极快),若相同再比对对象本身(
item == target)。如果匹配成功,直接返回True。
- 如果该槽位为空(
2. 冲突解决机制:开放寻址与探测算法
不同的对象可能会计算出相同的槽位下标(哈希冲突)。当发生冲突时,CPython 既没有采用链表拉链法,也没有简单的线性递增(容易导致聚集),而是采用带有扰动因子(perturbation)的开放寻址探测法:
// CPython setobject.c 探测序列更新公式
j = ((5 * j) + 1 + perturb) & mask;
perturb >>= 5;
这种探测方式能够迅速跳跃到新的空闲槽位。为了保证冲突概率极低,Python 规定当集合的已用槽位超过总容量的 2/3(或更高阈值)时,就会主动进行扩容翻倍(Resize),因此平均探测次数仅在 1~2 次之间,从而在数学上严格维持了平均 O(1) 的常数时间复杂度。
四、权衡分析:集合更快背后的代价
虽然集合的查找性能具有压倒性优势,但计算机科学中没有免费的午餐,集合极速查找的背后存在着明确的代价:
1. 内存消耗显著增加(空间换时间)
为了保持哈希查找的高命中率并减少冲突,集合内部必须保留大量的未用空槽(通常维持至少 1/3 的空闲容量)。此外,每个槽位需要同时保存哈希值缓存和指针。通过 sys.getsizeof() 比较可以发现:
- 包含 10,000 个整数的
list:约占用 80 KB 内存。 - 包含 10,000 个整数的
set:约占用 512 KB 内存。
集合的内存开销通常是等量列表的 4~8 倍。在内存敏感型服务或超大数据集处理中,这是一个不能忽视的成本。
2. 元素可哈希性(Hashable)限制
集合中的元素必须是可哈希的(不可变对象),例如整数、浮点数、字符串、元组或冻结集合(frozenset)。可变对象如 list、dict 或 set 本身无法放入集合,否则会直接引发 TypeError: unhashable type: 'list'。
3. 构建与转换成本 O(n)
很多人误以为“既然集合查找快,那查找前把列表转成集合就行了”,写出类似下面的代码:
# 典型反模式:循环内部将列表临时转换为集合
for item in query_items:
    if item in set(large_list):  # 严重错误!每次循环都重新建表 O(n)
        process(item)
把一个包含 n 个元素的列表转换为集合,必须遍历整个列表、计算每个元素的哈希并依次插入哈希表,这个构建过程的时间复杂度本身就是 O(n)。如果你只执行一次查找,target in large_list 也是 O(n),且其常数时间比建一个完整的集合要小得多!因此,在循环内部随手临时 set(...) 不仅不会加速,反而会让性能大幅恶化。
五、实战优化与选型决策指南
在工程实践中,应该根据具体的数据规模、查找频次以及数据特征做出理性选择:
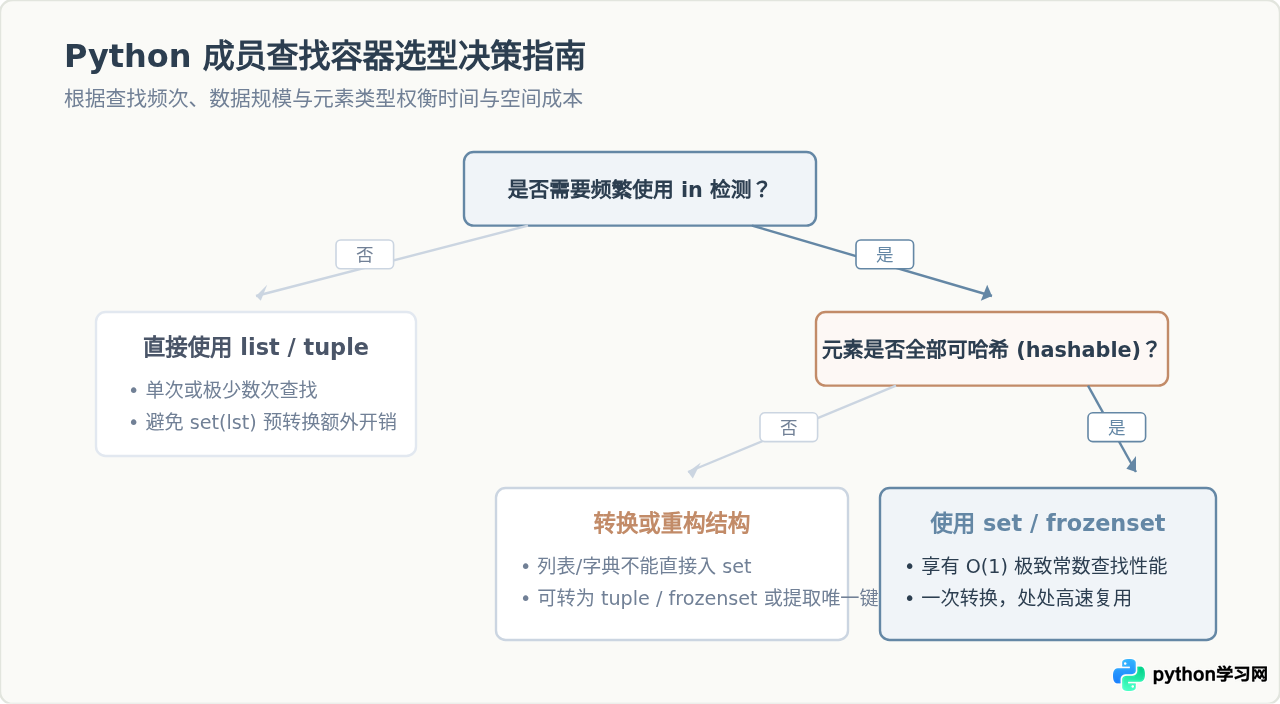
1. 静态白名单或过滤集:直接定义为集合
如果程序中存在一组固定的白名单、状态码或停用词,请直接定义为 set 或 frozenset,而不是 list:
# 推荐:直接声明为 set 字面量,编译期优化且查找速度极快
VALID_STATUS = {"pending", "approved", "rejected", "archived"}

def validate(status: str) -> bool:
    return status in VALID_STATUS
2. 批量查找与数据去重过滤:先转 set 再循环
当需要用一个大集合对成千上万个数据项进行过滤时,务必在循环体外部完成一次性转换:
# 推荐做法:一次转换,多次 O(1) 查找
def filter_records(records, blocked_ids_list):
    blocked_ids_set = set(blocked_ids_list)  # 单次 O(n) 开销

    # 随后循环内千百次查询全部享受 O(1)
    return [r for r in records if r.id not in blocked_ids_set]
3. 数据量极小(N < 10)且只查一两次:保留列表
当容器元素只有 3~5 个时,列表在连续内存上的局部缓存性极佳,此时哈希函数的计算开销甚至可能与直接线性比对相当。在这种轻量场景下,无需特意转换集合。
六、总结
回顾 Python 中 in 操作符的效率对比,其根本原因在于底层数据结构的组织逻辑不同:
- 列表(List):基于连续内存数组,执行线性遍历扫描,时间复杂度为 O(n),查找耗时随数据规模线性扩张。
- 集合(Set):基于哈希表,通过计算哈希值直接映射槽位地址,时间复杂度为 O(1),查找耗时恒定,不随数据规模发生改变。
在编写高性能 Python 代码时,只要遇到“多频次成员判定”或“大规模数据查找”的场景,都应优先使用 set(或字典的 key)代替 list,但切记在循环外完成转换,合理权衡内存占用与性能收益。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















