


Python使用pandas to_sql将DataFrame写入SQL数据库
深入讲解如何使用 Python 的 pandas.DataFrame.to_sql 方法将内存数据高效持久化至 SQL 数据库,系统解析 SQLAlchemy 引擎构建、if_exists 写入策略、chunksize 与 method='multi' 批量写入性能调优,以及 dtype 字段类型映射最佳实践。
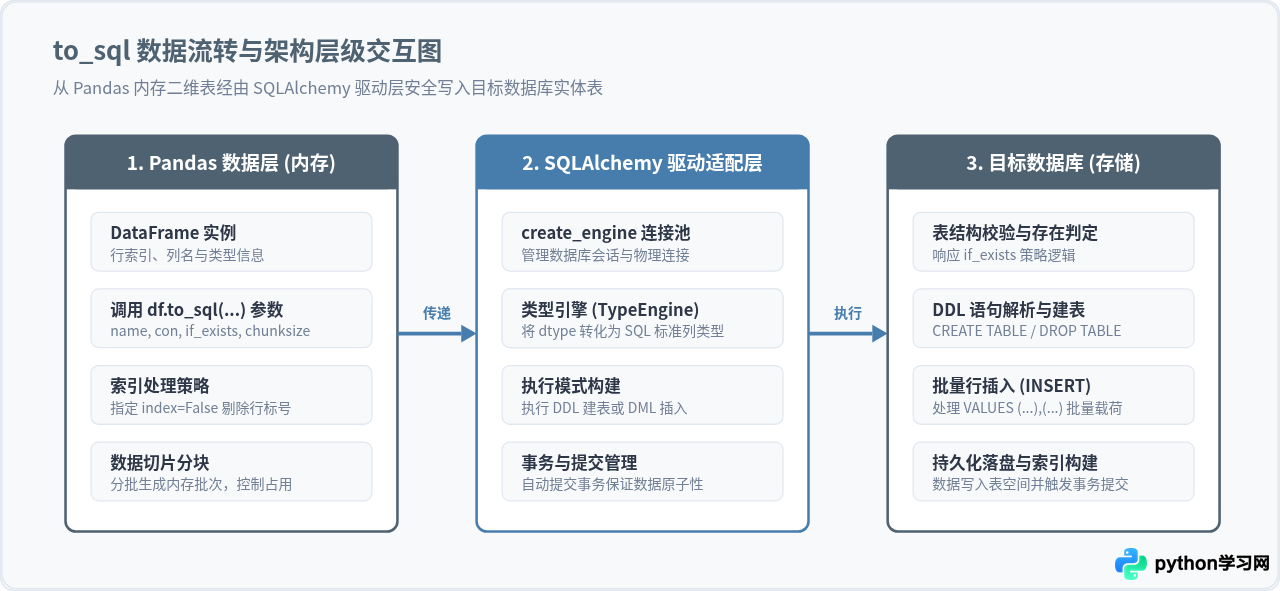
在数据清洗、指标计算或 ETL 自动化流程中,将内存中处理好的 Pandas DataFrame 结果持久化到关系型数据库中,是最常见的数据交付环节。Pandas 提供的 DataFrame.to_sql() 方法以 SQLAlchemy 为底层连接与方言引擎,支持直接将表格数据映射并写入 SQLite、MySQL、PostgreSQL 等常见数据库,免去了开发者手工拼接长篇 INSERT INTO 语句的繁琐操作。
一、准备工作:构建 SQLAlchemy 数据库引擎
自 Pandas 2.0 起,直接向 to_sql 传入原生 sqlite3 游标或第三方驱动原生连接的方式已逐渐被弃用,官方严格推荐使用 SQLAlchemy Engine 作为连接媒介。SQLAlchemy 不仅管理连接池,更能精准识别不同数据库方言(Dialect),确保列类型推断与批量语法兼容。
安装对应依赖库:
# 基础核心库
pip install pandas sqlalchemy

# 根据目标数据库安装对应底层驱动驱动
pip install pymysql       # 用于 MySQL
pip install psycopg2-binary # 用于 PostgreSQL
使用 create_engine 创建对应数据库的引擎实例:
from sqlalchemy import create_engine
import pandas as pd

# 1. 本地 SQLite 文件数据库
engine_sqlite = create_engine('sqlite:///analytics.db')

# 2. MySQL 数据库 (需提供 用户名:密码@主机:端口/数据库名)
engine_mysql = create_engine('mysql+pymysql://root:secure_pass@127.0.0.1:3306/prod_db')

# 3. PostgreSQL 数据库
engine_pg = create_engine('postgresql+psycopg2://postgres:secure_pass@127.0.0.1:5432/warehouse')
二、基础写入操作与核心参数
在获得了有效的 engine 之后,最基础的写入只需指定目标数据表名与连接对象。以下示例展示了构造样例数据并将其完整写入 SQLite 数据库的过程:
import pandas as pd
from sqlalchemy import create_engine

# 构造模拟业务数据
data = {
    'user_id': [1001, 1002, 1003],
    'username': ['Alice', 'Bob', 'Charlie'],
    'signup_score': [89.5, 94.0, 78.2]
}
df = pd.DataFrame(data)

# 初始化 SQLite 引擎
engine = create_engine('sqlite:///company.db')

# 执行写入操作:关键指定 index=False
df.to_sql(
    name='users',          # 目标数据库中的表名称
    con=engine,            # SQLAlchemy 引擎对象
    if_exists='replace',   # 表存在时的处理行为
    index=False            # 不将 DataFrame 自带的数字索引写为数据列
)

print("数据成功写入 users 表!")Pandas DataFrame 默认带有自增整数索引(0, 1, 2...)。若不加 index=False,to_sql 会在数据库表中额外新建一个名为 index 的整数列存储行标号。除极少数以特定业务 ID 作为行索引的场景外,这会污染目标表的列结构,增加不必要的存储开销。
三、深入理解 if_exists 写入策略
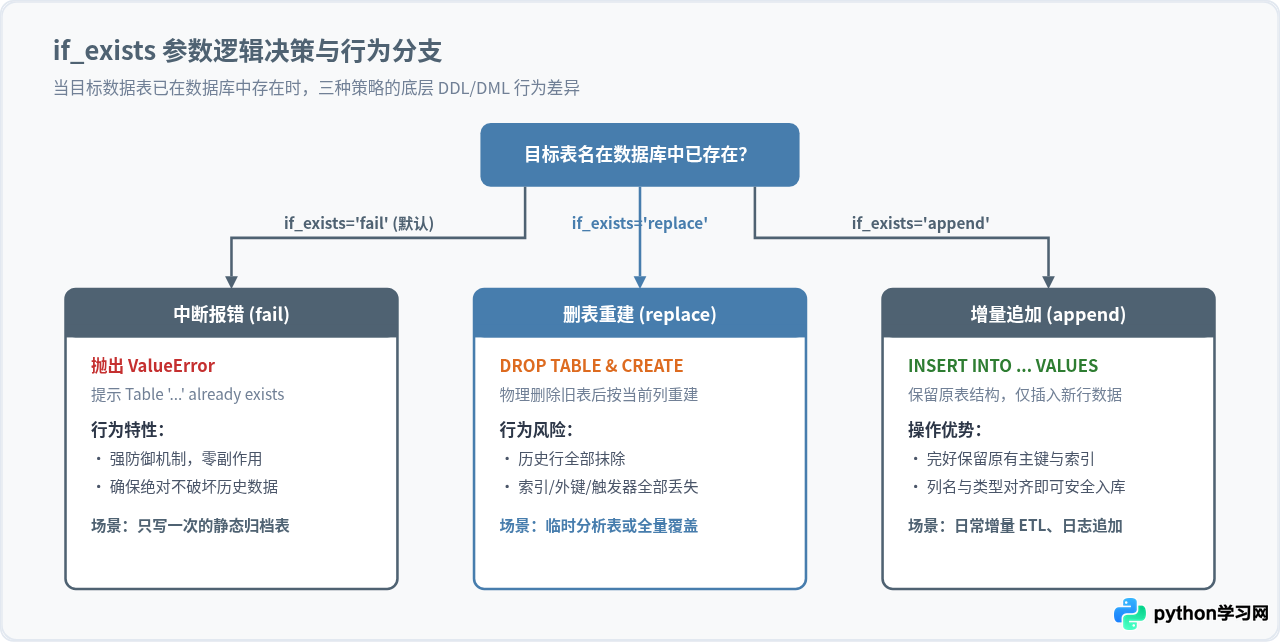
在实际生产中,写入的目标表往往已经存在历史数据。if_exists 参数决定了遇到同名表时的动作行为,支持三个预设选项:
- 'fail'(默认值):若表已存在,直接抛出
ValueError异常,中止写入流程。适合只允许首次初始化的严苛场景。 - 'replace':若表已存在,执行
DROP TABLE删除原有整张表及其数据,重新按照当前 DataFrame 结构创建新表并写入。注意:原有表的主键、自增约束、外键和索引将全部丢失! - 'append':若表已存在,保留原表结构,将新数据作为增量行通过
INSERT INTO追加到表末尾。这是 ETL 流水线与定时任务最常用的模式。
四、大数据量写入性能优化:chunksize 与 method='multi'
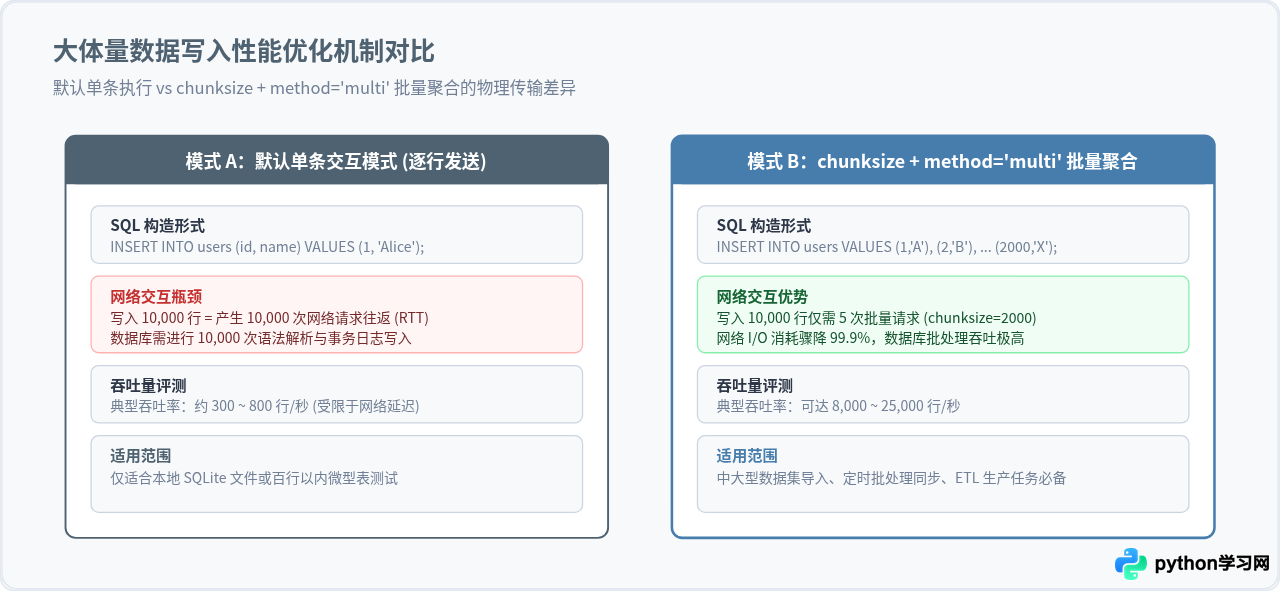
当 DataFrame 包含数十万或数百万行记录时,使用默认参数执行 to_sql 会显著变慢,甚至引发数据库服务端连接超时或客户端内存溢出。这是因为默认情况下,驱动往往采用单条参数化执行(逐条语句交互),导致网络往返延迟(RTT)剧增。
通过组合使用以下两个关键参数,可以将写入耗时降低 5 到 20 倍:
chunksize:设定单次切片批量写入的行数(如chunksize=2000或chunksize=5000)。这能够将大表分批送入数据库缓冲区,避免单次构建超巨大 SQL 导致的内存溢出。method='multi':将单条INSERT INTO tab (c1, c2) VALUES (?, ?)转换为一条多行值的复合插入语句INSERT INTO tab (c1, c2) VALUES (?, ?), (?, ?), ...,大幅削减数据库引擎与客户端间的网络通信包总数。
高性能写入实装代码示例:
# 高效批量写入十万行数据
large_df.to_sql(
    name='orders',
    con=engine,
    if_exists='append',
    index=False,
    chunksize=2000,       # 每次提交 2000 行切片
    method='multi'        # 生成多值 INSERT 语句
)
五、数据类型精确控制:dtype 显式映射
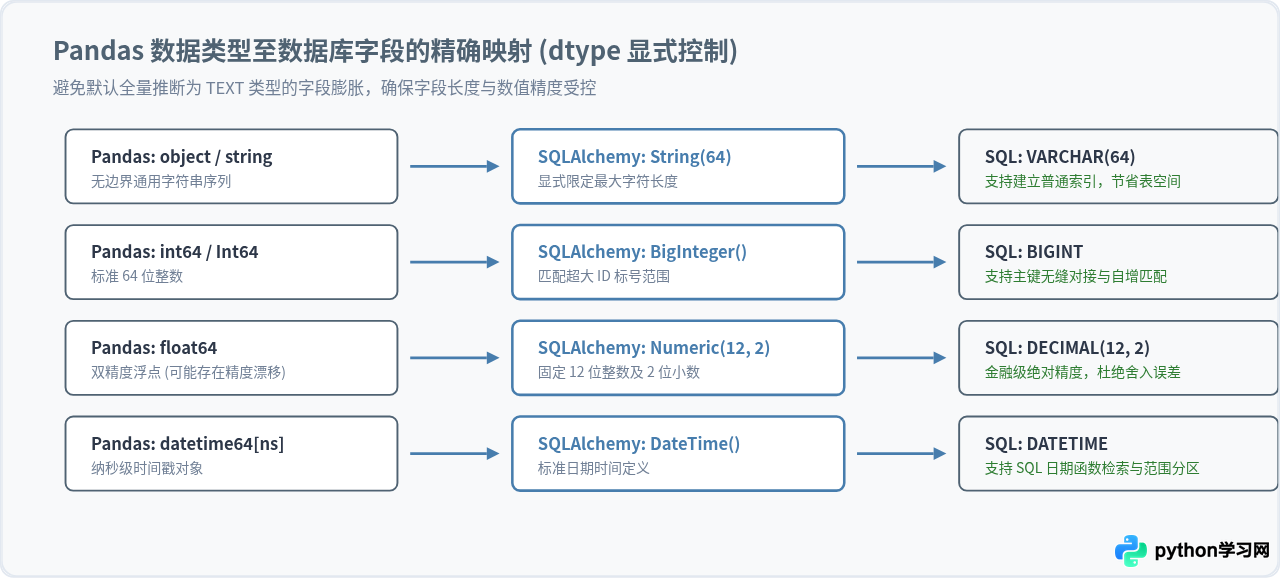
在自动建表场景中,Pandas 默认的数据类型推断可能不符合数据库设计规范。例如,Pandas 的 object 列通常会被映射为数据库中的 TEXT 或 CLOB 类型。在大数据量场景下,缺乏长度限制的 TEXT 列不仅占用多余存储,还会导致无法直接在 MySQL 中创建普通单列索引。
通过向 dtype 参数传入一个字典(键为列名,值为 SQLAlchemy 数据类型类),可以精准指定每一列的数据库物理存储类型:
from sqlalchemy.types import Integer, String, Numeric, DateTime

# 显式定义各列的数据库物理类型
dtype_mapping = {
    'user_id': Integer(),
    'username': String(50),           # 限制长度为 50,对应 VARCHAR(50)
    'balance': Numeric(10, 2),        # 定点数,保留两位小数
    'created_at': DateTime()          # 日期时间类型
}

df.to_sql(
    name='user_account',
    con=engine,
    if_exists='replace',
    index=False,
    dtype=dtype_mapping
)
六、结果验证与常见陷阱排查
1. 写入结果校验
完成写入后,建议通过 pd.read_sql 或 SQLAlchemy 原生连接执行快速验证,确认行数与数据内容符合预期:
from sqlalchemy import text

# 方法一:使用 Pandas 读取验证
read_df = pd.read_sql('SELECT * FROM user_account LIMIT 5', con=engine)
print(read_df)

# 方法二:通过连接上下文验证总写入条数
with engine.connect() as conn:
    count_result = conn.execute(text('SELECT COUNT(*) FROM user_account')).scalar()
    print(f"数据库表中当前总行数: {count_result}")
2. 高频易错点与处理方案
| 异常场景 / 报错表现 | 产生原因 | 推荐解决方案 |
|---|---|---|
ValueError: Table 'xxx' already exists |
默认 if_exists='fail',遇到已存在的表时触发防御性报错。 |
根据业务诉求显式指定 if_exists='append'(追加)或 'replace'(重建)。 |
数据库表中额外多出一列 index |
未显式配置 index=False,Pandas 默认将 DataFrame 索引当作普通列写入。 |
在 to_sql 中显式声明 index=False。 |
| 写入几十万行时程序长时间假死卡住 | 默认逐条执行单行 SQL,网络通信往返成为严重瓶颈。 | 补充 chunksize=2000, method='multi' 参数开启批量聚合写入。 |
字符串字段被自动创建为 TEXT 导致无法加索引 |
未传递 dtype 参数,Pandas object 类型默认推断为 TEXT。 |
引入 from sqlalchemy.types import String 并在 dtype 字典中指定具体长度。 |
数据库密码中包含 @ 或 : 导致连接串解析失败 |
特殊字符干扰了 URI 的协议解析逻辑。 | 使用 urllib.parse.quote_plus 对特殊字符密码进行 URL 编码。 |
在严谨的工程项目中,不推荐依赖 to_sql 自动根据 DataFrame 推断结构建表。最佳实践是由 DBA 或迁移脚本(如 Alembic)事先通过标准 SQL DDL 显式创建好包含主键、非空约束、自增序列、外键及优化索引的目标数据表;Python 数据脚本仅通过 if_exists='append' 配合 chunksize 执行纯粹的数据增量插入。这样既保障了底层架构的严密性与索引完备,又获得了极致的数据写入效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















