


Python怎么利用集合实现O(1)复杂度的快速数据匹配
详细讲解在Python中如何利用集合(set)的哈希表底层特性,将数据匹配和查询的时间复杂度由O(N)降低至O(1),包含核心原理、实战代码、集合运算推导及避坑指南。
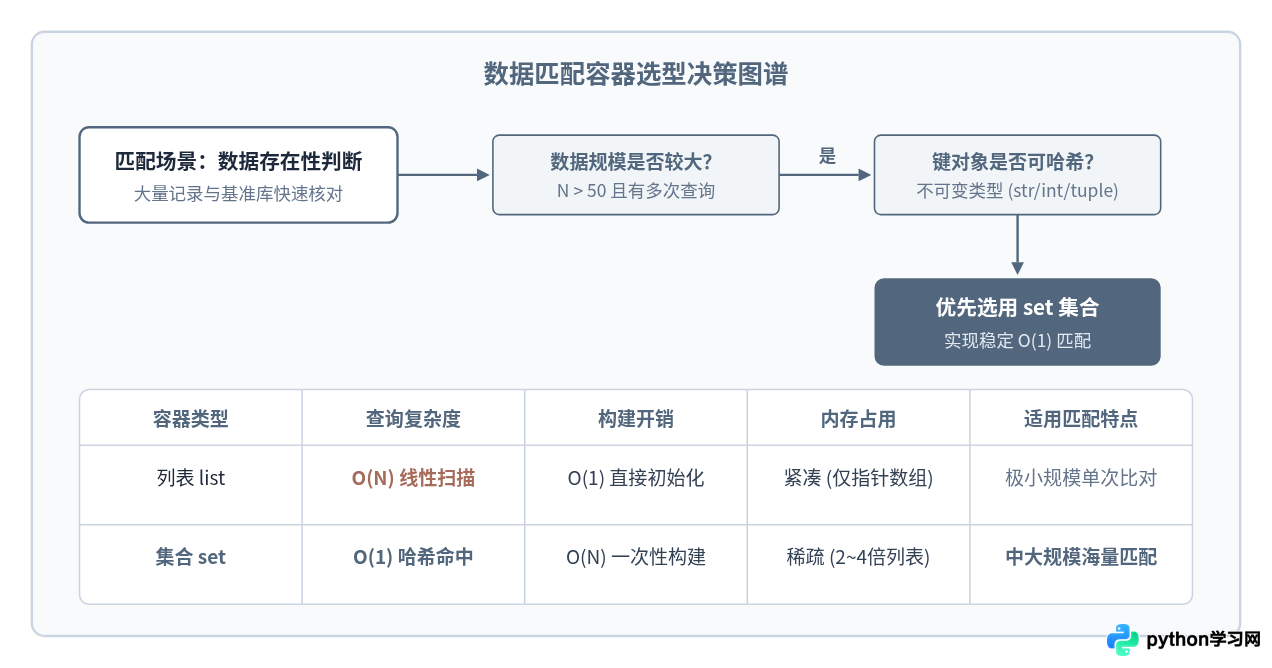
在日常数据清洗、接口数据对齐或业务黑白名单校验中,许多开发者习惯直接使用 target in my_list 来判断某条记录是否存在。当待核对的数据只有几十条时,这种写法非常轻快;但一旦数据规模增加到几万甚至几百万级别,整个程序的执行耗时就会呈几何级暴增。解决这个性能瓶颈最直接且标准的方法,就是将查询容器由列表(list)转为集合(set),利用底层哈希表的直接寻址能力,将每次匹配的时间复杂度由平均 O(N) 降低至 O(1)。
一、底层机制:线性扫描与哈希寻址的差异
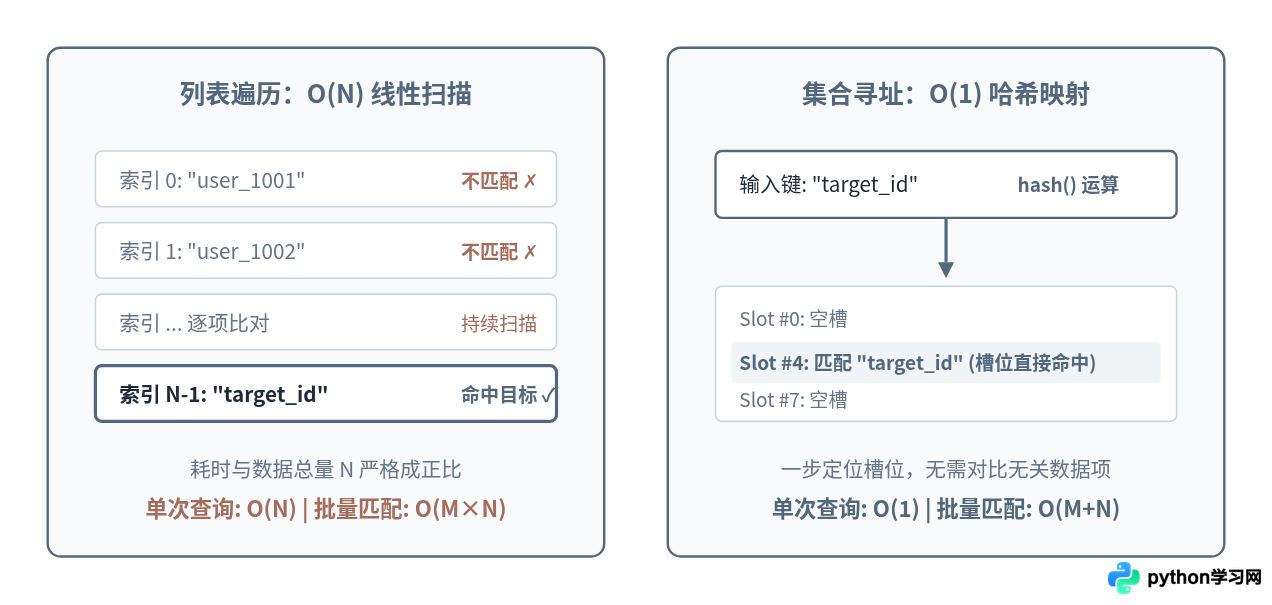
Python 中的列表属于动态顺序数组,底层连续存储着指向各个对象的引用指针。当执行 item in my_list 时,解释器只能从头到尾逐个比对元素,直到找到目标或遍历结束。如果列表中有 N 个元素,平均查找需要比较 N/2 次,最坏情况下则需要比对 N 次,时间复杂度严格呈现为 O(N)。如果要拿包含 M 个元素的另一组数据在列表中匹配,总时间消耗便攀升至 O(M × N)。
集合(set)则是基于哈希表(Hash Table)实现的离散容器。向集合插入或检索元素时,Python 会先调用内置的 hash() 函数计算元素的哈希值,再通过哈希掩码直接映射到内部散列表的一个确定槽位(Bucket)。检查某个元素是否存在时,解释器只需对该元素计算一次哈希值并查看对应槽位即可,几乎不需要遍历其他不相干的项。因此,集合的单次查询平均时间复杂度是稳定的 O(1),即便集合内容扩充到数千万条,查询时间也基本保持恒定。
二、实操指南:利用集合构建高效匹配流程
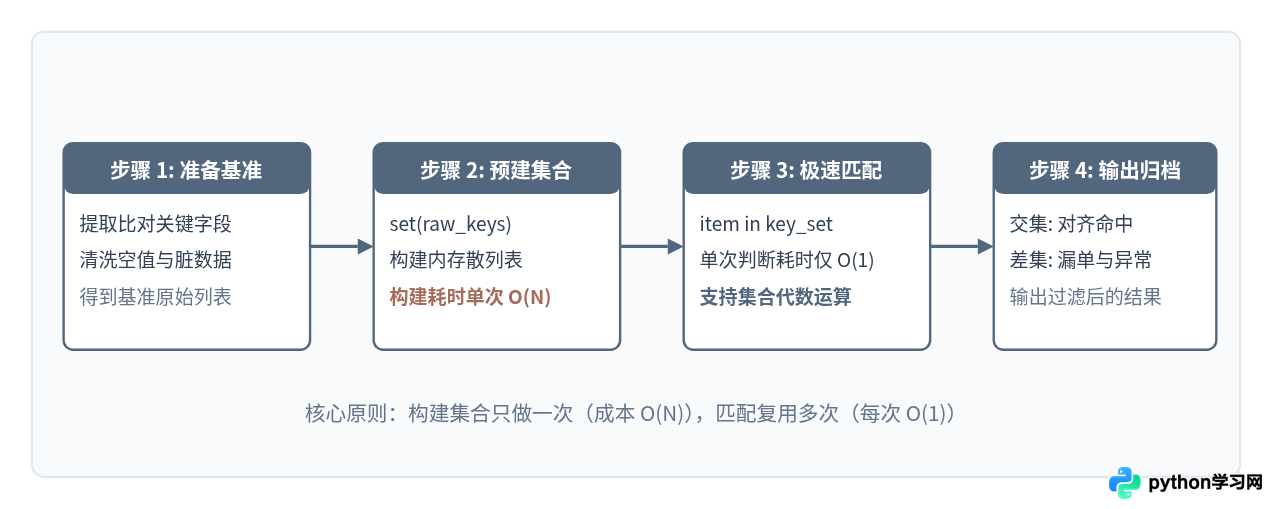
在工程实践中,完成一次高效的数据匹配通常包含四个明确步骤:提取匹配基准、一次性构建集合、批量映射匹配、输出对齐结果。
场景 1:黑名单/敏感词快速过滤
假设我们有一批待处理的交易日志,需要快速剔除命中黑名单的商户账号:
# 示例代码:黑名单匹配与过滤
def filter_transactions(raw_logs, blacklist):
    # 关键步骤:在循环外预先将列表转为集合,构建哈希表仅耗时 O(N)
    blacklist_set = set(blacklist)

    # 每次查询为 O(1),M 条日志的整体过滤耗时仅为 O(M)
    valid_logs = [log for log in raw_logs if log["merchant_id"] not in blacklist_set]
    return valid_logs

# 示例数据验证
logs = [
    {"trans_id": "T01", "merchant_id": "M_101", "amount": 200},
    {"trans_id": "T02", "merchant_id": "M_999", "amount": 50},
    {"trans_id": "T03", "merchant_id": "M_102", "amount": 120},
]
blacklist_merchants = ["M_999", "M_888", "M_777"]

clean_logs = filter_transactions(logs, blacklist_merchants)
# 示例输出:[{'trans_id': 'T01', 'merchant_id': 'M_101', 'amount': 200}, {'trans_id': 'T03', 'merchant_id': 'M_102', 'amount': 120}]避坑提示:千万不要在列表推导式内部写 if log["merchant_id"] not in set(blacklist)。如果在循环内部每次都调用 set(),每次迭代都会重新创建哈希表,导致不仅没有享受 O(1) 查询,反而额外增加了内存分配与散列计算开销。
三、进阶匹配:集合代数在多源数据核对中的应用
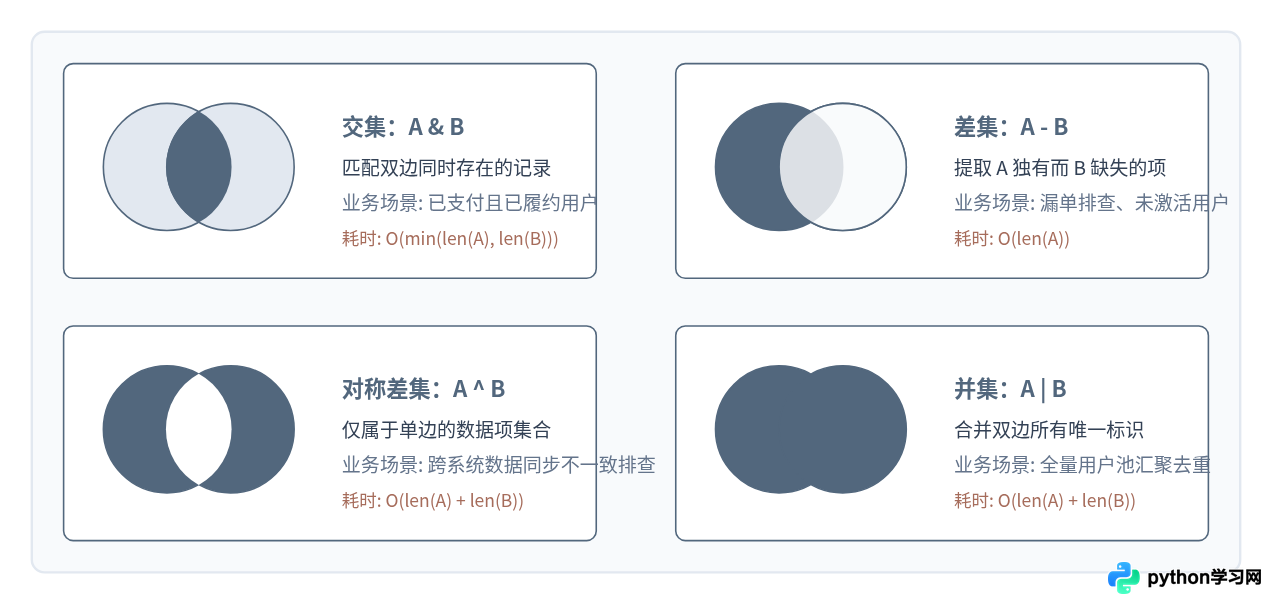
除了单纯的 in 关键字判定,Python 集合还提供了原生的代数运算操作符。这些操作符完全在底层 C 语言级别实现,省去了在 Python 层编写显式循环的解释器开销,是处理多源数据交叉对账最优雅且最高效的手段。
场景 2:双系统数据自动对账示例
在订单对账中,我们需要迅速找出“两边都存在且正常”的订单、“系统 A 有但系统 B 缺失”的漏单,以及“两端不一致”的异常单:
# 双系统订单核对
system_a_orders = {"ORD_001", "ORD_002", "ORD_003", "ORD_005"}
system_b_orders = {"ORD_002", "ORD_003", "ORD_004", "ORD_006"}

# 1. 共同拥有的订单(匹配成功)
matched = system_a_orders & system_b_orders
# 输出: {'ORD_002', 'ORD_003'}

# 2. 系统 A 有,但系统 B 缺失(疑似丢失同步)
missing_in_b = system_a_orders - system_b_orders
# 输出: {'ORD_001', 'ORD_005'}

# 3. 双端存在单边差异的全部异常订单
discrepancy = system_a_orders ^ system_b_orders
# 输出: {'ORD_001', 'ORD_004', 'ORD_005', 'ORD_006'}
四、适用边界与关键注意事项
集合虽然将匹配耗时压缩到了理论极限,但在实际使用中仍有明确的边界和代价,需要根据业务特征进行合理权衡:
- 元素必须是可哈希(Hashable)对象:集合要求内部元素具备固定的哈希值且不可变。常见的不可变对象如
int、str、tuple、frozenset均可作为集合元素;但如果尝试把可变对象(如list、dict、普通的set)存入集合,会立即触发TypeError: unhashable type: 'list'。若需要以多字段组合作为匹配键,应将其打包为元组(例如(user_id, order_date))。 - 空间换时间的代价:为了避免哈希冲突并维持 O(1) 的检索性能,Python 集合内部维护着较为稀疏的散列表结构(通常在装载因子达到 2/3 时自动扩容)。因此,存储同样数量的元素,集合占用的内存通常是列表的 2 到 4 倍。如果数据量极为庞大且内存资源紧张,需综合考虑服务器内存余量。
- 集合不保留元素顺序:集合的主要职责是判断“存在性”与“无序去重”。如果业务对输出序列有严格的先后顺序要求(例如按照时间轴排序),直接使用集合匹配会打乱原有顺序。若既要保留首次出现顺序又要做 O(1) 匹配,可以使用 Python 3.7+ 字典的
dict.fromkeys(keys)来兼顾保序与去重。
总结
利用 Python 集合实现快速数据匹配的核心逻辑是“一次哈希构建,多次极速命中”。在面对包含多次查找或大规模数据集对账的任务时,只要基准键对象不可变,就应当在循环外预先通过 set() 建立哈希索引,或者直接使用集合代数运算符(&、-、^)代替嵌套循环。这样不仅能将代码行数精简到极致,更能将算法执行效率提升几个数量级,让数据匹配任务真正达到 O(1) 的理想性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















