


Python EasyOCR离线环境部署与多语言文字识别教程
详细讲解在无外网隔离环境下部署Python EasyOCR的完整流程,涵盖依赖打包、模型权重固化、多语言识别配置及常见故障排查。
easyocr.Reader 时显式配置 model_storage_directory 并声明 download_enabled=False。本文将按实际落地步骤,完整说明从离线资源筹备、本地目录部署到多语言文字识别代码调用的全流程。
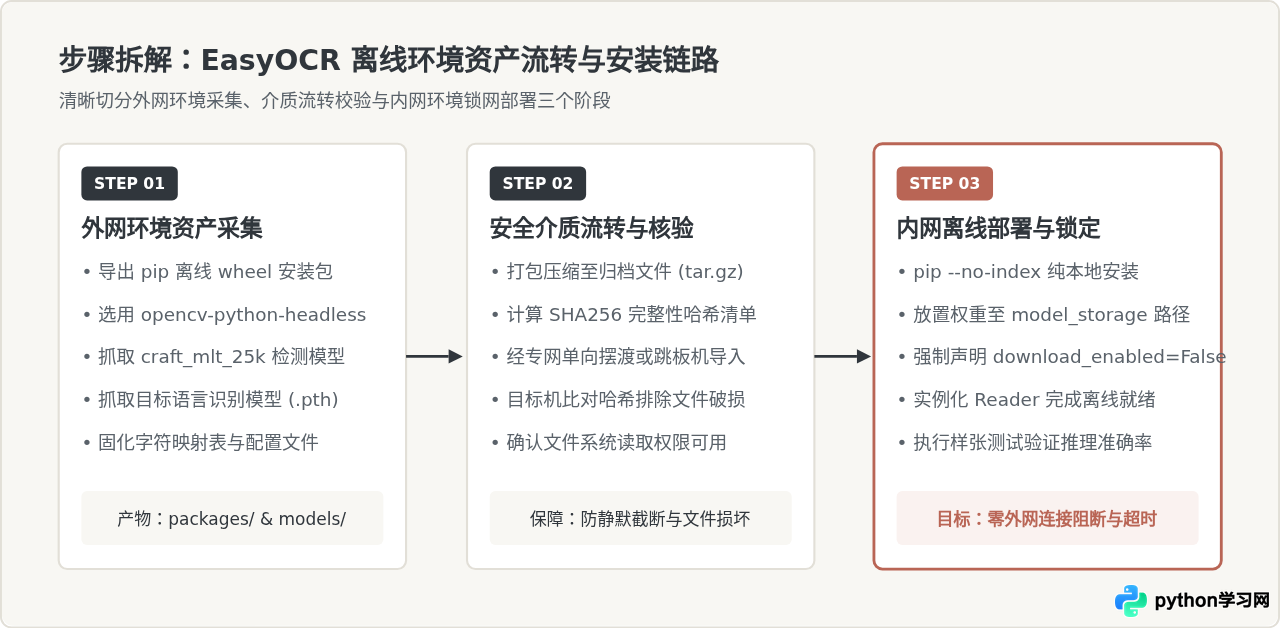
一、离线部署准备:依赖与模型权重归集
离线部署必须提前在具备外网环境的开发机上完成资产下载与归档。EasyOCR 的底层依赖包括 PyTorch、Torchvision、OpenCV 以及 SciPy 等科学计算库。对于生产 Linux 服务器,推荐使用 opencv-python-headless 代替标准版 OpenCV,以避免因为容器或精简系统缺失 X11/OpenGL 相关动态链接库而报错。
1. 依赖轮子包(Wheel)导出
在同构操作系统与相同 Python 版本的联网机器上执行以下命令,将全部依赖包下载至指定文件夹:
# 导出 Wheel 依赖至 packages 目录
pip download easyocr opencv-python-headless -d ./easyocr_packages
2. 官方模型权重下载
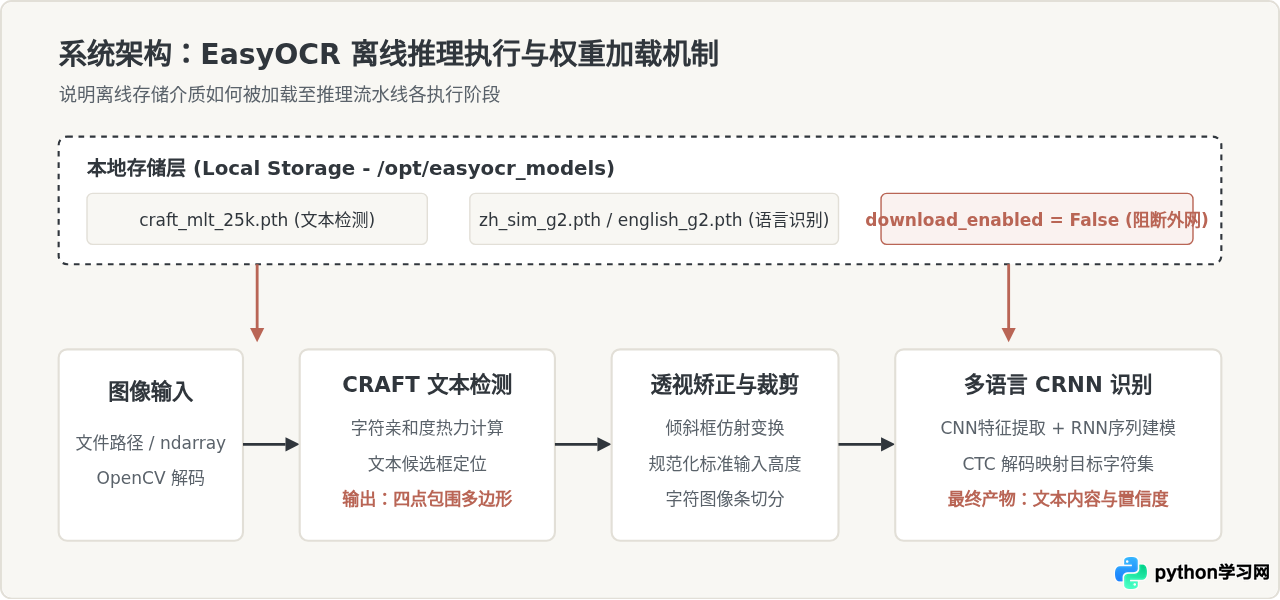
EasyOCR 将任务解耦为“文字区域检测”与“文字内容识别”两个独立模型。离线运行时必须人工下载对应的 .pth 权重文件:
- 文本检测模型:
craft_mlt_25k.pth(所有语种必须依赖该模型定位字符区域)。 - 简体中文识别模型:
chinese_sim.pth(或第二代模型zh_sim_g2.pth)。 - 通用英文识别模型:
english_g2.pth。 - 其他扩展语种:例如日语
japanese_g2.pth、韩语korean_g2.pth、繁体中文chinese_cht.pth等。
二、内网环境离线安装与权重目录配置
将上述依赖与模型拷贝至目标内网机器后,即可执行实际配置。
1. 离线安装 Python 依赖库
进入拷贝后的 easyocr_packages 目录,执行禁止联网检索的离线安装指令:
# 使用 --no-index 参数断开在线索引,强制使用本地包
pip install --no-index --find-links=./easyocr_packages easyocr opencv-python-headless
2. 建立本地模型仓库路径
EasyOCR 默认会在当前登录用户的主目录寻找权重文件,路径为 ~/.EasyOCR/model/。若未指定其他路径,可直接创建该目录并将下载的 .pth 文件拷贝进去:
# 创建默认存放路径
mkdir -p ~/.EasyOCR/model

# 将离线权重放入目录
cp craft_mlt_25k.pth ~/.EasyOCR/model/
cp zh_sim_g2.pth ~/.EasyOCR/model/
cp english_g2.pth ~/.EasyOCR/model/
在多用户共享服务器或基于 Docker 容器化的工程架构中,硬编码用户家目录不利于维护。更稳妥的做法是在应用服务目录(如 /opt/easyocr_models)集中存储权重,并在初始化 Reader 对象时通过 model_storage_directory 参数显式指定。
三、多语言文字识别实操与代码编写
完成离线部署后,通过 Python 脚本调用 EasyOCR。在离线环境下,必须确保两个关键参数生效:
download_enabled=False:完全禁用内部下载重试,若权重丢失立即暴露文件缺失错误,避免陷入数分钟的外网网络超时挂起。model_storage_directory:准确指向已存放.pth文件的目录。
1. 多语言参数组合规则
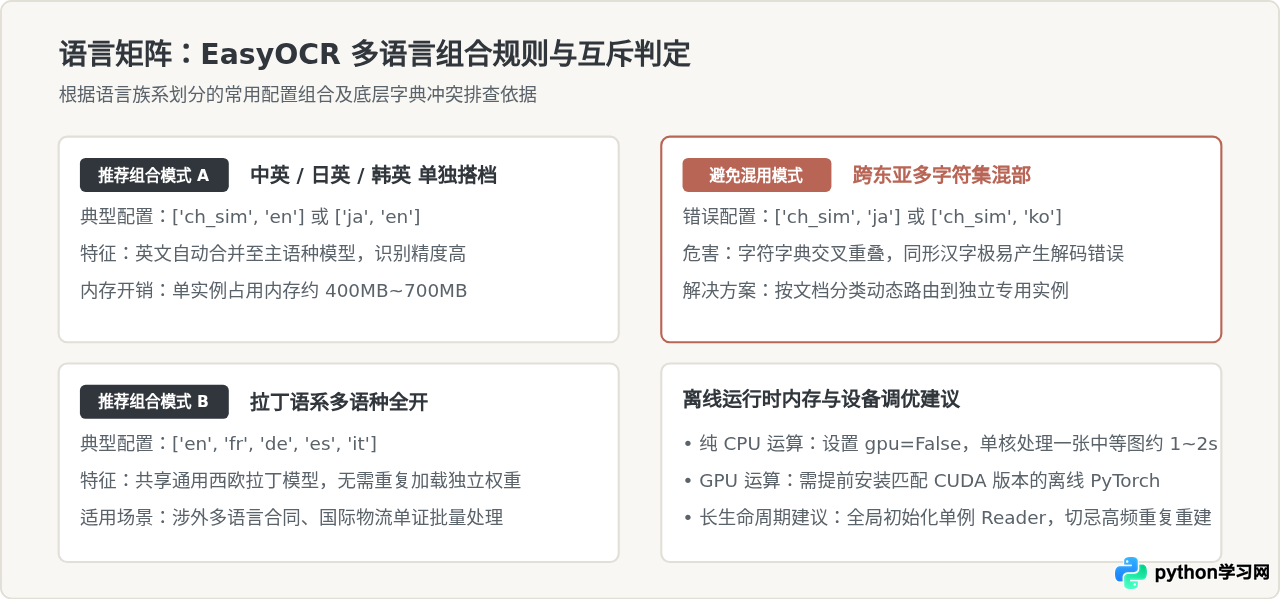
EasyOCR 支持数十种语言,但在传入 lang_list 时存在兼容性约定:
- 中英文组合:推荐配置
['ch_sim', 'en'],英文作为通用辅助语言可与中、日、韩等主流东亚语言并存。 - 拉丁语系组合:如英语、法语、德语、西班牙语(
['en', 'fr', 'de', 'es']),它们共享一套底层拉丁字母字典,可以自由组合使用。 - 跨东亚语言互斥性:由于中文简体、繁体、日语汉字与韩文谚文包含重叠且存在差异字形的编码映射,通常不建议在同一个 Reader 实例中混入多种东亚语言(例如同时传入
['ch_sim', 'ja', 'ko'])。若遇到多语种混合业务,最佳实践是初始化针对性的专用 Reader 实例,通过文档类型路由分别解析。
2. 完整识别代码示例
编写离线文字识别脚本,演示从初始化到提取文本及置信度的标准实现:
import os
import easyocr

# 1. 显式配置离线模型所在路径
MODEL_DIR = "/opt/easyocr_models"

# 2. 初始化 Reader 实例
# gpu=False 适用于无显卡的纯 CPU 宿主机
# download_enabled=False 严格禁止发起外网拉取
reader = easyocr.Reader(
    lang_list=['ch_sim', 'en'],
    gpu=False,
    model_storage_directory=MODEL_DIR,
    download_enabled=False
)

# 3. 执行单张图像识别
image_path = "sample_invoice.jpg"
if not os.path.exists(image_path):
    raise FileNotFoundError(f"待识别图像不存在: {image_path}")

# readtext 返回结构化列表,每一项由 (多边形坐标, 文本内容, 置信度) 组成
results = reader.readtext(image_path, detail=1)

# 4. 解析与格式化输出
print(f"=== 识别结果提取 (共检测到 {len(results)} 行文本) ===")
for bbox, text, score in results:
    # 过滤掉置信度低于 0.3 的噪点结果
    if score >= 0.3:
        print(f"置信度: {score:.2f} | 文本: {text}")
=== 识别结果提取 (共检测到 3 行文本) ===
置信度: 0.98 | 文本: 增值税专用发票
置信度: 0.95 | 文本: 购买方名称: 某某信息科技股份有限公司
置信度: 0.91 | 文本: 合计金额: ¥128,500.00
四、常见问题排查与避坑指南
在离线部署落地中,大部分问题并非由模型自身缺陷引起,而是源于缺少系统依赖或参数未彻底锁闭。
| 报错现象 / 异常表现 | 根本原因 | 彻底解决办法 |
|---|---|---|
urllib.error.URLError: <urlopen error ...> |
程序启动时触发了在线下载检查,外网不通导致挂起或超时 | 在初始化 Reader 时明确声明 download_enabled=False,并确保模型已正确放置在目标路径 |
ImportError: libGL.so.1: cannot open shared object file |
安装了完整版 opencv-python,其依赖宿主机的图形库文件 |
卸载 opencv-python,重新安装 opencv-python-headless |
FileNotFoundError: Missing model file ... |
模型权重文件名与 EasyOCR 内置名称不完全匹配,或目录指定有误 | 核对模型文件名。例如中文第二代模型应为 zh_sim_g2.pth 或 chinese_sim.pth,不可随意更名 |
| 识别大分辨率图像时内存溢出 (OOM) | 高分辨率图像导致 CRAFT 特征图过大,耗尽物理内存 | 在 readtext 中传入参数 canvas_size=1280 或预先使用 Pillow/OpenCV 对图片做等比缩放 |
五、总结
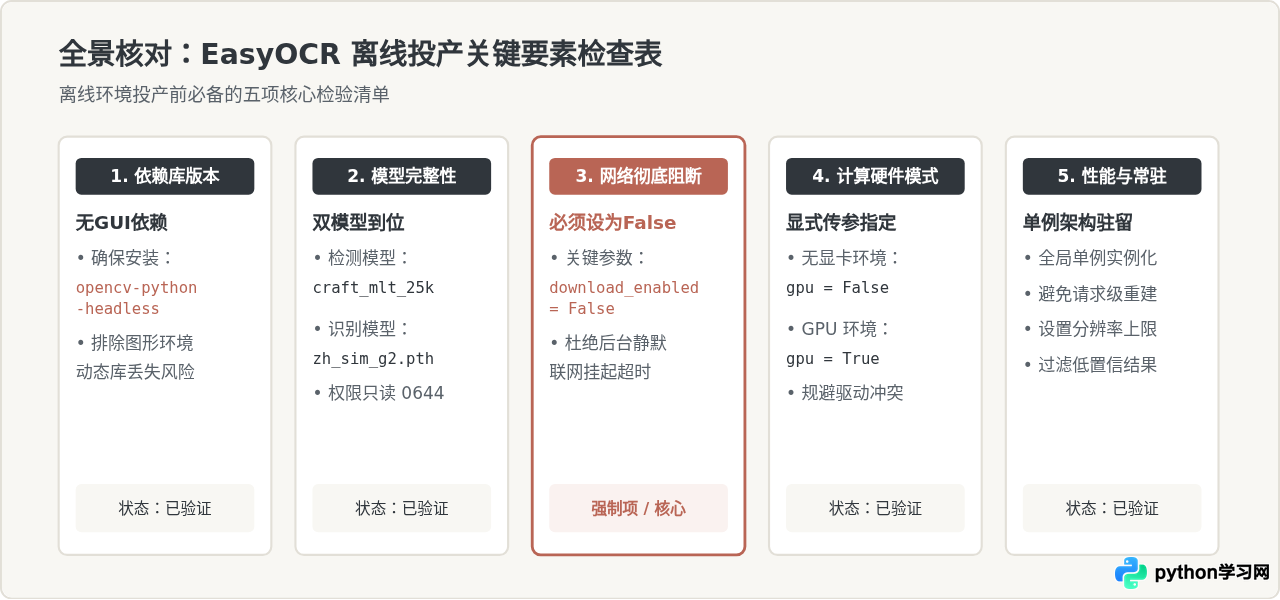
在隔离网络下稳定运行 EasyOCR,本质上是把原本由框架在线自动处理的“依赖打包”与“权重发现”两项任务接管为静态配置。只要确保安装的是 opencv-python-headless、模型权重完整落盘至指定存储路径,并在初始化代码中严格声明 download_enabled=False,就能够彻底避免联网尝试导致的超时异常,实现安全、高效、稳定的多语言离线文字识别。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















