


优化Python执行JS代码的性能:缓存上下文与引擎选择
深入解析在Python中执行JavaScript代码的核心性能瓶颈。从进程间通信与冷启动开销切入,详细对比QuickJS、V8等嵌入式引擎的选型依据,并提供预编译与上下文缓存落地的完整实现与避坑指南。
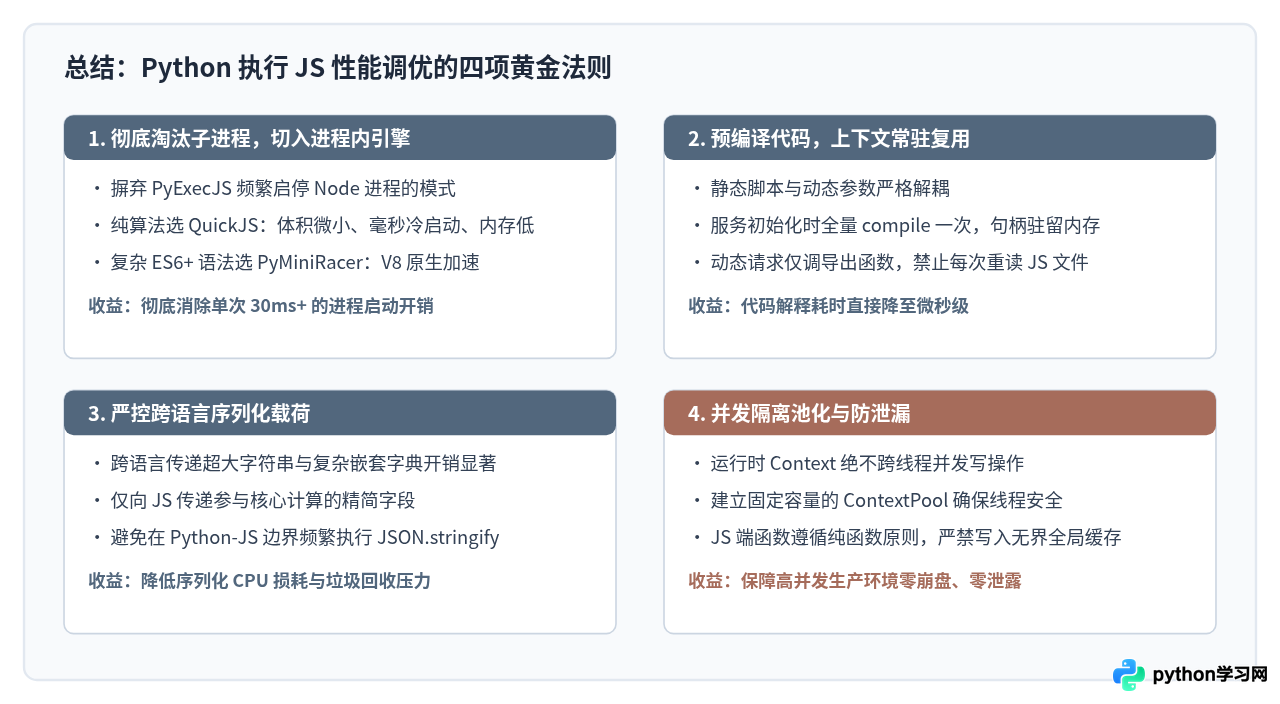
PyExecJS,但一旦调用频次上升到每秒数十次或数百次,就会遭遇吞吐量断崖式下滑。要彻底解决这一性能瓶颈,核心在于两项关键改造:用轻量进程内嵌入引擎替代外部子进程启动,以及在内存中持久化缓存已初始化的执行上下文以避免重复解析。
一、执行JS成为性能黑洞的根源分析
不少开发者在本地单元测试时发现执行一次 JS 函数只需几十毫秒,感觉完全能够接受。然而当部署到高并发抓取或批量处理管道中时,整个系统的 CPU 利用率会迅速飙升至 100%,延迟增加数倍。这种性能恶化通常并非源于 JavaScript 本身的代码执行速度,而是跨语言交互层面的系统资源损耗。
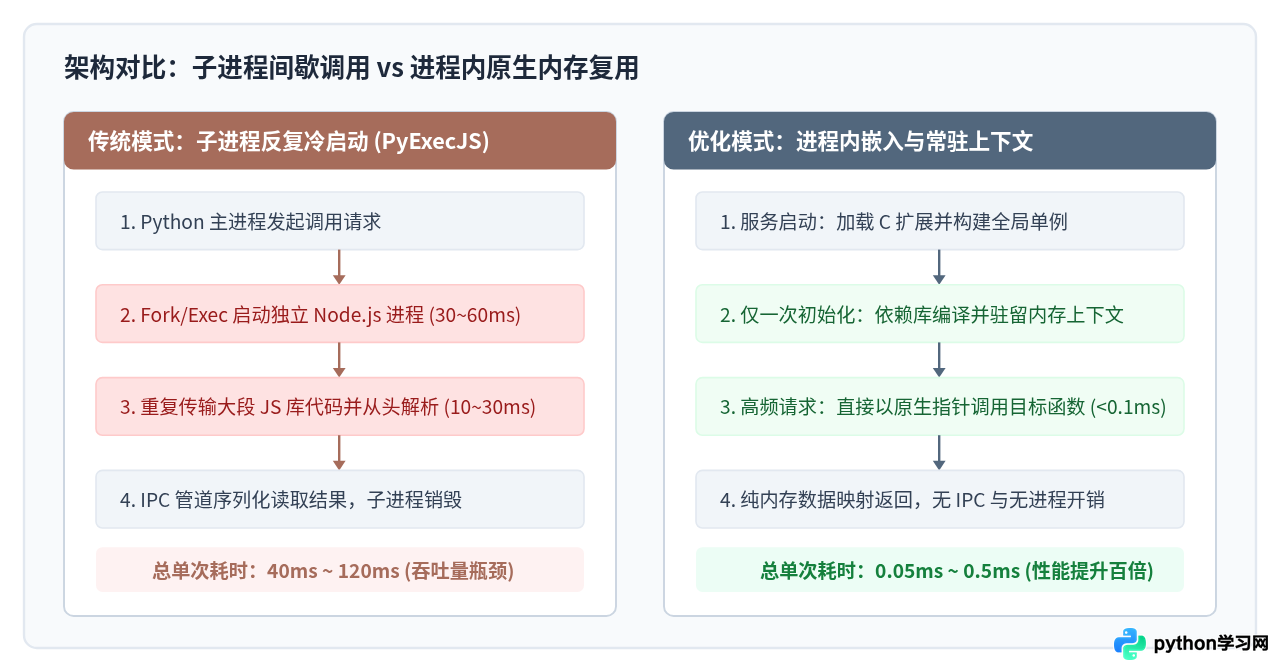
以广泛使用的 PyExecJS 为例,其底层默认的工作模式是封装 subprocess.Popen。每当你调用一次 compile() 或 eval(),系统都会完整经历以下开销链条:
- 进程创建与销毁:操作系统需要为 Node.js 分配独立的进程空间、加载基础 C++ 运行时以及初始化 V8 堆栈,单次进程启动耗时就高达 25ms 至 60ms。
- 全量脚本磁盘写入与冷编译:若依赖外部 JS 库(如 CryptoJS 或自定义混淆脚本),整个几百 KB 的代码会被重新写入临时管道并由 Node 引擎从零执行语法解析(Parse)与 AST 构建。
- 标准 IPC 序列化阻塞:通过标准输入/输出流(stdin/stdout)进行数据传递,必须经过多重字符串格式化与 JSON 编解码。
二、主流 JS 引擎选型:找到最契合的运行时
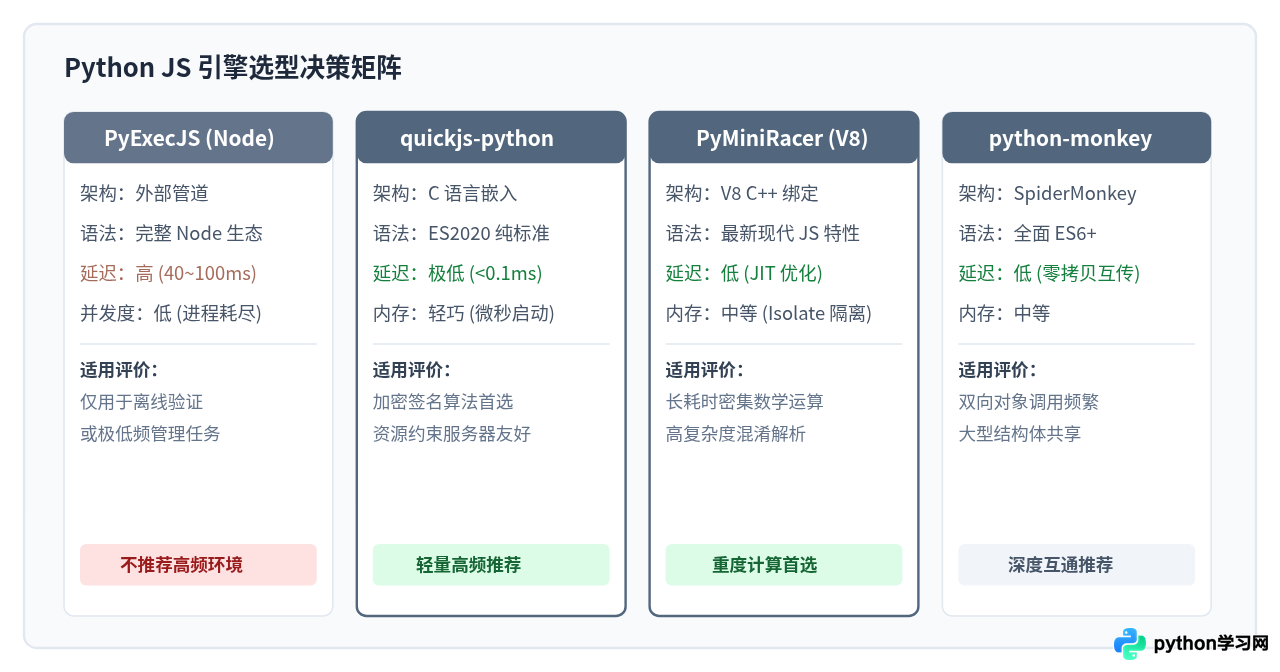
脱离业务诉求谈引擎选型是不现实的。在 Python 生态中,目前可用的主要执行方案各有取舍:
| 引擎方案 | 底层核心 | 集成机制 | 单次调用延迟 | 内存常驻占用 | 典型适用场景 |
|---|---|---|---|---|---|
| PyExecJS | Node.js / JScript | Subprocess 管道 | 40 ~ 120ms | 极高(按进程) | 仅适合开发阶段验证,严禁用于线上高频服务 |
| quickjs-python | Fabrice Bellard QuickJS | C 原生嵌入 | 0.02 ~ 0.1ms | 极低(几 MB) | 混淆逆向解密、轻量加密算法、无现代 DOM 依赖 |
| PyMiniRacer | Google V8 | C++ 原生共享库 | 0.1 ~ 0.5ms | 中等(数十 MB) | 现代 ES6+ 语法、大型复杂框架、需极致 JIT 计算速度 |
| python-monkey | Mozilla SpiderMonkey | Rust/C++ 深度桥接 | 0.1 ~ 0.4ms | 中等 | Python 与 JS 复杂数据类型零拷贝、双向深度互操作 |
三、缓存上下文:性能调优的关键核心
即便更换为基于 C/C++ 绑定的嵌入式引擎,若每次调用仍重复调用 eval(full_code),性能依然会打很大折扣。因为解释器每遇到一次长代码,都必须走一遍 Lexer 词法切分与 AST 构建。
核心调优思路:把基础依赖库代码与高频业务调用完全解耦。在服务初始化阶段将公共函数编译进全局上下文(Context)并常驻内存;当实际请求到达时,仅执行精简的函数调用并传入动态参数。
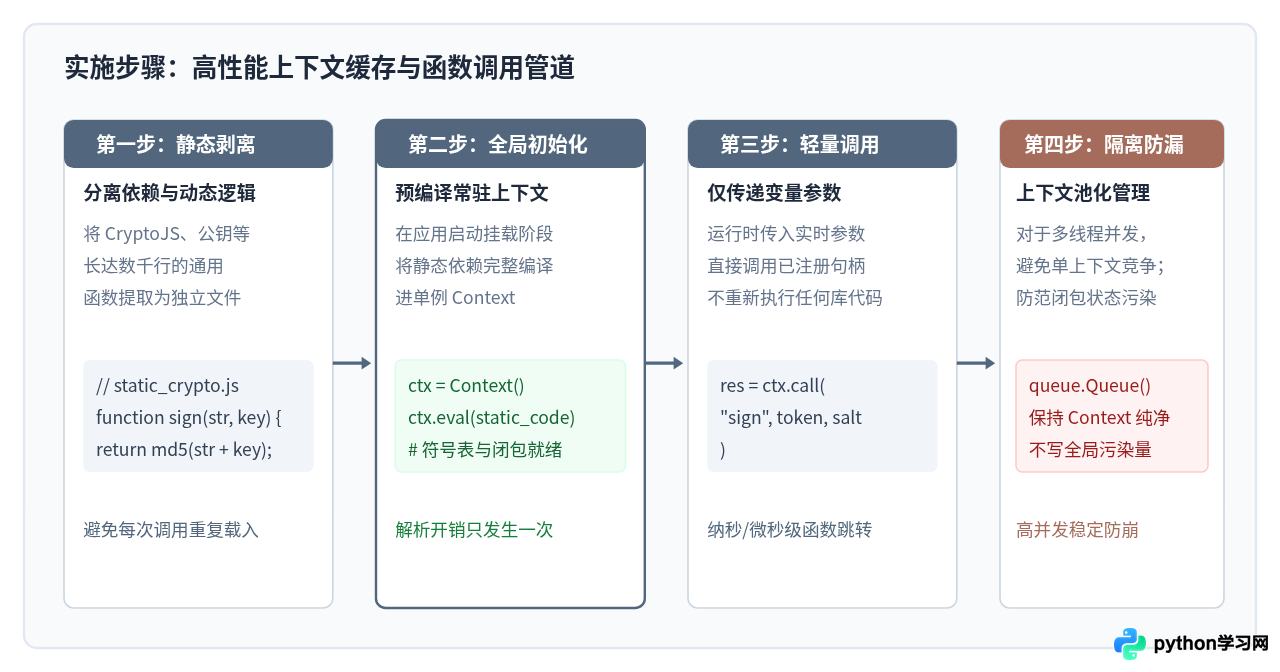
实战对比:从低效写法到高性能 Context 缓存
我们以最常见的逆向签名解密场景为例,对比两种写法的性能差距。
低效做法(频繁重复编译):
# 反模式:每次循环都重新解析几千行 JS
import quickjs

def sign_data_bad(raw_str, token):
    # 每次调用都必须重新构建整个 JS 虚拟机堆栈并解析完整脚本
    with open("complex_encrypt.js", "r", encoding="utf-8") as f:
        js_code = f.read()

    ctx = quickjs.Context()
    ctx.eval(js_code)
    # 动态拼接字符串容易引起注入与逃逸风险,且速度较慢
    return ctx.eval(f'generateSign("{raw_str}", "{token}")')
高效做法(单例上下文预热与调用):
# 推荐模式:模块级别编译一次,高频循环只调导出函数
import quickjs

class JSSignEngine:
    _instance = None

    def __init__(self, script_path="complex_encrypt.js"):
        self.context = quickjs.Context()
        with open(script_path, "r", encoding="utf-8") as f:
            script_content = f.read()
        # 静态库预解析与函数注册(仅耗时一次)
        self.context.eval(script_content)
        # 获取目标函数的原生绑定对象
        self._sign_func = self.context.get("generateSign")

    @classmethod
    def get_instance(cls):
        if cls._instance is None:
            cls._instance = cls()
        return cls._instance

    def sign(self, raw_str: str, token: str) -> str:
        # 直接通过 C-API 传入原生 Python 参数,零额外解析耗时
        return self._sign_func(raw_str, token)

# 使用示例
engine = JSSignEngine.get_instance()
# 单次耗时从 40ms 直接压降到 0.04ms
signature = engine.sign("order_id_10029", "auth_token_xyz")
window.cache = {}),并且在每次执行签名时向其追加条目,常驻上下文的内存占用会随请求量单调递增。因此,必须确保常驻上下文中运行的 JS 函数是无副作用的纯函数(Pure Function)。
四、并发与多线程环境下的隔离治理
当 Python 应用基于 threading、concurrent.futures 或 ASGI(如 FastAPI)运行时,直接跨线程共享同一个执行上下文通常是不安全的。大部分 JS 运行时引擎(包括 QuickJS 与 V8 的 Isolate)其底层上下文并非线程安全(Thread-Safe),如果两个线程同时在一个 Context 内执行字节码,会导致解释器内部栈指针混乱甚至引发段错误(Segmentation Fault)。
为了解决并发与复用的平衡,推荐采用上下文对象池(Context Pool)架构:
import queue
import contextlib
import quickjs

class ContextPool:
    def __init__(self, script_content: str, max_workers: int = 8):
        self._pool = queue.Queue(maxsize=max_workers)
        for _ in range(max_workers):
            ctx = quickjs.Context()
            ctx.eval(script_content)
            self._pool.put(ctx)

    @contextlib.contextmanager
    def acquire(self):
        ctx = self._pool.get()
        try:
            yield ctx
        finally:
            self._pool.put(ctx)

# 在多线程任务中借出与归还
pool = ContextPool(script_content, max_workers=16)

def worker_task(param):
    with pool.acquire() as ctx:
        func = ctx.get("generateSign")
        return func(param, "fixed_salt")
五、结语
Python 调用 JS 场景下的性能优化并不神秘,核心在于看清每一毫秒消耗的具体归属。从弃用多进程管道机制转向 C/C++ 嵌入运行时,再到以“单例或池化”策略管理预编译上下文,这套组合拳能将原本需要几十毫秒的跨语言调用彻底压降至亚毫秒级别。在实际工程落地时,优先使用 QuickJS 解决纯算法签名,遇到重度现代语法或复杂计算时切换到 V8,并始终保持上下文的纯净与复用,即可在 Python 生态中获得稳定且极致的执行性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















