


Python数据校验库选型:Pydantic、Marshmallow与Cerberus对比
深入对比 Python 主流数据校验库 Pydantic、Marshmallow 与 Cerberus 的架构设计、核心机制、性能表现、序列化能力及适用场景,提供系统化的技术选型决策指南与落地建议。
在 Python Web 接口开发、批处理作业和数据交换场景中,不可信输入数据的边界校验是保障系统稳健运行的核心环节。面对格式各异的外部 JSON、表单或配置字典,开发团队通常需要在 Pydantic、Marshmallow 与 Cerberus 这三个成熟库之间做出抉择。这三者并非单纯的替代关系,而是分别代表了类型提示优先、声明式双向序列化以及纯字典驱动三种截然不同的设计哲学。本文将围绕架构机理、API 范式、执行性能、复杂规则处理与框架生态五个维度展开系统对比,并给出清晰的选型路径。
三者核心机制与架构哲学
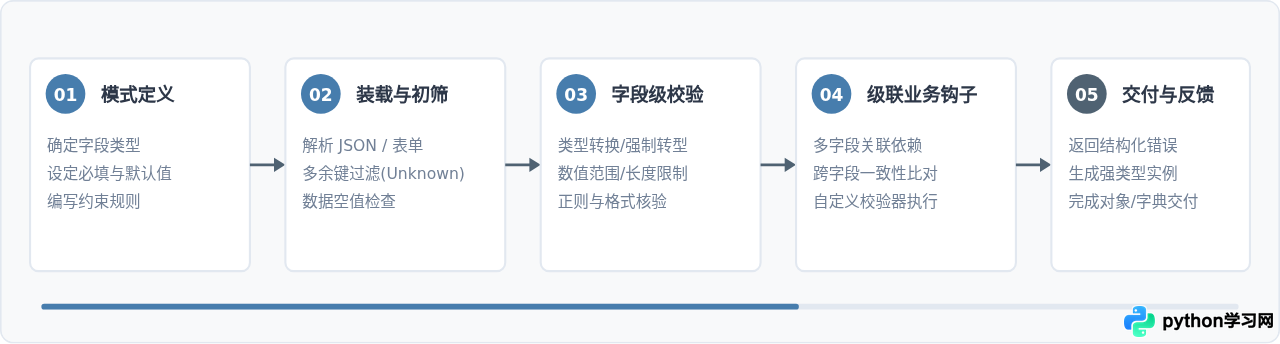
Pydantic 的核心在于将 Python 3.7+ 的原生类型注解(Type Hints)转化为运行时的数据解析与校验逻辑。在 Pydantic v2 中,底层解析引擎完全由 Rust 重写(pydantic-core),其设计目标是将杂乱的输入数据强行清洗、规范化并转换为强类型的结构体对象实例。Pydantic 主张“解析而非仅仅验证”(Parse, don't validate),在验证成功后,开发者直接操作的是具备属性提示和 IDE 补全的 Python 类实例。
Marshmallow 则是经典的对象序列化与反序列化框架。它独立于 Python 静态类型系统,采用类似于 Django/WTForms 表单的声明式 Schema 类。Marshmallow 的双向能力非常平衡:通过 load() 方法完成数据反序列化与校验,通过 dump() 方法将复杂的 ORM 实体、类对象过滤并序列化为标准字典或 JSON 结构。它的设计重心是业务数据与外部呈现格式之间的解耦和双向映射。
Cerberus 遵循极端极简的 Unix 哲学。它没有庞大的类型体系或类包装机制,完全使用原生 Python 字典(Dict-based Schema)定义校验规则。Cerberus 不主动去生成新的强类型实体类,而是专注于“检查字典输入是否符合规则”,并输出一个布尔判定和结构化错误字典。由于规则本身就是 Python 原生字典,它与 YAML、JSON 等配置文件天然亲和,非常适合动态加载与插件化规则注入。
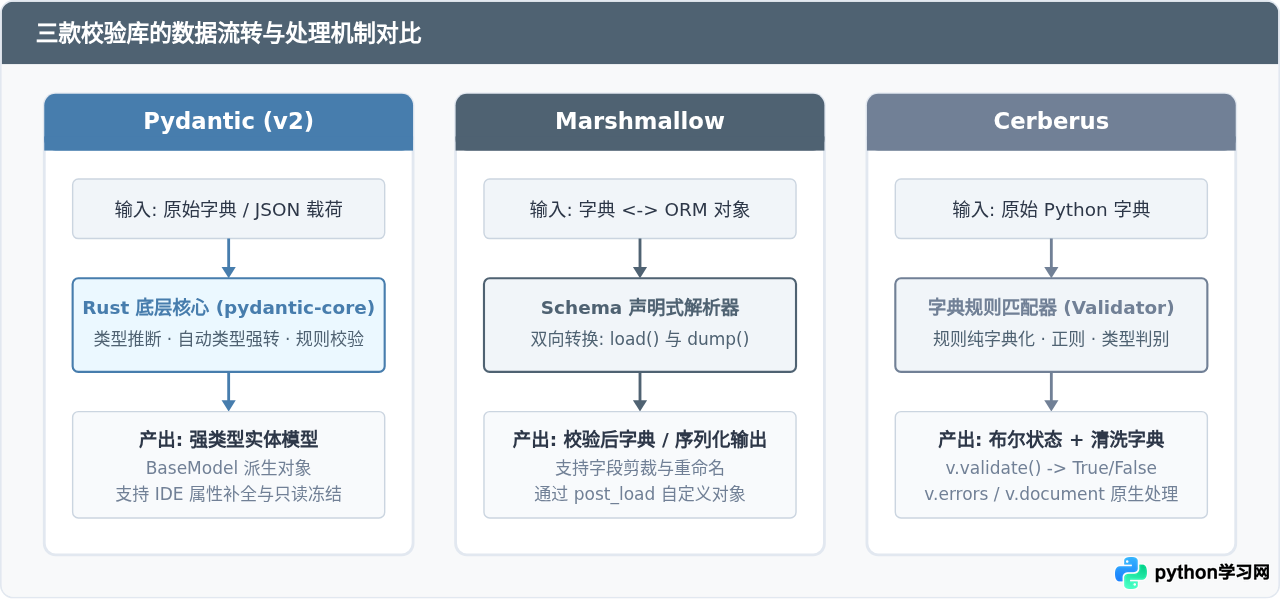
校验逻辑的执行全流程
为了让校验过程可观测、可调试,任何成熟的数据校验流水线都涵盖五个关键步骤:模式定义、数据装载、字段级规则执行、级联与业务钩子、错误聚合与实体交付。理解这五个步骤在不同框架中的落实方式,是技术选型的关键。
代码范式与具体实现对比
为了直观展现三者的 API 风格差异,下面以一个通用的“用户注册信息校验”场景为例进行演示。业务要求:用户名 username 为 3-20 位的字符串;年龄 age 必须在 18 至 120 岁之间;email 必须符合邮箱格式;允许选填 tags 列表;如果传入非法字段需有明确的报错反馈。
1. Pydantic 风格实现
Pydantic 直接使用 Python 类型标注与 Field 元数据,代码极其精简:
# 环境依赖: pip install pydantic[email]
from typing import List, Optional
from pydantic import BaseModel, Field, EmailStr, ValidationError

class UserRegistration(BaseModel):
    username: str = Field(..., min_length=3, max_length=20, description="用户唯一账号名")
    age: int = Field(..., ge=18, le=120, description="用户年龄")
    email: EmailStr
    tags: List[str] = Field(default_factory=list)

# 校验成功示例
payload = {"username": "alex_chen", "age": "25", "email": "alex@example.com", "tags": ["python", "backend"]}
user = UserRegistration.model_validate(payload)
# 字符串 "25" 会被自动解析为 int: 25
print(user.username, type(user.age), user.age)
# 输出: alex_chen <class 'int'> 25

# 校验失败捕获
try:
    UserRegistration.model_validate({"username": "al", "age": 16, "email": "invalid-mail"})
except ValidationError as exc:
    # 示例输出错误结构
print(exc.errors())注意:Pydantic 默认采用宽松的类型强转模式(例如传入字符串 "25" 会自动转型为整型 25)。若在金融或严苛数据系统中使用,需显式声明严格模式:Field(..., strict=True) 或在配置中开启 model_config = ConfigDict(strict=True)。
2. Marshmallow 风格实现
Marshmallow 采用独立的字段类,不依赖 Python 类型注解,逻辑高度显式化:
# 环境依赖: pip install marshmallow
from marshmallow import Schema, fields, validate, ValidationError

class UserRegistrationSchema(Schema):
    username = fields.Str(required=True, validate=validate.Length(min=3, max=20))
    age = fields.Int(required=True, validate=validate.Range(min=18, max=120))
    email = fields.Email(required=True)
    tags = fields.List(fields.Str(), load_default=list)

schema = UserRegistrationSchema()

# 校验与加载
payload = {"username": "alex_chen", "age": 25, "email": "alex@example.com"}
try:
    clean_data = schema.load(payload)
    print("清洗后的数据字典:", clean_data)
except ValidationError as err:
    # err.messages 会返回精准到字段的字典形式错误
    print("校验失败信息:", err.messages)

# 反向序列化 (Dump)
serialized = schema.dump(clean_data)注意:Marshmallow 默认对 payload 中的未声明字段(Unknown fields)采取丢弃(RAISE/EXCLUDE/INCLUDE)策略。在生产中推荐显式配置 class Meta: unknown = EXCLUDE,避免未知字段引发意料之外的校验中断。
3. Cerberus 风格实现
Cerberus 使用纯字典声明 Schema,无需定义任何类:
# 环境依赖: pip install cerberus
from cerberus import Validator

schema = {
    "username": {
        "type": "string",
        "minlength": 3,
        "maxlength": 20,
        "required": True
    },
    "age": {
        "type": "integer",
        "min": 18,
        "max": 120,
        "required": True,
        "coerce": int  # 支持显示声明类型强转函数
    },
    "email": {
        "type": "string",
        "required": True,
        "regex": r"^[\w\.-]+@[\w\.-]+\.\w+$"
    },
    "tags": {
        "type": "list",
        "schema": {"type": "string"},
        "required": False,
        "default": []
    }
}

v = Validator(schema)
payload = {"username": "alex_chen", "age": "25", "email": "alex@example.com"}

if v.validate(payload):
    # normalized 会应用默认值并完成 coerce 转换
    clean_dict = v.normalized(payload)
    print("通过校验,处理后字典:", clean_dict)
else:
print("校验失败原因:", v.errors)注意:Cerberus 的 v.validate() 仅返回 True 或 False,不会主动抛出异常;获取清洗后的数据需调用 v.normalized(payload),而不是直接读取原输入字典。
选型决策路径与场景分支
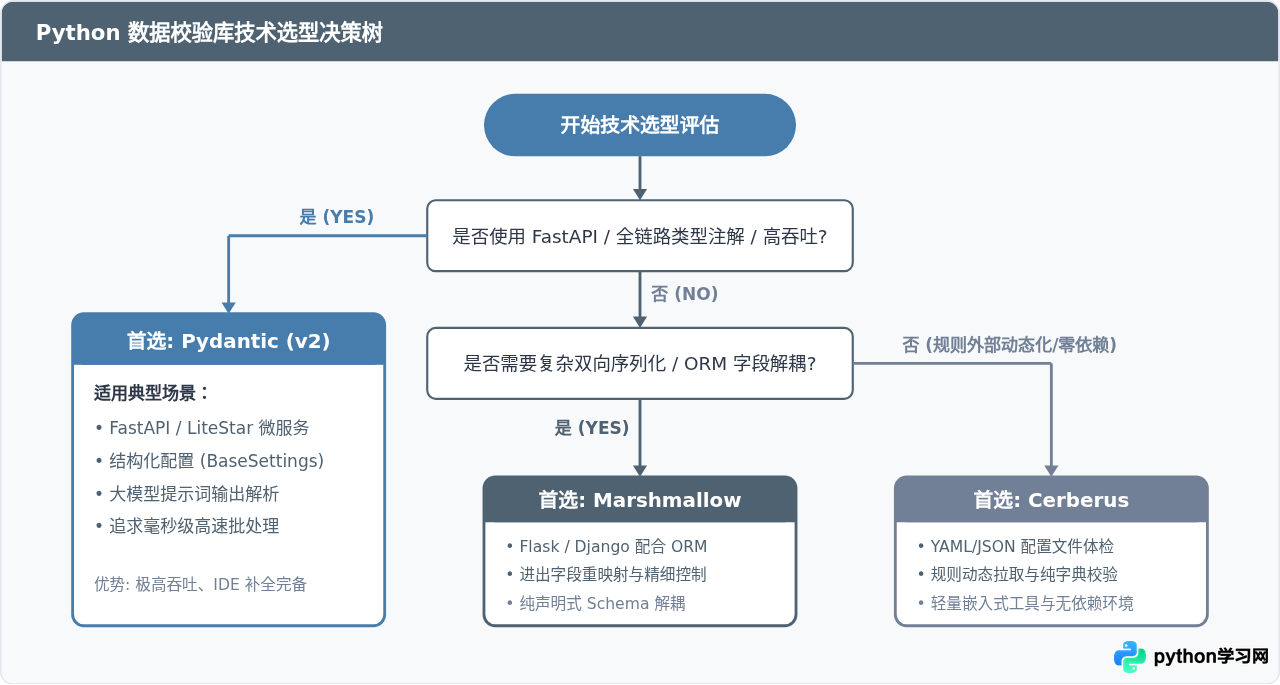
技术选型不应脱离具体的工程上下文。在多数团队中,技术栈底座(如 Web 框架)、QPS 指标、配置动态化诉求是决定校验库选择的三大关键要素。
关键对比维度与特性矩阵
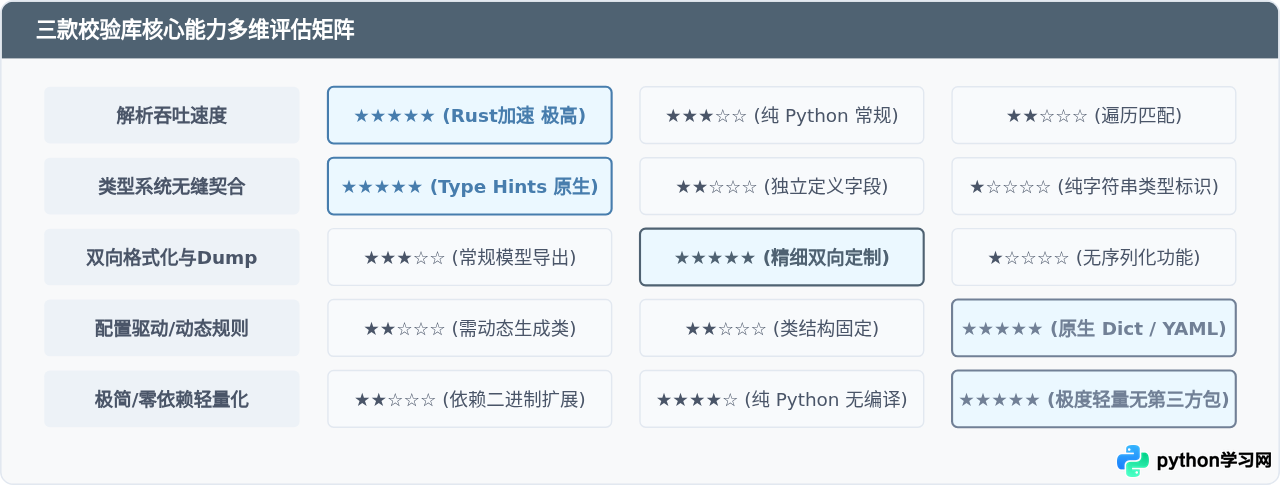
为了全面评估三个库在生产落地中的工程代价,下表和图示总结了它们在解析速度、复杂嵌套、序列化扩展以及学习曲线上的量化表现。
| 评估维度 | Pydantic (v2) | Marshmallow | Cerberus |
|---|---|---|---|
| 核心驱动引擎 | Python 类型注解 + Rust 内核 | 声明式 Schema 继承类 | 纯 Python 字典定义 |
| 校验吞吐性能 | 极高(比纯 Python 库快 5-20 倍) | 中等(纯 Python 运行时解析) | 中等偏低(规则遍历匹配) |
| 序列化 (Dump) 能力 | 支持(通过 model_dump,与类型绑定) | 极强(支持深层嵌套与字段重命名) | 不支持(仅做 dict 规则校验) |
| 外部规则动态加载 | 需调用 create_model 动态元编程 |
较为繁琐,需动态构造 Schema 类 | 天然支持(直接读 YAML/JSON 文件) |
| 外部依赖包 | 包含编译型二进制 (pydantic-core) | 零 C 扩展依赖(纯 Python) | 零外部依赖(纯 Python) |
| 主流生态绑定 | FastAPI, SQLModel, LangChain | Flask (webargs), apispec, Django | 独立运维脚本, 内部配置校验工具 |
生产落地实践与常见避坑点
Pydantic 在默认模式下极具侵略性。例如,声明为 is_active: bool 的字段,输入 "yes"、1、"true" 都会被强转为 True;声明为 count: int,输入浮点数 12.0 会被静默截断为 12。如果业务严禁类型隐式转换,务必显式声明 Field(..., strict=True) 或使用 StrictStr、StrictInt、StrictBool 等严格类型。
Marshmallow 擅长处理多层级异常。在处理具有深度嵌套的 JSON 时,使用 fields.Nested 并配合 many=True 可以一次性返回全部失败项的路径索引。此外,Marshmallow 支持通过 schema.context 传入诸如当前登录用户、数据库 Session 等外部上下文,在自定义 @validates 钩子中直接读取,而无需污染入参 payload。
Cerberus 不支持像 Pydantic 那样直接在字段旁加装饰器,所有自定义校验逻辑必须通过继承 cerberus.Validator 并实现 _validate_<rule_name> 方法完成。例如,实现一个判断偶数的规则:
class CustomValidator(Validator):
    def _validate_is_even(self, is_even, field, value):
        """ {'type': 'boolean'} """
        if is_even and isinstance(value, int) and value % 2 != 0:
            self._error(field, "该数值必须为偶数")

v = CustomValidator({'num': {'type': 'integer', 'is_even': True}})
总结与落地建议
在当下的 Python 现代化工程建设中,Pydantic 无疑处于主流地位。它不仅成为 FastAPI 的事实标准,更是现代化类型注解工程与大模型应用解析(如 Instructor、LangChain Output Parser)的首选方案。对于新立项的后端项目、微服务与高并发 API,Pydantic v2 是绝大多数团队的基准选择。
对于重度使用传统 Flask/Django 架构、需要将复杂的 ORM 实体(如 SQLAlchemy、Django Models)深度定制并序列化为外部格式的项目,Marshmallow 的双向映射与字段级过滤器依然能够带来极高的解耦灵活性。
而对于 CLI 工具开发、低依赖脚本、系统监控配置体检,或校验规则需要从远程数据库、YAML/JSON 配置文件实时加载而无需重新发布代码的轻量化场景,Cerberus 凭借其零依赖与纯字典架构,仍然具备不可替代的轻巧优势。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















