


怎么撰写高命中率的Python开发工程师简历:项目经验与技术亮点提炼
针对Python开发工程师求职场景,深入讲解如何通过STAR法则重构项目经历,从高并发、异步IO、数据库性能调优及分布式架构等维度深度提炼技术亮点,提升简历初筛命中率。
招聘方在筛选 Python 开发工程师简历时,通常在 10 到 15 秒内快速评估候选人的工程深度、技术栈匹配度以及业务解决能力。一份高命中率简历的核心在于两点:将平淡的“业务流水账”重构成结构严密、量化结果明确的项目经验,并从中精准萃取具有技术说服力的亮点。本文围绕这一目标,提供从项目挑选、描述重构、亮点挖掘到终稿自检的可执行方案。
一、筛选核心项目:确立简历的技术主线
很多求职者在准备简历时倾向于把所有经历事无巨细地罗列出来,例如入门阶段写过的简易博客系统、基础网页爬虫以及课程设计作业。这种“大杂烩”式的罗列往往会稀释简历的核心竞争力,导致面试官无法迅速捕捉到求职者的技术上限。
撰写高命中率简历的第一步是“做减法”:整份简历保留 2 到 3 个最具代表性的工业级项目即可。筛选核心项目时,可以参考以下三个基准:
- 业务真实度与复杂度:优先选择承载真实用户请求、具有清晰业务链路与数据流转的系统,避免纯粹跟随教程照搬的基础 Demo。
- 技术挑战与攻坚空间:选择经历过并发压力测试、性能优化、架构迁移或稳定性治理的项目,这类项目更容易提炼出具备说服力的技术论据。
- 个人主导深度:确保所选项目中至少有 60% 以上的核心模块是由自己独立负责设计、编码与调优的,确保面试时经得起连续追问。
二、项目经验重构:基于增强型 STAR 法则
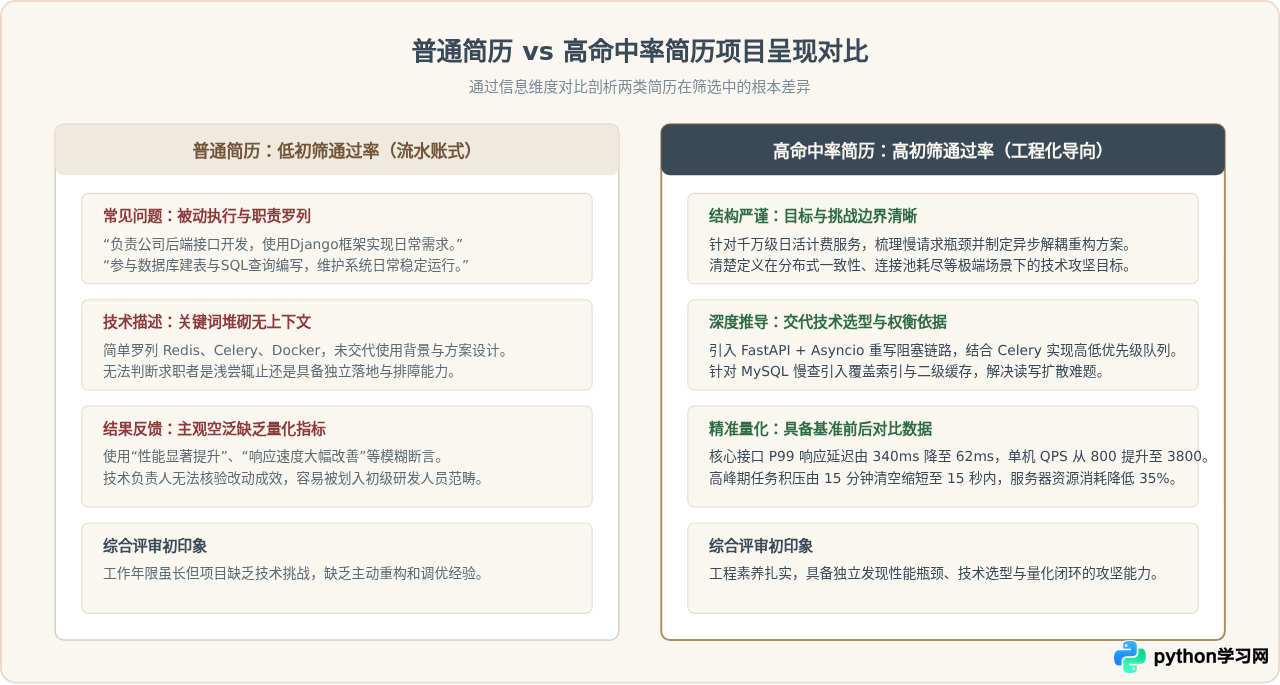
很多简历初筛被拒并非由于求职者技术实力不足,而是因为叙述缺乏逻辑结构,未能向面试官展现其思考与落地过程。推荐采用增强型 STAR 法则对每一个核心项目进行系统化重构:
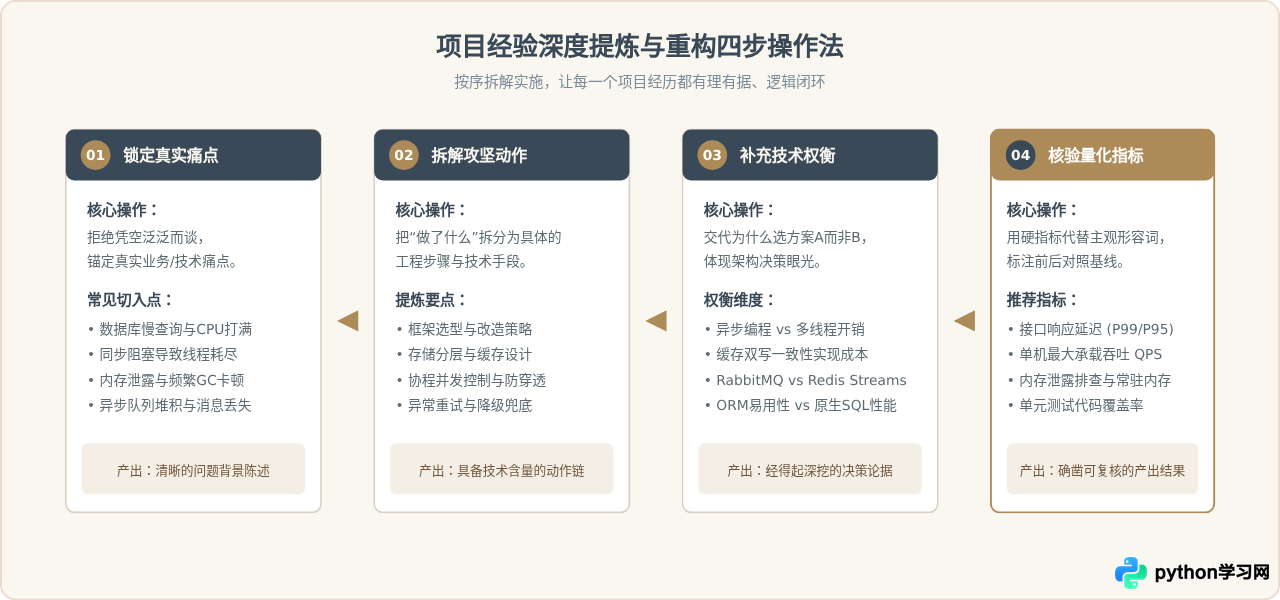
- S(Situation 背景与痛点):说明该项目面临的具体业务场景或原有架构瓶颈。例如“原有架构基于传统同步框架,在促销高峰期遇到数据库连接池被占满、接口超时率激增的问题”。
- T(Task 目标与任务):明确你在此次重构或攻坚中承担的职责指标。例如“主导异步化重构,核心目标是在机器配置不变的前提下将接口吞吐量提升 3 倍,P99 延迟压降到 100ms 以内”。
- A(Action 技术选型与实施动作):详细展开技术选型、架构设计与核心落地点。这是最能体现技术深度的核心段落,必须写明关键库、技术权衡与避坑经验。
- R(Result 量化收益与验证):以具体的基准测试数据或线上监控指标作为结尾,证明技术动作的实际成效。
实例对比:一段项目描述的优化全过程
“负责公司订单结算模块的开发工作。使用 Flask 框架编写订单接口,与前端对接数据。使用 MySQL 存储订单详情,配合 Redis 缓存热点数据。修复日常接口 bug,保证系统平稳运行。”
“针对电商大促期间订单结算服务超时率升高(峰值 QPS 超过 2500 时连接池频繁耗尽)的瓶颈,主导结算链路的性能改造与稳定性重构:
- 架构与并发重构:采用 FastAPI + Asyncio 替代原有同步阻塞接口,利用协程并发处理下游风控、积分扣减等三方外部 HTTP 依赖,规避线程阻塞开销;
- 存储层慢查调优:针对订单复合查询,基于 EXPLAIN 执行计划排查并消除 Extra 中的 Using filesort,建立
(user_id, status, created_at)覆盖索引,慢查比例由 8.7% 压降至 0.2%; - 缓存架构防护:设计基于 Redis 的分布式锁与热点防击穿机制,通过逻辑过期与后台协程异步刷新缓存策略,保障数据库只承受穿透底量;
- 量化产出:单机服务峰值 QPS 从 450 提升至 2800,核心结算接口 P99 响应延迟由 420ms 降至 58ms,系统平稳承载双十一大促全量流量。”
三、Python 核心技术亮点的四大提炼维度
很多开发者在日常工作中完成了大量需求,但面对“技术亮点”时往往觉得无可写之处。实际上,任何生产环境下的 Python 应用都会在并发机制、数据存取、分布式架构及代码工程素养上遇到深度挑战。以下提炼出四大关键维度:
1. 深入剖析并发机制:从单纯调用到原理调优
许多开发者在简历中仅写“掌握多线程与多进程”。面试官极易追问:“GIL 是如何限制多线程的?在什么场景下应该使用线程,什么场景下必须使用进程或协程?”如果简历能直接体现出对底层机制的理解与应用,则能显著增加初筛权重。
推荐提炼方式:“针对批量数据抓取与解析任务,分析得出解析过程存在大量正则计算(CPU 密集)而网络请求属于典型 IO 密集。因此架构上采用 asyncio + aiohttp 维持千级并发网络连接,配合 multiprocessing.Pool 分配独立进程进行并行清洗,规避 CPython 解释器 GIL 锁竞争,整体执行耗时缩短 72%。”
2. 深度挖掘数据存储层:拒绝无脑 CRUD
绝大多数 Web 系统性能瓶颈最终都落在数据库与缓存上。写出高命中率项目的关键,在于展现你具备诊断和解决数据热点、大事务、慢查及分布式一致性的工程实操经验。
推荐提炼方式:“排查生产环境订单表(单表行数达 1800 万)分页慢查询瓶颈。分析发现 LIMIT 100000, 20 触发大量回表操作,重构为基于主键延迟关联的覆盖索引查询;同时针对 ORM 默认的惰性加载引发的 N+1 问题,强制采用联表预加载机制,将全表扫描查询耗时由 2.4s 压缩至 35ms。”
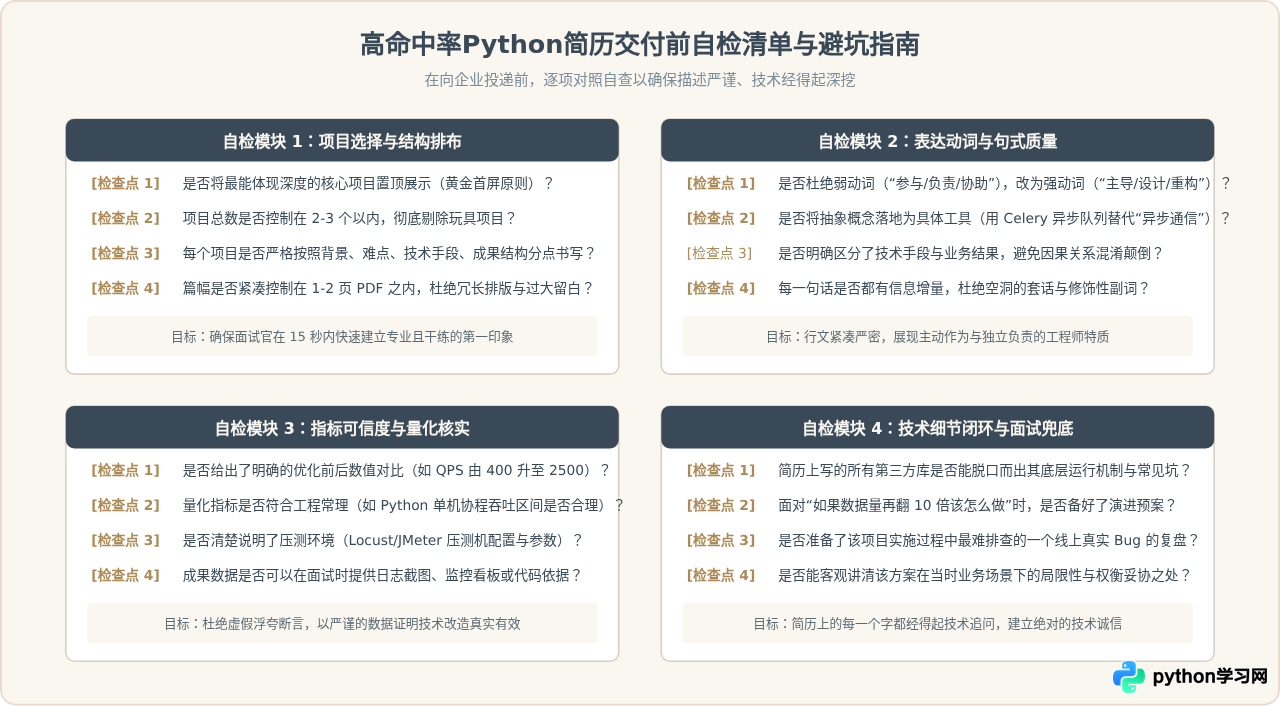
四、简历撰写的三大常见误区与避坑指南
在优化简历的过程中,不少求职者容易从一个极端走向另一个极端。为了确保简历既具备技术高度又具备真实可信度,需要格外防范以下三个常见误区:
- 误区一:堆砌热门技术名词但与业务脱节。例如在简历中写满 Kubernetes、Flink、Spark、Kafka,但实际项目中这些中间件全部由运维或大数据团队托管,求职者只调用了一个推送接口。一旦面试官深入追问参数配置、高可用策略或源码细节,往往立即破功。
- 误区二:缺少对照基线,指标不可信。直接写“并发性能提升数倍”或者“吞吐量极大增加”。高命中率的描述必须包含基准前后对照(Baseline vs Optimized),明确注明是在什么机器规格(例如 4 核 8G 单机测试环境)下的何种指标变化。
- 误区三:项目缺少个人独立思考与权衡。只交代“按照领导要求使用方案 X 完成开发”。在技术面试中,面试官更看重候选人为什么选择该方案,是否对比过替代方案,以及实施该方案付出的代价与后续兜底措施。
五、写在最后:从简历准备到技术面试的统一
简历并不是求职者单方面罗列历史功绩的记账簿,而是一份针对招聘技术负责人的“技术解决方案提案”。优秀的 Python 工程师不仅在于能写出可以跑通的代码,更在于清楚代码在不同规模数据与请求压力下的边界、瓶颈与代价。
撰写高命中率简历的过程,本质上是对过往项目技术深度的一次深度技术复盘。当求职者能够以严密的 STAR 逻辑,清晰阐释异步并发机制的演进、存储层索引与缓存的精密防护,以及可度量的工程收益时,不仅初筛命中率会大幅提高,也为后续的技术现场面试打下了最坚实的基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















