


Python错误处理与日志记录完整代码:集成try-except与logging模块
深入解析如何在Python中集成try-except异常捕获与logging标准库模块,提供包含控制台输出、文件切片轮转、完整堆栈追踪以及资源安全回收的生产级完整代码与架构图解。
print() 打印错误或使用裸 except: 吞噬异常,则会彻底丢失排查问题所必需的调用堆栈、精确时间与上下文环境。将语言底层的 try-except-else-finally 异常捕获机制与标准库 logging 模块有机结合,是构建健壮、可维护系统的标准范式。本文直接提供一套包含控制台彩色呈现、日志文件轮转持久化、堆栈追踪记录及资源安全清理的完整工程代码与架构说明。
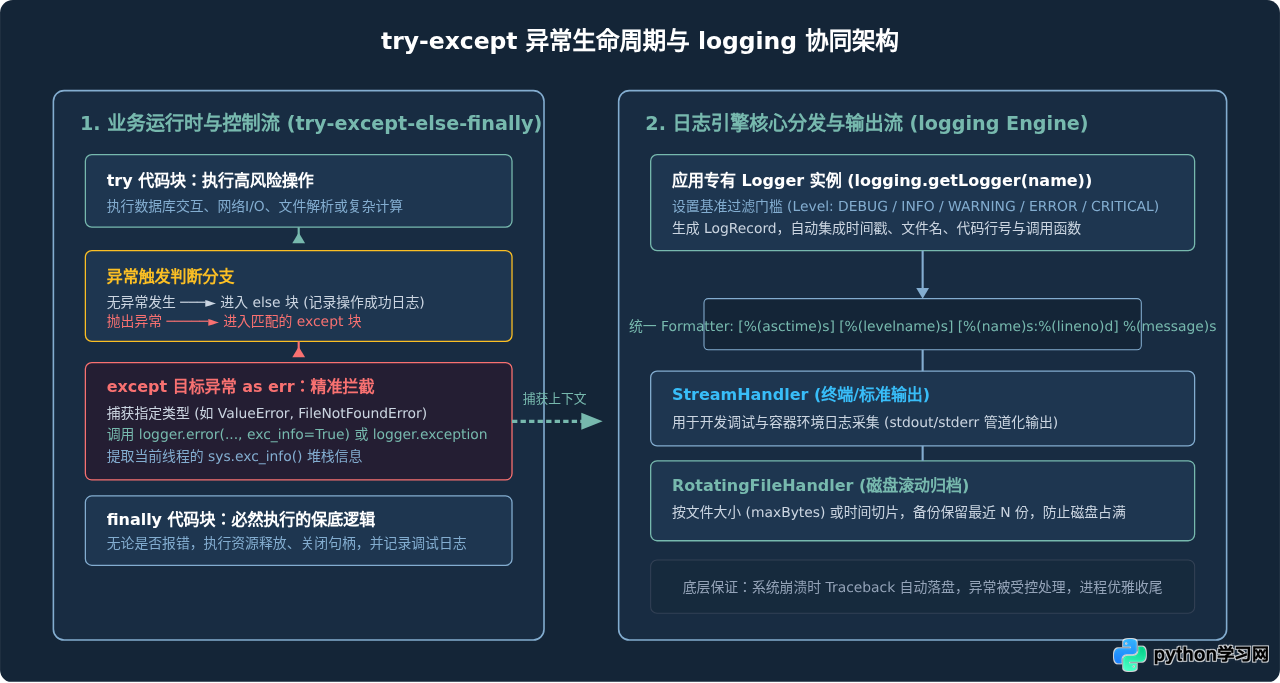
一、try-except 与 logging 的协同架构与运行机制
很多初学者在调试代码时习惯依赖 print(e) 查看报错信息。但在生产环境或长期后台运行的任务中,标准输出通常无法自动留存,也无法区分开发调试信息、业务警告与致命崩溃。更严重的是,直接打印异常实例对象 e 仅能得到一行简短的错误描述,具体的报错文件、函数调用关系和代码行号完全丢失。
Python 提供的 try-except 负责拦截与控制流程跳转,而 logging 模块则负责多渠道分发、格式化格式规范与堆栈溯源。二者结合时,try 块负责执行可能产生风险的业务逻辑;except 块负责精准捕获预期异常,并调用 logger.error("...", exc_info=True) 或 logger.exception("...") 将包含完整调用栈(Traceback)的结构化日志同时写入终端与按文件大小自动切分的日志文件中。
二、生产级完整集成代码实现
以下是可直接独立运行的完整代码。代码中构建了一个专用的日志管理器,配置了同时输出到终端与滚动文件的双处理通道,并通过真实的文件解析与数值计算场景,演示了 try-except-else-finally 与 logging 的标准集成模式。
import os
import sys
import logging
from logging.handlers import RotatingFileHandler
from typing import Optional, Dict, Any

def get_configured_logger(
    name: str = "production_app",
    log_dir: str = "logs",
    log_filename: str = "app.log",
    level: int = logging.DEBUG
) -> logging.Logger:
    """
    创建并配置一个具备控制台输出与自动文件轮转的专用 Logger。
    避免对 root logger 进行直接修改,防止第三方模块日志被动污染。
    """
    logger = logging.getLogger(name)
    logger.setLevel(level)

    # 防止在多次导入或调用时重复添加 Handler 导致日志重复打印
    if logger.handlers:
        return logger

    # 确保日志存储目录存在
    os.makedirs(log_dir, exist_ok=True)
    log_filepath = os.path.join(log_dir, log_filename)

    # 1. 定义统一的日志格式(时间、级别、Logger名、文件名、行号、具体信息)
    formatter = logging.Formatter(
        fmt="[%(asctime)s] [%(levelname)-7s] [%(name)s:%(filename)s:%(lineno)d] %(message)s",
        datefmt="%Y-%m-%d %H:%M:%S"
    )

    # 2. 控制台 Handler:输出到标准错误/终端,便于即时观测
    console_handler = logging.StreamHandler(sys.stdout)
    console_handler.setLevel(logging.INFO)
    console_handler.setFormatter(formatter)
    logger.addHandler(console_handler)

    # 3. 磁盘滚动文件 Handler:单个文件达到 5MB 时自动切分,最多保留 5 个备份文件
    file_handler = RotatingFileHandler(
        filename=log_filepath,
        maxBytes=5 * 1024 * 1024,  # 5 MB
        backupCount=5,
        encoding="utf-8"
    )
    file_handler.setLevel(logging.DEBUG)
    file_handler.setFormatter(formatter)
    logger.addHandler(file_handler)

    return logger

# 初始化应用日志器
logger = get_configured_logger()

class BusinessValidationError(Exception):
    """自定义业务验证异常"""
    pass

def execute_data_processing(file_path: str, divisor: int) -> Optional[Dict[str, Any]]:
    """
    模拟典型的数据处理工作流:涉及文件 I/O、自定义校验与数学计算。
    完整应用 try-except-else-finally 结构集成 logging 记录。
    """
    logger.info("开始处理任务,目标文件: '%s', 计算除数: %d", file_path, divisor)
    file_handle = None
    processed_result = None

    try:
        # 第一步:尝试打开并读取文件数据
        logger.debug("尝试打开数据源文件: %s", file_path)
        file_handle = open(file_path, "r", encoding="utf-8")
        raw_content = file_handle.read().strip()
        logger.debug("成功读取文件内容,字节数: %d", len(raw_content))

        # 第二步:数据类型转换与业务规则验证
        if not raw_content:
            raise BusinessValidationError("数据文件内容为空,无法进行指标计算")

        base_value = float(raw_content)

        if divisor == 0:
            raise ZeroDivisionError("除数参数不能为 0")

        # 第三步:核心计算
        calculated_metric = round(base_value / divisor, 4)
        processed_result = {
            "source_file": file_path,
            "base_value": base_value,
            "divisor": divisor,
            "metric": calculated_metric
        }

    except FileNotFoundError as fnf_err:
        # 捕获已知且易发生的环境类错误,记录为 WARNING 或 ERROR,附带调用栈
        logger.error(
            "数据源文件未找到: '%s'。系统无法继续执行当前任务。详细原因: %s",
            file_path,
            fnf_err,
            exc_info=True  # exc_info=True 会自动在日志中输出完整的 Traceback
        )
    except BusinessValidationError as bve_err:
        # 捕获业务规则异常,通常属于预期逻辑分支,记录警告级别
        logger.warning("业务数据校验失败: %s (文件: %s)", bve_err, file_path)
    except ZeroDivisionError:
        # 使用 logger.exception(),它等价于 logger.error(..., exc_info=True)
        logger.exception("计算过程中发生除零错误,divisor 参数不合法")
    except Exception as unexpected_err:
        # 兜底捕获所有未知异常,防止整个应用在后台静默崩溃
        logger.critical(
            "处理流程遇到未知严重系统错误: %s",
            unexpected_err,
            exc_info=True
        )
    else:
        # 当且仅当 try 代码块内没有任何异常发生时执行
        logger.info(
            "数据处理成功完成!计算指标: %s",
            processed_result["metric"]
        )
        return processed_result
    finally:
        # 无论成功还是抛出异常,都会被无条件执行的清理段
        if file_handle and not file_handle.closed:
            file_handle.close()
            logger.debug("已安全关闭文件句柄: %s", file_path)
        logger.debug("任务生命周期钩子执行完毕,执行资源回收动作")

    return None

if __name__ == "__main__":
    logger.info("=== 开始执行 Python 错误处理与日志记录集成演示 ===")

    # 场景 1:成功执行演示(创建测试文件并执行计算)
    sample_file = "valid_data.txt"
    with open(sample_file, "w", encoding="utf-8") as f:
        f.write("1024.50")

    result = execute_data_processing(sample_file, divisor=4)
    logger.info("场景 1 返回结果: %s", result)

    # 场景 2:触发 FileNotFoundError 异常演示
    execute_data_processing("non_existent_data.txt", divisor=2)

    # 场景 3:触发除零异常 ZeroDivisionError 演示
    execute_data_processing(sample_file, divisor=0)

    # 清理测试生成的临时文件
    if os.path.exists(sample_file):
        os.remove(sample_file)

    logger.info("=== 演示执行完毕,所有错误均已按级别记录并保留排查轨迹 ===")
三、落地实施的四个关键操作步骤
将上述代码拆解到实际工程中,需要遵循规范的操作流程,避免盲目包裹代码。一个健壮的错误处理与日志体系通常按照以下四个步骤逐步部署:
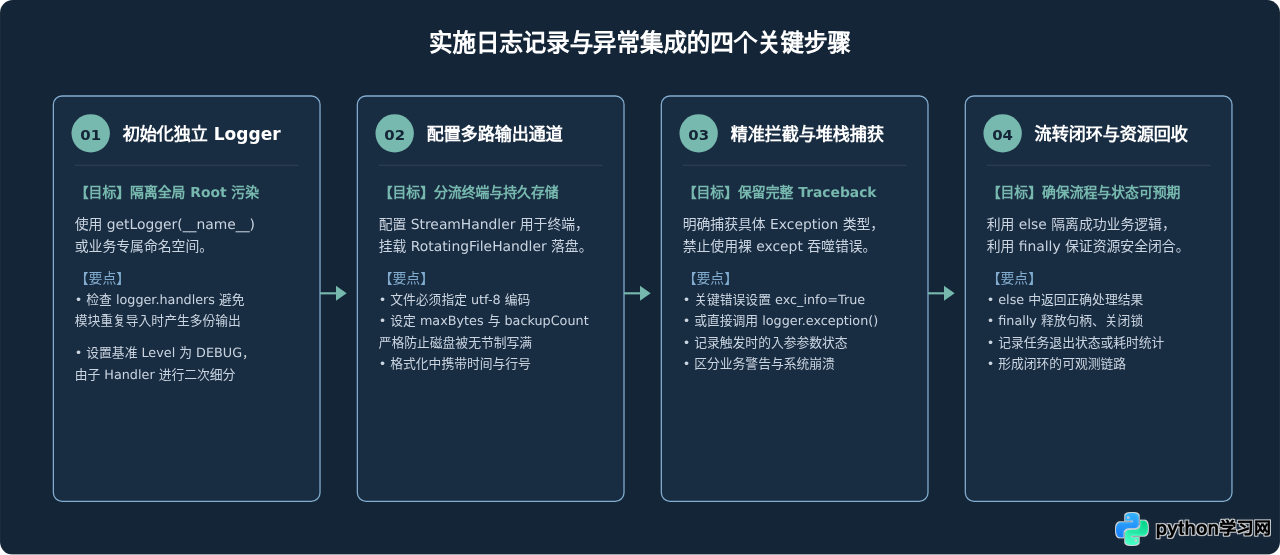
步骤 1:按模块层级初始化专属 Logger 实例
在任何模块中,都应使用 logging.getLogger(__name__) 或明确的命名空间获取 Logger。不要直接在应用中频繁调用 logging.basicConfig(),因为该函数只会作用于 Root Logger,且一旦被第三方库提前调用就会静默失效。在配置自定义 Logger 时,务必加入 if logger.handlers: return logger 的前置判断,防止在单元测试或高频导入时因重复注册 Handler 导致同一行日志在屏幕上被打印多次。
步骤 2:搭配 StreamHandler 与 RotatingFileHandler 实现多通道输出
生产环境必须将“即时排查需求”与“事后审计需求”分离:
- 控制台输出(StreamHandler):设置级别为
INFO或WARNING,保持终端清爽,适合容器化环境的stdout/stderr汇聚工具采集。 - 本地持久化(RotatingFileHandler):设置级别为
DEBUG,捕获一切微观细节;同时指定maxBytes=5*1024*1024与backupCount=5,使文件在超过 5MB 时自动滚动为app.log.1、app.log.2,超出数量时自动覆盖最老文件,从根源上杜绝服务器磁盘被日志撑爆的事故。
步骤 3:在 except 中利用 exc_info 捕获完整调用栈
捕获异常后,如果只调用 logger.error(f"出错了: {e}"),日志中只会记录 出错了: [Errno 2] No such file or directory,后续维护人员无法得知具体是哪一行代码调用触发了该异常。正确的做法是在调用 logger.error() 时传入参数 exc_info=True,或者直接使用专门为异常块设计的快捷方法 logger.exception("...")。底层 logging 会自动从当前线程的上下文中获取完整 Traceback 并将其格式化后追加到日志正文中。
步骤 4:通过 else 与 finally 确保逻辑流转与资源清理
try 块内部的代码行数应尽量缩减,仅包含可能产生特定异常的核心语句。成功后的后续操作(例如将结果写入缓存、向外部系统发送通知)应放置在 else 块中,这样可以避免成功逻辑中意外抛出的无关异常被当前的 except 错误拦截。而关闭文件句柄、释放数据库连接、归还线程池连接等必须执行的操作,则必须放在 finally 块中,无论是否发生异常都执行安全释放。
四、关键代码模式对比与决策依据
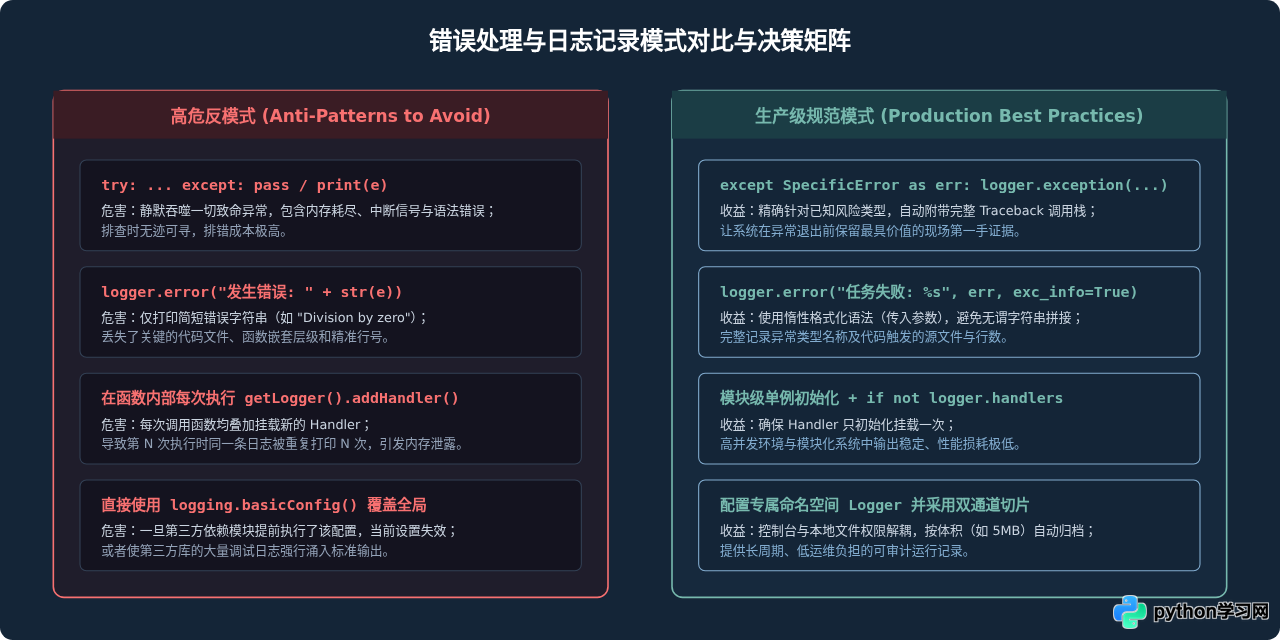
在实际编写错误处理代码时,开发者常在一些常见写法之间犹豫。下表及决策图直观对比了典型反模式与标准工程写法之间的差异:
| 场景需求 | 高危/反模式做法 | 工程规范推荐做法 | 设计考量与收益 |
|---|---|---|---|
| 输出运行异常 | print(e) |
logger.error("操作失败", exc_info=True) |
print 丢失时间、行号与 Traceback;logger 具备完整上下文与重定向能力。 |
| 异常类型匹配 | 裸 except: 或 except Exception: 无差别吞噬 |
明确捕获特定类 except (ValueError, KeyError) as e: |
裸 except 会拦截 SystemExit 和 KeyboardInterrupt,导致无法正常通过 Ctrl+C 终止程序。 |
| 堆栈跟踪记录 | 手动通过 traceback.print_exc() 打印 |
在 except 块中使用 logger.exception("详细说明") |
保持日志格式的一致性,确保堆栈能够正确写入到所有挂载的 Handler(如磁盘文件)。 |
| 资源管理清理 | 仅在 try 的末尾执行 f.close() |
使用 with 语句或在 finally 块中严格检查并关闭 |
一旦 try 语句中途报错,末尾的 close 将被跳过,导致句柄泄漏。 |
五、生产部署注意事项与实战技巧
在生产系统中,如果在 try-except 记录日志时直接将用户提交的完整载荷(Payload)或数据库连接字符串无差别输出,极易将用户明文密码、API Token、身份证号或银行卡信息打入日志文件。
建议做法:对记录到日志中的字典或对象进行前置脱敏处理;对于包含密码等敏感字段的配置项,在记录时使用 *** 屏蔽关键值。
logging 模块原生支持 extra 参数字典。在 except 中捕获异常时,可以将当前请求的 request_id、user_id 或处理的 batch_id 传入 extra 中。
logger.error(
    "订单支付扣款失败",
    exc_info=True,
    extra={"order_id": "ORD-20261015-001", "user_id": 98122, "amount": 299.00}
)
只要在 Formatter 中配置了 %(order_id)s 等占位符,或者对接 ELK、Loki 等集中日志平台,这些字段就能够被单独索引,使得排查复杂分布式链路中的异常变得轻而易举。
异常包装与主动重新抛出(raise from)
在很多大型分层架构(如 Web 视图层与底层的 DAO 数据访问层)中,底层捕获了 sqlite3.OperationalError 或 IOError 等系统级异常并记录日志后,可能不希望将底层细节直接暴露给上层控制器,而是需要包装为业务统一的 DataPersistenceError。此时应使用 Python 3 的 raise from 语法:
try:
    cursor.execute(sql, params)
except sqlite3.OperationalError as db_err:
    logger.error("数据库底层执行失败,SQL: %s", sql, exc_info=True)
    # 包装为上层可识别的业务异常,并保留原始异常因果链
    raise DataPersistenceError("持久化存储异常,已记录审计日志") from db_err
这种写法能够完整保留“异常成因链(Exception Chaining)”,后续无论是上层继续捕获还是直接抛出,Python 都会在输出中清晰标明 The above exception was the direct cause of the following exception,兼顾了模块封装与排错诉求。
六、全文总结与生命周期闭环
将 try-except 与 logging 深度集成,不是简单地在代码周围加上几行保护代码,而是建立一套从异常感知、分级过滤、现场保护、持久归档到告警响应的完整质量防御闭环。
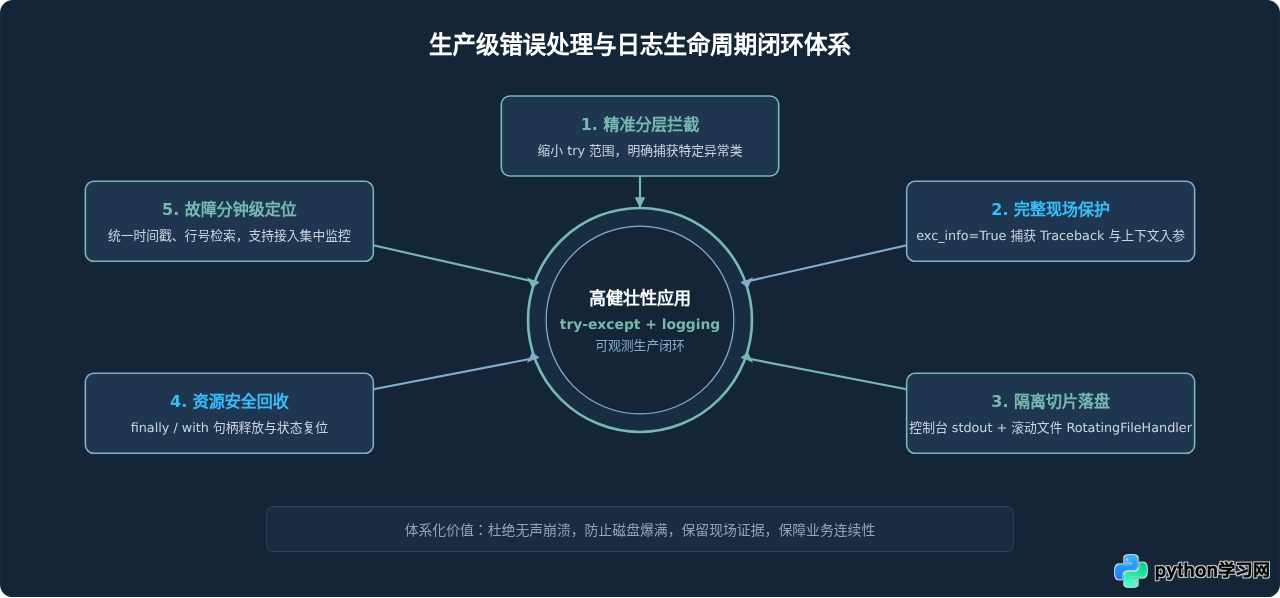
掌握并落地本篇所提供的工程级配置与代码模板,不仅可以帮助开发者在本地开发与自动化测试中快速溯源缺陷,更能确保代码在部署到生产服务器或容器集群后,面对偶发性的网络抖动、文件损坏或业务脏数据时,仍能维持秩序、完整记录原因并平稳运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















