


解决AI搜索API返回结果不准确或超配额限制的常见方法
本文以Tavily API为例,解析AI搜索调用中“状态错误”与“结果空值”的混淆问题。通过Python离线分类代码演示如何区分限流、预算耗尽与真实空结果,避免将技术故障误判为内容缺失。文章进一步探讨了基于证据链的质量优化策略及合规的配额管理方案,帮助开发者建立稳定的检索增强生成(RAG)流程。
AI 搜索 API 的“没找到”和“没调用成功”必须分开处理。前者可能需要改查询与核对来源,后者要先看响应状态;如果把错误统一转换成空列表,后续模型就可能在没有检索证据的情况下继续生成答案。下面以 Tavily 的响应语义为例,演示离线分类,不发送真实请求,也不消耗搜索额度。
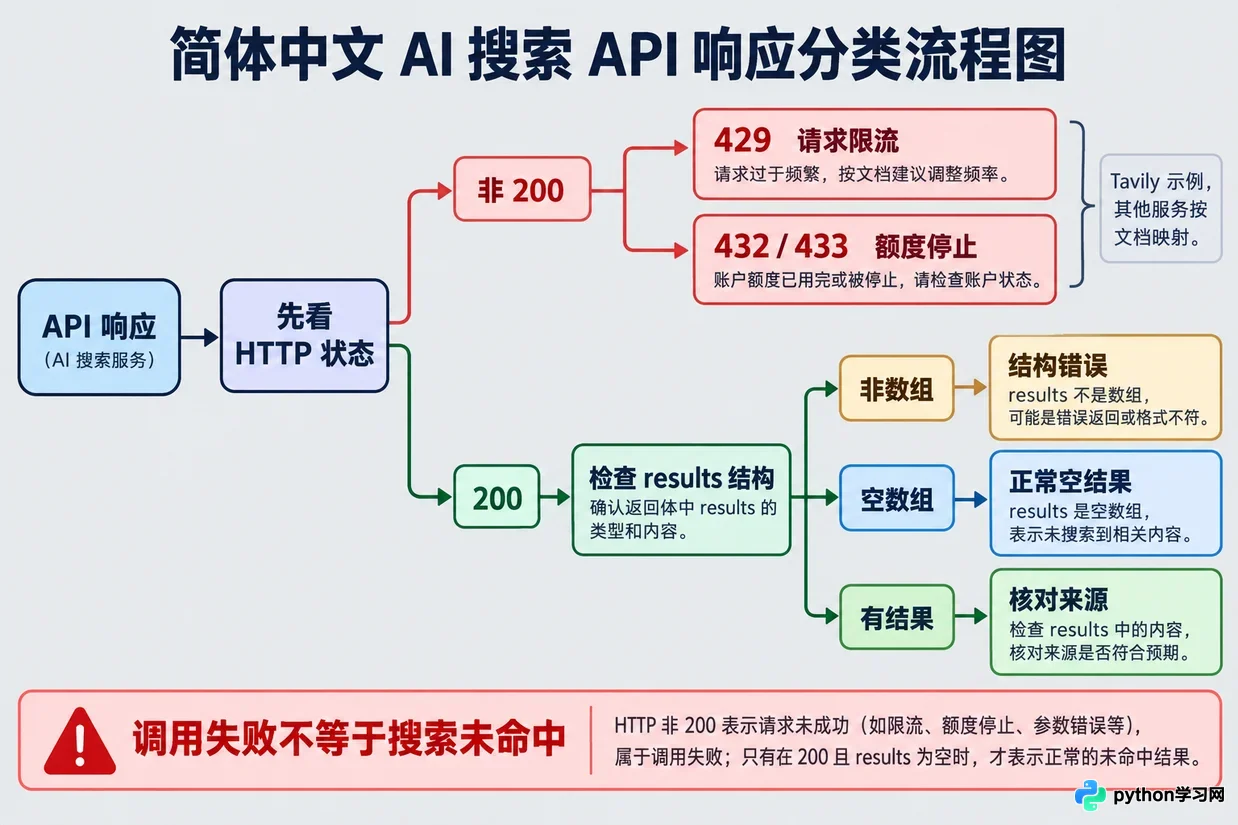
AI搜索API错误处理逻辑分支示意图
先看状态,再讨论搜索结果是否准确
一种常见错误,是拿到响应 JSON 后直接读取 results,没有先检查 HTTP 状态。错误响应没有这个字段时,默认空列表会掩盖真正原因。最小错误写法如下,示例环境为 Python 3,仅使用本地构造的数据:
def wrong(status, payload):
    return payload.get("results", [])

print(wrong(429, {}))
# []
这个空列表不是“搜索没有命中”。它只是程序把错误结构当成了成功结构。日志如果只记“结果数量0”,就会把限流、预算耗尽、鉴权问题和正常空结果混为一谈。
在 Tavily 的现行定义中,429 表示请求过密,432 表示套餐使用上限,433 表示按量付费上限。它们不能共用一个无限重试分支。其他供应商的状态和错误体可能不同,接入时应按自己的服务文档建立映射,而不是把这几个编号当作行业统一标准。
错误被吞掉,会把成本问题变成内容问题
如果调用失败后仍让模型回答,用户看到的是一段流畅文字,后台实际却没有获得新的搜索证据。若再因答案不满意而自动拆成更多查询、增加并发,可能进一步触发限制,形成“结果越差,请求越多”的循环。
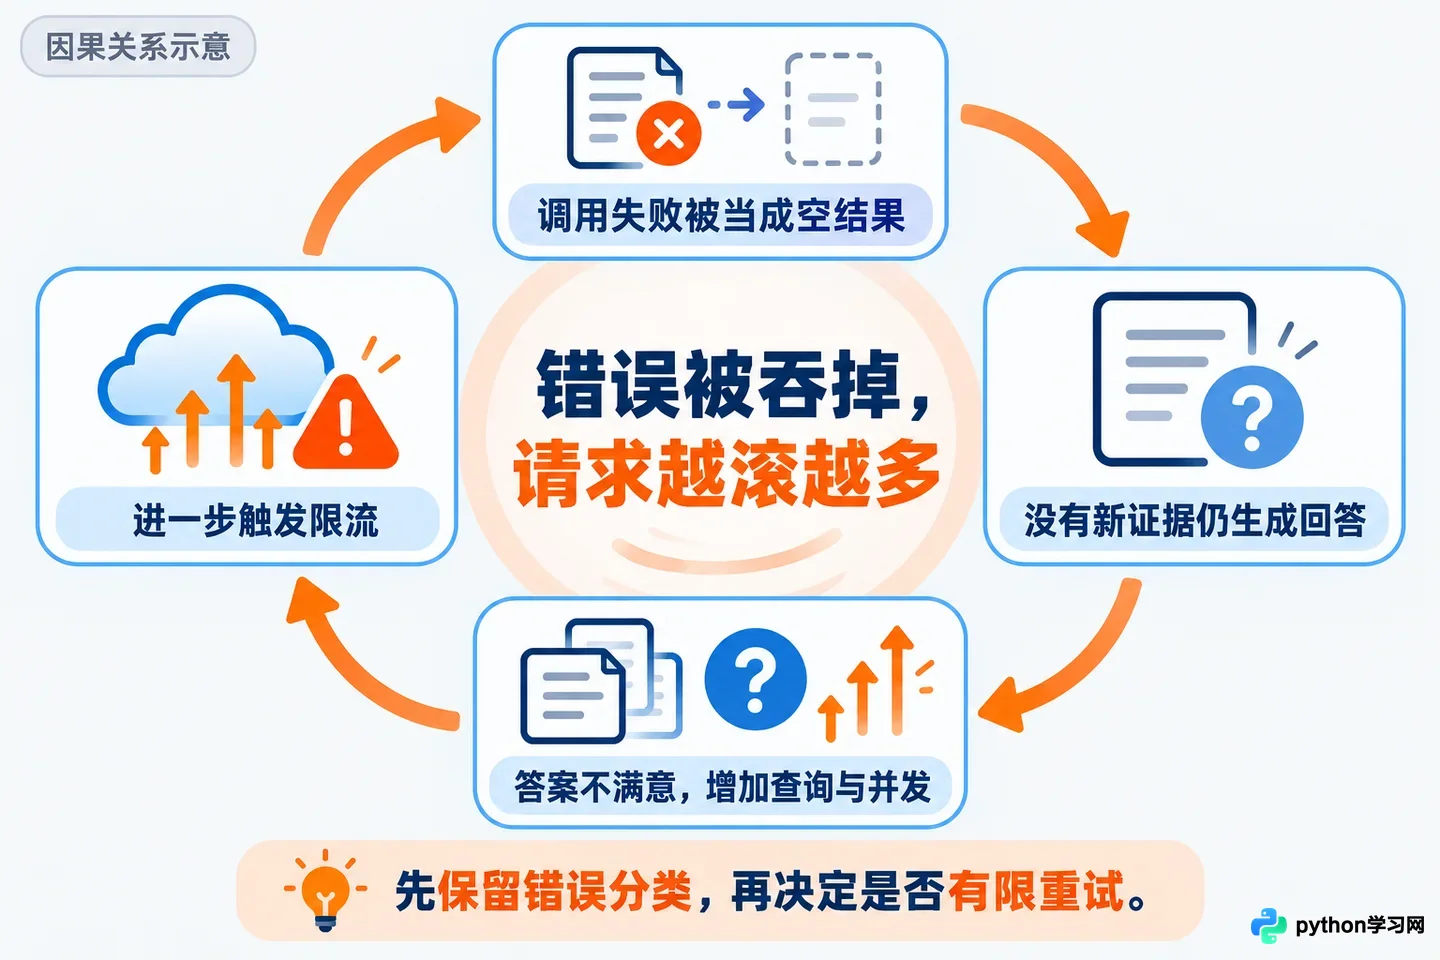
错误处理不当导致的请求风暴循环
先在程序边界保留状态、请求标识、耗时和脱敏后的错误类别。不要把 API 密钥、完整敏感查询或未经处理的用户资料写入公开日志。成功响应还要检查结构,不能把 results 为 null 当成空数组。
下面的修正代码只负责分类,不实现联网、退避或自动扣费。分类结果交给业务层决定:
def fixed(status, payload):
    if status == 429:
        return "RATE_LIMIT"
    if status in (432, 433):
        return "BUDGET_STOP"
    if status != 200:
        return "ERROR"
    results = payload.get("results")
    if not isinstance(results, list):
        return "SCHEMA_ERROR"
    return "EMPTY" if not results else "REVIEW_SOURCES"

for status, payload in [
    (429, {}),
    (432, {}),
    (200, {"results": []}),
    (200, {"results": [{"title": "test"}]}),
]:
    print(status, wrong(status, payload), fixed(status, payload))
这组离线数据已运行,输出为:
429 [] RATE_LIMIT
432 [] BUDGET_STOP
200 [] EMPTY
200 [{'title': 'test'}] REVIEW_SOURCES
最后一行只说明存在待检查的结果,不证明来源真实、内容相关或答案正确。示例中的 test 是测试标记,不是搜索结果或测评证据;生产代码还应处理超时、非 JSON 响应及字段结构变化。
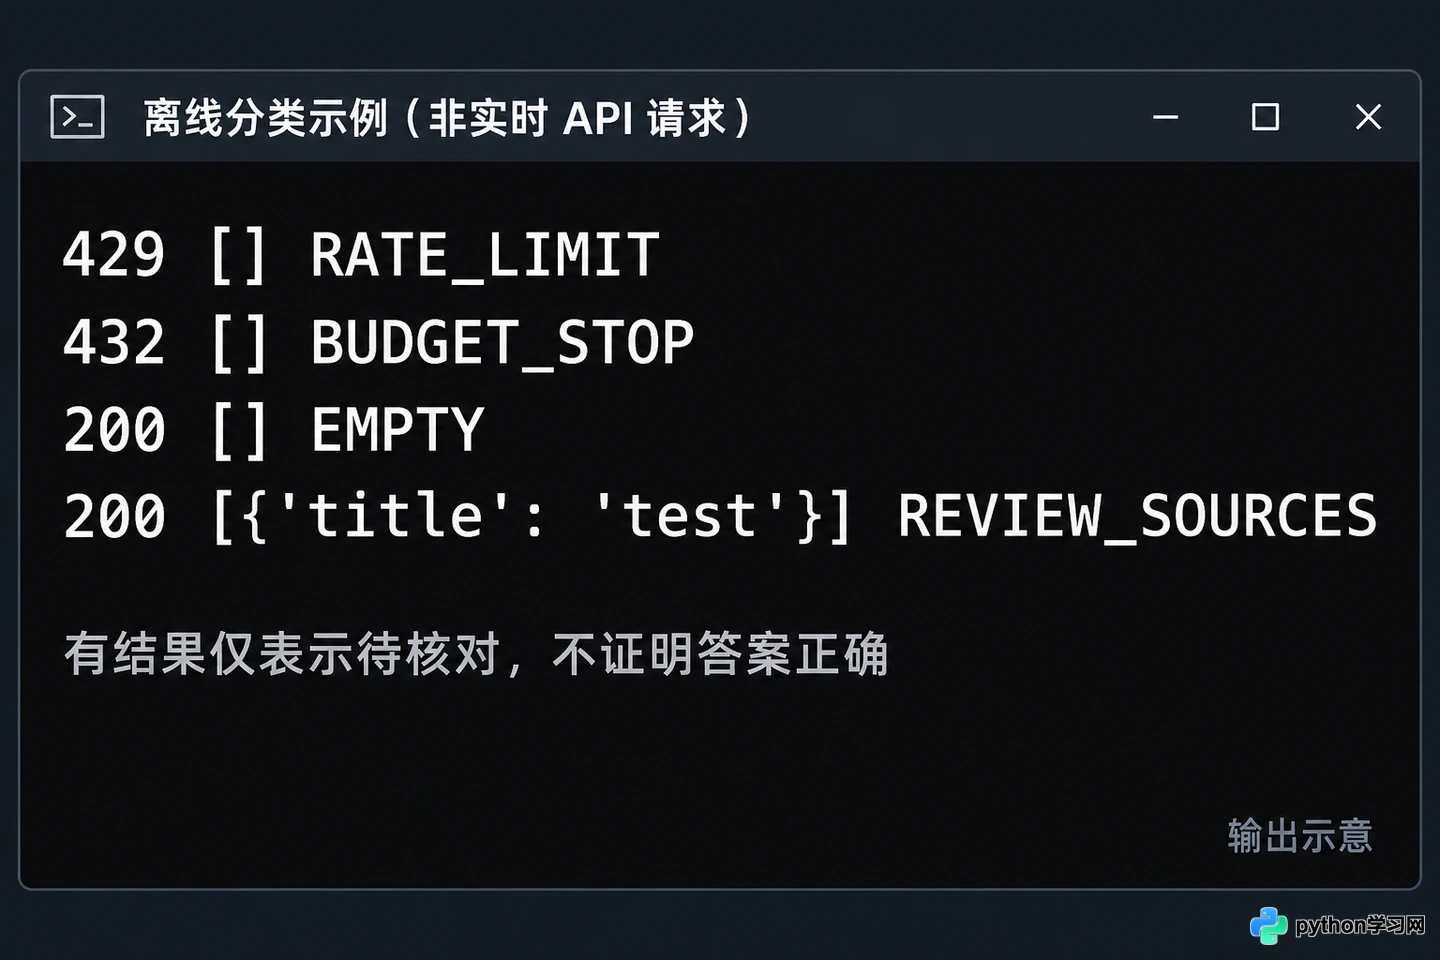
修正后的分类器代码运行输出
质量问题改证据链,额度问题改调用策略
当状态成功但答案不准,先比较请求、原始结果和最终摘要:查询是否带上对象全名与版本,结果是否来自目标主体,原文日期是否适合问题,摘要是否加入了来源没有支持的推断。若原始结果就偏题,先改查询;若原文相关而摘要歪了,应修正摘要环节,不必一味增加搜索次数。
Tavily 提供时间范围、包含或排除域名等搜索条件。它们有助于约束范围,也可能排掉真正需要的来源;过滤后为空,应检查条件是否过窄,而不是宣称目标事实不存在。搜索相关性分数也不等于事实真实性,重要结论仍要检查原文。
对短时限流,应限制并发和请求频率,合并同一问题的重复调用;只有适合重试的请求,才设置有限次数的退避,并遵守服务返回的等待信息。不要在多个工作线程中各自立即重试,把一次限流放大成请求风暴。
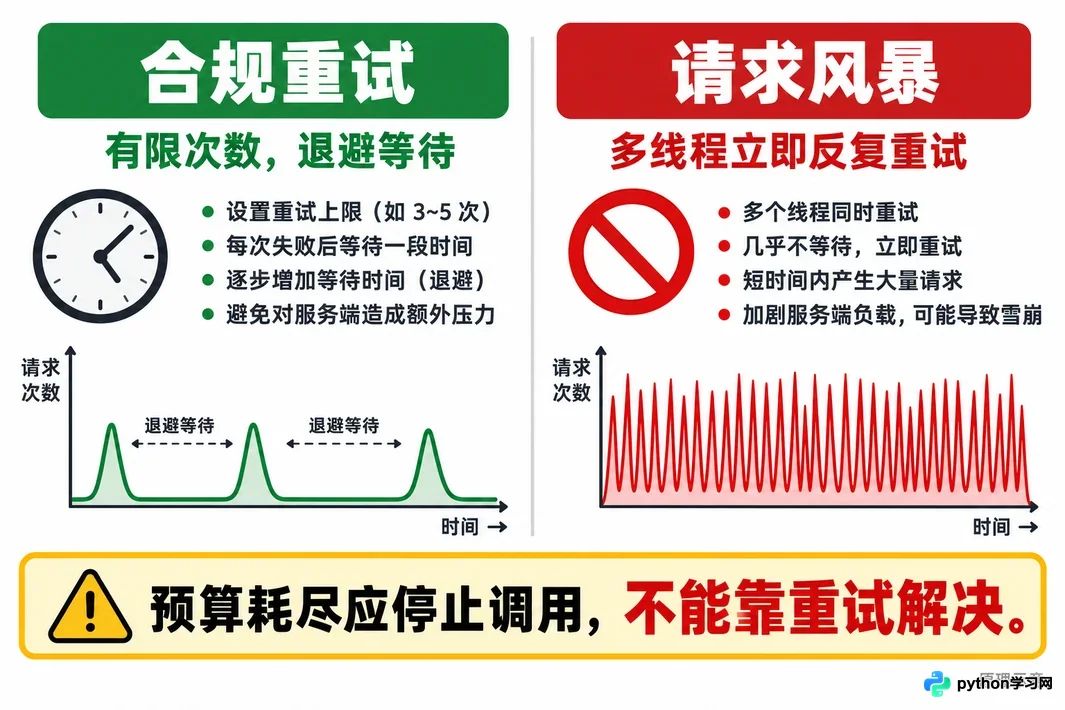
合规重试与请求风暴的对比
对预算或套餐上限,应暂停受影响的自动调用,向用户明确说明当前无法获得新检索结果。是否提高预算是单独的授权决定,不自动购买、换账号或轮换密钥绕过限制。可以在明确标注时间与来源的前提下提供已有缓存,不能把旧缓存说成刚检索的数据。
缓存键还应包含影响结果的查询条件,而不只是用户的一句话;但也不应为了命中率长期保存不宜保留的敏感查询。修复前后用同一组脱敏样例比较错误分类、命中内容和调用数量,不用一次成功就声称问题彻底解决。
先证明请求成功,再评估证据质量;重试解决的是暂时失败,不会自动修正查询语义,更不能替代预算授权。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















