


不用安装第三方包:Python标准库怎么实现HTTP请求与CSV解析
在无法安装外部依赖的受限环境下,使用Python内置的urllib.request与csv模块,即可高效完成网络数据获取、流式字符解码与结构化CSV解析全流程。
urllib.request 搭配 csv 与 io 模块,就能以零外部依赖的方式稳定完成远端数据拉取、字符集解码以及结构化表格解析全过程。
在许多实际生产场景中,安装外部扩展包并非唾手可得的事情:严格锁死的内网运维跳板机、体积敏感的超轻量 Docker 基础镜像、资源受限的嵌入式边缘节点,或者需要长期分发给客户独立运行的自动化单文件脚本。在这些场景中,外部依赖不仅增加了打包复杂度与安全审计成本,还可能因网络隔绝导致安装失败。
事实上,Python 自带的电池(Batteries Included)设计早已完备。标准库中的 urllib.request 负责底层的 HTTP/HTTPS 协议交互,io.TextIOWrapper 或 io.StringIO 承担网络字节流与文本之间的编码转换桥梁,而 csv 模块则以高鲁棒性的状态机处理带转义、换行与特殊分隔符的表格内容。
一、数据交互链路与核心模块分工
实现“从网络获取并解析 CSV”的核心逻辑,本质上是一条清晰的数据管道流转过程。网络请求输出的是原始二进制字节(Bytes),CSV 解析器需要的是字符文本行(Text Stream),明确两者之间的转换机制是写出高效代码的前提。
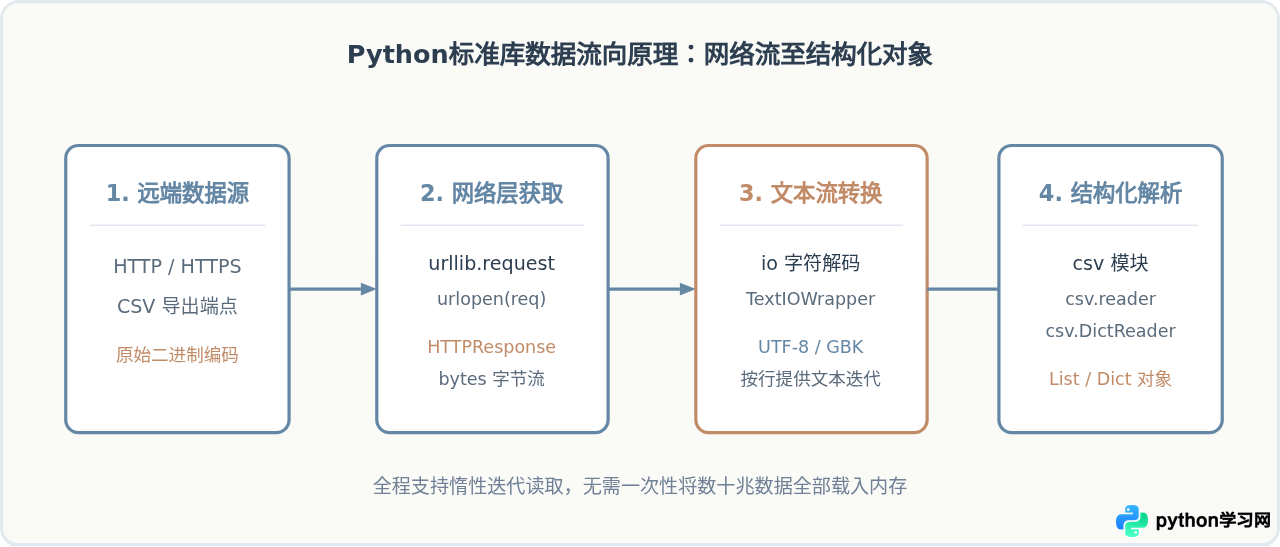
从上图可以看到,整个过程分为四个独立而衔接紧密的阶段:
- 网络传输阶段:使用
urllib.request.Request组装定制化报头(如 User-Agent、Token 认证),通过urlopen发出请求并获得套接字响应对象。 - 流式封装阶段:由于
csv模块只能接收产出字符文本(str)的可迭代对象,而urlopen返回的是二进制数据流(bytes),需要借助io.TextIOWrapper进行透明的流式字符解码。 - 语法分析阶段:
csv.reader或csv.DictReader接入解码流,按照 RFC 4180 规则逐行抽取字段并拆分为 Python 列表或字典。
二、使用 urllib.request 发起 HTTP 请求
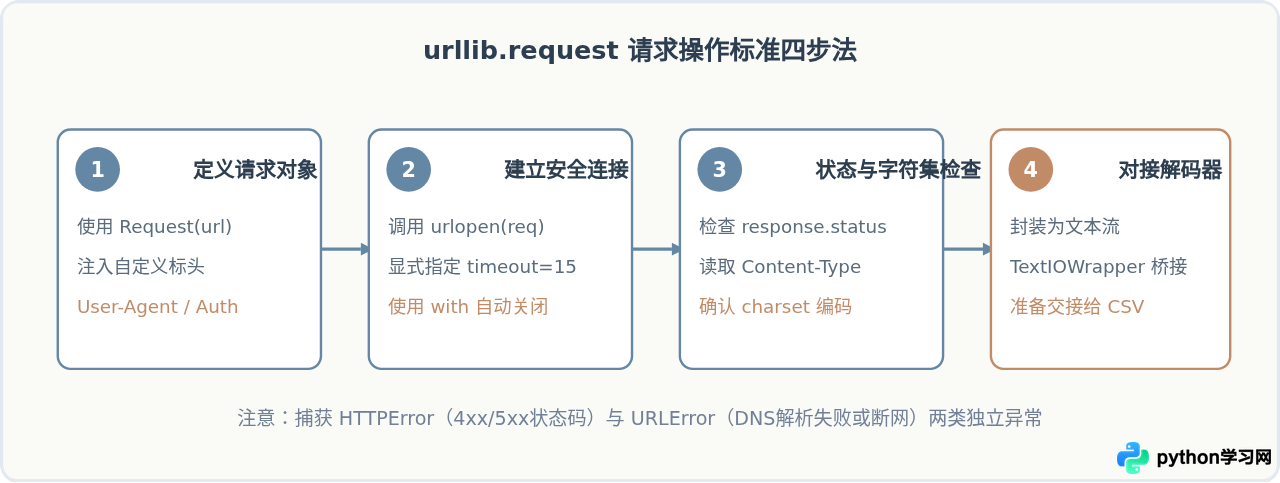
发起基础网络请求只需调用 urllib.request.urlopen(url),但在实际工程环境中,直接传入纯字符串 URL 往往容易被目标服务器因“缺省 User-Agent”拦截,或因网络抖动导致连接无限期挂起。因此规范的做法必须包含明确超时限制与构造 Request 头部。
1. 基础请求示例
import urllib.request
import urllib.error

url = "https://example.com/data/reports.csv"

# 1. 显式组装带有浏览器特征或业务凭证的标头
headers = {
    "User-Agent": "InternalDataCollector/1.0 (Python Standard Library)",
    "Accept": "text/csv, text/plain; q=0.9, */*; q=0.8"
}

req = urllib.request.Request(url, headers=headers, method="GET")

try:
    # 2. 发起请求并强制设置超时时间(单位为秒)
    with urllib.request.urlopen(req, timeout=15) as response:
        # 获取 HTTP 状态码
        status_code = response.status
        print(f"请求状态码: {status_code}")

        # 读取响应头中声明的字符集,若未声明则默认按 UTF-8 处理
        charset = response.headers.get_content_charset() or "utf-8"
        print(f"检测到响应字符集: {charset}")

except urllib.error.HTTPError as e:
    print(f"服务端响应错误: HTTP {e.code} - {e.reason}")
except urllib.error.URLError as e:
    print(f"网络或连接错误: {e.reason}")
requests 库在状态码为 404 或 500 时仍返回 Response 对象不同,标准库的 urlopen 遇到非 2xx/3xx 响应会直接抛出 urllib.error.HTTPError 异常。因此网络调用必须用 try...except 严密包裹。
三、解析 CSV:csv.reader 与 csv.DictReader 对比
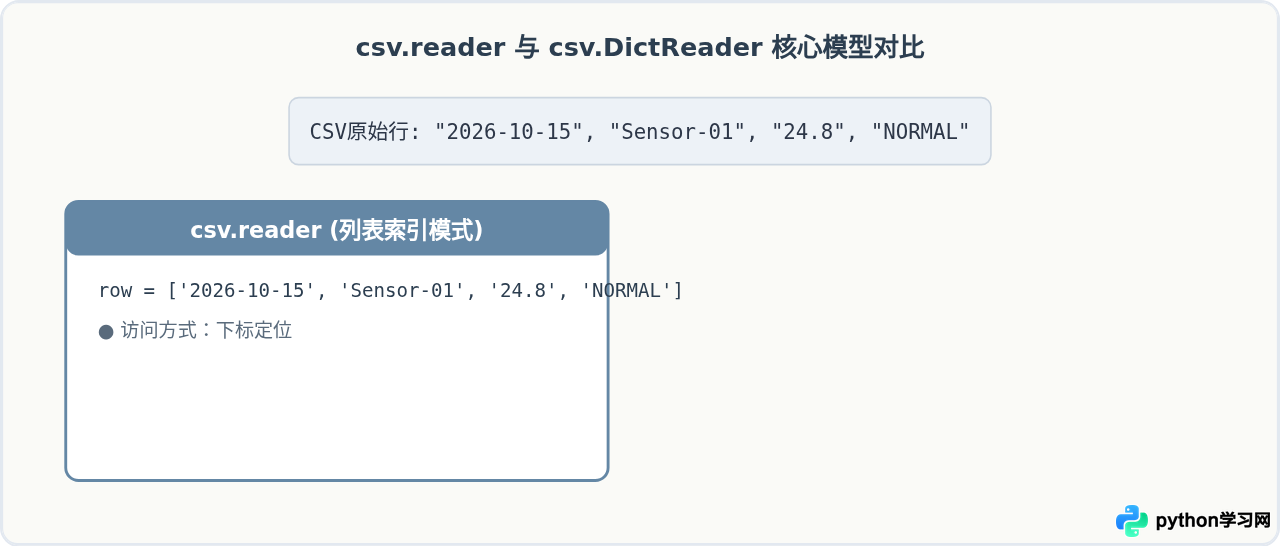
成功获得网络响应后,如何高效解析数据?Python 提供了两种主要的解析器:csv.reader 与 csv.DictReader。它们在内存开销和编码直观性上各有所长。
1. 内存流解析法(适合中小型数据)
当数据量较小(例如数十 KB 到几 MB 之间)时,可以一次性调用 response.read().decode('utf-8') 将全部字节载入内存,并包装为 io.StringIO 供解析器使用:
import io
import csv

raw_text = """id,device_name,temperature,status
101,Gateway-A,23.5,ONLINE
102,Gateway-B,28.1,WARNING
103,Sensor-Node-01,19.2,ONLINE
"""

# 使用 io.StringIO 将字符串转为文件式对象
stream = io.StringIO(raw_text.strip())

# 使用 DictReader 迭代
reader = csv.DictReader(stream)
for row in reader:
    dev = row["device_name"]
    temp = float(row["temperature"])
    status = row["status"]
    print(f"设备: {dev:<15} 温度: {temp:>5.1f}℃  状态: {status}")
2. 流式直读解析法(高效省内存)
如果远端的 CSV 文件有几十兆甚至数百兆,调用 .read() 会将整个文件一口气吞进内存,甚至引发 Out-Of-Memory(OOM)。
解决该问题的终极方案是利用标准库的 io.TextIOWrapper,直接把网络套接字 response 包装成支持逐行读取的字符流。此时 csv.reader 每迭代一行,底层仅从网络中拉取对应的缓冲块,内存占用恒定保持在数 KB 水平。
四、完整端到端实战:流式获取并解析线上 CSV
下面是一个符合生产级规范的完整单文件脚本,不依赖任何第三方模块,演示从网络请求发起、字符集自适应检测、流式交接,到过滤统计的全部过程。
import urllib.request
import urllib.error
import io
import csv

def fetch_and_analyze_remote_csv(target_url: str):
    """
    使用纯标准库拉取远端 CSV 并完成流式统计分析
    """
    request_headers = {
        "User-Agent": "Mozilla/5.0 (Compatible; InternalDataProcessor/2.0)",
        "Accept": "text/csv, text/plain; q=0.9"
    }

    req = urllib.request.Request(target_url, headers=request_headers)

    print(f"[1/4] 发起连接: {target_url}")
    try:
        # 打开远程连接,设置超时时间为 20 秒
        with urllib.request.urlopen(req, timeout=20) as response:
            if response.status != 200:
                print(f"非期望状态码: {response.status}")
                return

            # 获取响应编码声明,无法识别时降级为 utf-8-sig(可顺带剔除 BOM 头)
            charset = response.headers.get_content_charset() or "utf-8-sig"
            print(f"[2/4] 连接成功,状态码: {response.status},字符集: {charset}")

            # 核心步骤:直接将原始二进制套接字 response 封装为流式文本读取器
            # newline='' 是 Python 官方针对 csv 模块推荐的换行处理参数
            text_stream = io.TextIOWrapper(response, encoding=charset, newline='')

            print("[3/4] 初始化 CSV 解析器...")
            reader = csv.DictReader(text_stream)

            # 字段校验
            if not reader.fieldnames:
                print("错误:CSV 文件表头为空!")
                return
            print(f"识别到的字段列表: {reader.fieldnames}")

            # 边读边统计,内存零积压
            total_count = 0
            alert_count = 0

            print("[4/4] 开始流式消费数据行:")
            for line_no, row in enumerate(reader, start=1):
                total_count += 1

                # 示例业务过滤:假定表包含 'status' 与 'temperature'
                status = row.get("status", "").upper()
                try:
                    temp = float(row.get("temperature", 0.0))
                except ValueError:
                    temp = 0.0

                if status == "WARNING" or temp > 35.0:
                    alert_count += 1
                    dev_id = row.get("id", f"Row-{line_no}")
                    print(f"  [告警] 设备编号: {dev_id} | 温度: {temp}℃ | 状态: {status}")

            print("=" * 45)
            print(f"解析完成!共处理数据行: {total_count} 条,触发告警: {alert_count} 条")

    except urllib.error.HTTPError as http_err:
        print(f"[HTTP错误] 服务端返回代码: {http_err.code}, 详情: {http_err.reason}")
    except urllib.error.URLError as net_err:
        print(f"[网络错误] 无法建立通信: {net_err.reason}")
    except csv.Error as csv_err:
        print(f"[CSV解析错误] 格式异常: {csv_err}")
    except Exception as general_err:
        print(f"[未知异常] {type(general_err).__name__}: {general_err}")

if __name__ == "__main__":
    # 测试使用的模拟公共端点
    SAMPLE_URL = "https://raw.githubusercontent.com/datasets/gdp/master/data/gdp.csv"
    fetch_and_analyze_remote_csv(SAMPLE_URL)
五、生产环境高频避坑清单
仅掌握核心 API 还不足以保证生产环境下的平稳运行。以下是不用第三方库时最常遇到的四类细节问题及其确定性的应对策略:
微软系软件(如 Windows Excel 导出的 CSV)常会在文件最开头附加三个隐藏字节
\xef\xbb\xbf(即 UTF-8 BOM)。如果使用普通 utf-8 解码,首个字段名会被识别为 \ufeffid,导致 row["id"] 抛出 KeyError。解决方案:在
TextIOWrapper 或 decode 时,明确使用 encoding="utf-8-sig",Python 会自动识别并剔除开头的 BOM。
欧洲部分国家或系统常以分号
; 作为 CSV 分隔符,数据日志也常见制表符 \t。解决方案:利用
csv.Sniffer 自动探测,或在实例化时显式传入参数 csv.reader(stream, delimiter=';')。
在企业私有网关或测试环境下,目标服务可能使用了内网自签证书,
urllib 默认会做严格校验证书链,直接报错 CERTIFICATE_VERIFY_FAILED。解决方案:若需在受信任的专有环境中临时跳过校验,可借助标准库
ssl 模块:
import ssl
# 创建非校验上下文(生产外网请慎用)
ctx = ssl.create_default_context()
ctx.check_hostname = False
ctx.verify_mode = ssl.CERT_NONE

response = urllib.request.urlopen(req, context=ctx)
六、方案选型与决策总结
掌握 Python 标准库的 HTTP 与 CSV 处理能力,并不意味着要盲目排斥优秀的开源第三方库。明确标准库与第三方库的工程定位,是做架构选型的关键。
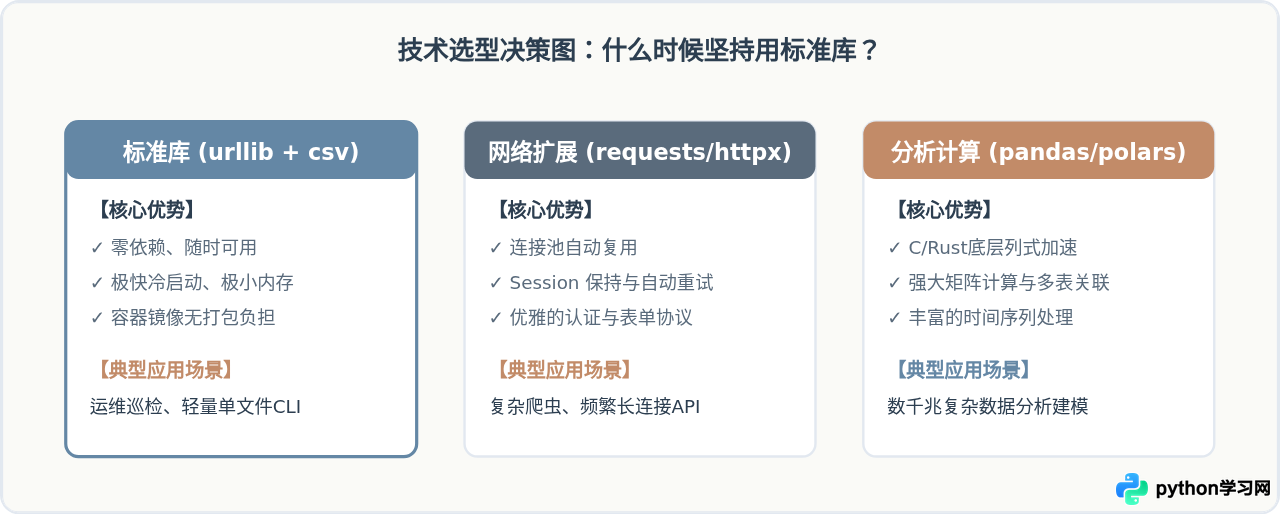
总结而言,在追求极致便携性、环境不可控、离线受限或轻量运维等场景下,Python 标准库的 urllib.request 与 csv 是毫无疑问的第一选择。只要理顺“网络流 -> 编码文本流 -> 结构化表格”这三级转化机制,就能在不下载任何第三方 wheel 包的前提下,写出既高效又健壮的生产级代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















