


Python打印字符串时\n和\t不生效的原因及解决方法
深入解析在Python中打印字符串时转义字符\n与\t不生效的四大核心根源,提供包含容器直接打印、原始字符串误用、字面量二次转义以及制表位机制的完整排查步骤与修复方案。
\n(换行符)和 \t(制表符)在打印时没有产生换行或缩进,而是原样显示为字面量字符,或者排版位置不符合预期,核心根源通常只有四种情况:在列表或字典等容器中直接输出触发了 repr() 解析、字符串前误加了 r 声明为原始字符串、外部读取数据时反斜杠被二次转义为 \\n,或者终端环境下制表位宽度计算产生视觉偏差。只要找准出现阶段,就能通过针对性的方法彻底解决。
一、现象解析:转义字符为什么会被当成普通字符?
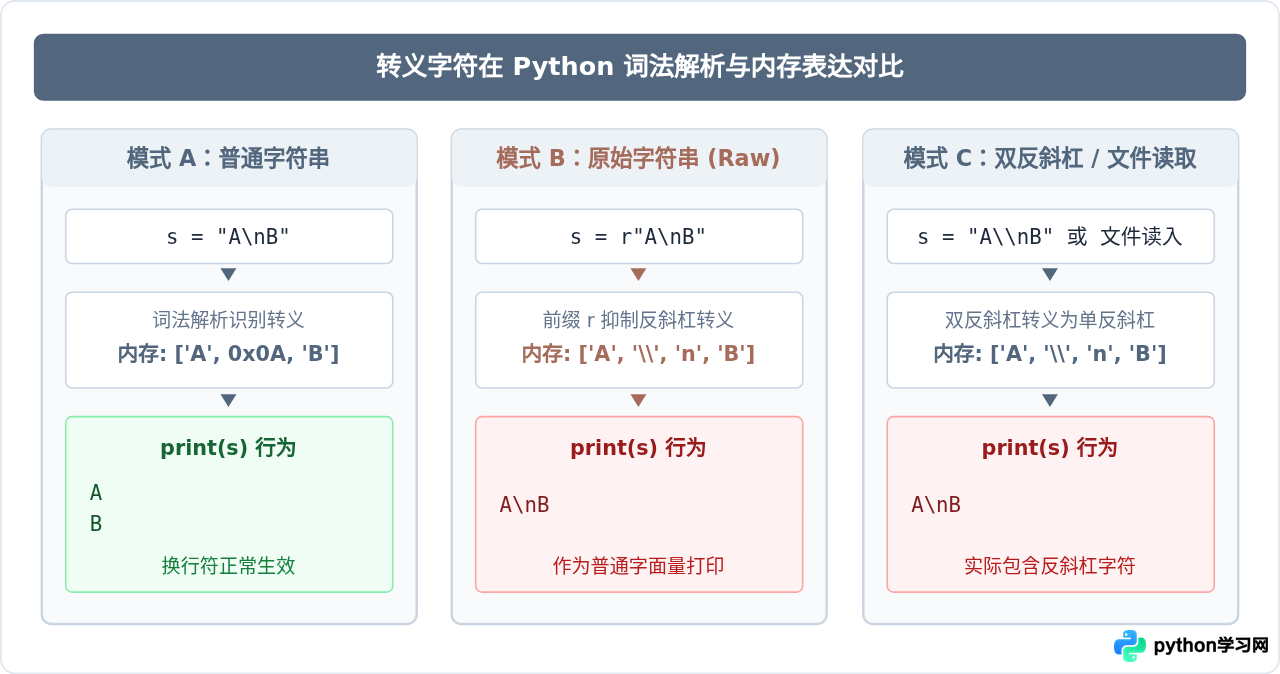
Python 解释器在读取字符串字面量时,默认会对反斜杠 \ 后跟随的特定字符执行转义映射。例如,将 \n 解析为 ASCII 码为 10 的换行符(LF),将 \t 解析为 ASCII 码为 9 的水平制表符(TAB)。
当开发者调用 print() 期望看到分行或水平对齐时,如果终端依然输出了反斜杠和字母本身(例如终端直接打出 hello\nworld),说明在 Python 的内部内存模型中,这个字符串存储的并非单个不可见的控制字符,而是两个独立的字符:反斜杠 \(ASCII 92)与字母 n(ASCII 110)。
二、导致不生效的四大常见原因及代码复现
1. 打印了列表、元组或字典等容器对象
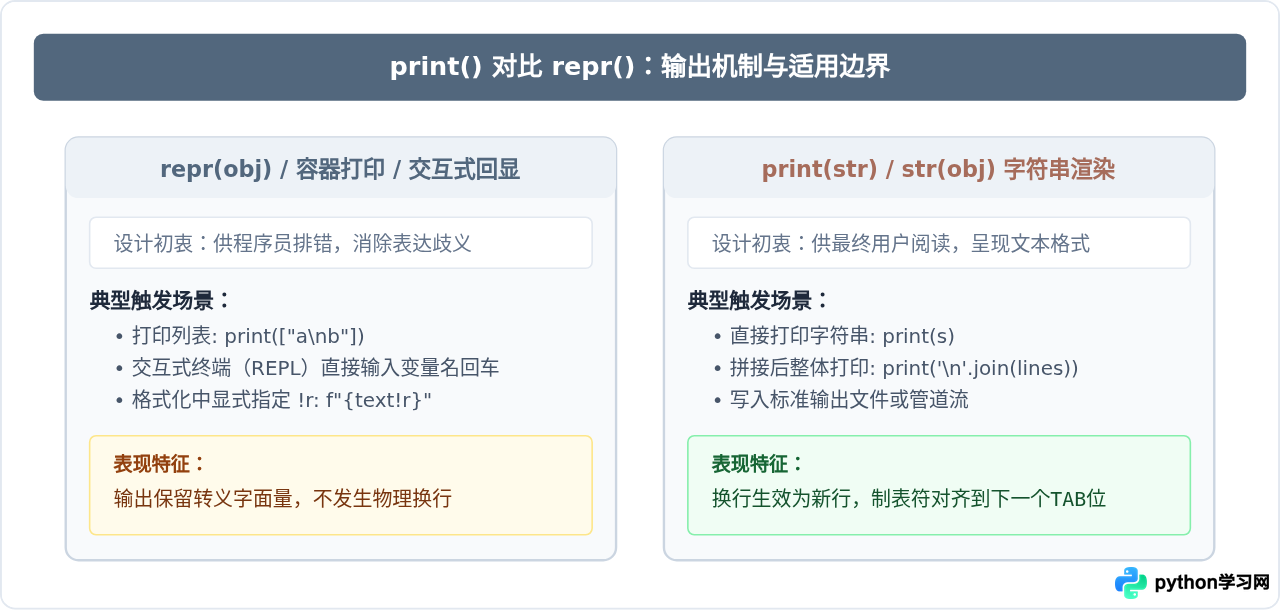
这是初学者最常遇到的陷阱。当把包含 \n 的字符串放入列表中,并执行 print(my_list) 时,屏幕上输出的依然是 \n,而不是换行:
# 示例:直接打印容器对象
lines = ["第一行\n", "第二行\t缩进内容"]
print(lines)

# 控制台输出结果(并没有换行或制表):
['第一行\n', '第二行\t缩进内容']
根本原因:当打印容器类型时,Python 并不会逐个调用每个内部元素的 __str__() 方法,而是调用容器自身的 __repr__()。为了保证开发者调试时不丢失真实结构,repr 会将控制字符显式转义显示。
2. 字符串前添加了原始字符串前缀 r 或 R
在处理正则表达式或 Windows 路径时,我们常用 r"..." 来防止反斜杠转义。如果习惯性给所有字符串都加上 r,转义符便会完全失效:
# 示例:误加了原始字符串标识 r
text = r"项目一\n项目二\t详情"
print(text)

# 控制台输出结果:
项目一\n项目二\t详情
根本原因:原始字符串标志告诉 Python 编译器“请不要转义任何反斜杠”。此时字符 \ 和 n 被按字面存储为两个独立字符。
3. 字符串经过了二次转义,或者来源于外部输入(JSON、文件、数据库)
在很多场景中,字符串并不是硬编码在 .py 文件中的,而是从文本文件、JSON 接口、环境变量或数据库中读出来的。外部数据中如果本身就包含字面量反斜杠和字母 n,读取后反斜杠会被系统转义为 \\:
# 代码中显式写成双反斜杠,或外部文本中直接存有 "\n" 字符
text_escaped = "首行\\n次行"
print(text_escaped)

# 控制台输出结果:
首行\n次行
根本原因:文本文件如果存储了字符 \ 和 n,用 file.read() 读到内存后是长度为 2 的两个字符,并不是换行控制符。
4. 制表符 \t 因终端制表位(Tab Stop)对齐规则导致的“看似失效”
对于 \t,有时候并没有显示为反斜杠和 t,但看起来只隔了一个普通的空格,或者不同行的列没有对齐,导致误以为 \t 没有生效:
# 示例:\t 在前置文字长度变化时的制表表现
print("1234567\tA")   # 前面已有 7 个字符
print("12345678\tB")  # 前面已有 8 个字符(刚好跨过一个8字符制表位)

# 控制台输出效果:
1234567 A
12345678        B
根本原因:\t 并不是固定插入 4 个或 8 个空格,而是将光标移动到“下一个制表位”。如果当前文本距离下一个制表位只差 1 个字符距离,\t 就只会显示 1 个空格的宽度。
三、系统排查步骤与针对性解决方法
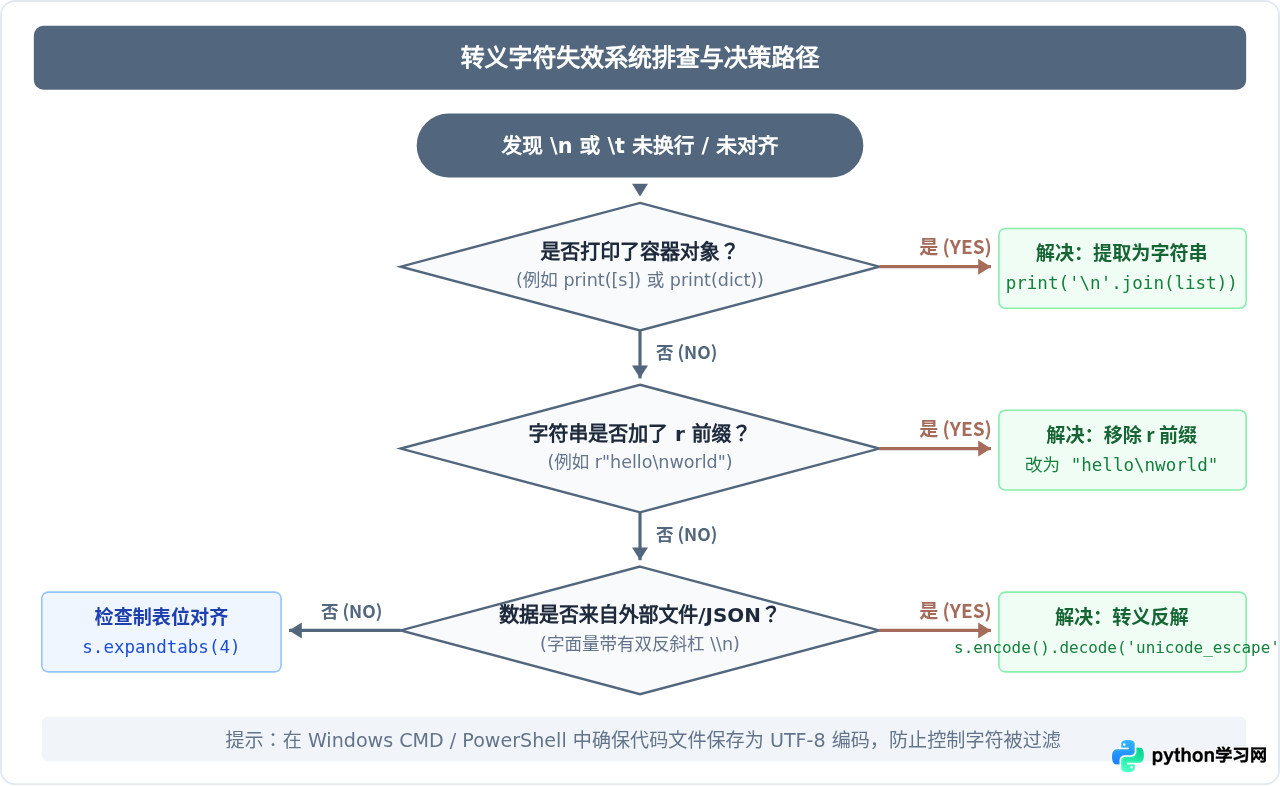
当遇到 \n 或 \t 不生效时,按照下列流程图依次排查,可以在一分钟内准确定位根因并应用修复方案。
方法 1:脱离容器包装,直接打印字符串或使用 join()
如果内容存在于列表、元组或集合中,请不要直接打印整个容器。应遍历元素逐项打印,或者使用字符串的 join() 方法组合后输出:
items = ["苹果", "香蕉", "橙子"]

# 错误做法(显示单行列表,且若有换行符也会被转义):
print(items)

# 正确做法 A:使用 join 拼成单一换行字符串
print("\n".join(items))

# 正确做法 B:循环逐项打印
for item in items:
    print(item)
方法 2:去掉字面量中的 r 前缀
检查变量赋值语句。如果不需要防止 Windows 路径反斜杠转义,请删除 r 或 R:
# 修复前:
path_info = r"路径配置完成:\nC:\Users\Admin\Documents"

# 修复后:去掉 r,只对真正的反斜杠写成 \\,保留 \n 转义
path_info = "路径配置完成:\nC:\\Users\\Admin\\Documents"
print(path_info)
方法 3:使用 unicode_escape 或字符串替换还原双重转义
当数据来源于外部文件、网络 API、JSON 反序列化失败或者包含字面量的 \n(字符串中实际有两个字符 \ 和 n)时,可以使用 Python 提供的 unicode_escape 编解码器将它们还原为真实控制符:
# 模拟从外部文件读入的带有字面量反斜杠的字符串
raw_input_text = "第一部分\\n第二部分\\t子标题"

# 方案 A:使用 unicode_escape 编解码还原所有标准转义(推荐)
restored_text = raw_input_text.encode('utf-8').decode('unicode_escape')
print(restored_text)

# 方案 B:简单替换常用转义符
clean_text = raw_input_text.replace("\\n", "\n").replace("\\t", "\t")
print(clean_text).replace("\\n", "\n"),避免直接使用 eval() 或不受限的转义解码,防止潜在的代码注入或异常字符解析。
方法 4:利用 expandtabs() 规范化制表符宽度
制表符 \t 依赖当前终端对于 Tab Stop 的定义(通常默认为 8 个空格宽度)。为了保证在任何终端或日志平台都有统一的对齐表现,推荐在输出前使用 str.expandtabs() 显式将 \t 转换为确定数量的实际空格:
header = "ID\tName\tScore"
row1 = "1\tAlice\t98"
row2 = "102\tBob\t85"

# 将每一个 \t 转换为按 8 空格制表位补全的精确空格字符
print(header.expandtabs(8))
print(row1.expandtabs(8))
print(row2.expandtabs(8))
四、总结与常见排错速查
遇到打印排版未达预期时,不要盲目拼接反斜杠。下表总结了最典型的现象、内部原因以及对应的单行修复方案:
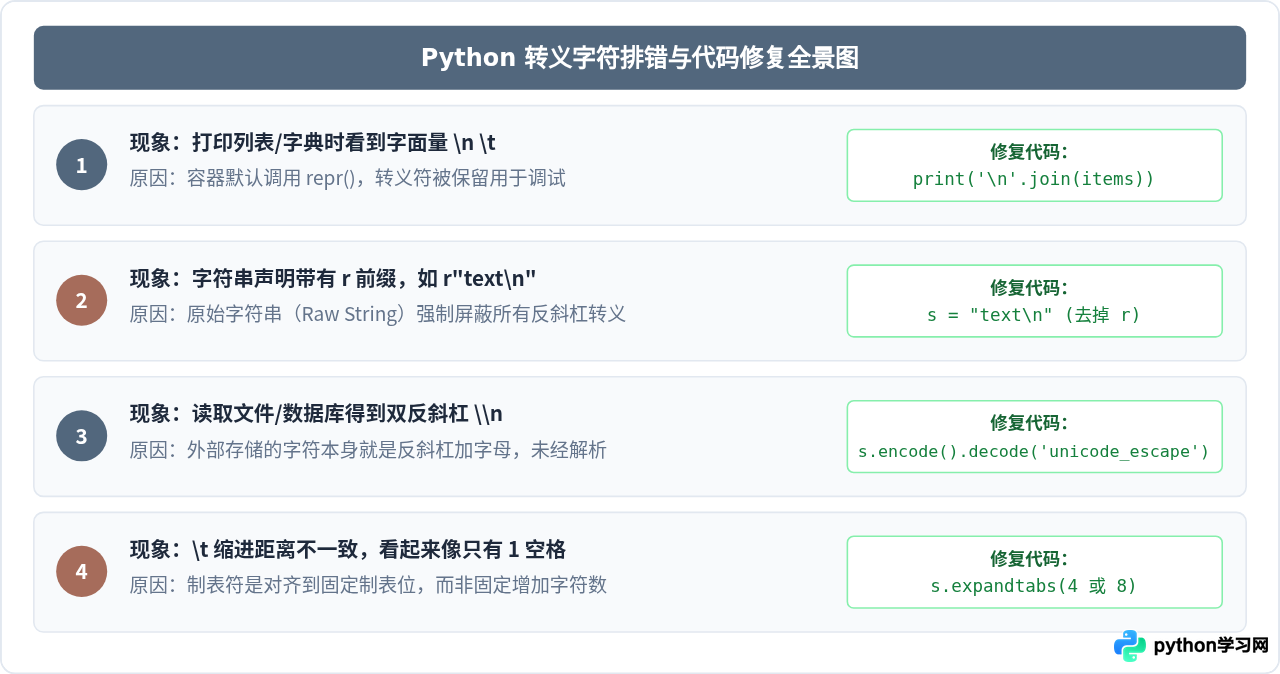
| 问题场景 | 典型代码特征 | 内部原因 | 推荐解决方案 |
|---|---|---|---|
| 打印容器对象 | print([s1, s2]) |
容器调用 __repr__ 输出以避免歧义 |
使用 '\n'.join(list) 或遍历打印 |
| 使用原始字符串 | r"第一行\n第二行" |
r 前缀强制关闭反斜杠转义 |
移除 r,对实际路径写成 \\ |
| 外部文本包含字面量 | 从文件读入包含 \n 的字符串 |
反斜杠作为独立字符存入,变成 \\n |
s.encode().decode('unicode_escape') |
| 制表符对齐偏差 | \t 间隔忽大忽小 |
按 8 字符倍数移动光标,差额可能仅为 1 字符 | 使用 str.expandtabs(width) 替换为标准空格 |
通过理解 Python 的词法解析规则以及 str 与 repr 的设计差异,可以迅速排除换行符与制表符的显示异常,确保在控制台、日志文件和用户交互界面中呈现出稳定、整洁的排版效果。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















