


python函数参数顺序错误SyntaxError怎么办
深入解析Python中因函数参数顺序不当引发的SyntaxError语法错误,系统剖析函数定义期与函数调用期的两类典型报错表现、底层消除二义性机制,并提供规范的排查与修复步骤。
一、故障表现:两类常见的参数顺序 SyntaxError
在 Python 中,与函数参数顺序直接相关的语法错误(SyntaxError)主要发生在两个不同的生命周期阶段:函数定义期与函数调用期。这两类错误属于编译期异常,在 Python 解释器将源代码解析为抽象语法树(AST)时就会直接抛出,程序甚至不会开始执行函数体内的任何逻辑。
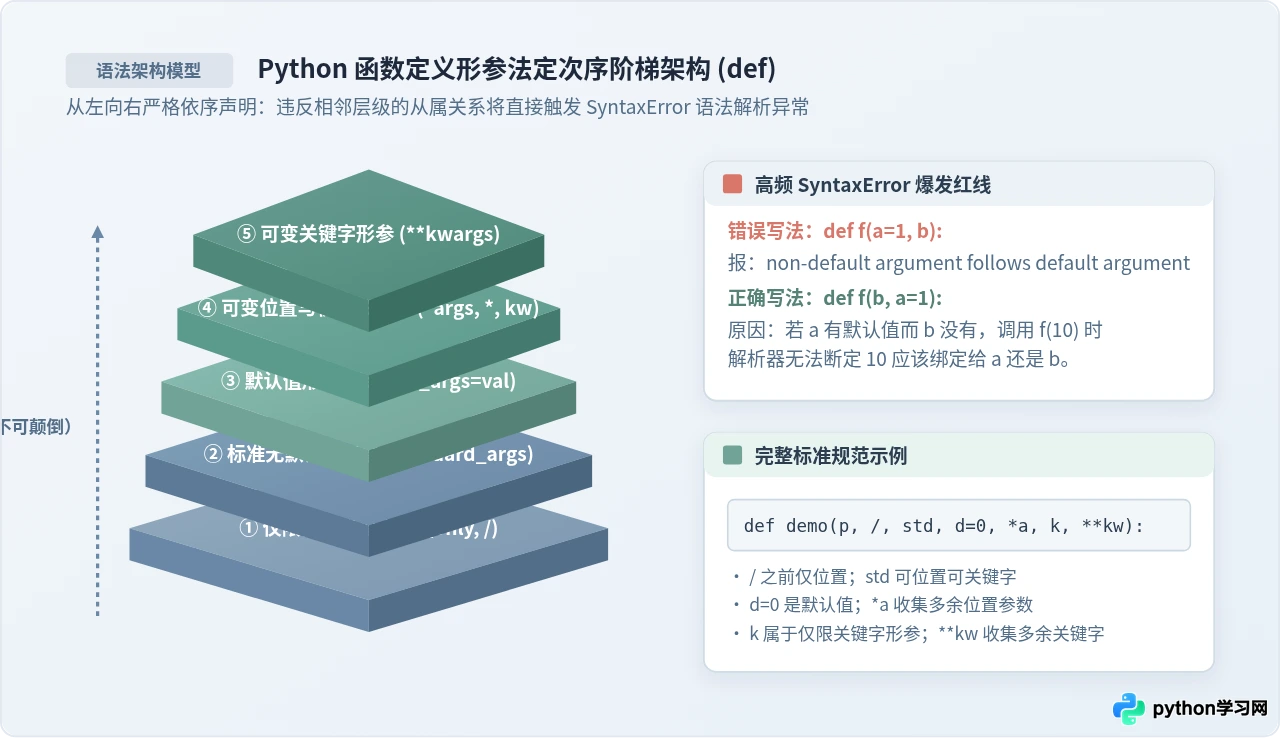
1. 定义期报错:non-default argument follows default argument
当在 def 语句中定义函数形参时,如果把没有默认值的参数写在了带有默认值的参数后面,解释器会报出如下错误:
# 错误示例:定义期形参顺序颠倒
def calculate_price(discount=0.1, price):
    return price * (1 - discount)
终端示例输出:
  File "app.py", line 2
    def calculate_price(discount=0.1, price):
                                      ^
SyntaxError: non-default argument follows default argument
错误提示直译为“无默认值参数跟在了默认值参数之后”。Python 语法解析器在遇到标记 ^ 处的 price 时,发现其未附带默认值,而前面的 discount 已经声明了默认值 0.1,因此直接阻断解析。
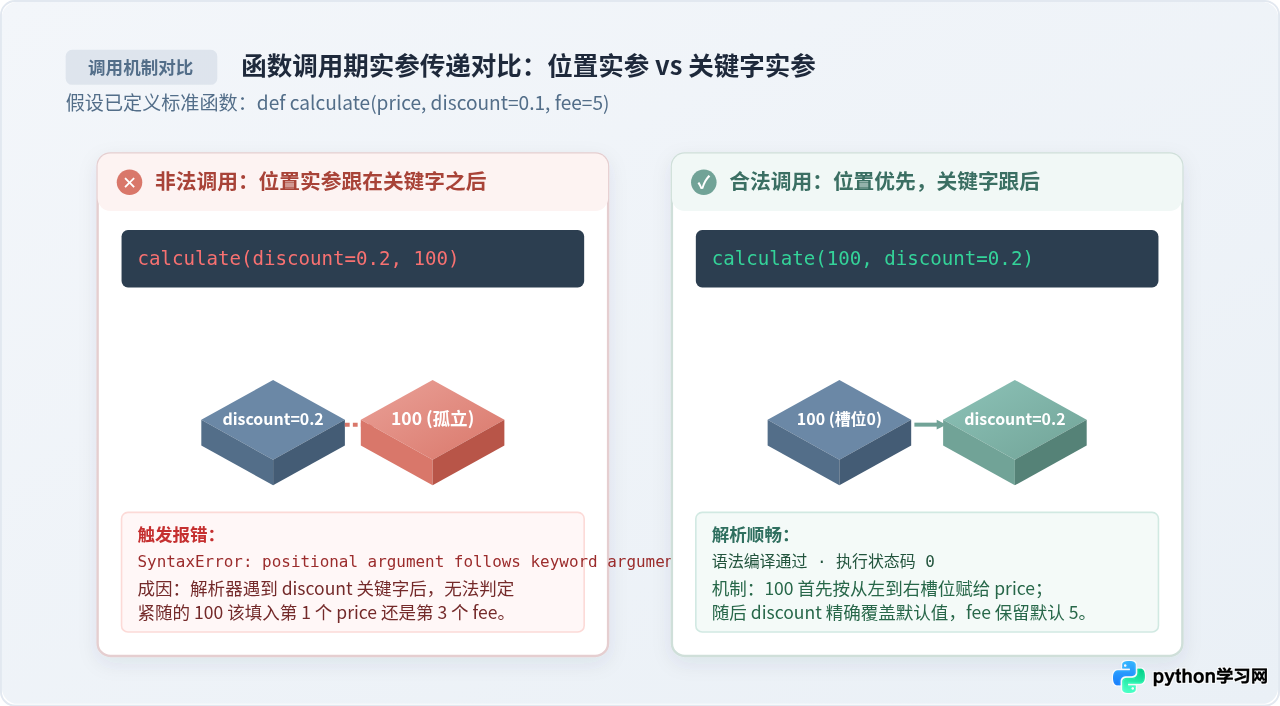
2. 调用期报错:positional argument follows keyword argument
当调用一个已经定义好的函数时,如果传入的位置实参排在了关键字实参之后,解释器会抛出另一种报错:
# 正确的函数定义
def connect_server(host, port, timeout=30):
    return f"Connecting to {host}:{port} (timeout={timeout}s)"

# 错误示例:调用期实参顺序颠倒
connect_server(host="127.0.0.1", 8080)
终端示例输出:
  File "app.py", line 5
    connect_server(host="127.0.0.1", 8080)
                                     ^
SyntaxError: positional argument follows keyword argument
错误提示直译为“位置实参跟在了关键字实参之后”。解析器在解析到关键字参数 host="127.0.0.1" 之后,无法继续按照位置索引去匹配后续的普通数值 8080。
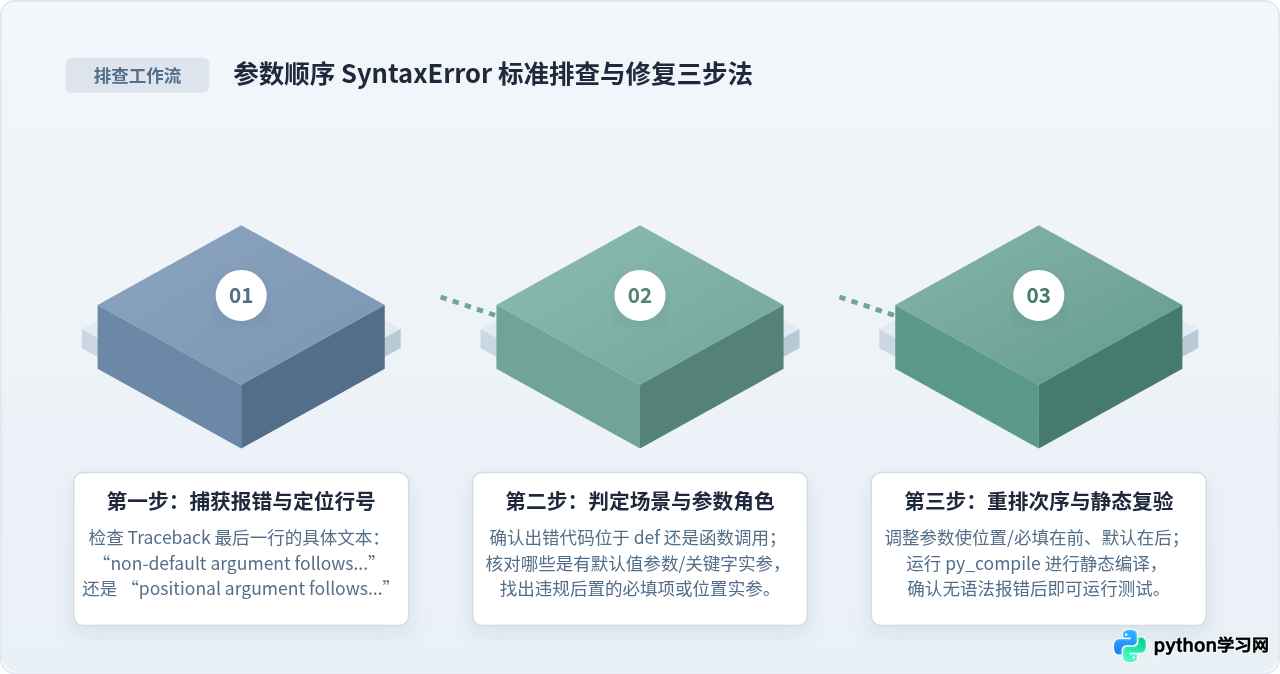
二、排查与修复的标准三步操作法
遇到此类错误时,不需要盲目重写整个函数,遵循标准化排查路径即可在数秒内定位并修复。
-
第一步:查看 Traceback 报错提示与定位行号
观察终端输出的最后一行。如果包含non-default argument follows default argument,说明问题在def行;如果包含positional argument follows keyword argument,说明问题在函数调用行。记下报错代码行号。 -
第二步:核对参数角色清单
针对报错的代码行,逐一核对括号内的每一个参数:- 若是
def语句:辨识哪些形参带有=默认值,哪些是没有默认值的必填项。 - 若是函数调用:辨识哪些是带有
key=value键值对的关键字实参,哪些是直接传值的纯位置实参。
- 若是
-
第三步:调整顺序并进行静态语法复验
将所有无默认值形参或位置实参整体前移,使之排在最左侧;将所有默认参数或关键字实参移到右侧。保存文件后,无需启动复杂业务系统,直接使用静态编译命令验证(见第五节)。
三、场景一修复:函数定义中的形参顺序规则
深入理解为什么 Python 会强制规定这一顺序,有助于从根本上避免再次书写错误的代码结构。
1. 底层成因:消除参数绑定的二义性
假设 Python 允许 def calculate_price(discount=0.1, price): 这样的定义,那么当调用者执行 calculate_price(100) 时,Python 解释器将面临无法裁决的歧义:
- 解释 A:调用者想把
100赋给第一个位置上的discount?但此时第二个必填参数price就会缺失。 - 解释 B:调用者想让
discount采用默认值0.1,把100赋给必填的price?但在按位置传参的机制下,跨过前面的形参直接赋值给后面的形参是无法自洽的。
因此,Python 规定无默认值的形参必须全部排在有默认值的形参之前,彻底消除了位置匹配时的二义性。
2. 规范修复方案
针对定义期的错误,通常有两种合法的修复方式:
方案 A:重排形参顺序(最常见做法)
将必填的 price 放置在前,带默认值的 discount 放置在后:
# 修复后代码
def calculate_price(price, discount=0.1):
    return price * (1 - discount)

# 正常调用
print(calculate_price(100))        # 输出: 90.0
print(calculate_price(100, 0.2))   # 输出: 80.0
方案 B:使用仅限关键字参数(Keyword-Only)
如果业务上确实希望某些带默认值的参数在前面,或者不想强制位置顺序,可以使用单星号 * 将其之后的参数声明为仅限关键字参数:
# 通过单星号隔离,解除位置匹配二义性
def calculate_price(*, discount=0.1, price):
    return price * (1 - discount)

# 此时调用必须全部指定参数名,语法完全合法
print(calculate_price(price=100))                 # 输出: 90.0
print(calculate_price(discount=0.2, price=100)) # 输出: 80.0* 之后,后面的所有参数都不能再通过位置实参传递,必须使用 key=value 的形式传入。
四、场景二修复:函数调用中的实参顺序规则
函数调用时的实参传递遵循同样的消除歧义哲学。
1. 底层成因:槽位匹配与命名解析机制
Python 在执行函数调用时,参数绑定过程遵循两个固定步骤:
- 首先处理位置实参:从左至右依次填入函数签名的对应形参槽位(Slot)。
- 随后处理关键字实参:根据指定的参数名找到对应槽位并赋值;如果该槽位已经被前序的位置实参占满,则报错
TypeError: got multiple values for argument。
如果允许在关键字实参之后继续书写无名位置实参,例如 connect_server(host="127.0.0.1", 8080),解释器就无法得知 8080 到底是对应第二个形参 port,还是因为前面的 host 已经绑定而应该从下一个未绑定的槽位继续顺延。为了确保语法解析的单向确定性,Python 语法直接在解析期禁止此类写法。
2. 规范修复方案
方案 A:将位置实参前置
保持未命名的实参在最前面,按函数签名位置依次填入:
# 修复方案 A:位置实参居前
connect_server("127.0.0.1", 8080)
# 或者仅对后续参数使用关键字
connect_server("127.0.0.1", port=8080, timeout=10)
方案 B:全部显式指定参数名(推荐)
如果已经开始使用关键字传参,最稳妥、可读性最好的方式是将后续的参数也全部写为关键字形式:
# 修复方案 B:全部使用关键字实参(可任意调换顺序)
connect_server(host="127.0.0.1", port=8080)
connect_server(port=8080, host="127.0.0.1")  # 此时顺序调换同样合法
五、进阶场景:包含 *args、**kwargs 与 / 时的顺序规范
在编写通用库、装饰器或大型框架时,函数参数签名往往会包含不定长参数以及 Python 3.8 引入的仅限位置形参标记。此时的顺序必须严格符合 Python 的语法标准规范。
| 次序 | 形参类型 | 语法示例 | 规则与约束 |
|---|---|---|---|
| 1 | 仅限位置形参 (Positional-Only) | x, y, / |
必须位于 / 之前,调用时严禁使用关键字传参。 |
| 2 | 标准无默认值形参 | a, b |
可位置可关键字,必须在有默认值形参之前。 |
| 3 | 标准默认值形参 | c=10 |
可位置可关键字,必须紧跟无默认值形参。 |
| 4 | 可变位置形参 | *args |
用于收集多余的位置实参,之后的所有普通形参均自动转为仅限关键字参数。 |
| 5 | 仅限关键字形参 | k, debug=False |
位于 *args 或独立 * 之后,调用时必须显式写出 key=val。 |
| 6 | 可变关键字形参 | **kwargs |
必须处于整个函数定义的末尾,用于收集多余的键值对。 |
以下为一个同时包含上述所有特性的完整合法函数定义示例:
# 包含所有类型参数的完整规范示例
def comprehensive_demo(pos_only, /, std_param, def_param=100, *args, kw_only, kw_default="safe", **kwargs):
    print("pos_only:", pos_only)
    print("std_param:", std_param)
    print("def_param:", def_param)
    print("args:", args)
    print("kw_only:", kw_only)
    print("kw_default:", kw_default)
    print("kwargs:", kwargs)

# 合法调用示例
comprehensive_demo(
    1,                  # 对应 pos_only(严禁写 pos_only=1)
    2,                  # 对应 std_param
    3,                  # 覆盖 def_param
    4, 5, 6,            # 收集进 args
    kw_only="required", # 必填仅限关键字
    custom_tag="data"   # 收集进 kwargs
)
六、验证与预防:静态语法编译测试
在修改参数顺序后,如何快速确认代码中的 SyntaxError 已经彻底消除,且没有引入新的语法错误?推荐使用 Python 标准库自带的 py_compile 工具。
1. 静态编译验证命令
运行以下命令对修改后的 Python 脚本进行字节码编译检查:
# 静态语法编译检查命令
python3 -m py_compile your_script.py
执行结果判断:
- 验证成功:命令以退出码 0 静默退出,控制台无任何输出,说明语法解析完全正确。
- 验证失败:如果仍存在参数顺序错误,命令会立刻以非零状态码退出并清晰打印出错行号与原因。
2. 常见延伸疑问与避坑细节
疑问一:为什么解包时 *list 和 **dict 也会遇到顺序问题?
在函数调用中解包集合时,规则与普通实参一致:func(*pos_items, **kwd_items) 必须保证位置解包在关键字解包之前。如果写成 func(**dict_val, *list_val),同样会直接触发 SyntaxError: iterable argument unpacking follows keyword argument unpacking。
疑问二:重构函数参数顺序后需要注意什么?
当修改了既有函数的形参顺序时,虽然当前函数定义通过了编译,但项目中历史代码里依赖旧“位置顺序”调用的语句可能会传错参数甚至报运行时异常。因此,调整公共函数签名时,建议全局搜索调用点,或者将新增参数追加在末尾并赋予默认值。
七、核心法则与避坑清单总结
为了便于日常开发速查与代码评审,我们将 Python 函数参数顺序的核心规则精简为三条口诀看板:
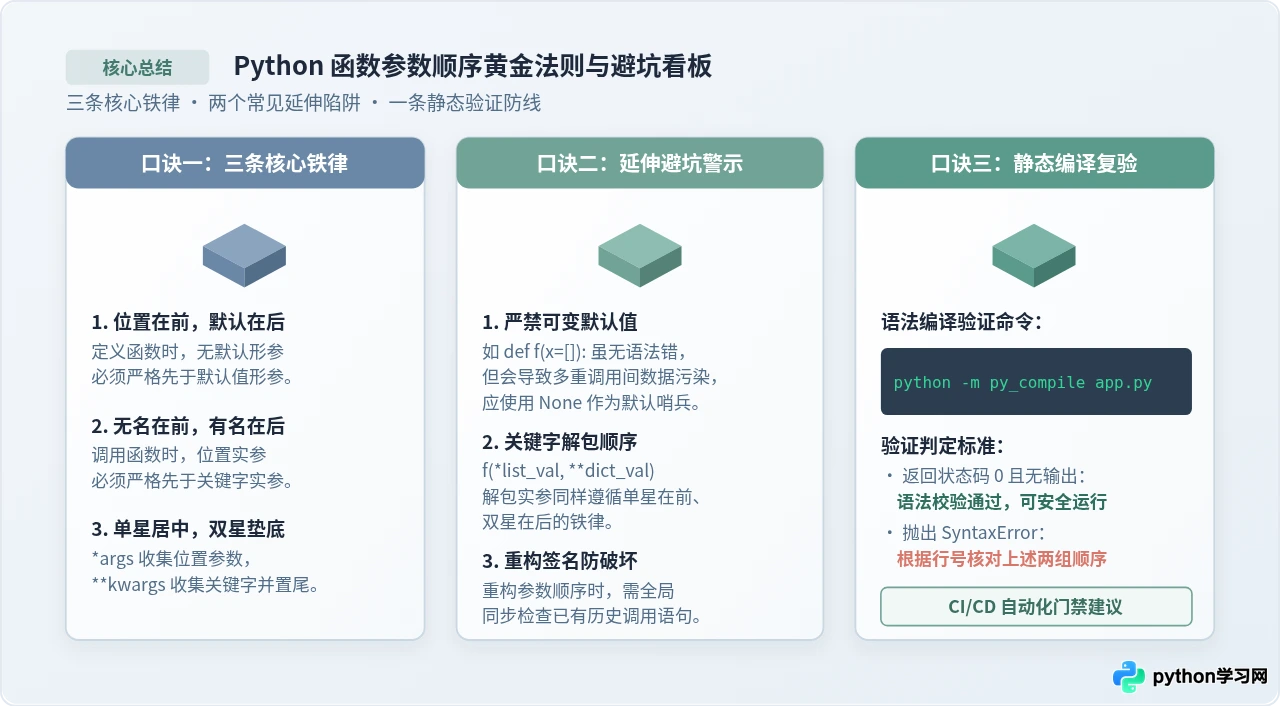
• 定义期:无默认在前,默认在后;无名在前,有名在后。
• 调用期:位置实参在前,关键字实参在后。
• 特殊项:单星
*args 居中收集余量,双星 **kwargs 垫底收尾。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















